Expressions régulières -Métacaractères
Les métacaractères dans les expressions régulières sont des caractères ayant une signification spéciale. Ils ne représentent pas des caractères littéraux, mais servent à contrôler le motif de correspondance.
Métacaractères de base
.(point)
-
Correspond à tout caractère unique sauf un saut de ligne (
\n) en dehors de tout caractère uniqueExemple :
a.bCorrespond à "aab", "a1b", "a b", etc.
^(caret)
-
Correspond à la position de début de la chaîne
-
Exemple :
^abcCorrespond aux chaînes commençant par "abc"
$(signe dollar)
-
Correspond à la position de fin de la chaîne
-
Exemple :
xyz$Correspond aux chaînes se terminant par "xyz"
\(barre oblique inversée)
-
Caractère d'échappement, il fait perdre au caractère suivant sa signification spéciale
-
Exemple :
\.Correspond à un point littéral au lieu de n'importe quel caractère
Métacaractères de classe de caractères
[](crochets)
-
Définit un ensemble de caractères, correspond à n'importe quel caractère de cet ensemble
-
Exemple :
[aeiou]Correspond à une voyelle quelconque
[^](classe de caractères niée)
-
Correspond à tout caractère ne se trouvant pas entre les crochets
-
Exemple :
[^0-9]Correspond à tout caractère autre qu'un chiffre
-(trait d'union)
-
Représente une plage au sein d'une classe de caractères
-
Exemple :
[a-z]Correspond à n'importe quelle lettre minuscule
Métacaractères de quantification
*(astérisque)
-
Correspond à la sous-expression précédente zéro ou plusieurs fois
-
Exemple :
ab*cCorrespond à "ac", "abc", "abbc", etc.
+(signe plus)
-
Correspond à la sous-expression précédente une ou plusieurs fois
-
Exemple :
ab+cCorrespond à "abc", "abbc" mais pas "ac"
?(point d'interrogation)
-
Correspond à la sous-expression précédente zéro ou une fois
-
Exemple :
colou?rCorrespond à "color" et "colour"
{n}(accolades)
-
Correspond exactement n fois
-
Exemple :
a{3}Correspond à "aaa"
{n,}
-
Correspond au moins n fois
-
Exemple :
a{2,}Correspond à "aa", "aaa", etc.
{n,m}
-
Correspond de n à m fois
-
Exemple :
a{2,4}Correspond à "aa", "aaa", "aaaa"
Métacaractères de regroupement et d'alternance
()(parenthèses)
-
Définit une sous-expression ou un groupe de capture
-
Exemple :
(ab)+Correspond à "ab", "abab", etc.
|(barre verticale)
-
Représente une relation "ou"
-
Exemple :
cat|dogCorrespond à "cat" ou "dog"
Métacaractères de classe de caractères spéciaux
\d
-
Correspond à n'importe quel chiffre, équivalent à
[0-9]
\D
-
Correspond à tout caractère qui n'est pas un chiffre, équivalent à
[^0-9]
\w
-
Correspond à tout caractère de mot (lettre, chiffre, trait de soulignement), équivalent à
[a-zA-Z0-9_]
\W
-
Correspond à tout caractère non-mot, équivalent à
[^a-zA-Z0-9_]
\s
-
Correspond à tout caractère d'espacement (espace, tabulation, saut de ligne, etc.)
\S
-
Correspond à tout caractère autre qu'un caractère d'espacement
Métacaractères de correspondance de limites
\b
-
Correspond à une limite de mot
-
Exemple :
\bcat\bCorrespond à "cat" mais pas à "category"
\B
-
Correspond à une limite de non-mot
-
Exemple :
\Bcat\BCorrespond à "cat" dans "scattered" mais pas au "cat" isolé
Autres métacaractères
\n
-
Correspond à un saut de ligne
\t
-
Correspond à une tabulation
\r
-
Correspond à un retour chariot
\f
-
Correspond à un saut de page
\v
-
Correspond à une tabulation verticale
Quantificateurs gourmands et non gourmands
Par défaut, les quantificateurs (*, +, ?, {}) sont gourmands et correspondent au plus grand nombre de caractères possible. Ajoutez après le quantificateur?pour le passer en mode non gourmand (paresseux) :
-
*?: zéro ou plus, mais aussi peu que possible -
+?: un ou plusieurs, mais le moins possible -
??: zéro ou un, mais le moins possible -
{n,m}?: n à m fois, mais le moins possible
Exemple :<.*?>Lors de la correspondance de balises HTML, il ne correspond pas d'une balise à l'autre
Lookahead positif et négatif
(?=...)(lookahead positif)
-
Correspond à une position suivie d'un motif spécifique
-
Exemple :
Windows(?=95|98)Correspond à "Windows" suivi de 95 ou 98
(?!...)(lookahead négatif)
-
Correspond à une position non suivie d'un motif spécifique
-
Exemple :
Windows(?!95|98)Correspond à "Windows" non suivi de 95 ou 98
(?<=...)(lookbehind positif)
-
Correspond à une position précédée par un motif spécifique
-
Exemple :
(?<=95|98)WindowsCorrespond à "Windows" précédé de 95 ou 98
(?<!...)(lookbehind négatif)
-
Correspond à une position non précédée par un motif spécifique
-
Exemple :
(?<!95|98)WindowsCorrespond à "Windows" non précédé de 95 ou 98
Exemples
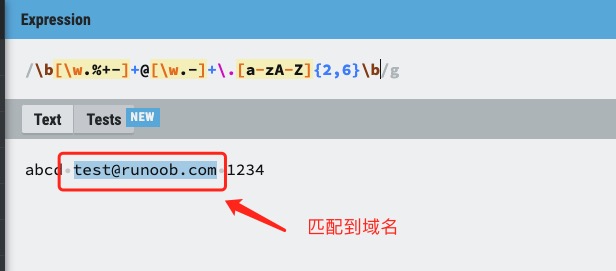
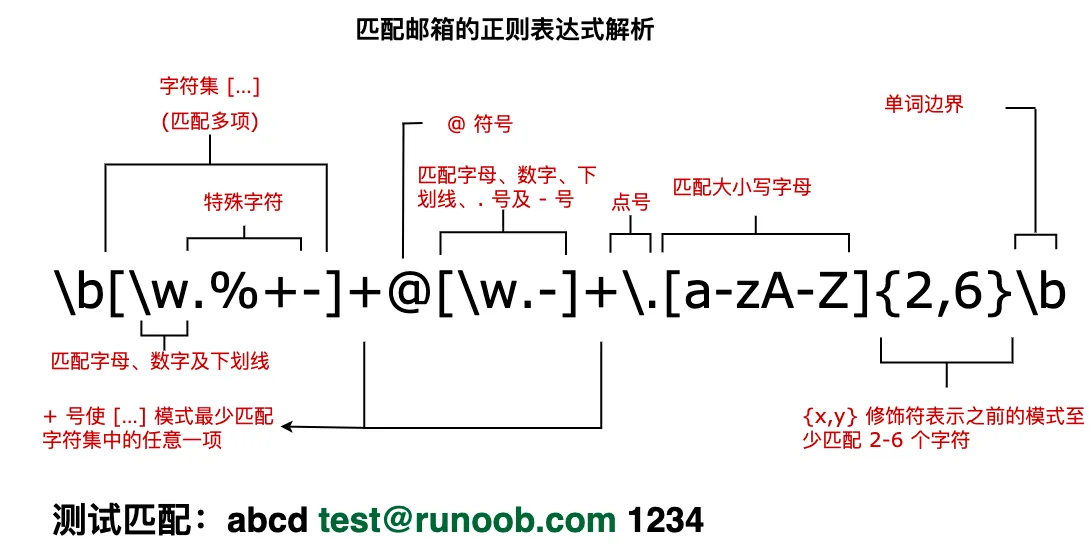
Ensuite, analysons une expression régulière pour faire correspondre des adresses e-mail, comme indiqué ci-dessous :
Exemples
Le texte marqué ci-dessous est l'expression avec les correspondances obtenues :
test@example.com
Essayez-le »
Le tableau suivant contient une liste complète des métacaractères et de leur comportement dans le contexte des expressions régulières :
| Caractère | Description |
|---|---|
| \ | Marque le caractère suivant comme un caractère spécial, un caractère littéral, une rétroréférence ou un échappement octal. Par exemple, 'n' correspond au caractère "n". '\n' correspond à un retour à la ligne. La séquence '\\' correspond à "\" et "\(" correspond à "(". |
| ^ | Correspond au début de la chaîne d'entrée. Si la propriété Multiline de l'objet RegExp est définie, ^ correspond également aux positions après '\n' ou '\r'. |
| $ | Correspond à la fin de la chaîne d'entrée. Si la propriété Multiline de l'objet RegExp est définie, $ correspond également aux positions avant '\n' ou '\r'. |
| * | Correspond à la sous-expression précédente zéro ou plusieurs fois. Par exemple, zo* peut correspondre à "z" ainsi qu'à "zoo". * est équivalent à {0,}. |
| + | Correspond à la sous-expression précédente une ou plusieurs fois. Par exemple, 'zo+' peut correspondre à "zo" ainsi qu'à "zoo", mais ne peut pas correspondre à "z". + est équivalent à {1,}. |
| ? | Correspond à la sous-expression précédente zéro ou une fois. Par exemple, "do(es)?" peut correspondre à "do" ou "does". ? est équivalent à {0,1}. |
| {n} | n est un entier non négatif. Correspond exactement n fois. Par exemple, 'o{2}' ne peut pas correspondre au 'o' dans "Bob", mais peut correspondre aux deux o dans "food". |
| {n,} | n est un entier non négatif. Correspond au moins n fois. Par exemple, 'o{2,}' ne peut pas correspondre au 'o' dans "Bob", mais peut correspondre à tous les o dans "foooood". 'o{1,}' est équivalent à 'o+'. 'o{0,}' est équivalent à 'o*'. |
| {n,m} | m et n sont tous deux des entiers non négatifs, où n <= m. Correspond au moins n fois et au plus m fois. Par exemple, "o{1,3}" correspondra aux trois premiers o dans "fooooood". 'o{0,1}' est équivalent à 'o?'. Notez qu'il ne doit pas y avoir d'espaces entre la virgule et les deux nombres. |
| ? | Lorsque ce caractère suit immédiatement un autre quantificateur (*, +, ?, {n}, {n,}, {n,m}), le mode de correspondance est non gourmand. Le mode non gourmand correspond à aussi peu que possible de la chaîne recherchée, tandis que le mode gourmand par défaut correspond à autant que possible. Par exemple, pour la chaîne "oooo", 'o+?' correspondra à un seul "o", tandis que 'o+' correspondra à tous les 'o'. |
| . | Correspond à n'importe quel caractère unique sauf le saut de ligne (\n, \r). Pour correspondre à n'importe quel caractère, y compris '\n', utilisez un motif comme"(.|\n)" motif. |
| (motif) | Correspond au motif et capture cette correspondance. La correspondance obtenue peut être récupérée depuis la collection Matches résultante, en utilisant la collection SubMatches en VBScript, et les propriétés $0…$9 en JScript. Pour mettre en correspondance les caractères de parenthèse, utilisez '\(' ou '\)'. |
| (?:pattern) | Correspond au motif mais ne capture pas le résultat de la correspondance, c'est-à-dire qu'il s'agit d'une correspondance non capturante, non stockée pour un usage ultérieur. Cela est utile lorsqu'on utilise le caractère "ou" (|) pour combiner les parties d'un motif. Par exemple, 'industr(?:y|ies)' est une expression plus concise que 'industry|industries'. |
| (?=pattern) | Assertion d'anticipation positive (positive lookahead). Correspond à la chaîne de recherche au début de toute chaîne qui correspond au motif. Il s'agit d'une correspondance non capturante, c'est-à-dire que la correspondance n'a pas besoin d'être capturée pour un usage ultérieur. Par exemple, "Windows(?=95|98|NT|2000)" correspond à "Windows" dans "Windows2000", mais ne peut pas correspondre à "Windows" dans "Windows3.1". L'anticipation (lookahead) ne consomme pas de caractères, c'est-à-dire qu'après qu'une correspondance se produit, la recherche de la correspondance suivante commence immédiatement après la dernière correspondance, et non après les caractères inclus dans l'anticipation. |
| (?!pattern) | Assertion d'anticipation négative (negative lookahead). Correspond à la chaîne de recherche au début de toute chaîne qui ne correspond pas au motif. Il s'agit d'une correspondance non capturante, c'est-à-dire que la correspondance n'a pas besoin d'être capturée pour un usage ultérieur. Par exemple, "Windows(?!95|98|NT|2000)" correspond à "Windows" dans "Windows3.1", mais ne peut pas correspondre à "Windows" dans "Windows2000". L'anticipation (lookahead) ne consomme pas de caractères, c'est-à-dire qu'après qu'une correspondance se produit, la recherche de la correspondance suivante commence immédiatement après la dernière correspondance, et non après les caractères inclus dans l'anticipation. |
| (?<=pattern) | Assertion d'anticipation arrière positive (positive lookbehind), semblable à l'assertion d'anticipation positive, sauf que la direction est opposée. Par exemple, "(?<=95|98|NT|2000)Windowspeut correspondre à2000Windows"in"Windows, mais ne peut pas correspondre à3.1Windows"in"Windows"。 |
| (?<!pattern) | Assertion d'anticipation arrière négative (negative lookbehind), semblable à l'assertion d'anticipation négative, sauf que la direction est opposée. Par exemple(?<!95|98|NT|2000)Windowspeut correspondre à3.1Windows"in"Windows, mais ne peut pas correspondre à2000Windows"in"Windows"。 |
| x|y | Correspond à x ou y. Par exemple, 'z|food' peut correspondre à "z" ou "food". '(z|f)ood' correspond à "zood" ou "food". |
| [xyz] | Ensemble de caractères. Correspond à l’un quelconque des caractères inclus. Par exemple, '[abc]' peut correspondre à 'a' dans "plain". |
| [^xyz] | Ensemble de caractères nié. Correspond à tout caractère non inclus. Par exemple, '[^abc]' peut correspondre à 'p', 'l', 'i', 'n' dans "plain". |
| [a-z] | Plage de caractères. Correspond à tout caractère compris dans la plage spécifiée. Par exemple, '[a-z]' peut correspondre à tout caractère de lettre minuscule dans la plage 'a' à 'z'. |
| [^a-z] | Plage de caractères niée. Correspond à tout caractère ne se trouvant pas dans la plage spécifiée. Par exemple, '[^a-z]' correspond à tout caractère qui n’est pas dans la plage 'a' à 'z'. |
| \b | Correspond à une limite de mot, c’est-à-dire la position entre un mot et un espace. Par exemple, 'er\b' peut correspondre à 'er' dans "never", mais ne peut pas correspondre à 'er' dans "verb". |
| \B | Correspond à une limite de non-mot. 'er\B' peut correspondre à 'er' dans "verb", mais ne peut pas correspondre à 'er' dans "never". |
| \cx | Correspond à un caractère de contrôle indiqué par x. Par exemple, \cM correspond à un Control-M ou à un retour chariot. La valeur de x doit être l’une de A-Z ou a-z. Sinon, traitez c comme un caractère 'c' littéral. |
| \d | Correspond à un chiffre. Équivalent à [0-9]. |
| \D | Correspond à un caractère autre qu'un chiffre. Équivalent à [^0-9]. |
| \f | Correspond à un caractère de saut de page. Équivalent à \x0c et \cL. |
| \n | Correspond à un caractère de nouvelle ligne. Équivalent à \x0a et \cJ. |
| \r | Correspond à un caractère de retour chariot. Équivalent à \x0d et \cM. |
| \s | Correspond à tout caractère d'espacement, y compris l'espace, la tabulation, le saut de page, etc. Équivalent à [ \f\n\r\t\v]. |
| \S | Correspond à tout caractère qui n'est pas un caractère d'espacement. Équivalent à [^ \f\n\r\t\v]. |
| \t | Correspond à un caractère de tabulation. Équivalent à \x09 et \cI. |
| \v | Correspond à un caractère de tabulation verticale. Équivalent à \x0b et \cK. |
| \w | Correspond aux lettres, aux chiffres et aux traits de soulignement. Équivalent à '[A-Za-z0-9_]'. |
| \W | Correspond aux caractères qui ne sont pas des lettres, des chiffres ou des traits de soulignement. Équivalent à '[^A-Za-z0-9_]'. |
| \xn | Correspond à n, où n est une valeur d'échappement hexadécimale. La valeur d'échappement hexadécimale doit être composée d'exactement deux chiffres. Par exemple, '\x41' correspond à "A". '\x041' est équivalent à '\x04' & "1". L'encodage ASCII peut être utilisé dans les expressions régulières. |
| \num | Correspond à num, où num est un entier positif. Une rétroréférence à une correspondance capturée. Par exemple, '(.)\1' correspond à deux caractères identiques consécutifs. |
| \n | Identifie une valeur d'échappement octale ou une rétroréférence. S'il y a au moins n sous-expressions capturées avant \n, alors n est une rétroréférence. Sinon, si n est un chiffre octal (0-7), alors n est une valeur d'échappement octale. |
| \nm | Identifie une valeur d'échappement octale ou une rétroréférence. S'il y a au moins nm sous-expressions capturées avant \nm, alors nm est une rétroréférence. S'il y a au moins n captures avant \nm, alors n est une rétroréférence suivie de m littéral. Si aucune des conditions précédentes n'est remplie, et que n et m sont tous deux des chiffres octaux (0-7), alors \nm correspond à la valeur d'échappement octale nm. |
| \nml | Si n est un chiffre octal (0-3), et que m et l sont tous deux des chiffres octaux (0-7), alors correspond à la valeur d'échappement octale nml. |
| \un | Correspond à n, où n est un caractère Unicode représenté par quatre chiffres hexadécimaux. Par exemple, \u00A9 correspond au symbole de copyright (?). |