正規表現入門
正規表現(Regular Expression、略して regex または regexp)は強力なテキスト処理ツールであり、特殊な文字列を使用して、特定の構文規則に一致する一連の文字列を記述・マッチングします。
これは、次のように考えることができます:スーパーワイルドカード、通常のワイルドカード(例えば*任意の文字を表します)は機能が限られていますが、正規表現は非常に複雑で正確なテキストパターンを定義でき、単純な単語のマッチングから複雑な構造化データの抽出まで、何でもできます。
例えば、あなたはおそらく?と*ワイルドカードを使ってハードディスク上のファイルを検索します。?ワイルドカードはファイル名の0個または1個の文字にマッチし、*ワイルドカードはゼロ個以上の文字にマッチします。例えばdata(\w)?\.datのようなパターンは以下のファイルを検索します:
使用する*文字の置き換え?文字は見つかるファイルの数を増やします。data.*\.dat次のすべてのファイルにマッチします:
この検索方法は便利ですが、限界もあります。理解することで*ワイルドカードの動作原理から、正規表現が依存する概念が導入されますが、正規表現はより強力で、より柔軟です。
正規表現の使用は、簡単な方法で強力な機能を実現できます。以下に簡単な例を示します:
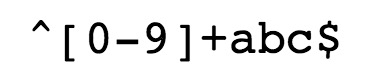
-
^は入力文字列の先頭位置にマッチします。
-
[0-9]+複数の数字にマッチし、[0-9]単一の数字にマッチし、+1つ以上にマッチします。
-
abc$アルファベットにマッチしabcそしてabcで終わり、$は入力文字列の終了位置にマッチします。
ユーザー登録フォームを作成するとき、ユーザー名には文字、数字、アンダースコア、接続文字(ハイフン) -、ユーザー名の長さを設定し、次の正規表現を使用して設定できます。
^[a-zA-Z0-9_-]{3,15}$
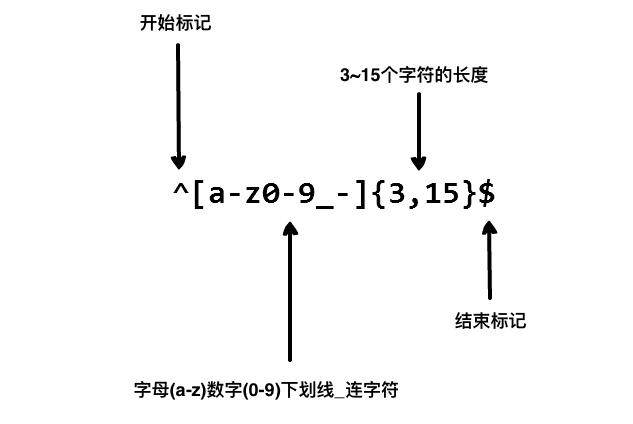
^は文字列の先頭にマッチすることを示します。[a-zA-Z0-9_-]は文字セットを示し、小文字、大文字、数字、アンダースコア、接続文字(ハイフン)を含みます。-。{3,15}は前の文字セットが最低3回、最大15回出現することを示し、ユーザー名の長さを3〜15文字に制限します。$は文字列の末尾にマッチすることを示します。
上記の正規表現はマッチしますサンプル、サンプル1、run-oob、run_oobが、次のものにはマッチしません:ruなぜなら、含まれる文字が短すぎて3文字未満のためマッチできないからです。また、次のものにもマッチしません:サンプル$なぜなら、特殊文字が含まれているからです。

例
数字で始まり、abc で終わる文字列にマッチします。
以下にマークされたテキストは、取得されたマッチの式です:
試してみる »
正規表現のメタ文字と特性
文字マッチング
- 通常の文字:通常の文字はリテラルにマッチします。例えば、文字 "a" にマッチすると、テキスト内の "a" という文字にマッチします。
- メタ文字:メタ文字は特別な意味を持ちます。例えば
\dは任意の数字文字にマッチし、\wは任意の英数字文字にマッチし、.は任意の文字(改行を除く)にマッチします。
量指定子
*:直前のパターンに0回以上マッチします。+:直前のパターンに1回以上マッチします。?:直前のパターンに0回または1回マッチします。{n}:直前のパターンにちょうど n 回マッチします。{n,}:直前のパターンに少なくとも n 回マッチします。{n,m}:直前のパターンに少なくとも n 回、多くても m 回マッチします。
文字クラス
[ ]:括弧内の任意の1文字にマッチします。例えば、[abc]文字 "a"、"b" または "c" にマッチします。[^ ]:括弧内の文字以外の任意の1文字にマッチします。例えば、[^abc]文字 "a"、"b"、"c" 以外の任意の文字にマッチします。
境界マッチング
^:文字列の先頭にマッチします。$:文字列の末尾にマッチします。\b:単語の境界にマッチします。\B:単語の境界以外にマッチします。
グループ化とキャプチャ
( ):サブ式のグループ化とキャプチャに使用します。(?: ):サブ式のグループ化に使用しますが、キャプチャは行いません。
特殊文字
\:エスケープ文字であり、特殊文字そのものにマッチするために使用します。.:任意の文字(改行を除く)にマッチします。|:複数のパターンの選択を指定するために使用します。
正規表現の定義と用途
技術的には、正規表現は通常の文字(例えば a から z までの文字)と特殊文字(メタ文字と呼ばれる)から構成される文字列であり、この文字列は検索パターン(pattern)を構成します。このパターンは、テキスト内で検索、マッチング、置換、分割の操作を行うために使用されます。
主な用途
正規表現には主に3つの用途があります:
- テキスト検索とマッチング:テキスト内に特定のパターンに一致する部分文字列が含まれているかをすばやく判断します。例えば、文字列が有効なメールアドレス形式かどうかをチェックします。
- テキスト置換:テキスト内で特定のパターンに一致するすべての部分を新しい内容に置き換えます。例えば、文書内のすべての日付形式を
YYYY-MM-DD一括で変更しますMM/DD/YYYY。 - テキスト抽出と分割:大量のテキストから関心のある部分を正確に抽出したり、特定の区切り文字に基づいてテキストを配列に分割したりします。例えば、ログファイルからすべてのIPアドレスを抽出したり、CSV文字列をカンマで分割したりします。
正規表現の適用シーン
正規表現は、プログラミングや日常のテキスト処理のあらゆる場面に浸透しています。以下は最も一般的な適用シーンのいくつかです:
1. データ検証
これは正規表現の最も古典的な用途の1つで、ユーザーが入力したデータが期待される形式に適合することを保証します。
- メールアドレスの検証:入力が次のような形式かどうかをチェックします:
username@domain.com。 - 携帯電話番号の検証:国/地域の携帯電話番号形式に一致するかどうかをチェックします(例:中国の11桁の数字)。
- パスワードの強度の検証:パスワードに大文字と小文字、数字、特殊文字が含まれることを要求します。
- 日付形式の検証:日付が
2023-12-25或12/25/2023などの有効な形式であることを確認します。 - 身分証番号の検証:特定の符号化規則に一致する身分証番号にマッチします。
2. テキスト検索とフィルタリング
大量のテキストから情報をすばやく特定します。
- ログ分析:サーバーログ内のすべての
ERROR或WARNレベルのレコードを検索します。 - コード検索:IDEまたはエディターで、正規表現を使用してすべての関数定義(例:
function xxx(...))や特定の変数名を検索します。 - ドキュメント内の検索:長いドキュメント内で出現するすべての電話番号やURLを検索します。
3. テキスト置換とクレンジング
テキスト内容を一括で変更し、標準化します。
- データのフォーマット:電話番号を
12345678901~の形式にフォーマットします123-4567-8901。 - データのクレンジング:テキスト内の余分な空白文字(複数の連続スペースやタブなど)を削除します。
- 機密情報のマスキング:テキスト内の身分証番号を置き換えます
***、例えば110101199001011234->110101********1234。 - コードリファクタリング:変数名や関数名を一括でリネームします。
4. テキスト抽出と解析
非構造化テキストから構造化データを抽出します。
- Webクローラー:HTMLコードからすべてのリンクを抽出します(
href="...")または画像アドレス(src="...")。 - 設定ファイルの解析:読み取り
key = value形式の設定ファイル。 - 特定データの抽出:テキストから出現するすべての金額を抽出します(例:
¥100.50或$99.99)。
5. 文字列分割
単一の文字だけでなく、複雑なルールを使用して文字列を分割します。
- 1つ以上のスペース、カンマ、またはセミコロンを使用して文を分割します。
- さまざまな区切り文字(例:
,、;、\t)に基づいてCSVまたはTSVデータを解析します。
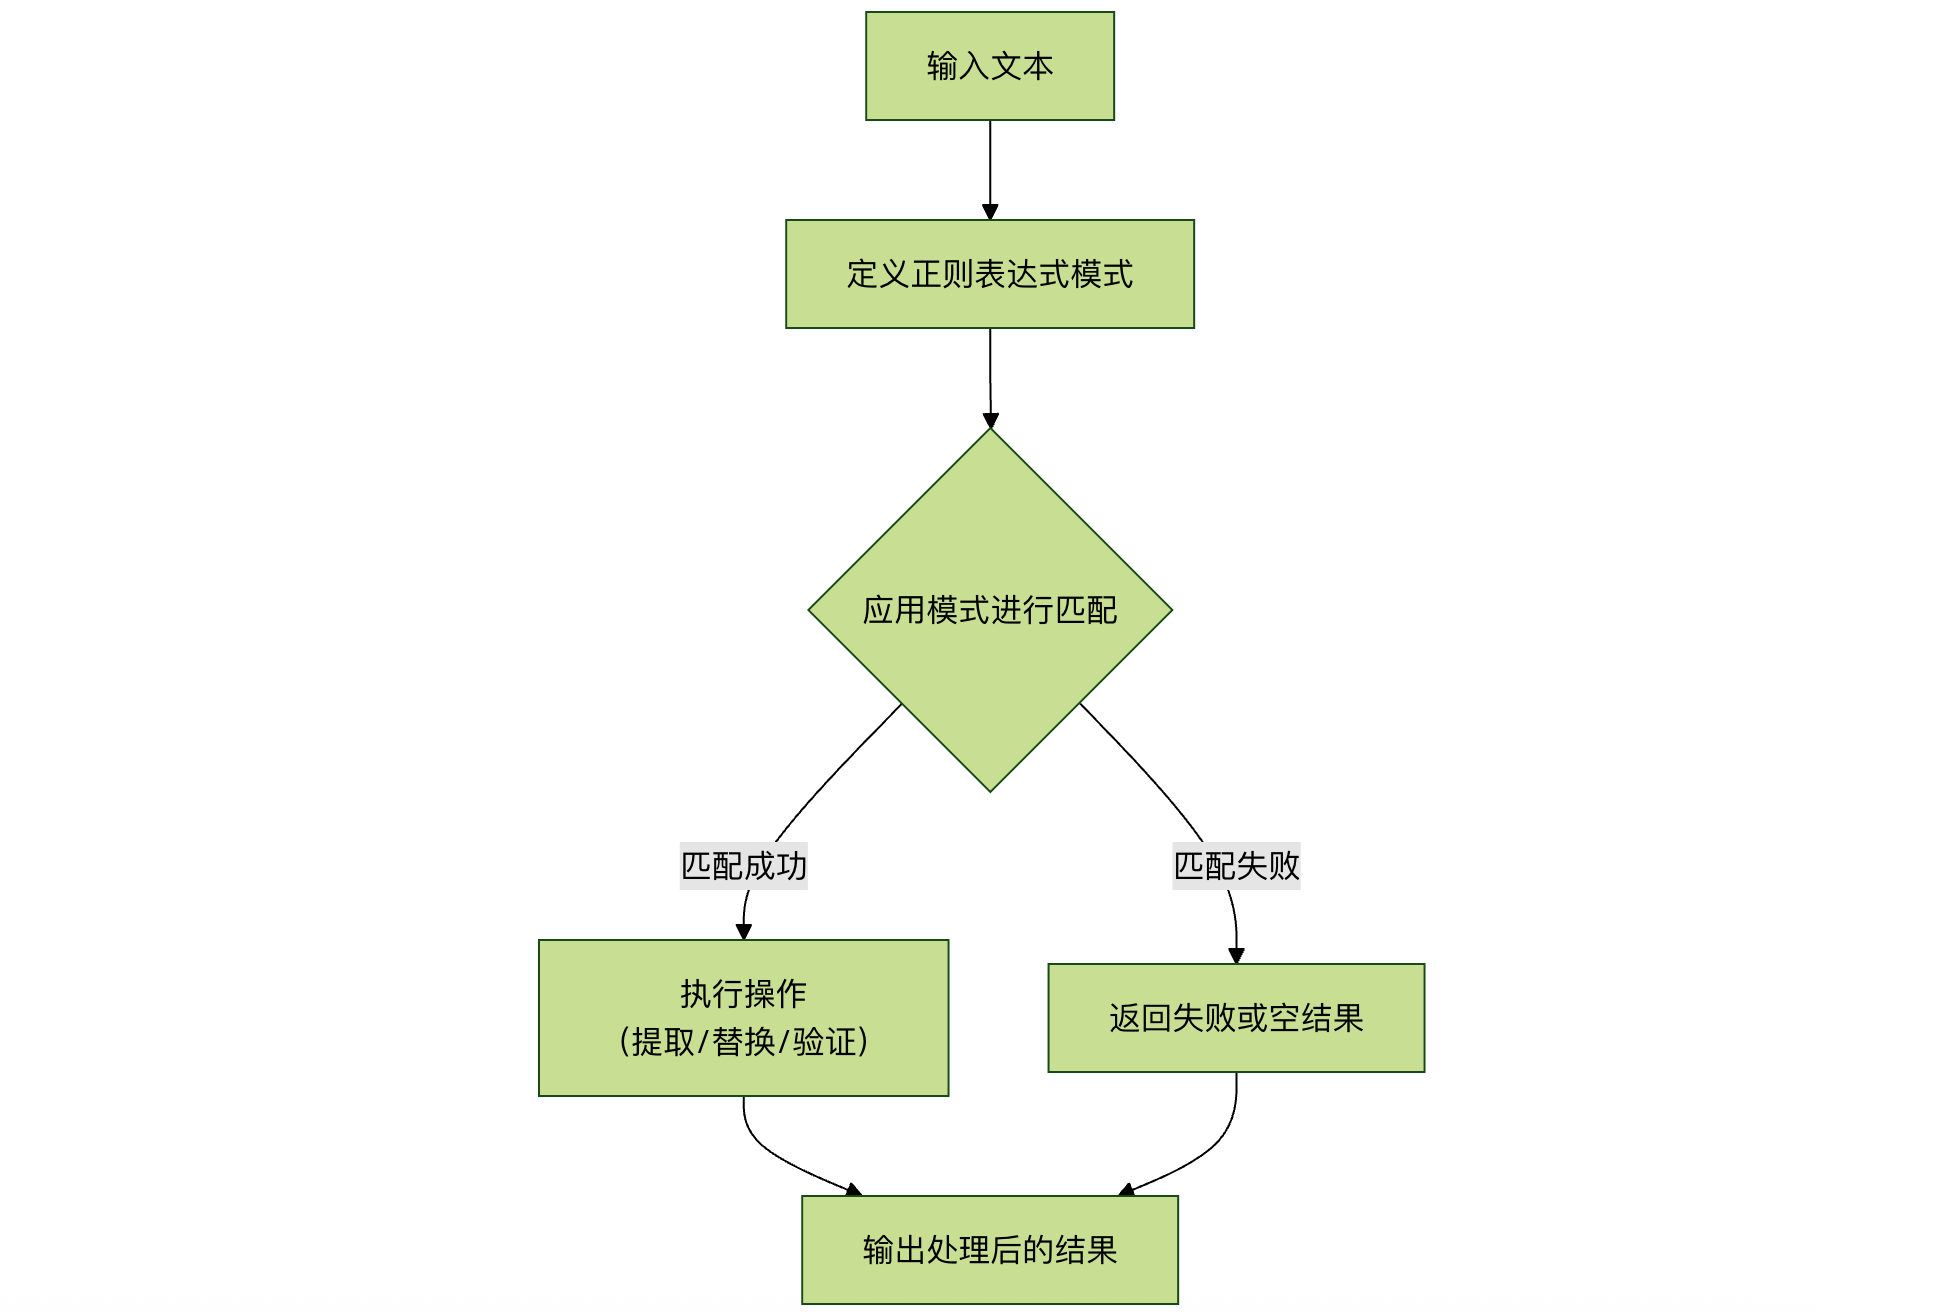
以下のフローチャートは、データ処理における正規表現の核となるワークフローをまとめたものです:
発展の歴史
正規表現の祖先は、人間の神経系がどのように機能するかに関する初期の研究にまで遡ることができます。神経生理学者であるWarren McCullochとWalter Pittsは、これらの神経ネットワークを記述する数学的手法を研究しました。
1951年、Stephen Kleeneという数学者がMcCullochとPittsの初期の研究に基づいて、「神経網事象の表現法」というタイトルの論文を発表し、正規表現の概念を導入しました。正規表現は、彼が正規集合の代数の式であり、そのため正規表現という用語が採用されました。
その後、この研究をKen Thompsonの計算検索アルゴリズムを用いた初期の研究に適用できることが発見されました。Ken ThompsonはUnixの主要な発明者です。正規表現の最初の実用的なアプリケーションは、Unixのgrepエディタでした。
おおよその発展の歴史は以下のとおりです:
1951年:計算理論の創始者の一人であるアメリカのコンピュータ科学者Stephen Kleeneが初めて正規言語の概念を提唱し、形式化された手法を用いてこの言語を記述しました。これにより、正規表現の発展の理論的基盤が築かれました。
1960年代:Unixオペレーティングシステムの共同創設者の一人であるKen Thompsonが、正規表現を実際に応用した最初のプログラムを開発しました。これはUnixのgrepコマンドの一部です。これは正規表現の実際の応用を示すものでした。
1970年代:Ken ThompsonとRob Pikeが最初の正規表現エンジンを開発し、Unixシステムで広く使用されました。これは正規表現の普及に重要な役割を果たしました。
1986年:Philip HazelがPCRE(Perl Compatible Regular Expressions)ライブラリを開発しました。これは、さまざまなプログラミング言語でPerlスタイルの正規表現を使用できるようにする正規表現ライブラリです。
1997年:IEEEがPOSIX.2標準を公開しました。これには正規表現の標準仕様が含まれており、異なるUnixシステム間で正規表現の動作がより一貫したものになりました。
2000年代以降:正規表現はコンピュータプログラミングとテキスト処理においてますます人気が高まり、正規表現をサポートするプログラミング言語やツールは、Perl、Python、Java、JavaScriptなど、より豊富で強力になりました。
現在:正規表現は今でもテキスト処理とデータ抽出の重要なツールであり、データサイエンス、テキスト分析、Webクローラー、文字列検索と置換などの分野で広く応用されています。
応用分野
現在、正規表現は多くのソフトウェアで広く応用されています。*nix(Linux、Unixなど)、HPなどのオペレーティングシステム、PHP、C#、Javaなどの開発環境、そして多くのアプリケーションソフトウェアでも、正規表現の姿を見ることができます。
C# 正規表現
C#チュートリアルでは、C# 正規表現この章では、C#の正規表現に関する知識を専門に紹介しています。
Java 正規表現
Javaチュートリアルでは、Java 正規表現この章では、Javaの正規表現に関する知識を専門に紹介しています。
JavaScript 正規表現
JavaScriptチュートリアルでは、JavaScript RegExp オブジェクトこの章では、JavaScriptの正規表現に関する知識を専門に紹介しており、完全なJavaScript RegExp オブジェクトリファレンスマニュアル。
Python 正規表現
Python基礎チュートリアルでは、Python 正規表現この章では、Pythonの正規表現に関する知識を専門に紹介しています。
Ruby 正規表現
Rubyチュートリアルでは、Ruby 正規表現この章では、Rubyの正規表現に関する知識を専門に紹介しています。
| コマンドまたは環境 | . | [ ] | ^ | $ | \( \) | \{ \} | ? | + | | | ( ) |
| vi | √ | √ | √ | √ | √ | |||||
| Visual C++ | √ | √ | √ | √ | √ | |||||
| awk | √ | √ | √ | √ | awkはこの構文をサポートしています。コマンドラインに --posix または --re-interval パラメータを追加するだけです。man awkのinterval expressionを参照してください。 | √ | √ | √ | √ | |
| sed | √ | √ | √ | √ | √ | √ | ||||
| delphi | √ | √ | √ | √ | √ | √ | √ | √ | √ | |
| python | √ | √ | √ | √ | √ | √ | √ | √ | √ | √ |
| java | √ | √ | √ | √ | √ | √ | √ | √ | √ | √ |
| javascript | √ | √ | √ | √ | √ | √ | √ | √ | √ | |
| php | √ | √ | √ | √ | √ | |||||
| perl | √ | √ | √ | √ | √ | √ | √ | √ | √ | |
| C# | √ | √ | √ | √ | √ | √ | √ | √ |
以下は、主流のプログラミング言語における正規表現サポートの比較です:
| プログラミング言語 | サポート方式 | 一般的なクラス/モジュール | 簡単な例(数字のマッチング) |
|---|---|---|---|
| JavaScript | 言語のネイティブサポート | RegExpオブジェクト、またはリテラルを使用/.../ |
/\d+/ 或 new RegExp("\\d+") |
| Python | 標準ライブラリreモジュール |
reモジュール |
re.compile(r"\d+") |
| Java | 標準ライブラリjava.util.regex 包 |
PatternとMatcher 类 |
Pattern.compile("\\d+") |
| PHP | 組み込みPCRE関数 | preg_一連の関数(例:preg_match) |
preg_match("/\d+/", $text) |
| C# | System.Text.RegularExpressions名前空間 |
Regex 类 |
new Regex(@"\d+") |
| Go | 標準ライブラリregexp 包 |
regexp 包 |
regexp.MustCompile(\d+) |
| Ruby | 言語のネイティブサポート、コアクラス | Regexp 类 |
/\d+/ |