Регулярные выражения -Введение
Регулярное выражение (regex или regexp для краткости) — это мощный инструмент обработки текста. Оно использует специальную строку для описания и сопоставления ряда строк, соответствующих определённому синтаксическому правилу.
Можно представить это каксупер-подстановочный знак. Обычные подстановочные знаки (такие как*представляющие любой символ) имеют ограниченную функциональность, тогда как регулярные выражения могут задавать чрезвычайно сложные и точные текстовые шаблоны — от простого сопоставления слов до извлечения сложных структурированных данных — почти что угодно.
Например, вы, вероятно, используете?и*подстановочные знаки для поиска файлов на жёстком диске.?Подстановочный знак соответствует 0 или 1 символу в имени файла, а*подстановочный знак соответствует нулю или более символам. Шаблон вродеdata(\w)?\.datнайдёт следующие файлы:
Использование символа*вместо символа?увеличивает количество найденных файлов.data.*\.datОн соответствует всем следующим файлам:
Хотя этот метод поиска полезен, он всё ещё ограничен. Понимая, как работают*подстановочные знаки, вводятся понятия, на которые опираются регулярные выражения, но регулярные выражения более мощные и более гибкие.
Использование регулярных выражений позволяет простым способом достичь мощной функциональности. Вот простой пример:
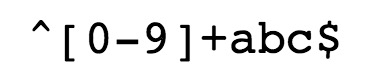
-
^Соответствует началу входной строки.
-
[0-9]+Соответствует нескольким цифрам,[0-9]соответствует одной цифре,+соответствует одной или более.
-
abc$Соответствует буквеabcи заканчивается наabcв конце,$соответствует концу входной строки.
При написании формы регистрации пользователя, если мы разрешаем именам пользователей содержать толькобуквы, цифры, подчёркивания и дефисы -, и задаём длину имени пользователя, мы можем использовать следующее регулярное выражение для его определения.
^[a-zA-Z0-9_-]{3,15}$
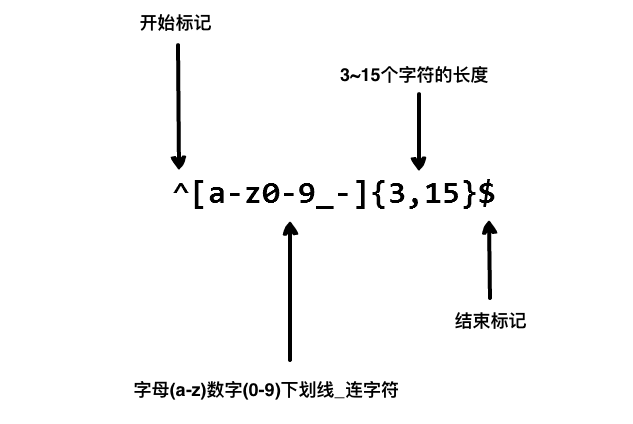
^Совпадает с началом строки.[a-zA-Z0-9_-]Обозначает набор символов, содержащий строчные буквы, прописные буквы, цифры, подчёркивания и дефисы-。{3,15}Указывает, что предшествующий набор символов должен встречаться не менее 3 раз и не более 15 раз, таким образом ограничивая длину имени пользователя от 3 до 15 символов.$Совпадает с концом строки.
Приведённое выше регулярное выражение может соответствоватьexample、example1、run-oob、run_oob, но не соответствуетru, потому что содержит слишком короткие буквы — меньше 3 символов, поэтому оно не может совпасть. Оно также не соответствуетexample$, потому что содержит специальные символы.

Пример
Сопоставляет строки, которые начинаются с цифры и заканчиваются на "abc".:
Текст, отмеченный ниже, — это выражение, которое дало совпадение:
Попробуйте »
Метасимволы и возможности регулярных выражений
Сопоставление символов
- Обычные символы: обычные символы сопоставляются буквально. Например, сопоставление буквы "a" сопоставит символ "a" в тексте.
- Метасимволы: метасимволы имеют особые значения. Например,
\dсоответствует любому цифровому символу,\wсоответствует любому буквенно-цифровому символу,.соответствует любому символу (кроме новой строки), и т. д.
Квантификаторы
*: Соответствует предыдущему шаблону ноль или более раз.+: Соответствует предыдущему шаблону один или более раз.?: Соответствует предыдущему шаблону ноль или один раз.{n}: Соответствует предыдущему шаблону ровно n раз.{n,}: Соответствует предыдущему шаблону как минимум n раз.{n,m}: Соответствует предыдущему шаблону как минимум n раз и не более m раз.
Классы символов
[ ]: Соответствует любому одному символу внутри скобок. Например,[abc]соответствует символам "a", "b" или "c".[^ ]: Соответствует любому символу, кроме тех, что внутри скобок. Например,[^abc]соответствует любому символу, кроме "a", "b" или "c".
Сопоставление границ
^: Совпадает с началом строки.$: Совпадает с концом строки.\b: Совпадает с границей слова.\B: Совпадает с не-границей слова.
Группировка и захват
( ): Используется для группировки и захвата подвыражений.(?: ): Используется для группировки, но не для захвата подвыражений.
Специальные символы
\: Экранирующий символ, используется для сопоставления с самим специальным символом..: Совпадает с любым символом (кроме символа новой строки).|: Используется для указания выбора среди нескольких шаблонов.
Определение и применение регулярных выражений
Технически, регулярное выражение — это строка, состоящая из обычных символов (таких как буквы от a до z) и специальных символов (называемых метасимволами). Эта строка образуетпоисковый шаблон, который используется для поиска, сопоставления, замены или разделения текста.
Основные применения
У регулярных выражений есть три основных применения:
- Поиск и сопоставление текста: Быстро определить, содержит ли фрагмент текста подстроку, соответствующую определённому шаблону. Например, проверить, является ли строка допустимым форматом адреса электронной почты.
- Замена текста: Заменить все части текста, соответствующие определённому шаблону, новым содержимым. Например, изменить все форматы даты в документе с
YYYY-MM-DDединообразно наMM/DD/YYYY。 - Извлечение и разделение текста: Точно извлекать нужные нам части из большого фрагмента текста или разделять текст на массив по определённым разделителям. Например, извлечь все IP-адреса из файла журнала или разделить строку CSV запятыми.
Сценарии применения регулярных выражений
Регулярные выражения пронизывают почти все аспекты программирования и повседневной обработки текста. Ниже приведены некоторые из наиболее распространённых сценариев применения:
1. Проверка данных
Это одно из самых классических применений регулярных выражений, гарантирующее, что пользовательский ввод соответствует ожидаемому формату.
- Проверка адресов электронной почты: Проверить, похож ли ввод на
username@domain.com。 - Проверка номеров телефонов: Проверить, соответствует ли он формату мобильного номера страны/региона (например, 11-значному номеру Китая).
- Проверка надежности пароля: Требовать, чтобы пароли содержали заглавные и строчные буквы, цифры и специальные символы.
- Проверка форматов даты: Убедитесь, что дата указана в допустимых форматах, таких как
2023-12-25или12/25/2023. - Проверка номеров удостоверений личности: Сопоставлять номера удостоверений личности, соответствующие определенным правилам кодирования.
2. Поиск и фильтрация текста
Быстро находить информацию в больших объёмах текста.
- Анализ журналов: Поиск в серверных журналах всех записей на
ERRORилиWARNуровень. - Поиск кода: В IDE или редакторе используйте регулярные выражения для поиска всех определений функций (например,
function xxx(...)) или конкретных имён переменных. - Поиск по содержимому документа: Найти все вхождения номеров телефонов или URL в длинном документе.
3. Замена и очистка текста
Пакетно изменять текстовое содержимое для его нормализации.
- Форматирование данных: Форматировать номера телефонов из
12345678901в123-4567-8901。 - Очистка данных: удаление лишних пробельных символов из текста (например, нескольких подряд идущих пробелов или символов табуляции).
- Маскирование конфиденциальной информации: замена номеров удостоверений личности в тексте на
***, например110101199001011234->110101********1234。 - Рефакторинг кода: пакетное переименование переменных или имён функций.
4. Извлечение и разбор текста
Извлечение структурированных данных из неструктурированного текста.
- Веб-краулеры: извлечение всех ссылок из HTML-кода (
href="...") или адрес изображения (src="...")。 - Разобрать файл конфигурации: прочитать
key = valueфайл конфигурации в формате. - Извлечение конкретных данных: извлечь все вхождения сумм из фрагмента текста (например,
¥100.50или$99.99)。
5. Разделение строк
Используйте сложные правила, а не просто один символ, для разделения строк.
- Разделите предложение, используя один или несколько пробелов, запятых или точек с запятой.
- На основе различных разделителей (таких как
,、;、\t) для разбора данных CSV или TSV.
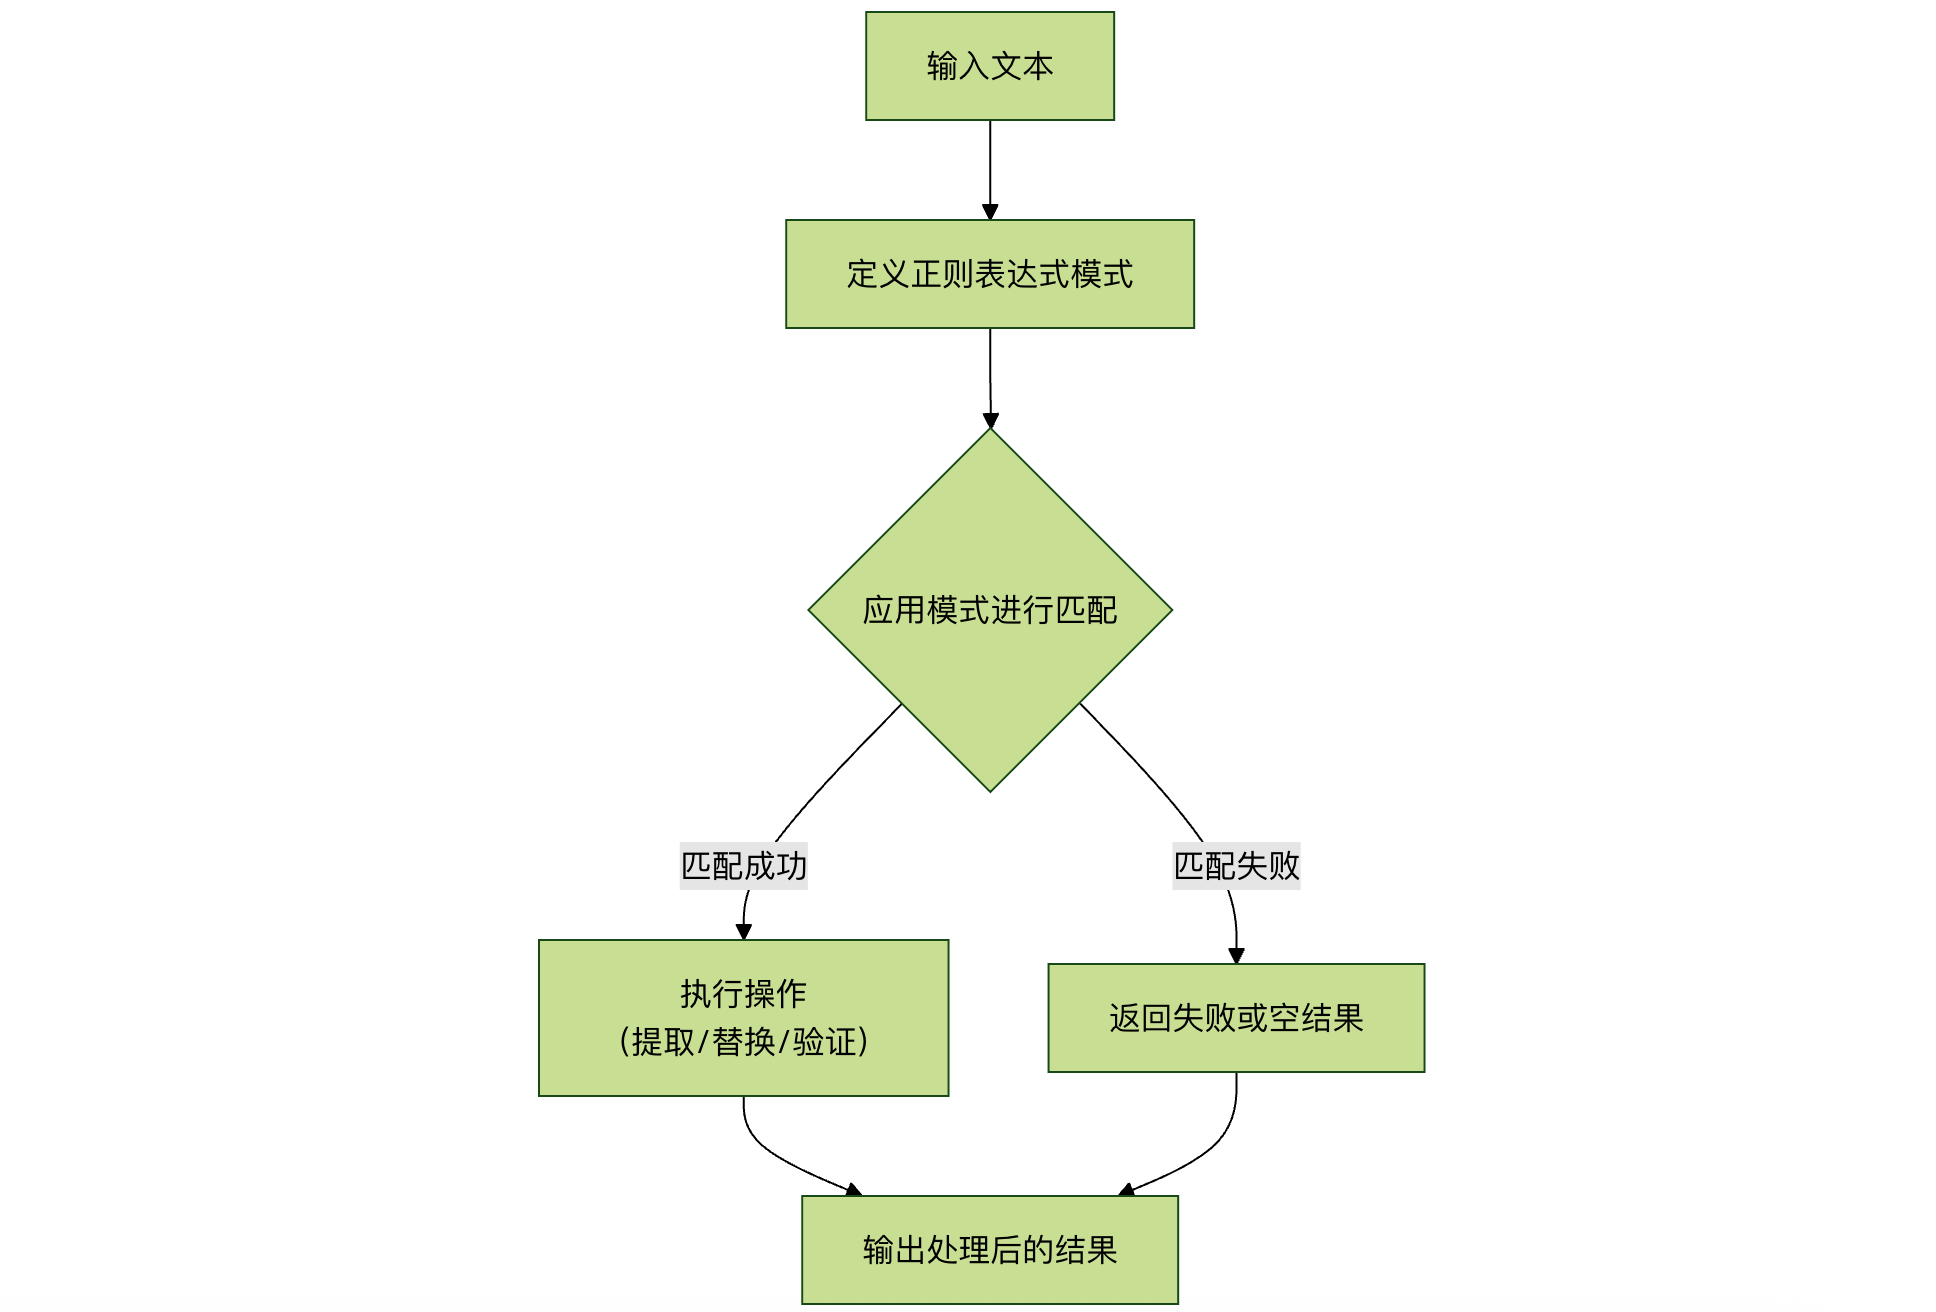
Следующая блок-схема обобщает основной рабочий процесс регулярных выражений при обработке данных:
История разработки
Предшественников регулярных выражений можно проследить до ранних исследований того, как работает нервная система человека. Уоррен МакКаллок и Уолтер Питтс, два нейрофизиолога, разработали математический способ описания таких нейронных сетей.
В 1951 году математик по имени Стивен Клини, опираясь на раннюю работу МакКаллока и Питтса, опубликовал статью под названием «Представление событий в нервных сетях», введя понятие регулярных выражений. Регулярные выражения — это выражения, используемые для описания того, что он называлалгеброй регулярных множеств, поэтому был принят терминрегулярное выражение.
Впоследствии было обнаружено, что эту работу можно применить в некоторых ранних исследованиях с использованием алгоритмов вычислительного поиска Кена Томпсона. Кен Томпсон был одним из главных создателей Unix. Первым практическим применением регулярных выражений стал редактор grep в Unix.
Примерная история развития выглядит так:
1951: Стивен Клини, один из основателей теории вычислений и американский учёный в области информатики, впервые предложил понятие регулярных языков и использовал формальные методы для описания этого языка. Это заложило теоретическую основу для разработки регулярных выражений.
1960-е: Кен Томпсон, один из соучредителей операционной системы Unix, разработал первую программу, которая действительно применяла регулярные выражения; это была часть команды grep в Unix. Это ознаменовало практическое применение регулярных выражений.
1970-е: Кен Томпсон и Роб Пайк разработали первый движок регулярных выражений, широко использовавшийся в Unix-системах, что сыграло ключевую роль в популяризации регулярных выражений.
1986: Филип Хейзел разработал библиотеку PCRE (Perl Compatible Regular Expressions) — библиотеку регулярных выражений, которая позволяет использовать регулярные выражения в стиле Perl в разных языках программирования.
1997: IEEE выпустил стандарт POSIX.2, который включает стандартную спецификацию регулярных выражений, что сделало поведение регулярных выражений более согласованным в разных системах Unix.
После 2000-х годов: регулярные выражения стали всё более популярными в программировании и обработке текста. Языки программирования и инструменты, поддерживающие регулярные выражения, стали богаче и мощнее, например Perl, Python, Java, JavaScript и т. д.
В настоящее время: регулярные выражения остаются важным инструментом обработки текста и извлечения данных, широко применяются в таких областях, как наука о данных, анализ текста, веб-сканеры, поиск и замена строк и многих других.
Области применения
В настоящее время регулярные выражения широко используются во многих программных системах, включая *nix (Linux, Unix и т. д.), HP и другие операционные системы, среды разработки, такие как PHP, C#, Java, и множество прикладных программ; следы регулярных выражений можно встретить повсюду.
Регулярные выражения C#
В нашем руководстве по C#,Регулярные выражения C#эта глава посвящена знакомству с регулярными выражениями C#.
Регулярные выражения в Java
В нашем руководстве по Java,Регулярные выражения Javaэта глава посвящена знакомству с регулярными выражениями Java.
Регулярные выражения JavaScript
В нашем руководстве по JavaScript,Объект RegExp JavaScriptэта глава посвящена знакомству с регулярными выражениями JavaScript, а также мы предоставляем полныйСправочник по объекту RegExp JavaScript。
Регулярные выражения Python
В нашем базовом руководстве по Python,Регулярные выражения Pythonэта глава посвящена знакомству с регулярными выражениями Python.
Регулярные выражения Ruby
В нашем учебнике по Ruby,Регулярные выражения Rubyэта глава посвящена знакомству с регулярными выражениями Ruby.
| Команда или среда | . | [ ] | ^ | $ | \( \) | \{ \} | ? | + | | | ( ) |
| vi | √ | √ | √ | √ | √ | |||||
| Visual C++ | √ | √ | √ | √ | √ | |||||
| awk | √ | √ | √ | √ | awk поддерживает этот синтаксис; просто добавьте параметр --posix или --re-interval в командной строке. См. интервальное выражение в man awk. | √ | √ | √ | √ | |
| sed | √ | √ | √ | √ | √ | √ | ||||
| delphi | √ | √ | √ | √ | √ | √ | √ | √ | √ | |
| python | √ | √ | √ | √ | √ | √ | √ | √ | √ | √ |
| java | √ | √ | √ | √ | √ | √ | √ | √ | √ | √ |
| javascript | √ | √ | √ | √ | √ | √ | √ | √ | √ | |
| php | √ | √ | √ | √ | √ | |||||
| perl | √ | √ | √ | √ | √ | √ | √ | √ | √ | |
| C# | √ | √ | √ | √ | √ | √ | √ | √ |
Ниже приведено сравнение поддержки регулярных выражений в основных языках программирования:
| Язык программирования | Способ поддержки | Общие классы/модули | Простой пример (сопоставление цифр) |
|---|---|---|---|
| JavaScript | Поддержка родного языка | RegExpобъект, или использование литерала/.../ |
/\d+/илиnew RegExp("\\d+") |
| Python | Стандартная библиотекаreМодуль |
reМодуль |
re.compile(r"\d+") |
| Java | Стандартная библиотекаjava.util.regexПакет |
PatternиMatcherКласс |
Pattern.compile("\\d+") |
| PHP | Встроенные функции PCRE | preg_ряд функций (таких какpreg_match) |
preg_match("/\d+/", $text) |
| C# | System.Text.RegularExpressionsnamespace |
RegexКласс |
new Regex(@"\d+") |
| Go | Стандартная библиотекаregexpПакет |
regexpПакет |
regexp.MustCompile(\d+) |
| Ruby | Поддержка родного языка, основной класс | RegexpКласс |
/\d+/ |