Tri rapide randomisé
Le tri rapide est l'un des algorithmes de tri les plus classiques en informatique, connu pour sa complexité temporelle moyenne de O(n log n). Cependant, lorsque les données d'entrée sont déjà triées ou presque triées, le tri rapide traditionnel dégénère vers une complexité temporelle de O(n²). Le tri rapide randomisé résout habilement ce problème en introduisant de l'aléatoire.
Avant d'aborder le tri rapide randomisé, commençons par revoir l'idée centrale du tri rapide traditionnel.
Fonctionnement du tri rapide
Le tri rapide utilise lastratégie diviser pour régner; les étapes de base sont les suivantes :
- Sélectionner la valeur pivotChoisir un élément du tableau comme valeur pivot.
- Opération de partitionnementRéorganiser le tableau afin que tous les éléments inférieurs au pivot soient placés avant lui, et que tous les éléments supérieurs au pivot soient placés après lui.
- tri récursifAppliquer récursivement le même processus aux sous-tableaux situés de part et d’autre du pivot.
Problèmes du tri rapide traditionnel
Les performances du tri rapide traditionnel dépendent fortement du choix du pivot. L’algorithme est plus efficace lorsque le pivot peut à peu près diviser le tableau en deux moitiés égales à chaque fois. Cependant, les performances se dégradent considérablement dans les cas suivants :
- Tableau triéSi le tableau est déjà trié, choisir chaque fois le dernier élément comme pivot conduit à des partitions extrêmement déséquilibrées.
- Tableau en ordre inverseSemblable à un tableau trié, mais dans la direction opposée.
- Éléments en doubleUn grand nombre d’éléments en double peut également provoquer des partitions déséquilibrées.
Dans ces pires scénarios, la complexité temporelle du tri rapide se dégrade en O(n²), comparable à celle d’algorithmes simples tels que le tri à bulles.
Le tri rapide aléatoire évite les pires scénarios en introduisant de l’aléatoire, ce qui garantit que l’algorithme conserve de bonnes performances moyennes sur diverses entrées.
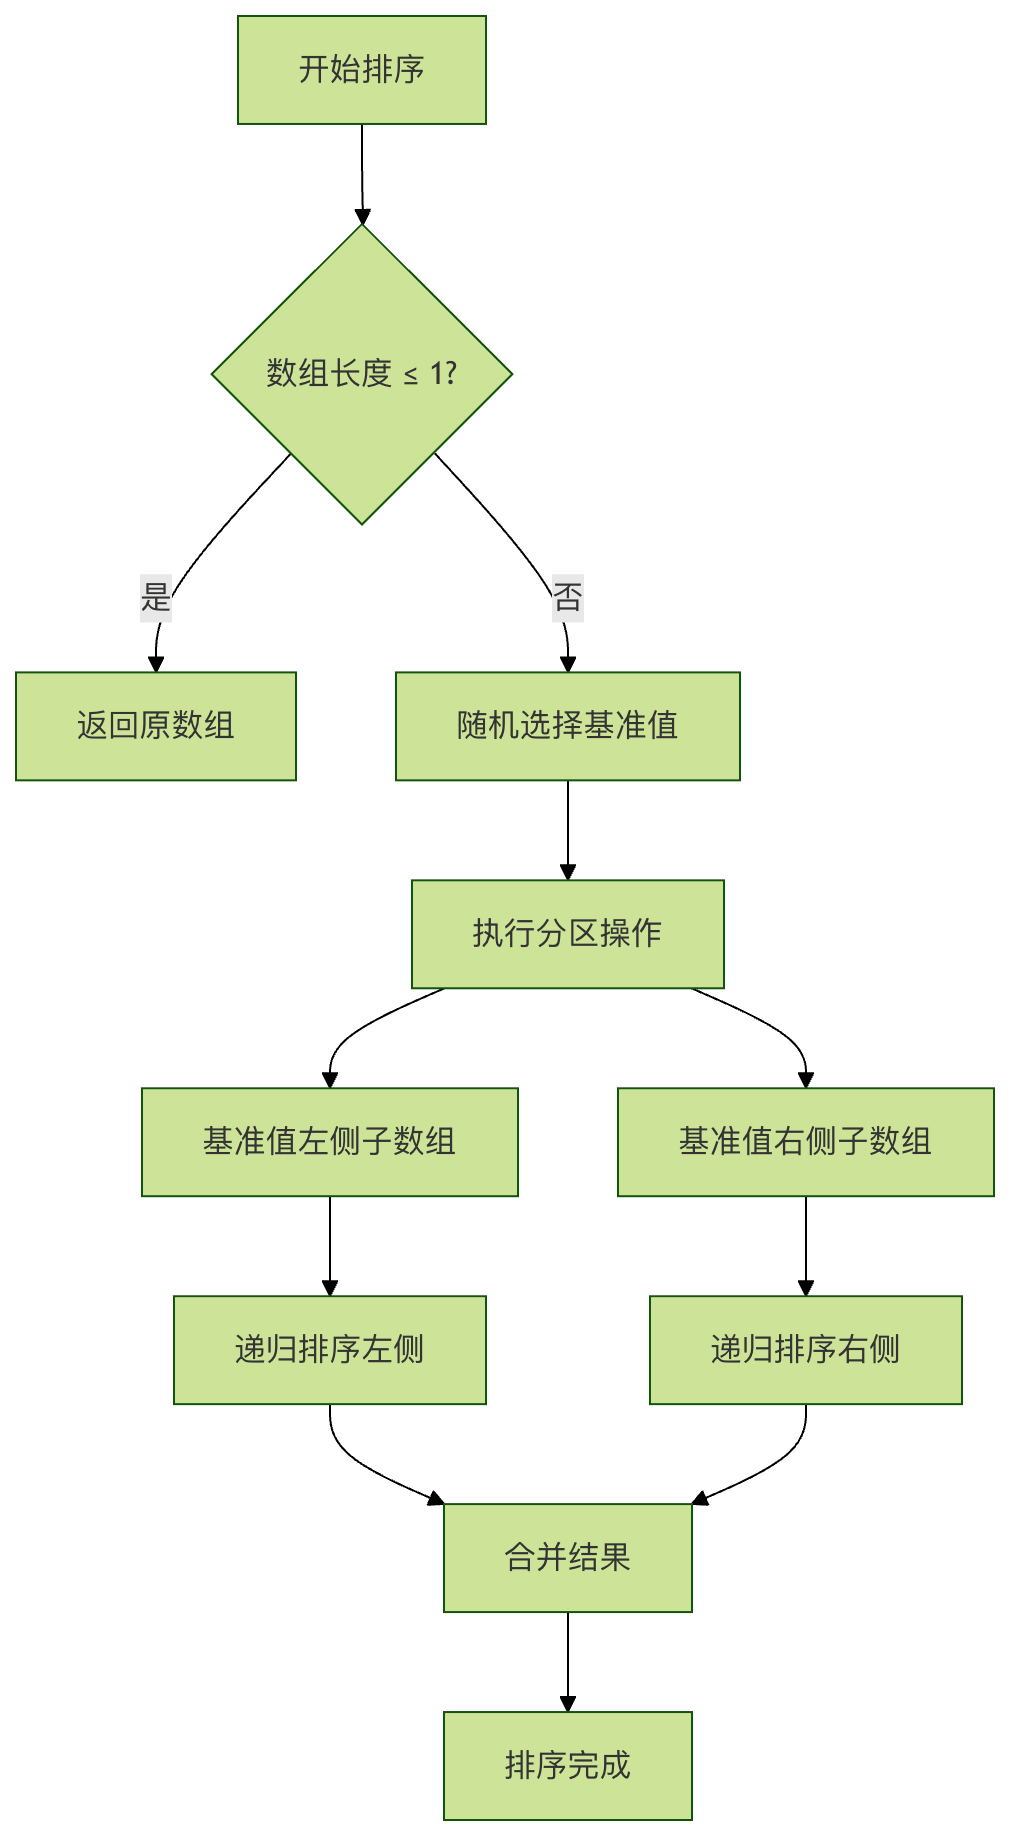
L'amélioration principale du tri rapide randomisé est très simple :Sélectionner le pivot de manière aléatoirePlutôt que de toujours choisir le premier, le dernier ou l'élément du milieu, un élément aléatoire est sélectionné comme pivot. Ce caractère aléatoire rend la probabilité du pire cas extrêmement faible, garantissant ainsi une complexité temporelle attendue de O(n log n).
Idée de base du tri rapide randomisé :Par une seule passe de tri, les données à trier sont divisées en deux parties indépendantes, où toutes les données d'une partie sont plus petites que toutes les données de l'autre partie. Ensuite, le tri rapide est appliqué récursivement à chacune de ces deux parties. L'ensemble du processus de tri peut se dérouler récursivement, transformant ainsi l'ensemble des données en une séquence ordonnée.
Avantages de l'algorithme
| Fonctionnalités | Tri rapide traditionnel | Tri rapide randomisé |
|---|---|---|
| Complexité temporelle dans le pire des cas | O(n²) | O(n²) (mais avec une probabilité extrêmement faible) |
| Complexité temporelle moyenne | O(n log n) | O(n log n) |
| Conditions du pire cas | Entrées spécifiques (comme des tableaux déjà triés) | La sélection aléatoire tombe toujours sur la valeur extrême |
| Complexité spatiale | O(log n) (pile de récursion) | O(log n) (pile de récursion) |
| Stabilité | instable | instable |
Bien que la complexité temporelle dans le pire cas du tri rapide randomisé reste théoriquement O(n²), en pratique la probabilité que ce pire cas se produise est extrêmement faible. Pour un tableau de n éléments, la probabilité que la sélection aléatoire des pivots conduise au pire cas est d'environ 1/n!, ce qui est pratiquement impossible.
Diagramme du processus
Dans un tableau, sélectionnez un pivot, par exemple le 4 en première position, puis déplacez le 4 vers sa position correcte afin que les données du sous-tableau précédent soient inférieures à 4 et que les données du sous-tableau suivant soient supérieures à 4, puis continuez récursivement jusqu'à ce que le tri complet soit terminé.
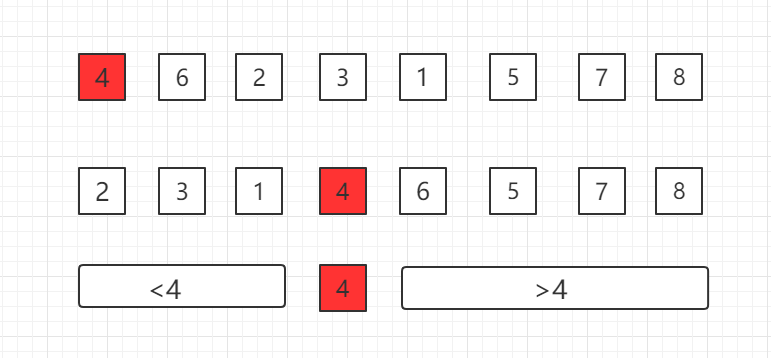
La manière de déplacer les données du pivot sélectionné vers sa position correcte est le cœur du tri rapide, et nous appelons ce processus Partition.
Le processus est le suivant, oùiest la position de l'élément actuellement parcouru et comparé :
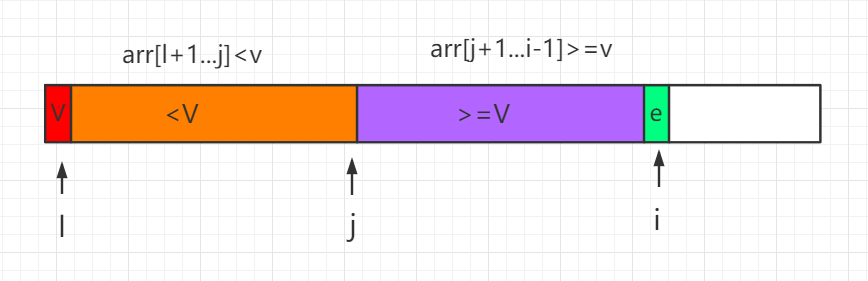
Ce processus de partition est exprimé en code comme suit :
Exemple
private static int partition(Comparable[] arr, int l, int r){
Comparable v = arr[l];
int j = l;
for( int i = l + 1 ; i <= r ; i ++ )
if( arr[i].compareTo(v) < 0 ){
j ++;
// Échanger les positions des éléments du tableau
swap(arr, j, i);
}
swap(arr, l, j);
return j;
}
...
Si le tri rapide est appliqué à un tableau presque trié, les sous-tableaux après chaque partition sont extrêmement déséquilibrés, et il peut facilement dégénérer enO(n^2)un algorithme de complexité temporelle. Nous devons optimiser le code ci-dessus en sélectionnant aléatoirement un pivot comme référence, ce que l'on appelle l'algorithme de tri rapide randomisé. Il nous suffit d'ajouter la ligne suivante avant le code ci-dessus pour sélectionner aléatoirement un élément du tableau et l'échanger avec les données du pivot.
swap( arr, l , (int)(Math.random()*(r-l+1))+l );
Exemple de code Java
Téléchargement du paquet de code source :Télécharger
Code du fichier QuickSort.java :
/**
* Tri rapide randomisé
*/
public class QuickSort {
// Effectuer l'opération de partition sur la partie arr[l...r]
// Retourner p, tel que arr[l...p-1] < arr[p] ; arr[p+1...r] > arr[p]
private static int partition(Comparable[] arr, int l, int r){
// Sélectionne aléatoirement une valeur comme pivot dans la plage arr[l...r]
swap( arr, l , (int)(Math.random()*(r-l+1))+l );
Comparable v = arr[l];
// arr[l+1...j] < v ; arr[j+1...i) > v
int j = l;
for( int i = l + 1 ; i <= r ; i ++ )
if( arr[i].compareTo(v) < 0 ){
j ++;
swap(arr, j, i);
}
swap(arr, l, j);
return j;
}
// Utiliser récursivement le tri rapide pour trier la plage arr[l...r]
private static void sort(Comparable[] arr, int l, int r){
if (l >= r) {
return;
}
int p = partition(arr, l, r);
sort(arr, l, p-1 );
sort(arr, p+1, r);
}
public static void sort(Comparable[] arr){
int n = arr.length;
sort(arr, 0, n-1);
}
private static void swap(Object[] arr, int i, int j) {
Object t = arr[i];
arr[i] = arr[j];
arr[j] = t;
}
// Test de QuickSort
public static void main(String[] args) {
// Le tri rapide est aussi un algorithme de complexité O(n log n)
// Peut facilement traiter des données de l'ordre de 1 million en 1 seconde
int N = 1000000;
Integer[] arr = SortTestHelper.generateRandomArray(N, 0, 100000);
sort(arr);
SortTestHelper.printArray(arr);
}
}
Implémentation du tri rapide randomisé
Implémentation Python
Exemple
def randomized_quick_sort(arr, low=None, high=Aucune):
"""
Fonction principale pour le tri rapide randomisé
Paramètres :
arr : la liste à trier
low : indice de début du sous-tableau (par défaut 0)
high : indice de fin du sous-tableau (par défaut len(arr)-1)
Retourne :
La liste triée (triée sur place ; renvoie également la liste triée)
"""
# Définir les paramètres par défaut
if low is None:
low = 0
if high is None:
high = len(arr) - 1
# Condition d'arrêt de la récursion : la longueur du sous-tableau est inférieure ou égale à 1
if low < high:
# Sélectionner aléatoirement le pivot et partitionner
pivot_index = randomized_partition(arr, low, high)
# Trier récursivement les sous-tableaux gauche et droit
randomized_quick_sort(arr, low, pivot_index - 1)
randomized_quick_sort(arr, pivot_index + 1, high)
return arr
def randomized_partition(arr, low, high):
"""
Fonction de partition aléatoire
Paramètres :
arr : la liste à partitionner
low : indice de début du sous-tableau
high : indice de fin du sous-tableau
Retourne :
L'indice de la position finale de la valeur du pivot
"""
# Sélectionner aléatoirement un indice comme position du pivot
random_index = random.randint(low, high)
# Échanger l'élément sélectionné aléatoirement avec le dernier élément
arr[random_index], arr[high] = arr[high], arr[random_index]
# Utiliser le dernier élément (qui est maintenant l'élément sélectionné aléatoirement) comme pivot
return partition(arr, low, high)
def partition(arr, low, high):
"""
Fonction de partition (identique à quicksort)
Paramètres :
arr : la liste à partitionner
low : indice de début du sous-tableau
high : indice de fin du sous-tableau
Retourne :
L'indice de la position finale de la valeur du pivot
"""
pivot = arr[high] # Pivot
i = low - 1 # Limite de la région inférieure au pivot
for j in range(low, high):
if arr[j] <= pivot:
i += 1
# Échanger les éléments
arr[i], arr[j] = arr[j], arr[i]
# Placer le pivot à la position correcte
arr[i + 1], arr[high] = arr[high], arr[i + 1]
return i + 1
# Données de test
test_data = [3, 6, 8, 10, 1, 2, 1]
print("Tableau d'origine :", test_data)
print("Tableau trié :", randomized_quick_sort(test_data.copy()))
Analyse de la complexité temporelle
La complexité temporelle du quicksort randomisé peut être exprimée par la formule suivante :
\[ T(n) = O(n) + T(k) + T(n - k - 1) \]
Où :
- \( O(n) \) est le temps de l'opération de partition.
- \( T(k) \) est le temps nécessaire pour trier le sous-tableau gauche.
- \( T(n - k - 1) \) est le temps nécessaire pour trier le sous-tableau de droite.
- \( k \) est le nombre d'éléments à gauche de la valeur du pivot.
Dans la version randomisée, la valeur attendue de \( k \) est \( n/2 \), donc la complexité temporelle attendue est :
\[ E[T(n)] = O(n \log n) \]
Variantes et optimisations du tri rapide randomisé
1. Tri rapide à trois voies
Lorsque le tableau contient de nombreux doublons, le tri rapide à deux voies traditionnel n'est pas efficace. Le tri rapide à trois voies divise le tableau en trois parties : les éléments inférieurs au pivot, égaux au pivot et supérieurs au pivot.
Exemple
"""Tri rapide randomisé à trois voies"""
if low is None:
low = 0
if high is None:
high = len(arr) - 1
if low < high:
# Sélectionner aléatoirement le pivot
random_index = random.randint(low, high)
arr[random_index], arr[low] = arr[low], arr[random_index]
pivot = arr[low]
# Partition en trois voies
lt = low # Frontière de région pour les valeurs inférieures au pivot
gt = high # Frontière de région pour les valeurs supérieures au pivot
i = low + 1 # Élément actuel en cours de vérification
while i <= gt:
if arr[i] < pivot:
arr[lt], arr[i] = arr[i], arr[lt]
lt += 1
i += 1
elif arr[i] > pivot:
arr[i], arr[gt] = arr[gt], arr[i]
gt -= 1
else:
i += 1
# Trier récursivement les partitions inférieures et supérieures au pivot
randomized_three_way_quick_sort(arr, low, lt - 1)
randomized_three_way_quick_sort(arr, gt + 1, high)
return arr
# Test avec des données contenant des doublons
test_data_with_duplicates = [3, 6, 3, 8, 1, 3, 6, 1]
print("Tableau d'origine (avec doublons) :", test_data_with_duplicates)
print("Après le tri rapide à trois voies :", randomized_three_way_quick_sort(test_data_with_duplicates.copy()))
2. Optimisation des petits tableaux
Pour les tableaux très petits (généralement moins de 10-20 éléments), le tri par insertion peut être plus efficace que le tri rapide. Nous pouvons combiner les avantages des deux algorithmes :
Exemple
"""Tri rapide aléatoire optimisé : utiliser le tri par insertion pour les petits tableaux"""
if low is None:
low = 0
if high is None:
high = len(arr) - 1
# Utiliser le tri par insertion pour les petits tableaux
if high - low + 1 <= threshold:
insertion_sort(arr, low, high)
return arr
if low < high:
pivot_index = randomized_partition(arr, low, high)
optimized_randomized_quick_sort(arr, low, pivot_index - 1, threshold)
optimized_randomized_quick_sort(arr, pivot_index + 1, high, threshold)
return arr
def insertion_sort(arr, low, high):
"""Tri par insertion, utilisé pour trier de petits tableaux"""
for i in range(low + 1, high + 1):
key = arr[i]
j = i - 1
while j >= low and arr[j] > key:
arr[j + 1] = arr[j]
j -= 1
arr[j + 1] = key
# Tester l'optimisation des petits tableaux
small_test_data = [9, 3, 7, 1, 5, 2, 8, 4, 6]
print("Petit tableau d'origine :", small_test_data)
print("Après le tri optimisé :", optimized_randomized_quick_sort(small_test_data.copy(), threshold=5))
Comparaison des performances et recommandations pratiques
Test de performance
Comparons les performances de différents algorithmes de tri à l'aide de tests pratiques.
Exemple
import random as rand
def performance_test():
"""Test de performance : comparer les temps d'exécution de différents algorithmes de tri"""
algorithmes = {
"Tri rapide aléatoire": randomized_quick_sort,
"Tri rapide à trois voies": randomized_three_way_quick_sort,
"Tri rapide optimisé": optimized_randomized_quick_sort,
}
# Générer les données de test
test_sizes = [100, 1000, 10000]
for size in test_sizes:
print(f"\nTaille du tableau de test : {size}")
# Générer différents types de données de test
test_cases = {
"Données aléatoires": [rand.randint(0, 10000) for _ in range(size)],
"Données triées": list(range(size)),
"Données inversées": list(range(size, 0, -1)),
Grande quantité de données dupliquées: [rand.randint(0, 10) for _ in range(size)],
}
for case_name, test_data in test_cases.items():
print(f" {case_name}:")
for algo_name, algo_func in algorithms.items():
data_copy = test_data.copy()
start_time = time.time()
algo_func(data_copy)
end_time = time.time()
execution_time = (end_time - start_time) * 1000 # Convertir en millisecondes
print(f" {algo_name}: {execution_time:.2f} ms")
# Exécuter le test de performance (remarque : cela peut prendre du temps pour les grands tableaux)
# performance_test()