Tri par fusion
Le tri fusion (en anglais : Merge sort, ou mergesort) est un algorithme de tri efficace basé sur l'opération de fusion.
Le tri fusion est une application très typique de l'approche diviser pour régner (Divide and Conquer). Il fusionne des sous-séquences déjà ordonnées pour obtenir une séquence entièrement ordonnée ; c'est-à-dire, rendre d'abord chaque sous-séquence ordonnée, puis rendre ordonnés les segments entre les sous-séquences. Fusionner deux listes ordonnées en une seule liste ordonnée s'appelle une fusion à deux voies.
Imaginez que vous devez trier un jeu de cartes à jouer complètement mélangé. Une méthode efficace consiste à : d'abord diviser le paquet en deux piles plus petites, trier chaque pile séparément, puis fusionner ces deux piles ordonnées en un paquet entièrement ordonné.Tri fusionC'est précisément sur cetteapproche de diviser pour régnerque repose l'algorithme de tri classique de la pensée.
Ses opérations principales peuvent être résumées en deux étapes :
- Diviser: Diviser récursivement une grande liste non ordonnée par le milieu, encore et encore, en la décomposant en de nombreuses petites sous-listes, jusqu'à ce que chaque sous-liste ne contienne qu'un seul élément (une liste d'un seul élément est naturellement ordonnée).
- Conquérir: Fusionner récursivement ces sous-listes ordonnées deux à deux, en triant pendant le processus de fusion, et enfin les fusionner en une seule liste ordonnée complète.
Applicabilité
Le tri fusion est adapté aux scénarios comportant de grandes quantités de données et où la stabilité est requise.
Le tri fusion est un algorithme de tri stable (c'est-à-dire que l'ordre relatif des éléments égaux reste inchangé après le tri). Sa complexité temporelle est O(n log n) dans tous les cas, ce qui le rend très efficace lors du traitement de données à grande échelle, mais sa complexité spatiale est O(n), car le processus de fusion nécessite des tableaux supplémentaires pour stocker temporairement les données.
L'organigramme suivant montre clairement l'ensemble du processus de diviser pour régner dans le tri fusion :
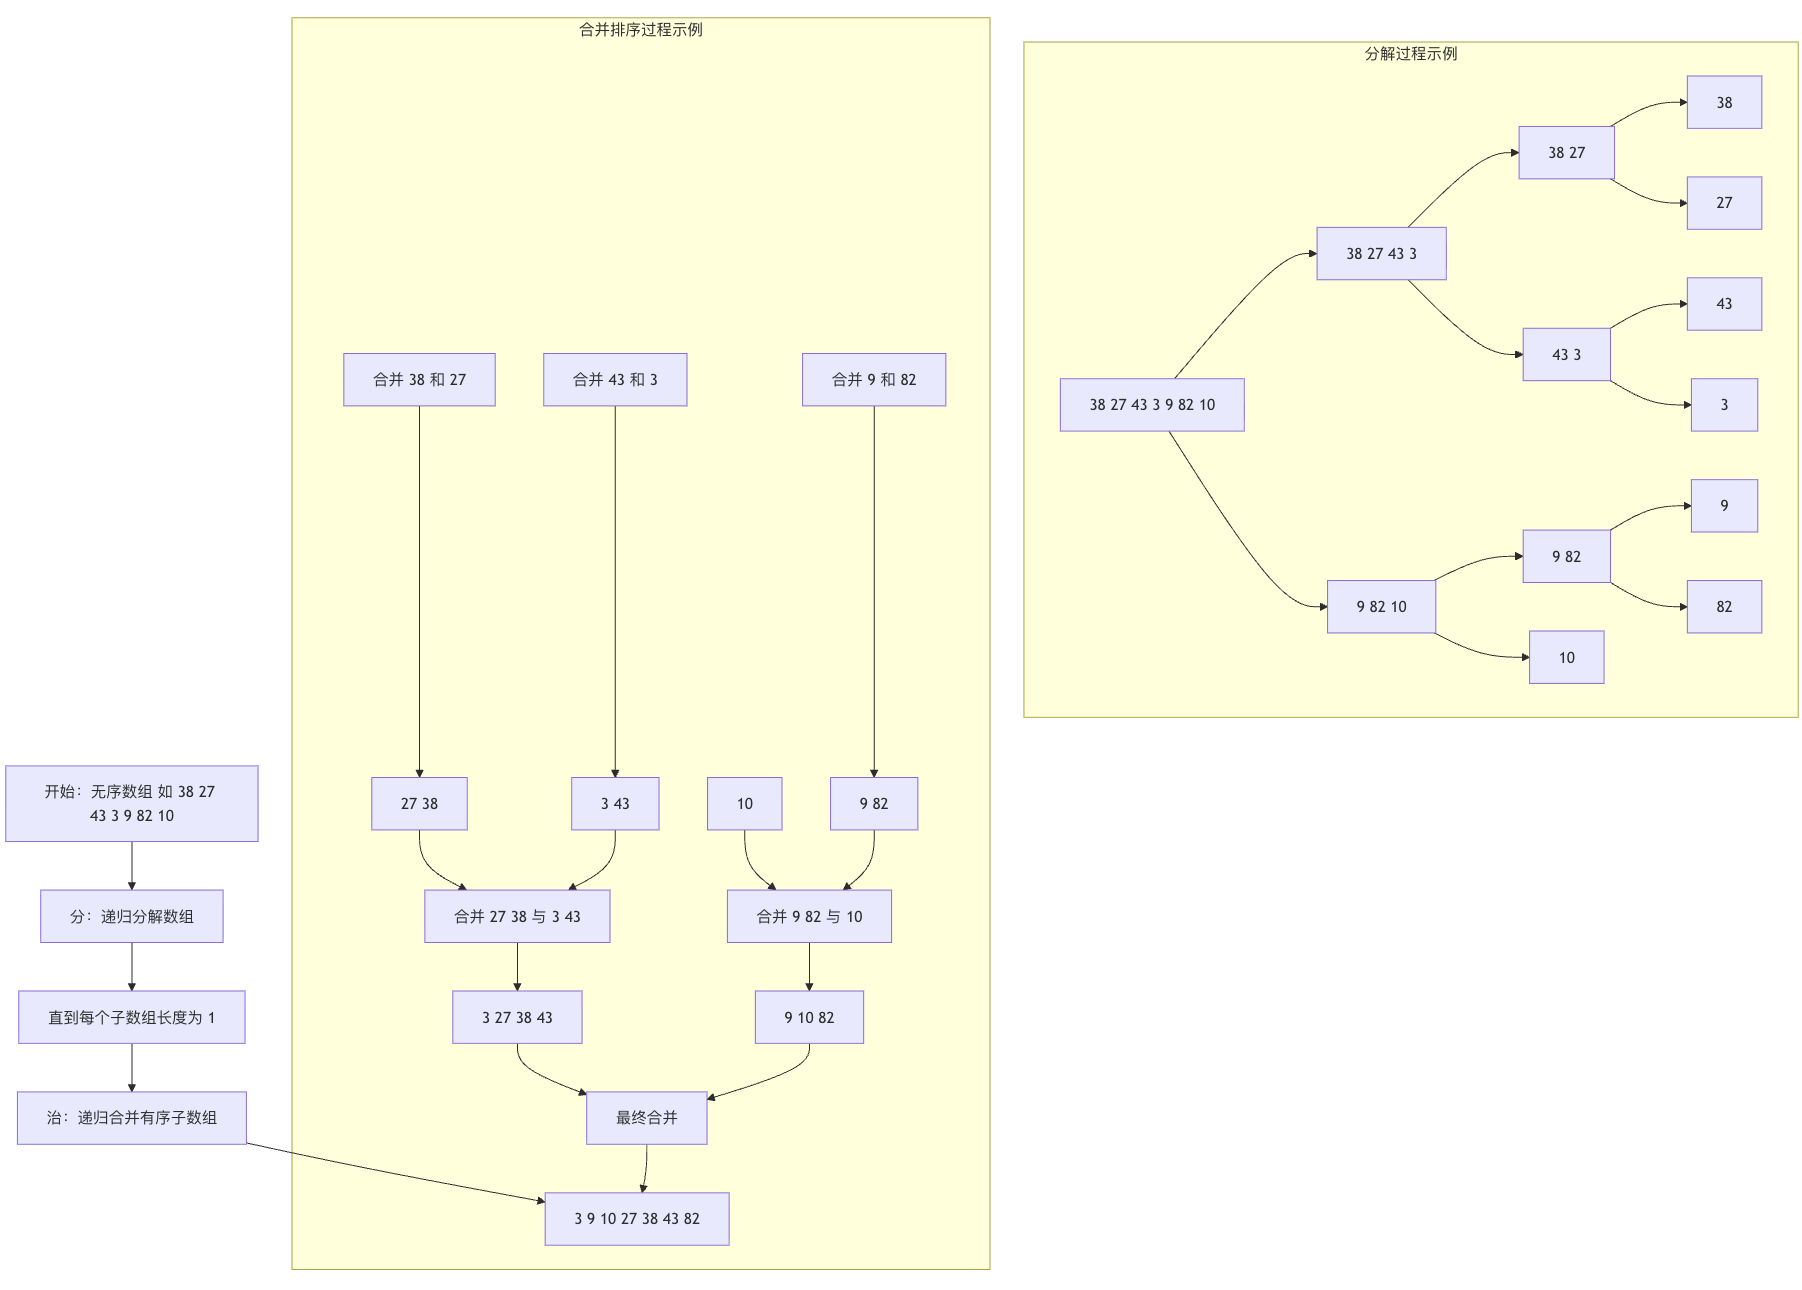
Diagramme du processus
Le tri fusion est un exemple d'algorithme récursif. L'opération de base de cet algorithme consiste à fusionner deux tableaux triés : il prend deux tableaux d'entrée A et B, un tableau de sortie C, et trois compteurs i, j, k, initialement positionnés au début de leurs tableaux respectifs.
Le plus petit de A[i] et B[j] est copié à la position suivante dans C, et le compteur correspondant avance d'un pas.
Lorsque l'un des deux tableaux d'entrée est épuisé, copiez la partie restante de l'autre tableau dans C.
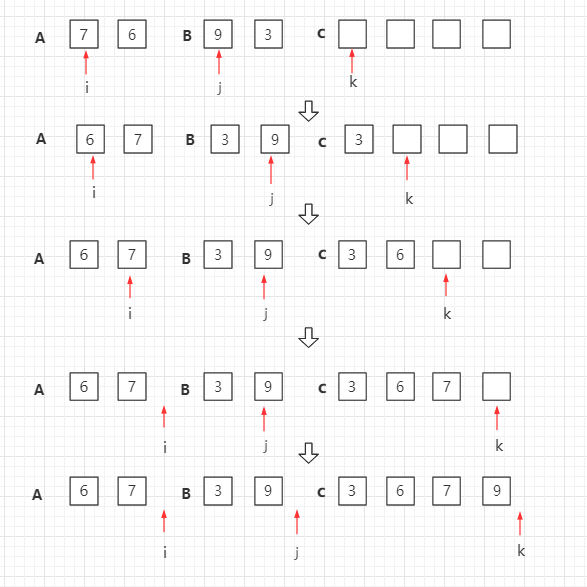
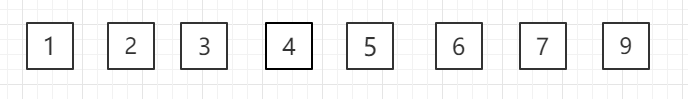
Tri fusion descendant, diagramme de regroupement récursif :
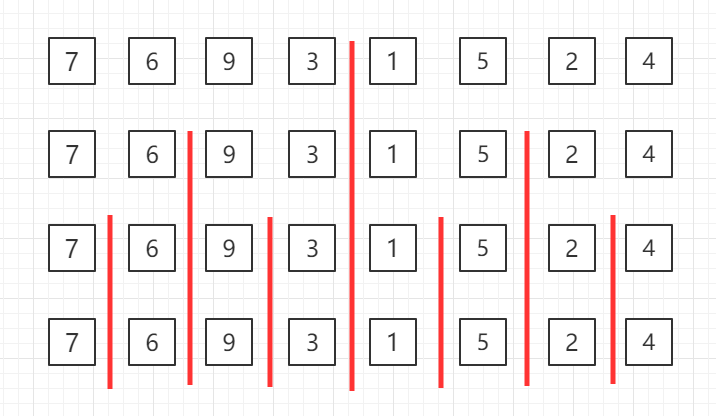
Effectuez un tri fusion sur les données de la troisième ligne, regroupées par paires.
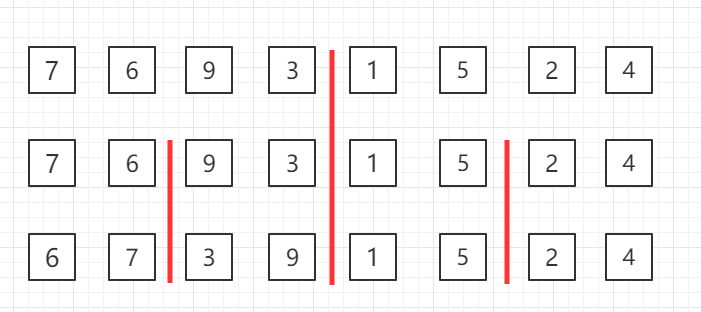
Effectuez un tri fusion sur les données de la deuxième ligne, regroupées par quatre.
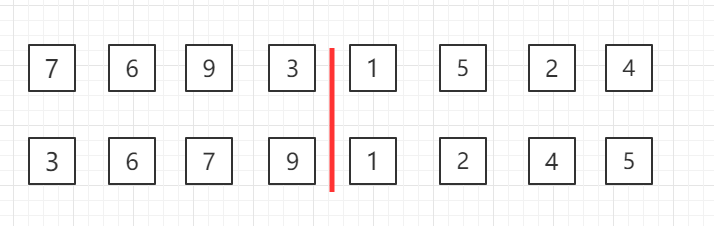
Tri fusion global
Exemple de code Java
Téléchargement du paquet de code source :Télécharger
Code du fichier MergeSort.java :
// Fusionner les deux parties arr[l...mid] et arr[mid+1...r]
private static void merge(Comparable[] arr, int l, int mid, int r) {
Comparable[] aux = Arrays.copyOfRange(arr, l, r + 1);
// Initialiser : i pointe vers l'indice de début l de la moitié gauche ; j pointe vers l'indice de début mid+1 de la moitié droite
int i = l, j = mid + 1;
for (int k = l; k <= r; k++) {
if (i > mid) { // Si tous les éléments de la moitié gauche ont été traités
arr[k] = aux[j - l];
j++;
} else if (j > r) { // Si tous les éléments de la moitié droite ont été traités
arr[k] = aux[i - l];
i++;
} else if (aux[i - l].compareTo(aux[j - l]) < 0) { // L'élément pointé dans la moitié gauche < l'élément pointé dans la moitié droite
arr[k] = aux[i - l];
i++;
} else { // L'élément pointé dans la moitié gauche >= l'élément pointé dans la moitié droite
arr[k] = aux[j - l];
j++;
}
}
}
// Utiliser récursivement le tri fusion pour trier la plage arr[l...r]
private static void sort(Comparable[] arr, int l, int r) {
if (l >= r) {
return;
}
int mid = (l + r) / 2;
sort(arr, l, mid);
sort(arr, mid + 1, r);
// Dans le cas où arr[mid] <= arr[mid+1], sauter la fusion
// Ceci est très utile pour les tableaux presque triés, mais dans les cas généraux, il y a une perte de performance
if (arr[mid].compareTo(arr[mid + 1]) > 0)
merge(arr, l, mid, r);
}
public static void sort(Comparable[] arr) {
int n = arr.length;
sort(arr, 0, n - 1);
}
// Test de fusion
public static void main(String[] args) {
int N = 1000;
Integer[] arr = SortTestHelper.generateRandomArray(N, 0, 100000);
sort(arr);
// Afficher le tableau
SortTestHelper.printArray(arr);
}
}
Principes de l'algorithme et étapes détaillées
L'implémentation du tri fusion repose principalement sur deux fonctions clés :merge_sort(responsable de la "division") etmerge(responsable de la « gouvernance »).
1. Fonction de décompositionmerge_sort
Cette fonction fonctionne de manière récursive :
Cas de base: Si la longueur du tableau actuel est inférieure ou égale à 1, alors il est déjà ordonné, renvoyez directement.
Cas récursif:
- Trouvez la position médiane du tableau
mid。 - Pour la moitié gauche
arr[:mid]Appel récursifmerge_sort。 - Pour la moitié droite
arr[mid:]Appel récursifmerge_sort。 - Enfin, appelez
mergeLa fonction fusionne les parties gauche et droite déjà triées.
2. Fonction de fusionmerge
C'est l'essence de l'algorithme, responsable de la fusion de deux petits tableauxdéjà triésen un grand tableau ordonné. Le processus est similaire à parcourir deux annuaires téléphoniques déjà triés par ordre alphabétique et à les fusionner en un seul.
- Créer un tableau temporaire
temp, et trois pointeurs :i(pointant vers l'élément courant du tableau de gauche),j(pointant vers l'élément courant du tableau de droite),k(pointant vers la position de remplissage du tableau temporaire). - Comparer
left[i]etright[j], puisle plus petitmettez cet élément danstemp[k], puis le pointeur correspondant etkAvancez d'un pas. - Répétez l'étape 2 jusqu'à ce que tous les éléments de l'un des tableaux aient été placés dans le tableau temporaire.
- Ajoutez tous les éléments restants de l'autre tableau (qui sont intrinsèquement plus grands que les éléments déjà placés et sont déjà ordonnés) directement à la fin du tableau temporaire dans l'ordre.
- le tableau temporaire
tempLa séquence ordonnée dans ... est recopiée aux positions correspondantes du tableau d'origine.
Implémentation du code et analyse ligne par ligne
Implémentons le tri fusion en Python. Nous fournirons une version complète et abondamment commentée.
Données de test
Tout d'abord, préparons une liste non ordonnée comme données de test :
Exemple
test_array = [38, 27, 43, 3, 9, 82, 10]
print("Tableau d'origine :", test_array)
Implémentation complète
Exemple
"""
La fonction principale du tri fusion.
Paramètres :
arr (list) : La liste à trier.
Retourne :
list : la nouvelle liste triée (pour plus de clarté, cette implémentation renvoie une nouvelle liste).
"""
# Cas de base : si la longueur du tableau est 0 ou 1, il est déjà trié
if len(arr) <= 1:
return arr
# 1. Diviser : trouver le milieu et diviser le tableau en deux moitiés
mid = len(arr) // 2
left_half = arr[:mid] # Moitié gauche
right_half = arr[mid:] # Moitié droite
# Trier récursivement les moitiés gauche et droite
left_sorted = merge_sort(left_half)
right_sorted = merge_sort(right_half)
# 2. Régner : fusionner les deux sous-tableaux triés
return merge(left_sorted, right_sorted)
def merge(left, right):
"""
Fusionner deux listes triées.
Paramètres :
left (list) : La première liste triée.
right (list) : La deuxième liste triée.
Retourne :
list : La liste triée fusionnée.
"""
sorted_list = [] # Liste temporaire pour stocker le résultat de la fusion
i = j = 0 # i et j sont des pointeurs parcourant left et right, respectivement
# 3. Comparer et fusionner : tant que les deux listes ont encore des éléments
while i < len(left) and j < len(right):
if left[i] <= right[j]: # Remarque : utiliser <= pour maintenir la stabilité du tri
sorted_list.append(left[i])
i += 1
else:
sorted_list.append(right[j])
j += 1
# 4. Gérer les éléments restants : ajouter tous les éléments restants de la liste de gauche ou de droite au résultat
# Puisque les listes de gauche et de droite sont déjà triées, les éléments restants doivent tous être plus grands que les éléments déjà fusionnés
sorted_list.extend(left[i:])
sorted_list.extend(right[j:])
return sorted_list
# Exécuter l'algorithme avec des données de test
sorted_array = merge_sort(test_array.copy()) # Utiliser copy pour éviter de modifier le tableau d'origine
print("Après le tri fusion :", sorted_array)
Exécution du code et sortie
Lorsque vous exécutez le code ci-dessus, vous verrez la sortie suivante :
原始数组: [38, 27, 43, 3, 9, 82, 10]
归并排序后: [3, 9, 10, 27, 38, 43, 82]
Analyse de la complexité de l'algorithme
Comprendre l'efficacité d'un algorithme est crucial. Nous résumons les performances du tri fusion à l'aide du tableau ci-dessous :
| Métrique | Complexité | Description |
|---|---|---|
| Complexité temporelle | O(n log n) | C'est l'avantage le plus important du tri fusion.log nIl provient du nombre de niveaux de récursion (division du tableau en deux),nCela vient du fait que chaque niveau d'opérations de fusion doit parcourir tous les éléments. Quel que soit l'état initial des données (meilleur, pire, cas moyen), la complexité temporelle est O(n log n). |
| Complexité spatiale | O(n) | Le processus de fusion nécessite un espace supplémentaire de taille égale au tableau original pour stocker des tableaux temporaires. C'est le principal inconvénient du tri par fusion. |
| Stabilité | Stable | DansmergeDans la fonction, lorsqueleft[i] == right[j]Lorsque cela se produit, nous prenons en prioritéleft[i](en utilisant<=comparaison), ce qui garantit que l'ordre relatif d'origine des éléments égaux reste inchangé. |
| Qu'il s'agisse d'un tri en place | non | Il nécessite un espace mémoire supplémentaire. |