Tutorial de introducción a GraphRAG
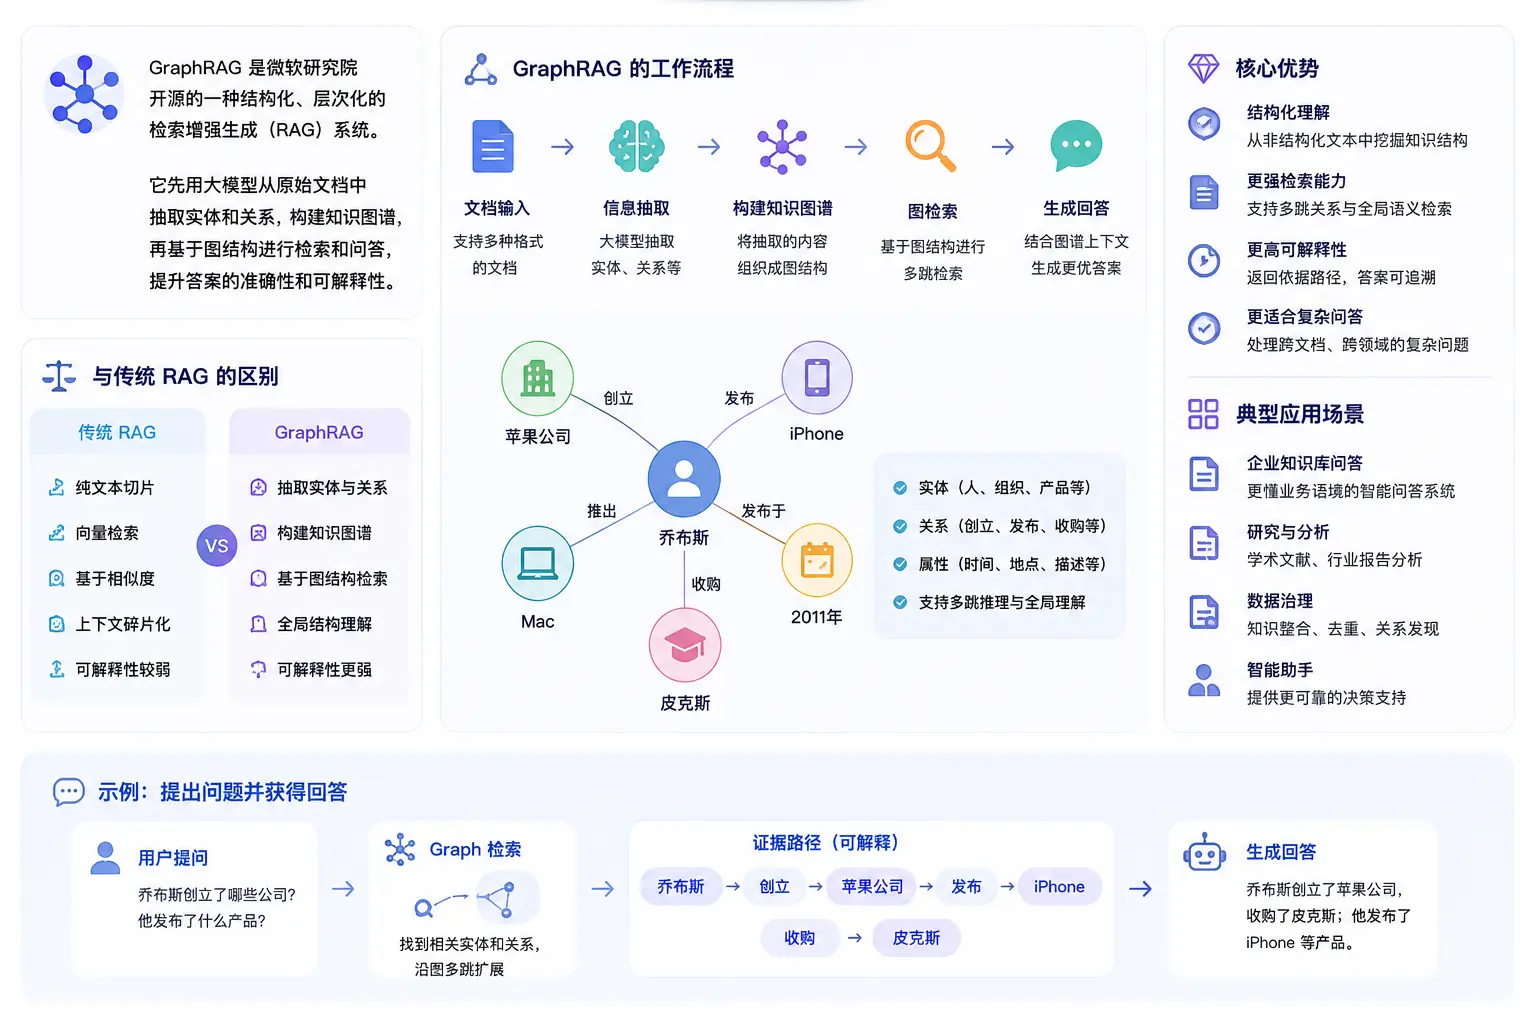
GraphRAG es un sistema de generación aumentada por recuperación (RAG) estructurado y jerárquico de código abierto de Microsoft Research. A diferencia del RAG tradicional, que utiliza recuperación vectorial sobre texto plano, GraphRAG primero usa un modelo grande para extraer entidades y relaciones de los documentos originales, construir un grafo de conocimiento y, a continuación, realizar la recuperación y las preguntas y respuestas basándose en la estructura del grafo.
Este tutorial está dirigido a lectores sin conocimientos previos, te lleva desde la instalación para que completes todo el proceso dedocumento → grafo de conocimiento → consulta y respuestadel flujo completo, el modelo usaqwen-plus, y el Embedding usa el de Tongyi de Alibaba Cloudtext-embedding-v4。
¿Qué es GraphRAG?
Para entender GraphRAG, primero hay que entender en qué es mejor que el RAG tradicional.
Limitaciones del RAG tradicional
El flujo de trabajo del RAG tradicional (Baseline RAG) es: dividir el documento en fragmentos pequeños → generar vectores → cuando llega una pregunta, usar la similitud vectorial para recuperar los fragmentos más relevantes → enviarlos al modelo para generar una respuesta.
Este enfoque funciona bien para problemas de "recuperación exacta", pero tiene un rendimiento deficiente en dos tipos de escenarios:
- Razonamiento de relaciones entre documentos: cuando la respuesta requiere conectar información dispersa en diferentes documentos, la similitud vectorial no puede expresar esa "relación". Por ejemplo: "¿Qué relación hay entre el CEO de la empresa A y el fundador de la empresa B?"
- Problemas de resumen global: cuando la pregunta pide un resumen macro de todo el corpus, unos pocos fragmentos de texto no pueden cubrir el panorama completo. Por ejemplo: "¿Cuáles son los riesgos más importantes en estos documentos financieros?"
Cómo resuelve GraphRAG estos dos problemas
La idea central de GraphRAG es:No recuperar directamente fragmentos de texto, sino construir primero un grafo de conocimiento y luego recuperar basándose en la estructura del grafo.。
Todo el proceso se divide en dos fases:
| Fase | Qué hace | Qué genera |
|---|---|---|
| Indexación (Index) | Usa el LLM para leer documentos, extraer entidades (personas, lugares, organizaciones, etc.) y relaciones, y construir un grafo de conocimiento; luego aplica el algoritmo de Leiden para realizar una agrupación jerárquica del grafo y generar resúmenes para cada comunidad. | Grafo de conocimiento + Resúmenes de comunidades + Índice vectorial |
| Consulta (Query) | Cuando el usuario pregunta, se elige una estrategia de recuperación según el tipo de pregunta, y se inyectan los datos del grafo, los resúmenes de las comunidades y los fragmentos de texto originales en el contexto del LLM para generar una respuesta. | Respuesta estructurada con fuentes de evidencia |
La fase de indexación de GraphRAG requiere llamar a muchas API de LLM, realizando extracción de entidades y resúmenes para cada fragmento de texto.El consumo de tokens es mucho mayor que en el RAG tradicional. Se recomienda, en el primer uso, probar el flujo con documentos pequeños (menos de unos miles de caracteres) y, una vez confirmado que funciona correctamente, procesar corpus a gran escala.
Comparación de cuatro modos de consulta
| Modo de consulta | Estrategia de recuperación | Tipo de preguntas adecuadas | Consumo de recursos |
|---|---|---|---|
| Global Search | Map-Reduce recorre todos los resúmenes de las comunidades | Preguntas globales y de resumen, como "¿Cuál es el tema central de estos documentos?" | Alto (múltiples llamadas LLM concurrentes) |
| Local Search | Parte de las entidades relevantes y expande nodos vecinos y textos asociados | Preguntas sobre entidades específicas, como "la red de relaciones principal de cierta persona" | Medio |
| DRIFT Search | Local Search + preguntas iterativas guiadas por la información de la comunidad | Preguntas relacionadas con entidades que requieren un contexto amplio, equilibrando profundidad y amplitud | Medio-alto |
| Basic Search | Similitud vectorial estándar (igual que el RAG tradicional) | Recuperación exacta simple, para comparar resultados | bajo |
Requisitos del entorno
Antes de comenzar, asegúrate de que tu entorno cumpla las siguientes condiciones.
| Dependencia | Versión requerida | Descripción |
|---|---|---|
| Python | 3.10 ~ 3.12 | Rango de soporte oficial, 3.13 no es compatible por el momento |
| pip | Última versión | Se recomienda primeropip install --upgrade pip |
| API Key de Alibaba Cloud Bailian | — | Enbailian.console.aliyun.com/Solicitar |
| Espacio en disco | ≥ 2GB | Los artefactos de indexación (archivos Parquet, base de datos vectorial) ocuparán bastante espacio |
Instalación
GraphRAG se publica en PyPI; se recomienda instalarlo en un entorno virtual de Python para no contaminar el entorno del sistema.
Crear el directorio del proyecto e inicializar el entorno virtual
mkdir graphrag_demo
cd graphrag_demo
python -m venv .venv
También se puede usarel comando uvpara especificar la versión de Python:uv venv --python 3.12
Activar el entorno virtual
macOS / Linux:
source .venv/bin/activate
Windows:
.venv\Scripts\activate
Instalar GraphRAG
pip install graphrag
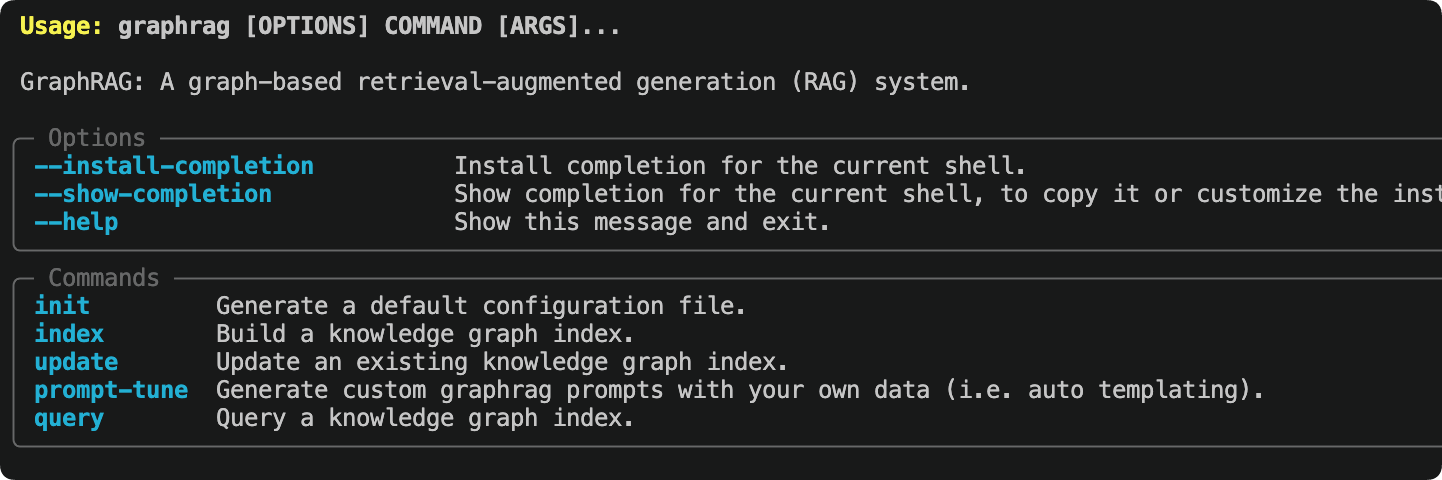
Después de la instalación, verifica:
graphrag --help
Mostrará algo degraphraginformación de comandos; la salida será similar a:
GraphRAG instalará automáticamente dependencias como LiteLLM, LanceDB, pandas, numpy, etc. La primera instalación tarda bastante (generalmente de 1 a 3 minutos); por favor, ten paciencia.
Inicializar el espacio de trabajo
Ejecutargraphrag initcomando, GraphRAG generará los archivos de configuración y la estructura de directorios en el directorio actual.
graphrag init
Nos pedirá que configuremos el modelo; podemos pulsar Enter para aceptar los valores predeterminados y modificarlos más tarde:
Specify the default chat model to use [gpt-4.1]:
Specify the default embedding model to use [text-embedding-3-large]:
Durante la inicialización se te pedirá que ingreses el modelo de Chat y el modelo de Embedding predeterminados; puedes omitirlos temporalmente pulsando Enter; más adelante los modificaremos manualmente.settings.yaml。
Una vez completada la inicialización, la estructura de directorios es la siguiente:
graphrag_demo/
├── .env                  # 存放 API Key 环境变量
├── settings.yaml         # 核心配置文件
├── input/                # 存放待处理的文本文件
├── output/               # 索引产物输出目录(自动生成)
└── prompts/              # Prompt 模板目录(自动生成)
Después de cada actualización de una versión menor de GraphRAG, se recomienda volver a ejecutar
graphrag init --forcepara refrescar el formato de configuración; de lo contrario, puede haber errores de ejecución debido a cambios en la estructura de configuración. Ten en cuenta que este comando sobrescribirá los existentessettings.yamly prompts; se recomienda hacer una copia de seguridad primero.
Preparar documentos de prueba
GraphRAG admite.txt、.csv、.jsondocumentos en formato; todos los archivos a procesar se colocan eninput/el directorio.
Usamos el documento de prueba recomendado oficialmente: "Canción de Navidad" de Charles Dickens, descargado directamente de Project Gutenberg:
curl /static.jyshare.com/download/pg24022.txt?v=2 -o ./input/book.txt
Si la red no está disponible, también puedes crear tu propio texto de prueba en chino; cuanto más rico sea el contenido (con muchas personas, lugares y relaciones entre eventos), más evidente será el efecto del grafo de conocimiento de GraphRAG:
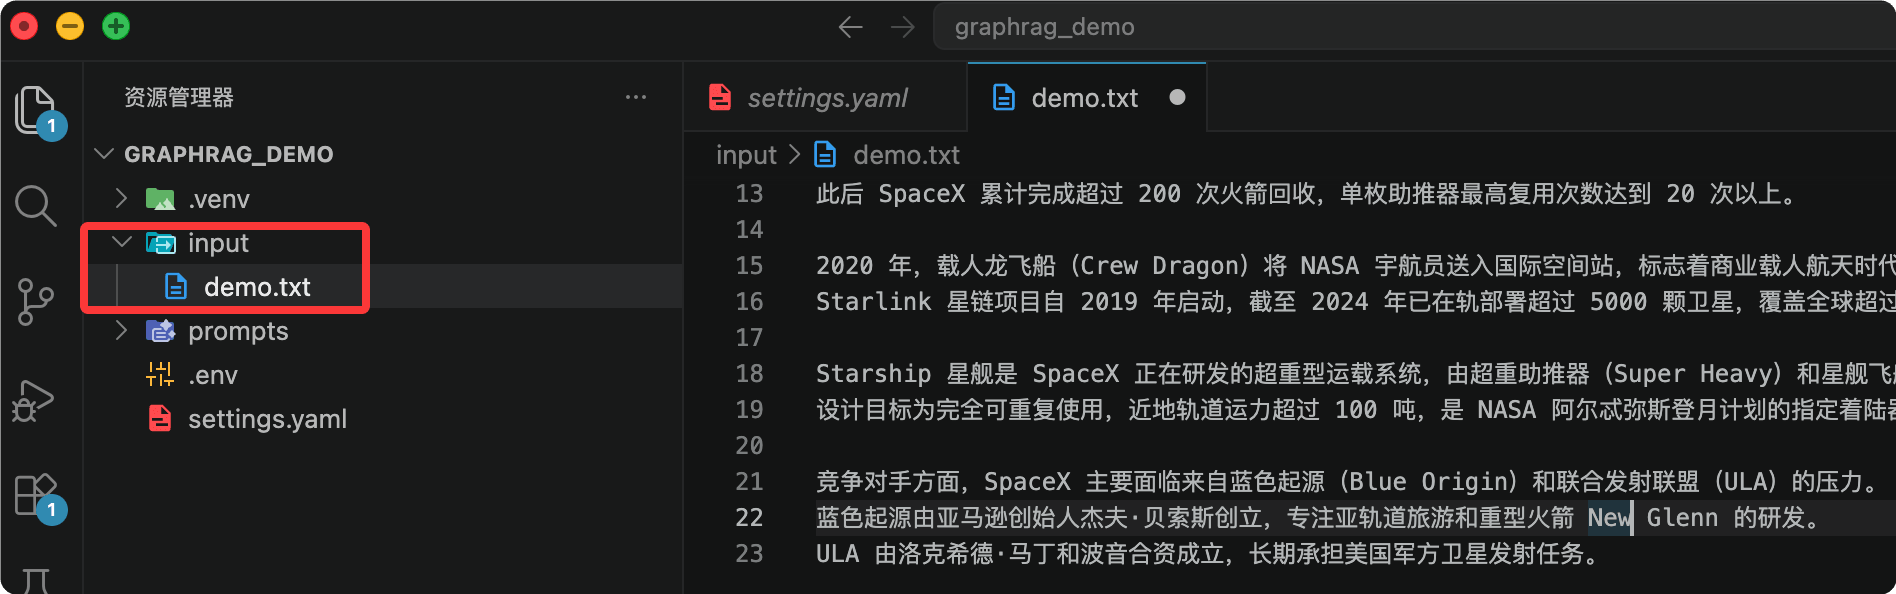
El archivo se coloca eninputel directorio, con el nombre de archivodemo.txt:
SpaceX 太空探索技术公司成立于 2002 年,由埃隆·马斯克(Elon Musk)在美国加利福尼亚州霍桑市创办。
公司目标是大幅降低太空运输成本,最终实现人类移民火星。

马斯克早年联合创立了 PayPal,2002 年以 15 亿美元出售给 eBay,随后将个人资产投入 SpaceX。
联合创始人中,汤姆·穆勒(Tom Mueller)担任推进系统首席设计师,主导了 Merlin 和 Raptor 发动机的研发。
格温·肖特维尔(Gwynne Shotwell)于 2002 年加入,2008 年起担任总裁兼 COO,负责公司日常运营和商业拓展。

2008 年,猎鹰 1 号(Falcon 1)在经历三次失败后首次成功入轨,成为首个由私营公司研制的液体轨道火箭。
2010 年,猎鹰 9 号(Falcon 9)首飞成功,同年龙飞船(Dragon)完成首次商业发射与回收。
2012 年,龙飞船成为首个对接国际空间站的商业航天器。

2015 年 12 月,猎鹰 9 号一级火箭首次实现陆地垂直回收,开创了火箭重复使用的新纪元。
此后 SpaceX 累计完成超过 200 次火箭回收,单枚助推器最高复用次数达到 20 次以上。

2020 年,载人龙飞船(Crew Dragon)将 NASA 宇航员送入国际空间站,标志着商业载人航天时代的开始。
Starlink 星链项目自 2019 年启动,截至 2024 年已在轨部署超过 5000 颗卫星,覆盖全球超过 60 个国家和地区。

Starship 星舰是 SpaceX 正在研发的超重型运载系统,由超重助推器(Super Heavy)和星舰飞船组成,
设计目标为完全可重复使用,近地轨道运力超过 100 吨,是 NASA 阿尔忒弥斯登月计划的指定着陆器。

竞争对手方面,SpaceX 主要面临来自蓝色起源(Blue Origin)和联合发射联盟(ULA)的压力。
蓝色起源由亚马逊创始人杰夫·贝索斯创立,专注亚轨道旅游和重型火箭 New Glenn 的研发。
ULA 由洛克希德·马丁和波音合资成立,长期承担美国军方卫星发射任务。
Configurar qwen-plus y el modelo de Embedding
Este es el paso más crítico de todo el tutorial; es necesario modificar.envysettings.yamldos archivos.
Paso 1: configurar la API Key
Abrir.envarchivo, e introduce tu API Key:
Ejemplo
# API Key de Alibaba Cloud Bailian
DASHSCOPE_API_KEY=sk-your-dashscope-api-key-here
Paso 2: modificar settings.yaml
Abrirsettings.yaml, y reemplazar todo el contenido con la siguiente configuración.
GraphRAG 2.x usa LiteLLM para llamar de forma unificada a varios modelos.model_provider: openaiJunto conapi_basepuede reenviar solicitudes a cualquier interfaz compatible con OpenAI:
completion_models:
  default_completion_model:
    model_provider: openai
    model: qwen-plus                              # 中文抽取稳定,成本低于 qwen-plus
    auth_method: api_key
    api_key: ${DASHSCOPE_API_KEY}
    api_base: https://dashscope.aliyuncs.com/compatible-mode/v1
    call_args:
      temperature: 0                              # 提高结构化稳定性
      max_tokens: 4096
    retry:
      type: exponential_backoff
      max_retries: 5
      base_delay: 2

embedding_models:
  default_embedding_model:
    model_provider: openai
    model: text-embedding-v4                      # 通义向量模型
    auth_method: api_key
    api_key: ${DASHSCOPE_API_KEY}
    api_base: https://dashscope.aliyuncs.com/compatible-mode/v1
    retry:
      type: exponential_backoff
      max_retries: 5

input:
  type: text

input_storage:
  type: file
  base_dir: input

chunking:
  type: tokens
  size: 600                                       # 中文推荐 500~800
  overlap: 100
  encoding_model: o200k_base

output_storage:
  type: file
  base_dir: output

reporting:
  type: file
  base_dir: logs

cache:
  type: json
  storage:
    type: file
    base_dir: cache

vector_store:
  type: lancedb
  db_uri: output/lancedb

embed_text:
  embedding_model_id: default_embedding_model    # 注意不要带逗号
  batch_size: 10                                 # 百炼 embedding 单次最多10条
  batch_max_tokens: 6000
  concurrency: 1                                 # 避免并发触发限流

extract_graph:
  completion_model_id: default_completion_model
  entity_types: []                               # 自动识别实体
  max_gleanings: 3                               # 提高关系补抽成功率

summarize_descriptions:
  completion_model_id: default_completion_model
  max_length: 500

cluster_graph:
  max_cluster_size: 20                           # 降低社区数量

extract_claims:
  enabled: false

community_reports:
  completion_model_id: default_completion_model
  max_length: 1500
  max_input_length: 4000                         # 防止生成阶段过慢

snapshots:
  graphml: true                                  # 导出图结构
  embeddings: false

local_search:
  completion_model_id: default_completion_model
  embedding_model_id: default_embedding_model
  top_k_entities: 10

global_search:
  completion_model_id: default_completion_model
  map_max_length: 500
  reduce_max_length: 1500
Acerca de la salida JSON de Qwen:GraphRAG necesita que el modelo devuelva de forma estable el formato JSON durante la fase de extracción de entidades. Qwen admite el modo JSON;
temperatureEstablecerlo en 0 puede mejorar aún más la estabilidad de la salida y reducir la probabilidad de fallos de análisis. Si aún aparecen errores de análisis JSON, se puede intentar agregar encall_argsagregar enresponse_format: {type: json_object}。
Iniciar la indexación
Una vez completada la configuración, ejecute el comando de indexación; GraphRAG leerá automáticamenteinput/todos los archivos en el directorio, invocará a qwen-plus para realizar extracción de entidades, reconocimiento de relaciones, generación de resúmenes y, finalmente, construirá un grafo de conocimiento completo.
graphrag index
Verás una salida de progreso similar a la siguiente:
⠹ GraphRAG Indexer
├── Loading Input (text) - 1 files loaded
├── create_base_text_units
├── extract_graph
│   └── Entity Extraction: 100%|████████████| 12/12 [02:34<00:00]
├── summarize_descriptions
├── cluster_graph
├── community_reports
└── generate_text_embeddings
All workflows completed successfully.
Una vez completada la indexación,output/en el directorio se generarán una serie de archivos Parquet:
| Archivo | Contenido |
|---|---|
entities.parquet | Todas las entidades extraídas (nombre, tipo, descripción, vector) |
relationships.parquet | Relaciones entre entidades (entidad origen, entidad destino, descripción de la relación, peso) |
communities.parquet | Comunidades generadas por el agrupamiento de Leiden (estructura jerárquica) |
community_reports.parquet | Informe resumido de cada comunidad (datos principales de Global Search) |
text_units.parquet | Bloques de texto originales (fuente de referencia de Local Search) |
lancedb/ | Base de datos vectorial, que almacena los vectores de varias entidades y bloques de texto |
Referencia de tiempo de indexación:Para un documento chino de unos pocos miles de caracteres (aproximadamente 10~20 bloques de texto), usar qwen-plus tarda alrededor de 3~10 minutos; para colecciones de documentos grandes de más de 100 000 caracteres, puede llevar varias horas. Se recomienda primero probar el flujo con un documento pequeño y luego procesar datos a gran escala.
Ejecutar consultas
Una vez completada la indexación, se puede consultar el grafo de conocimiento. GraphRAG ofrece dos formas: CLI y Python API.
Consulta mediante CLI
Búsqueda global (adecuada para preguntas de carácter macro):
graphrag query "文档中涉及的主要组织和人物有哪些?它们之间有什么关系?"
Búsqueda local (adecuada para preguntas sobre entidades específicas), agregue--method local:
graphrag query "SpaceX 公司的主要业务和合作伙伴有哪些?" --method local
Búsqueda DRIFT (equilibra profundidad y amplitud):
graphrag query "埃隆·马斯克的职业背景和主要贡献是什么?" --method drift
Búsqueda vectorial básica (para comparar con RAG tradicional):
graphrag query "Starship 星舰的设计目标和能力是什么?" --method basic
Consulta mediante la API de Python
Llamar a la consulta de GraphRAG en el código es adecuado para integrarlo en aplicaciones.
Ejemplo
# Consulta usando la Python API de GraphRAG
import asyncio
from graphrag.api import GraphRagConfig, search
async def run_query():
# Cargar el archivo de configuración (lee settings.yaml desde el directorio actual)
config = GraphRagConfig.from_yaml("settings.yaml")
# ── Ejemplo de búsqueda global ─────────────────
print("=" * 60)
print("【Global Search】Pregunta global")
print("=" * 60)
global_result = await search(
config=config,
query="¿Cómo es la red de relaciones entre las principales empresas y personajes mencionados en el documento?",
method="global", # Usar Global Search
)
print(global_result.response)
print()
# ── Ejemplo de búsqueda local ─────────────────
print("=" * 60)
print("【Local Search】Pregunta sobre una entidad específica")
print("=" * 60)
local_result = await search(
config=config,
query="¿Cuál es el antecedente del equipo fundador de SpaceX y sus principales productos?",
method="local", # Usar Local Search
)
print(local_result.response)
print()
# Ver la información de fuentes recuperada (opcional)
if hasattr(local_result, "context_data"):
entities = local_result.context_data.get("entities", [])
print(f"Se recuperaron {len(entities)} entidades relevantes:")
if __name__ == "__main__":
asyncio.run(run_query())
python query_demo.py
============================================================
【Global Search】全局性问题
============================================================
根据文档内容,主要涉及以下公司和人物关系网络:

**公司层面:**
- SpaceX 公司:主要角色,覆盖商业发射、载人航天、卫星互联网三大方向
- NASA:重要合作伙伴,阿尔忒弥斯登月计划 Starship 着陆器供应商
- 蓝色起源 / 联合发射联盟:主要竞争对手

**人物层面:**
- 马斯克(创始人):PayPal 联合创始人,SpaceX CEO 兼首席工程师
- 汤姆·穆勒(联合创始人):推进系统首席设计师,Merlin 和 Raptor 发动机之父
- 格温·肖特维尔:总裁兼 COO,负责公司商业运营

**关键关系:**
SpaceX 与 NASA 于 2020 年建立战略合作关系,
三家公司(SpaceX、蓝色起源、ULA)在商业航天发射市场形成竞争格局...

============================================================
【Local Search】针对特定实体的问题
============================================================
SpaceX 公司成立于 2002 年,创始团队包括:
- 马斯克:PayPal 联合创始人,SpaceX CEO 兼首席工程师,航天领域超二十年经验
- 汤姆·穆勒:推进系统首席设计师,主导 Merlin 和 Raptor 发动机研发

主要产品:
1. 猎鹰 9 号:全球首个实现垂直回收的轨道级火箭,已完成 200 次以上回收
2. Starship 星舰:超重型运载系统,近地轨道运力超 100 吨,完全可重复使用

检索到相关实体数量:12
Ajuste automático de prompts
Los desarrolladores oficiales de GraphRAG recomiendan encarecidamente ejecutar el ajuste automático de Prompt antes de procesar sus propios datos.
El ajuste automático hará que el LLM lea parte de tus documentos y luego genere un Prompt de extracción de entidades personalizado para el dominio de tus datos, lo que mejora la calidad de la construcción del grafo de conocimiento.
graphrag prompt-tune --config settings.yaml --root . --language Chinese
Una vez completado el ajuste,prompts/los archivos Prompt en el directorio se actualizarán automáticamente. Si tus documentos están en chino, agregue--language Chineseel parámetro puede hacer que el Prompt generado también esté en chino, mejorando la precisión de la extracción de entidades en chino.
El ajuste de Prompt en sí mismo también consume Tokens del LLM (aproximadamente equivalente a hacer una indexación rápida de una pequeña cantidad de documentos). Se recomienda reajustar cada vez que se cambie el conjunto de datos, en lugar de usar siempre el Prompt predeterminado.
Referencia rápida de comandos CLI comunes
A continuación se muestran los comandos más utilizados en el uso diario de GraphRAG.
| Comando | Descripción |
|---|---|
graphrag init | Inicializa el área de trabajo, genera.env、settings.yaml、input/ |
graphrag init --force | Forzar la reinicialización (se usa después de actualizar la versión); sobrescribirá la configuración existente |
graphrag index | Sobreinput/Ejecuta el flujo completo de indexación para los documentos del directorio |
graphrag index --resume | Reanuda la indexación desde el punto donde se interrumpió (las llamadas al LLM tienen caché, no se consumen Tokens repetidamente) |
graphrag index --update | Indexación incremental, solo procesa documentos nuevos |
graphrag query "问题" | Consulta Global Search (modo predeterminado) |
graphrag query "问题" --method local | Consulta Local Search |
graphrag query "问题" --method drift | Consulta DRIFT Search |
graphrag query "问题" --method basic | Basic Search (búsqueda vectorial) |
graphrag prompt-tune | Ajuste automático del Prompt (se recomienda ejecutarlo antes de procesar un nuevo conjunto de datos) |
Explicación completa de los campos de settings.yaml
A continuación se detallansettings.yamllas opciones de configuración más utilizadas en, para facilitar ajustes posteriores.
Relacionados con el modelo
| Campo | Tipo | Descripción |
|---|---|---|
model_provider | string | Proveedor del modelo; cuando se usa una interfaz compatible con OpenAI, completeopenai |
model | string | Nombre del modelo; para Qwen, completeqwen-plus 或 qwen-max |
api_key | string | API Key; se recomienda usar${ENV_VAR}referencia a variables de entorno |
api_base | string | Endpoint de API; para Qwen eshttps://dashscope.aliyuncs.com/compatible-mode/v1 |
call_args.temperature | float | Temperatura de generación; se recomienda establecerla en 0 durante la fase de indexación para mejorar la estabilidad |
call_args.max_tokens | int | Número máximo de Tokens por generación |
retry.max_retries | int | Número máximo de reintentos cuando falla una solicitud |
Relacionados con la división en fragmentos
| Campo | Descripción | Valor recomendado |
|---|---|---|
chunking.size | Número máximo de Tokens por bloque de texto | Inglés: 1200~1500; chino: 600~1000 |
chunking.overlap | Número de Tokens superpuestos entre bloques adyacentes para evitar que las entidades se corten en los bordes | 50~150 |
chunking.type | tokens(dividir por Tokens) osentence(dividir por oraciones) | Generalmente se usatokens |
Relacionados con la extracción de entidades
| Campo | Descripción | Recomendación |
|---|---|---|
extract_graph.entity_types | Lista de tipos de entidades que se le indica al modelo extraer con prioridad | Personalícelo según su dominio de negocio, por ejemploperson, company, product, technology |
extract_graph.max_gleanings | Número máximo de preguntas de seguimiento por bloque de texto (las preguntas de seguimiento pueden mejorar la recuperación, pero consumen más Tokens) | Establezca 1 para equilibrar costos, 2 para buscar calidad |
Preguntas frecuentes
¿Qué hago si la indexación falla a mitad de camino?
GraphRAG guarda en caché los resultados de cada llamada al LLM. Después de un fallo, simplemente vuelva a ejecutargraphrag index, los bloques de texto ya procesados con éxito se leerán desde la caché y no se consumirán Tokens repetidamente.
Si desea reiniciar desde cierto paso, use--resumeel parámetro:
graphrag index --resume
¿Cómo manejo los errores de análisis JSON?
La fase de extracción de entidades exige que el modelo devuelva estrictamente formato JSON. Si apareceJSONDecodeError, puede probar los siguientes métodos:
- En
call_argsAñadir enresponse_format: {type: json_object}(requiere que el modelo admita este parámetro) - va a
temperatureEstablecer en 0 - va a
max_gleaningsEstablecer en 0 (reducir las preguntas de seguimiento, disminuir la probabilidad de errores) - Ejecute
graphrag prompt-tuneReajuste el Prompt para que el modelo esté más familiarizado con el formato de salida
¿Cómo elegir entre Global Search y Local Search?
| Tipo de pregunta | Modo recomendado | Ejemplo |
|---|---|---|
| Resumen, carácter global | Global Search | "¿Cuál es el tema central de este lote de documentos?" "La visión completa de toda la red de relaciones entre personajes" |
| Para entidades específicas | Local Search | "¿La trayectoria profesional de Musk?" "Las principales características técnicas del cohete Falcon 9" |
| Se necesita equilibrar profundidad y amplitud | DRIFT Search | "Análisis de las conexiones entre un personaje y el ecosistema circundante" |
| Búsqueda simple y precisa | Basic Search | "¿En qué año se fundó SpaceX?" |
¿Cómo controlar un consumo de tokens demasiado alto?
- va a
chunking.sizeAumente apropiadamente (menos bloques de texto = menos llamadas al LLM) - va a
extract_graph.max_gleaningsEstablecer en 0 o 1 - En
entity_typesEn, conserve solo los tipos de entidades más relevantes para el negocio - Use un modelo más económico en la fase de indexación, y en la fase de consulta puede cambiarlo a un modelo más potente según sea necesario
GraphRAG ofrece una estrategia de "configuración de modelo asimétrica": en
completion_modelsdefina múltiples modelos; use un modelo de bajo costo en la fase de indexación y un modelo más capaz para consultas clave en la fase de consulta, encontrando un equilibrio entre costo y calidad.
¿Cómo manejar documentos en chino?
Al manejar documentos en chino, hay que tener en cuenta los siguientes puntos:
- Asegúrese de que
input.encoding: utf-8(por defecto ya es UTF-8) - Reduzca
chunking.size(los caracteres chinos tienen alta densidad de información; con 600~1000 Tokens es suficiente) - Ejecute
graphrag prompt-tune --language ChineseGenere un Prompt en chino entity_typesPuede agregar apropiadamente tipos específicos del chino, comogovernment_agency(instituciones gubernamentales),policy(políticas)
Lecturas adicionales
| Tema | Descripción | Enlace |
|---|---|---|
| Documentación oficial completa | Incluye explicaciones detalladas de todos los elementos de configuración | microsoft.github.io/graphrag |
| Referencia de configuración | Descripción completa de los campos de settings.yaml | microsoft.github.io/graphrag/config/yaml/ |
| Guía de selección de modelos | Cómo integrar varios LLM (incluido el uso de LiteLLM) | microsoft.github.io/graphrag/config/models/ |
| Explicación detallada del motor de consultas | Principios y ajuste de parámetros de los cuatro modos de consulta | microsoft.github.io/graphrag/query/overview/ |
| Guía de ajuste de Prompt | Instrucciones completas para el ajuste automático y manual de Prompt | microsoft.github.io/graphrag/prompt_tuning/overview/ |
| Guía de visualización | Uso de herramientas oficiales para visualizar grafos de conocimiento | microsoft.github.io/graphrag/visualization_guide/ |
| Artículo de GraphRAG | Artículo original de Microsoft Research, para comprender los principios subyacentes | arxiv.org/pdf/2404.16130 |