Loop Engineering (Ingeniería de bucles)
Loop Engineering (Ingeniería de bucles) es un nuevo concepto que se difundió rápidamente en la comunidad de programación con IA en junio de 2026. Fue sistematizado por el ingeniero de Google Addy Osmani, y Boris Cherny, responsable de Claude Code en Anthropic, y el desarrollador Peter Steinberger plantearon la misma idea de forma independiente en público.
Este artículo te llevará desde cero a entender qué es Loop Engineering, sus diferencias esenciales con Prompt Engineering, los seis elementos que conforman un Agent Loop completo y cómo diseñar tu primer Loop funcional.
Proceso de evolución de la ingeniería de IA
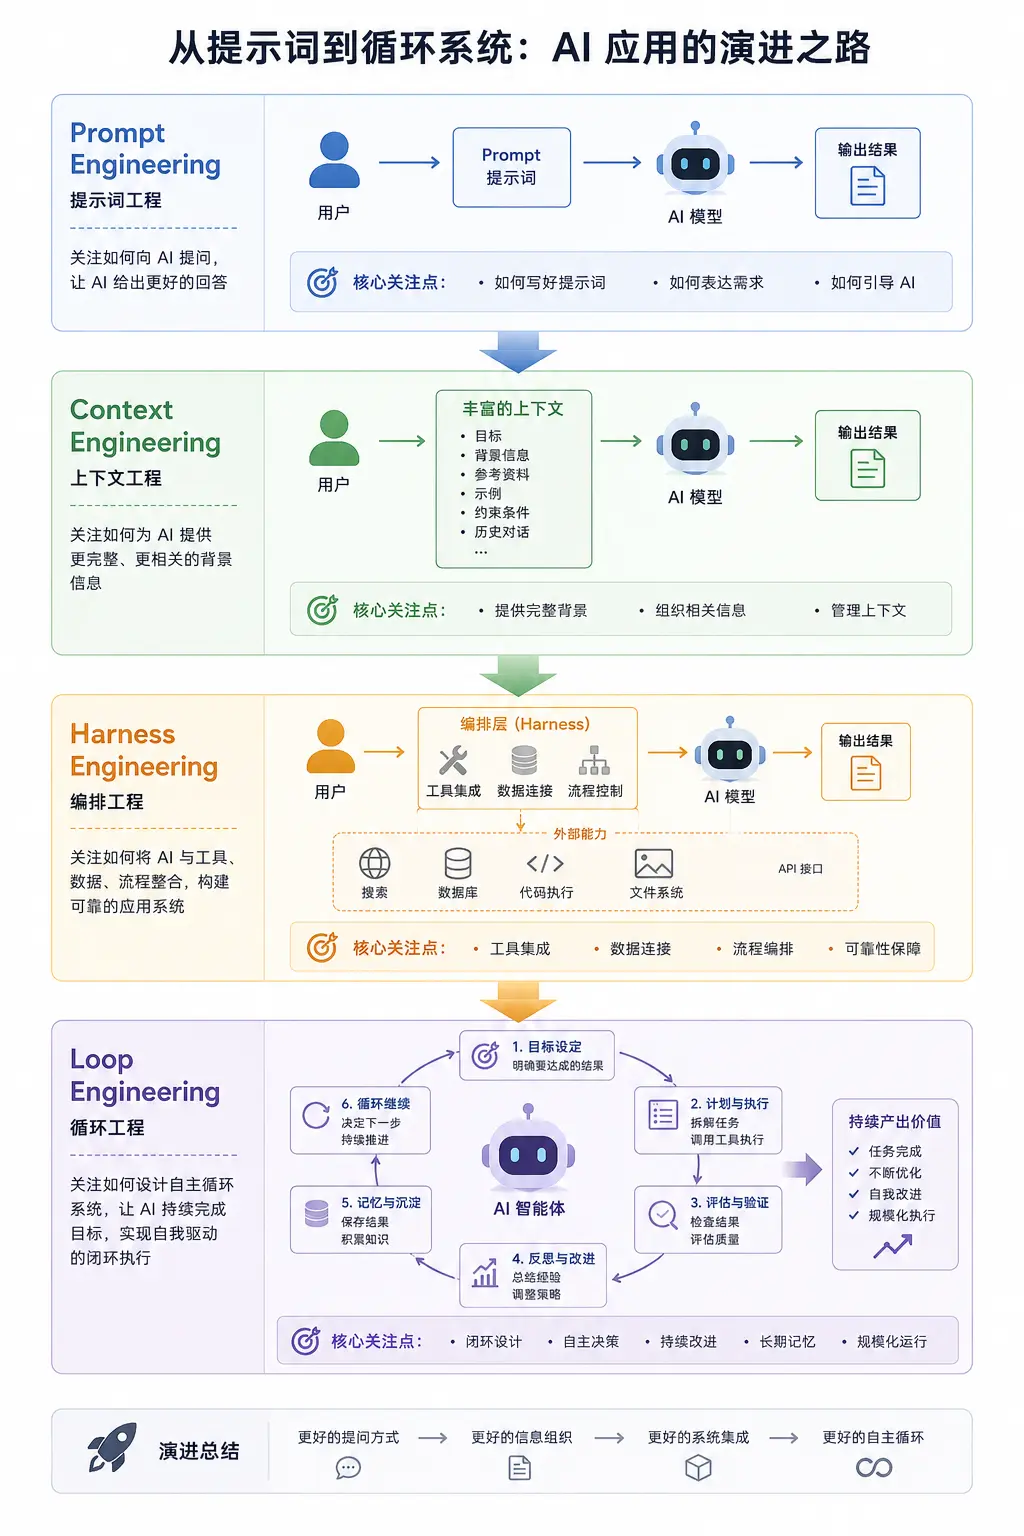
En los últimos dos años, el enfoque del desarrollo de IA ha ido cambiando constantemente: desde investigar cómo escribir buenos prompts, pasando gradualmente a organizar el contexto (Context), orquestar herramientas y flujos (Harness), hasta construir sistemas de bucle (Loop) capaces de ejecutarse de forma autónoma y entregar resultados de forma continua.
Prompt:怎么问 AI
↓
Context:给 AI 什么信息
↓
Harness:如何组织 AI 的能力
↓
Loop:如何让 AI 持续创造结果
| Etapa de ingeniería | Idea central | Enfoque | Entrada | Capacidad de IA | Rol de la persona | Escenario típico |
|---|---|---|---|---|---|---|
| Prompt Engineering (Ingeniería de prompts) | Obtener mejores resultados mediante el diseño de prompts | Cómo hacer preguntas | Prompt / Instrucción | Generación de un solo turno | Preguntador | Chat, escritura, generación de código |
| Context Engineering (Ingeniería de contexto) | Organizar y proporcionar información de contexto completa | Qué información dar a la IA | Base de conocimiento, historial, restricciones, contexto | Comprensión del contexto | Organizador de información | RAG, búsqueda con IA, asistentes de código |
| Harness Engineering (Ingeniería de orquestación) | Conectar modelos, herramientas y datos para formar flujos de trabajo | Cómo invocar capacidades | Contexto + API + cadena de herramientas | Ejecutar tareas | Diseñador de sistemas | Agentes, procesos automatizados, colaboración de múltiples herramientas |
| Loop Engineering (Ingeniería de bucles) | Construir sistemas de bucle cerrado autónomos impulsados por objetivos | Cómo completar objetivos de manera continua | Objetivos, estado, memoria, mecanismos de verificación | Planificar → Ejecutar → Verificar → Reparar → Operar de forma continua | Diseñador de reglas | Claude Code, programación con IA, operación automatizada, empleados de IA |
El origen de Loop Engineering
La aparición de Loop Engineering tiene un hito temporal claro: junio de 2026.
Punto de inflexión: dos frases, un millón de retuits
A principios de junio de 2026, el responsable de Claude Code en AnthropicBoris Chernydijo en una conferencia pública:
"I don't prompt Claude anymore. I have loops running. They're the ones prompting Claude and figuring out what to do. My job is to write loops."
(Ya no hago prompt a Claude directamente. Tengo un conjunto de Loops en ejecución que se encargan de hacer prompt a Claude y de decidir qué hacer a continuación. Mi trabajo es escribir los Loops.)
Pocos días después, el 7 de junio de 2026, el desarrolladorPeter Steinberger—creador del proyecto de agente de IA de código abierto OpenClaw (el repositorio nuevo que más rápido acumuló estrellas en la historia de GitHub)— publicó un tuit de doce caracteres:
"You shouldn't be prompting coding agents anymore. You should be designing loops that prompt your agents."
(Ya no deberías dar indicaciones manualmente al asistente de programación con IA. Deberías diseñar un Loop en el que el agente se indique a sí mismo.)
- Prompt EngineeringEs «enseñar a la IA cómo hacerlo»
- Loop EngineeringEs «diseñar un sistema para que la IA lo siga haciendo por sí misma»
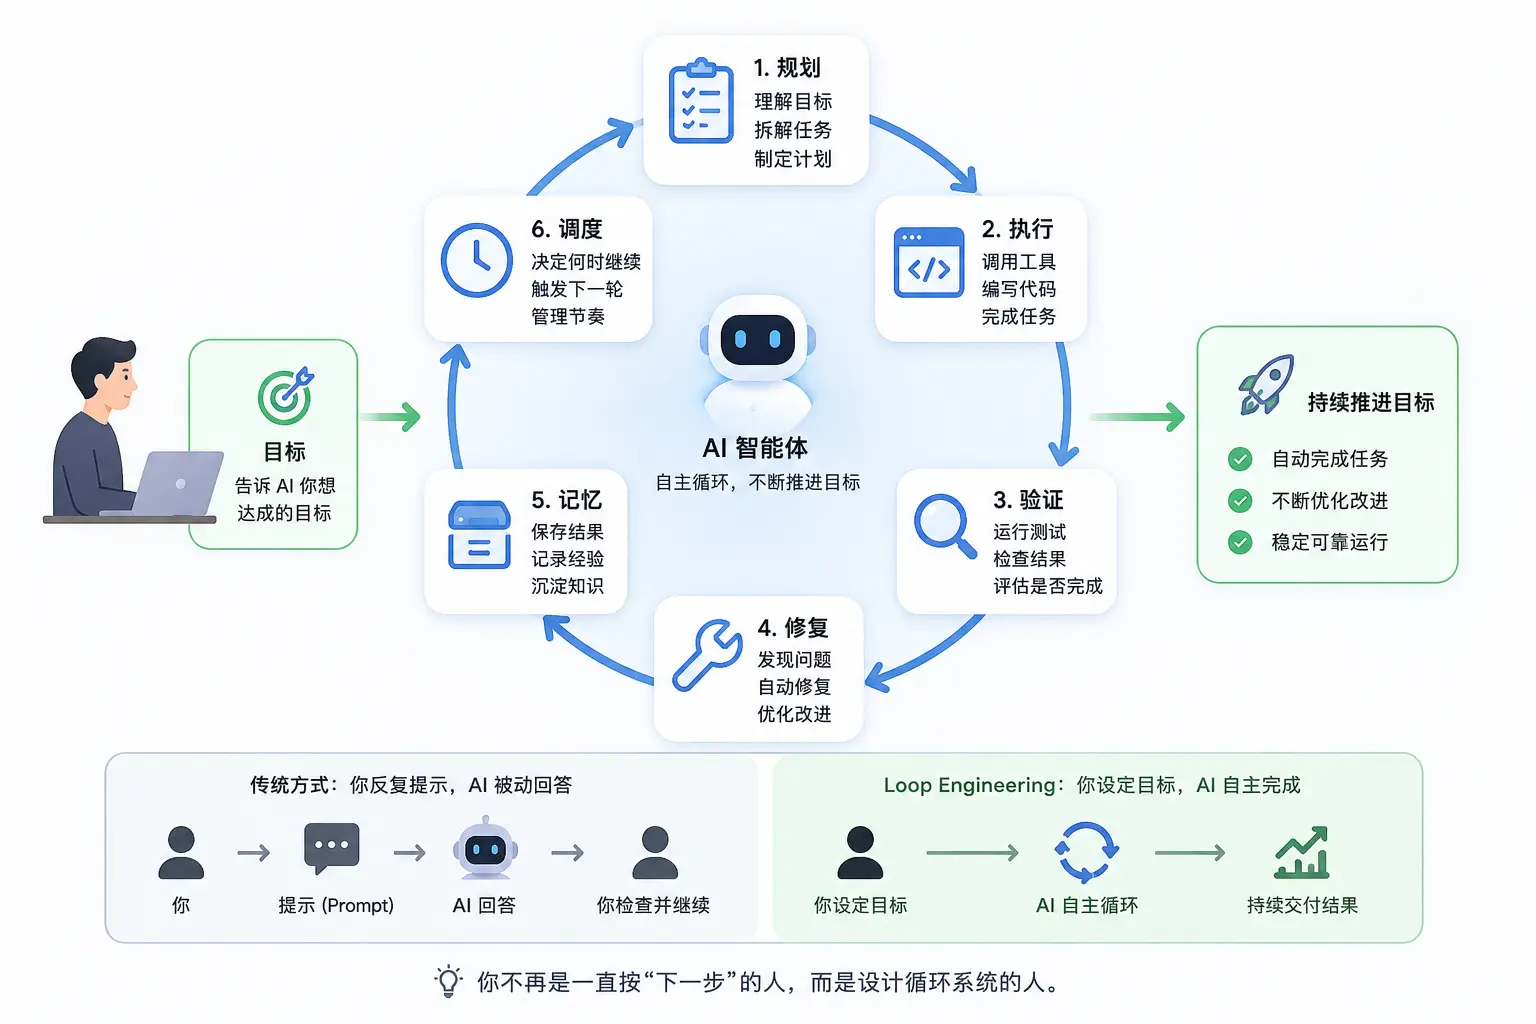
Estas dos frases provocaron un enorme debate en la comunidad de desarrolladores de IA, porque describían con precisión una tendencia que muchos ya sentían pero que aún no tenía nombre:Ya no es un cuello de botella si el prompt está bien escrito o no; el cuello de botella es todo el sistema de ejecución que diseñas para el agente.。
Posteriormente, Addy Osmani publicó un extenso artículo en Substack en el que nombró y sistematizó formalmente esta práctica comoLoop Engineering, convirtiéndola en una disciplina de ingeniería independiente.
Contexto: la evolución en tres generaciones de las herramientas de programación con IA
Loop Engineering no surgió de la nada; es el resultado natural de la evolución de las capacidades de las herramientas de programación con IA.
| Etapa | Herramienta representativa | Forma de trabajo | Cuello de botella |
|---|---|---|---|
| Primera generación: autocompletado | Versiones iniciales de GitHub Copilot | Completa la línea o función actual; el humano toma todas las decisiones | Solo puede asistir, no es autónomo |
| Segunda generación: conversacional | ChatGPT、Claude.ai | Una pregunta, una respuesta; el humano avanza manualmente cada paso | El humano se convierte en el cuello de botella; la velocidad está limitada por la velocidad al teclear |
| Tercera generación: bucle autónomo del agente | Claude Code、OpenAI Codex Agent | El agente planifica, ejecuta y verifica de forma autónoma, iterando en bucle hasta completar la tarea | Cómo diseñar un sistema que permita que el Loop funcione de manera fiable |
La aparición de las herramientas de tercera generación significa que la competencia central de los ingenieros ha pasado de saber escribir prompts a saber diseñar Loops.
Qué es Loop Engineering
Loop Engineering es la práctica de ingeniería de diseñar, operar y mejorar continuamente bucles de retroalimentación que permiten a los agentes de programación con IA completar de forma autónoma la planificación, ejecutar modificaciones de código, observar los resultados y realizar tareas a lo largo de múltiples iteraciones.
En una frase:
Loop Engineering es lo que te transforma de «la persona que hace prompt al agente» en «el ingeniero que diseña el sistema que hace prompt al agente».
Qué es un Loop (bucle)
Un Loop es un sistema recursivo orientado a objetivos: defines un propósito y el agente itera sin parar hasta que el trabajo está realmente terminado.
Cada agente ya tiene incorporado un «bucle interno» al ejecutar tareas: Percibir (Perceive) → Razonar (Reason) → Actuar (Act) → Observar (Observe), y luego se repite el ciclo.
Loop Engineering trabaja en el nivelsuperior:
| jerárquico de este bucle interno. | Quién impulsa | Qué hace |
|---|---|---|
| Bucle interno (integrado en el agente) | El propio agente | Leer archivo → modificar código → ejecutar pruebas → leer errores → volver a modificar |
| Bucle externo (diseñado por ti) | El sistema que tú diseñas | Descubrir tareas según el plan → asignar Agente → verificar resultados → registrar estado → iniciar siguiente ronda |
Ya no te sientas junto al Agente dando una instrucción para cada paso. Estás diseñando un sistema externo que conduce el bucle interno por ti, mientras tú te ocupas de tareas que requieren mayor criterio.
Diferencias entre Loop Engineering y Prompt Engineering
| Dimensión | Prompt Engineering | Loop Engineering |
|---|---|---|
| Objeto de optimización | Una sola instrucción escrita por ti manualmente | El sistema completo que decide automáticamente “qué indicar, cuándo indicar y si el resultado es aceptable” |
| Unidad de trabajo | Un turno de conversación que introduces manualmente | Un flujo de trabajo completo y automático que abarca múltiples turnos |
| Métrica de éxito | Calidad de la primera respuesta | Calidad del resultado final |
| Modo de fallo | El modelo da una respuesta deficiente | El bucle del sistema está mal diseñado: el ciclo se detiene demasiado pronto, ignora señales de error, no puede verificar la finalización |
| Perspectiva sobre el Agente | Una herramienta que sostienes | Un proceso de larga ejecución que tú coordinas |
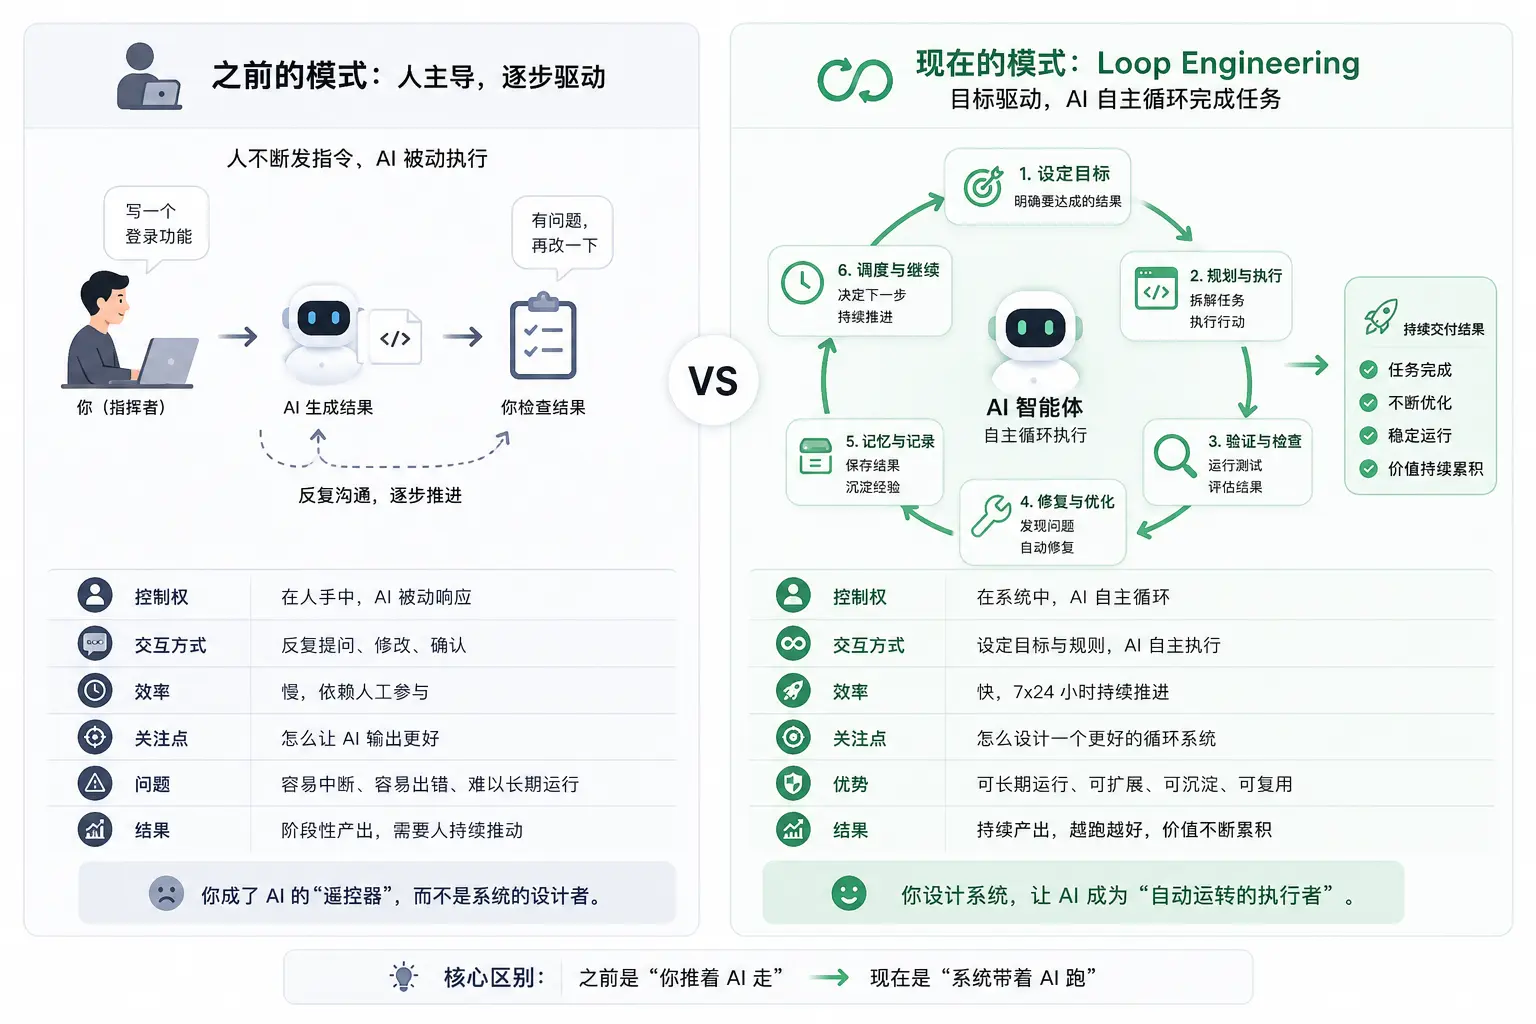
Prompt Engineering no ha muerto. Un bucle está compuesto por múltiples prompts; un prompt mal redactado dentro del bucle solo producirá trabajo deficiente a mayor velocidad. Loop Engineering es una capa por encima de Prompt Engineering, no su reemplazo.
La pila tecnológica completa de tres capas:
| Capa | Qué optimiza | Unidad de trabajo |
|---|---|---|
| Prompt Engineering | Cómo redactar una instrucción | Una conversación que introduces manualmente |
| Context Engineering | Qué contenido poner en la ventana de contexto: documentos, historial, definiciones de herramientas | Condiciones del entorno alrededor de una respuesta |
| Loop Engineering | Sistema autoejecutable que decide qué indicar, cuándo indicar y si el resultado es aceptable | Flujo de trabajo automático que abarca múltiples bucles internos |
El ciclo central del Loop
La estructura básica de un Agent Loop consta de cinco fases que se conectan de extremo a extremo e iteran continuamente.
| Fase | Nombre en inglés | Qué hace | Fuente típica de señales |
|---|---|---|---|
| Intención | Intent | Define el resultado objetivo: cómo es el éxito, cuáles son las restricciones | Desarrollador o sistema externo (Issue, informe de CI) |
| Contexto | Context | Recopila código relevante, documentación, registros de errores, convenciones | Repositorio de código, salida de pruebas, historial de conversaciones |
| Acción | Action | Editar archivos, ejecutar comandos, invocar herramientas, redactar soluciones | Ejecutado autónomamente por el Agente |
| Observación | Observation | Obtener resultados de pruebas, errores de compilación, salida en tiempo de ejecución, diff de código | Framework de pruebas, verificación de tipos, CI, revisión humana |
| Ajuste | Adjustment | Actualiza el plan según las observaciones; repite el bucle hasta que la tarea se complete o quede bloqueada | Siguiente ronda del bucle interno |
El poder del Loop no reside en ningún paso individual, sino en elbucle cerrado. Un fallo de prueba no es solo un mensaje de error; es nuevo contexto. Un error de tipo no es solo un bloqueo; es una señal sobre una suposición incorrecta. Un comentario de Code Review no es solo retroalimentación; es una nueva observación que impulsa la siguiente acción.
Los seis elementos constitutivos
Un Loop que funcione verdaderamente de forma autónoma necesita cinco componentes centrales, más un sistema de memoria que lo recorra todo; todos son imprescindibles.
Elemento 1: Disparadores automáticos (Automations)
El disparador automático es el corazón del Loop. Sin disparo automático, el Loop no es más que “una operación que hiciste una vez”, no un ciclo en el verdadero sentido.
El disparador define:¿Cuándo? ¿Qué hacer?
En Claude Code, usa el/loopcomando para crear un Loop con activación programada:
Ejemplo
# escribir los hallazgos en TODO.md y redactar un plan de corrección para los problemas marcados como quick-win
/loop "Read yesterday's CI failures and open issues, write findings \
to TODO.md, and draft fixes for anything labeled quick-win" \
--schedule "0 9 * * 1-5"
# /goal: ejecutar hasta que se cumpla una condición verificable
# El siguiente comando se ejecutará continuamente hasta que todas las pruebas del módulo de autenticación pasen y el lint esté limpio
/goal "All tests in test/auth pass and lint is clean"
En OpenAI Codex, Automations tiene un panel de interfaz dedicado. Puedes configurar el proyecto, el prompt, la cadencia (cadence) y si se ejecuta en un checkout local o en un Worktree en segundo plano. Las ejecuciones con hallazgos entran en la bandeja de entrada de Triage; las que no encuentran nada se archivan automáticamente.
Advertencia de costo de tokens:Un Loop programado con subagentes de verificación consume tokens en cada activación, y el consumo varía notablemente según la complejidad de la tarea. Se recomienda empezar con una cadencia más lenta (por ejemplo, una vez al día), observar los costos durante unos días y luego aumentar la frecuencia.
Elemento 2: Aislamiento en paralelo (Worktrees)
Cuando ejecutas varios agentes a la vez, los conflictos de archivos son el punto más problemático. Dos agentes escribiendo el mismo archivo al mismo tiempo es como dos ingenieros enviando cambios a la misma línea de código: el resultado es desastroso.
Git WorktreeLa solución es: proporcionar a cada Agente un directorio de trabajo independiente, operando cada uno en su propia rama, compartiendo el mismo historial de Git, pero con cambios de archivos totalmente aislados.
Ejemplo
git worktree add ../agent-fix-auth feature/fix-auth-tests
git worktree add ../agent-upgrade-deps feature/upgrade-axios
# En Claude Code, configurar aislamiento de worktree para los subagentes
# Añadir en el frontmatter de .claude/agents/reviewer.md:
# isolation: worktree → cada Agente obtiene un checkout independiente y se limpia automáticamente al terminar
Worktree elimina los conflictos mecánicos de archivos, pero no elimina elcuello de botella de la revisión. La velocidad con la que procesas y apruebas los cambios de código es el límite real que determina cuántos Agentes puedes ejecutar en paralelo, no la cantidad de Worktrees que la herramienta pueda abrir.
Elemento 3: Archivos de habilidades (Skills)
Skills (archivos de habilidades) resuelven un costo que se desperdicia cada vez:Cada nueva conversación, el Agente tiene que deducir desde cero las convenciones de tu proyecto。
Un Skill es una carpeta que contiene unSKILL.mdarchivo que documenta convenciones del proyecto, pasos de compilación, y conocimiento como “no hacemos esto por aquel incidente”. El Agente carga el Skill al inicio de cada sesión, en lugar de adivinar de nuevo cada vez.
Ejemplo
---
name: project-conventions
description: Convenciones de codificación del proyecto y pasos de construcción. Cualquier tarea que implique modificación de código debe cargar esta skill.
---
## Pila tecnológica
- Backend: Node.js20 + TypeScript 5.4 + Fastify
- Base de datos: PostgreSQL16, ORM usa Drizzle
- Pruebas: Vitest; los archivos de prueba van en __tests__/ al mismo nivel que src/
## Comandos de construcción
- Instalar dependencias: pnpm install
- Ejecutar pruebas: pnpm test
- Verificación de tipos: pnpm typecheck
- Generar artefactos de compilación: pnpm build
## Convenciones principales
- Todas las consultas a la base de datos deben pasar por las funciones encapsuladas en src/db/queries/; prohibido escribir SQL directamente en la capa de negocio
- Los errores deben usar uniformemente la clase AppError (src/errors/AppError.ts); prohibido lanzar strings sueltos
- Nombres de archivos de rutas de API:{resource}.routes.ts, colocados en src/routes/
- Toda API nueva debe actualizar también docs/api.md
## Prohibiciones
- No modificar directamente los archivos de migración históricos en el directorio migrations/
- No incluir claves reales en el archivo .env; usar .env.example como marcador de posición
Elemento 4: Conectores (Connectors / MCP)
Un Loop que solo puede ver el sistema de archivos local puede hacer muy poco. Los conectores (basados en MCP – Model Context Protocol) permiten al Agente leer el seguimiento de Issues, consultar bases de datos, llamar APIs y enviar mensajes en Slack.
Esta es la diferencia clave entre “el Agente dice aquí está la solución” y “el Loop abre automáticamente un PR, vincula el Ticket y notifica al canal cuando el CI pasa”.
Claude Code y OpenAI Codex son compatibles de forma nativa con el protocolo MCP, por lo que un conector escrito para una herramienta suele funcionar en ambas.
Ejemplo: Configurar conectores MCP en Claude Code
// Configurar el conector MCP para que el agente pueda operar GitHub y enviar notificaciones de Slack
{
"connectors": [
{
"name": "github",
"command": "npx",
"args": ["-y", "@modelcontextprotocol/server-github"],
"env": {
"GITHUB_TOKEN": "${GITHUB_TOKEN}"
}
},
{
"name": "slack",
"command": "npx",
"args": ["-y", "@modelcontextprotocol/server-slack"],
"env": {
"SLACK_BOT_TOKEN": "${SLACK_BOT_TOKEN}"
}
}
]
}
Conectar un conector al agente significa que este puede tomar acciones reales en un entorno real. Se debe configurar el principio de mínimo privilegio para cada conector, y las operaciones de alto riesgo (empujar código, fusionar PR, enviar notificaciones externas) deben requerir aprobación humana y no ejecutarse de forma totalmente automática.
Elemento 5: Subagentes (Sub-Agents)
Una de las decisiones de arquitectura más importantes en el Loop:Separar el agente que escribe código del agente que revisa el código。
El modelo que escribió el código tiende a ser demasiado indulgente al calificar su propio trabajo. Un revisor independiente con instrucciones diferentes —a veces incluso usando un modelo distinto— puede detectar los problemas que el primer agente pasó por alto al justificarse a sí mismo.
Este patrón de "creador-revisor" (Maker-Checker) también se aplica a la condición de detención del Loop: el comando de Claude Code/goalDespués de cada iteración, el comando utiliza un modelo separado para determinar si está "completado", en lugar de permitir que el modelo que realizó el trabajo lo determine.
Ejemplo: Definir un subagente verificador
---
name: spec-reviewer
description: Realizar una revisión adversarial de los cambios de código completados, verificando que cumplan con las especificaciones y los requisitos de prueba.
model: opus # Usar un modelo más potente como verificador
isolation: worktree # Realizar la comprobación de forma independiente para evitar contaminar el área de trabajo del creador
---
Eres un revisor de código adversarial. Tu trabajo no es aprobar, sino cuestionar.
Cuando recibas un diff, debes:
1. Ejecutar la suite de pruebas completa (pnpm test) y registrar los fallos
2. Ejecutar la comprobación de tipos (pnpm typecheck)
3. Comparar el diff con las especificaciones del proyecto en SKILL.md
4. Verificar que los cambios de comportamiento visibles para el usuario coincidan con los requisitos originales
Solo cuando todas las pruebas pasen, la comprobación de tipos esté limpia y no haya violaciones de especificaciones, se debe generar APPROVED.
De lo contrario, genera una razón de rechazo concreta; no des evaluaciones vagas.
Elemento 6: Memoria persistente (Memory)
La memoria es el pilar central de todo Loop que pueda ejecutarse de forma continua a través de conversaciones.
El modelo olvida por completo entre conversaciones. Sin memoria externa, cada vez que se activa el Loop el agente empieza desde cero, sin saber qué se hizo ayer, qué correcciones ya se fusionaron o qué tareas siguen abiertas.
La solución es extremadamente simple:Escribir el estado en un archivo y colocar ese archivo en el repositorio. El repositorio recuerda, aunque el modelo no recuerde.
Ejemplo: Archivo de estado del Loop
# Estado de las tareas del Loop
Última actualización:2026-06-1409:03 UTC (actualizado por el Loop automático)
## En curso
- [ ]Test inestable en test/auth/login.spec.ts (CI Run#4821, falló 3 veces)
- Hipótesis: fuga de estado de sesión entre pruebas concurrentes
- Probado: aislar la conexión de la base de datos de prueba → sin efecto
- Siguiente paso: revisar la lógica de limpieza en beforeEach
## Pendiente
- [ ]Actualizar axios a1.7.x (vulnerabilidad de seguridad CVE-2026-xxxxx)
- [ ]Actualización de la documentación de la API (PR#308 quedó desactualizada respecto al código después de fusionarse)
## Completado
- [x]Corregido el error causado por nombres de empresa con comillas simples en el módulo de facturación500Error (PR#312, fusionado)
- [x]Actualizar la versión de Node.js a20.x(PR #307, fusionado)
Cinco patrones comunes de Loop
Diferentes tipos de tareas de trabajo requieren diferentes señales de retroalimentación y condiciones de detención, por lo que se han desarrollado varios patrones clásicos de Loop.
| Patrón | Señal de observación principal | Condición de detención | Escenario típico |
|---|---|---|---|
| Loop impulsado por pruebas | Pruebas que pasan / fallan | Todas las pruebas objetivo pasan | Corrección de errores, pruebas de regresión, lógica de transformación de datos |
| Loop impulsado por el compilador | Lista de errores de tipo y errores de compilación | Cero errores en la comprobación de tipos | Migración de TypeScript, actualización de dependencias, refactorización |
| Loop impulsado por revisión | Comentarios de revisión humana | Todos los comentarios se procesan o se ignoran con una justificación documentada | Seguimiento mecánico de las revisiones de PR |
| Loop de depuración en tiempo de ejecución | Registros, trazas de pila, respuestas HTTP | Problema reproducible → formular hipótesis → verificar la corrección | Errores de producción, problemas de rendimiento, anomalías de interfaz |
| Loop de iteración de producto | Capturas de pantalla, inspecciones de navegador, informes de accesibilidad | Alineación con el diseño, comportamiento responsivo correcto, sin violaciones de especificaciones | Páginas de aterrizaje, ajustes de UI, componentes de marketing |
Construye tu primer Loop
No intentes construir desde el principio un Loop complejo totalmente automático, con múltiples agentes y fusión automática de PR. Comienza con un Loop mínimo viable, comprende su comportamiento y luego expándelo gradualmente.
Paso 1: Comienza con una tarea acotada
Cuanto más acotada sea la tarea, más claro tendrá el agente qué archivos son importantes y qué señales de verificación son relevantes.
| Definición de tarea deficiente | Definición de tarea buena |
|---|---|
| "Optimizar el rendimiento del panel" | "Reducir el tiempo de carga inicial del panel en un 30% retrasando la carga de gráficos no críticos, manteniendo al mismo tiempo el funcionamiento de los filtros existentes" |
| "Arreglar el problema de checkout" | "Corregir la prueba de cálculo de impuestos que falla en test/checkout/tax.spec.ts" |
| "Mejorar la página de configuración" | "Corregir el problema de diseño del botón de eliminación de cuenta que se corta en dispositivos móviles (ancho de 375px)" |
Paso 2: Indica claramente el método de verificación
El Loop necesita saber qué significa "completado". Si conoces el comando de verificación, inclúyelo directamente en las instrucciones.
Ejemplo: Instrucción de Loop con condiciones de verificación
/goal "Fix the auth bug"
# Bien: hay un comando de verificación concreto y criterios de éxito
/goal "Fix the session leak causing flaky tests in test/auth/login.spec.ts.
Success condition: run 'pnpm test test/auth/login.spec.ts' 5 times
consecutively with zero failures. Do not touch other test files."
Paso 3: Establece mecanismos de seguridad
Antes de que el Loop pueda abrir PR automáticamente, haz que solo escriba archivos y no realice ninguna operación externa; tú revisas el diff y decides si hacer commit.
Ejemplo: Loop de clasificación de fallos de CI diario (versión mínima segura)
# - Solo operaciones de lectura (leer registros de CI, leer Issues)
# - Solo escribir TODO.md (no tocar otros archivos)
# - No abrir PR ni fusionar código
# - Cada mañana revisas TODO.md y decides manualmente el siguiente paso
/loop "Read yesterday's CI failure logs and GitHub Issues labeled 'bug'.
Categorize findings by likely cause.
Write a summary with prioritized action items to TODO.md.
Do NOT edit any source files. Do NOT open any PRs." \
--schedule "0 8 * * 1-5"
Este Loop mínimo ya es muy valioso: cada mañana organiza la lista de problemas del día anterior, y cuando llegas a la oficina abres TODO.md y sabes qué hacer hoy, en lugar de pasar media hora revisando los registros de CI. Es el mejor punto de partida para entender el comportamiento del Loop, con un riesgo casi nulo.
Paso 4: Aumenta gradualmente el grado de autonomía
| Fase | Lo que el Loop puede hacer | Lo que hace el humano |
|---|---|---|
| Fase 1 (solo lectura) | Detectar problemas, clasificar tareas, escribir el archivo de estado | Revisar TODO.md y decidir manualmente el orden de procesamiento |
| Fase 2 (borrador) | Redactar propuestas de corrección, ejecutar pruebas, escribir en la rama | Revisar el diff y ejecutar git push manualmente |
| Fase 3 (semiatomática) | Abrir un Draft PR, ejecutar CI, notificar a Slack | Revisar el PR y hacer clic manualmente en Merge |
| Fase 4 (totalmente automática) | Dos agentes: creador + revisor, fusión automática después de que CI pase | Intervención humana en casos excepcionales, auditoría periódica del historial de fusiones |
Tres grandes riesgos de Loop Engineering
El Loop cambia la forma de trabajar, pero no elimina la responsabilidad del ingeniero. Hay tres problemas que se vuelven más graves a medida que el Loop mejora, y no más fáciles.
Riesgo 1: La verificación sigue siendo tu responsabilidad
Un Loop que se ejecuta sin supervisión también es un Loop que produce errores sin supervisión. Configurar un sub-agente verificador es un buen método para reducir el riesgo, pero "pasó la verificación" es una declaración, no una prueba.
No importa cuán confiable sea el Loop, la revisión humana del código fusionado no puede desaparecer.
Riesgo 2: La deuda de comprensión (Comprehension Debt) se acumula más rápido
Cuanto más rápido el Loop produce código, menor es la proporción de código que realmente comprendes. Este no es un problema exclusivo de la programación con IA, pero el Loop lo acelera.
El único antídoto es:Leer el código producido por el Loop. No dejes de entender qué está haciendo solo porque el Loop funciona sin problemas.
Riesgo 3: Rendición cognitiva (Cognitive Surrender)
Cuando el Loop funciona automáticamente, aceptar cualquier resultado que devuelva es la opción más cómoda. Este es el peligro más latente de la Ingeniería de Loops.
Dos personas pueden construir exactamente el mismo Loop y obtener resultados completamente opuestos: uno lo usa para avanzar más rápido sobre la base de una comprensión profunda, el otro lo usa para evitar el trabajo de comprensión en sí. El Loop no conoce la diferencia. Tú sí.
Cuatro tipos de modos de fallo del Loop y métodos para abordarlos:
| Modo de fallo | Manifestación | Causa raíz | Solución |
|---|---|---|---|
| Marcha en vacío (Thrashing) | El Agent modifica el código repetidamente, pero no converge | El objetivo no es claro, o la señal de verificación tiene ruido, o el alcance de cada modificación es demasiado grande | Reduce el alcance del objetivo, disminuye el tamaño de cada diff, usa comandos de verificación más confiables |
| Sobreajuste a las pruebas | Todas las pruebas pasan, pero la funcionalidad en realidad es incorrecta | La cobertura de pruebas es demasiado estrecha, no se verifican escenarios reales de usuario | Combina pruebas automáticas y comprobaciones de aceptación humana, añade pruebas de extremo a extremo |
| Deriva de contexto | El Agent continúa trabajando basándose en suposiciones obsoletas, ignorando los cambios que surgen | No se actualiza el contexto después de observaciones clave | Vuelve a recopilar el contexto después de observaciones importantes, no trates el plan inicial como sagrado |
| Autonomía insegura | El Agent ejecuta operaciones destructivas sin autorización | El alcance de permisos es demasiado amplio, no hay condiciones claras de detención | Principio de mínimo privilegio, las operaciones de alto riesgo deben requerir aprobación humana, establece reglas claras de detención |
Resumen de mejores prácticas
Los siguientes son los principios centrales para construir un Loop confiable, cada uno corresponde a un tipo común de fallo.
| Principio | Práctica concreta |
|---|---|
| Empieza con tareas estrechas | Define solo un objetivo con límites claros cada vez; un objetivo amplio impide que el Agent determine qué archivos y qué señales de verificación son relevantes |
| Dile al Agent cómo verificar | Escribe directamente el comando de verificación en las instrucciones (pnpm test test/auth), escenarios de aceptación o endpoints de API, para que "completado" sea medible |
| Prefiere cambios pequeños y reversibles | Exige al Agent hacer la modificación coherente más pequeña, ejecuta la verificación y luego expande; las reescrituras especulativas a gran escala dificultan determinar qué suposición falló |
| Respeta los patrones de código existentes | Haz que el Agent revise primero las implementaciones adyacentes, reutilice los componentes existentes, siga la nomenclatura existente y evite introducir abstracciones nuevas innecesarias |
| Los humanos mantienen el asiento del juicio | El Agent maneja la recopilación de evidencia y las correcciones mecánicas; el juicio de producto, las decisiones de arquitectura y la revisión final quedan reservados para los humanos |
| Consolida Loops reutilizables | Cuando un Loop funciona bien, consolídalo como un archivo de Skill o un desencadenante estandarizado, para reducir el costo de repetición en el futuro |