GraphRAG Einsteigertutorial
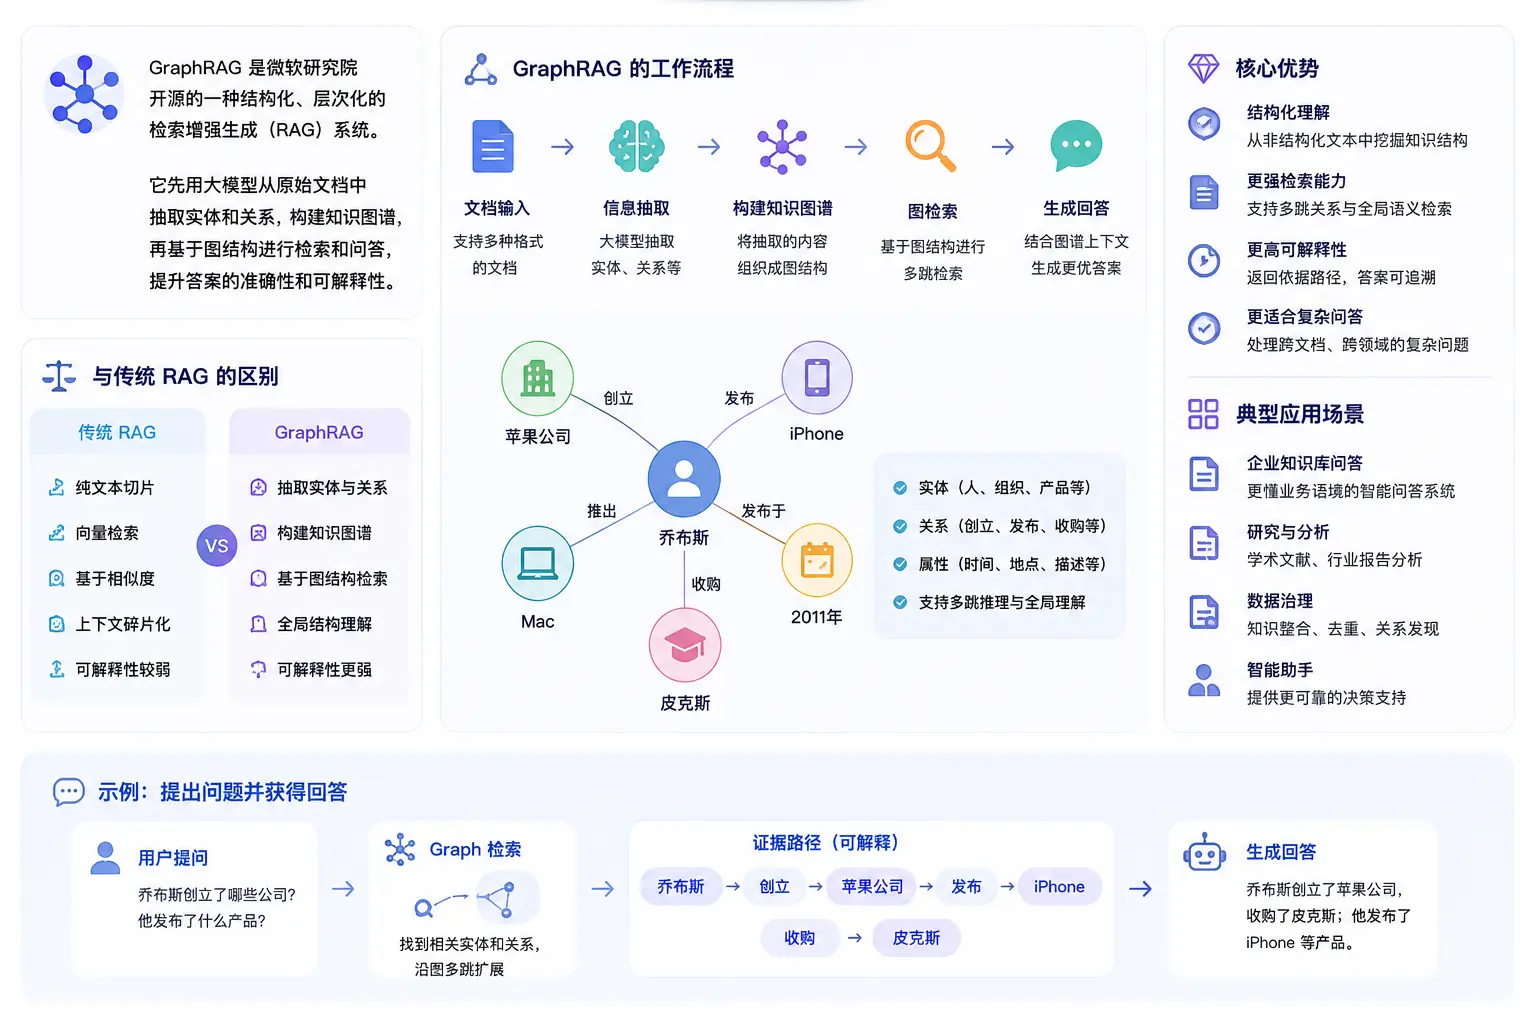
GraphRAG ist ein strukturiertes, hierarchisches Retrieval-Augmented-Generation-(RAG)-System, das von Microsoft Research als Open Source veröffentlicht wurde. Im Gegensatz zu traditionellem RAG, das reine Textvektor-Suche verwendet, nutzt GraphRAG zunächst ein großes Sprachmodell, um Entitäten und Beziehungen aus Rohdokumenten zu extrahieren, konstruiert einen Wissensgraphen und führt dann Retrieval und Fragebeantwortung auf Basis der Graphstruktur durch.
Dieses Tutorial richtet sich an Einsteiger ohne Vorkenntnisse und führt Sie durch den kompletten Workflow von der InstallationDokument → Wissensgraph → Abfrage-Fragen&AntwortenDas verwendete Modell istqwen-plus, und das Embedding verwendet Alibaba Cloud Tongyistext-embedding-v4。
Was ist GraphRAG
Um GraphRAG zu verstehen, müssen Sie zunächst verstehen, wie es besser ist als traditionelles RAG.
Grenzen von traditionellem RAG
Der Workflow von traditionellem RAG (Baseline RAG) ist: Dokumente in kleine Chunks aufteilen → Vektoren generieren → wenn eine Frage kommt, Vektorähnlichkeit verwenden, um die relevantesten Chunks abzurufen → sie dem Modell zuführen, um eine Antwort zu generieren.
Dieser Ansatz funktioniert gut für Fragen vom Typ "exakte Suche", ist aber in zwei Szenarien leistungsschwach:
- Dokumentübergreifendes relationales Schlussfolgern: Wenn die Antwort erfordert, über verschiedene Dokumente verstreute Informationen zu verbinden, kann Vektorähnlichkeit diese "Beziehung" nicht ausdrücken. Zum Beispiel: "Was ist die Schnittmenge zwischen dem CEO von Unternehmen A und dem Gründer von Unternehmen B?"
- Globale Zusammenfassungsfragen: Wenn die Frage eine Zusammenfassung des gesamten Korpus auf Makroebene erfordert, können einige Text-Chunks nicht das Gesamtbild abdecken. Zum Beispiel: "Was sind die kritischsten Risikopunkte in diesem Stapel von Finanzberichten?"
Wie GraphRAG diese beiden Probleme löst
Die Kernidee von GraphRAG ist:Anstatt direkt Text-Chunks abzurufen, wird zuerst ein Wissensgraph aufgebaut und dann auf Basis der Graphstruktur abgerufen.。
Der gesamte Prozess ist in zwei Phasen unterteilt:
| Phase | Was es tut | Was es ausgibt |
|---|---|---|
| Index | Verwenden Sie das LLM, um Dokumente zu lesen, Entitäten (Personen, Orte, Organisationen usw.) und Beziehungen zu extrahieren und einen Wissensgraphen aufzubauen; verwenden Sie dann den Leiden-Algorithmus, um hierarchisches Clustering auf dem Graphen durchzuführen und für jede Community eine Zusammenfassung zu generieren. | Wissensgraph + Community-Zusammenfassungen + Vektorindex |
| Abfrage | Wenn ein Benutzer eine Frage stellt, werden je nach Fragetyp unterschiedliche Retrieval-Strategien ausgewählt, und Graphdaten, Community-Zusammenfassungen und ursprüngliche Text-Chunks werden alle in den LLM-Kontext injiziert, um eine Antwort zu generieren. | Strukturierte Antworten mit Quellenangaben |
Die Indexierungsphase von GraphRAG erfordert den Aufruf einer großen Anzahl von LLM-APIs, wobei für jedes Textsegment Entitätsextraktion und Zusammenfassung durchgeführt werden,Der Token-Verbrauch ist weit höher als bei traditionellem RAG. Es wird empfohlen, dass Sie bei der ersten Verwendung zuerst den Workflow mit einem kleinen Dokument (innerhalb weniger tausend Zeichen) testen und erst nach Bestätigung der korrekten Funktion große Korpora verarbeiten.
Vergleich der vier Abfragemodi
| Abfragemodus | Retrieval-Strategie | Geeignete Fragetypen | Ressourcenverbrauch |
|---|---|---|---|
| Globale Suche | Map-Reduce: alle Community-Zusammenfassungen durchlaufen | Globale und Zusammenfassungsfragen, wie z. B. "Was ist das Kernthema dieser Dokumente?" | Hoch (mehrere gleichzeitige LLM-Aufrufe) |
| Lokale Suche | Ausgehend von relevanten Entitäten Nachbarn und zugehörige Texte erweitern | Fragen zu bestimmten Entitäten, wie z. B. "das wichtigste Beziehungsnetzwerk einer Person" | Mittel |
| DRIFT-Suche | Lokale Suche + iterative Nachfragen, geleitet durch Community-Informationen | Entitätsbezogene Fragen, die einen breiten Kontext erfordern und Tiefe und Breite ausbalancieren | Mittel-hoch |
| Basissuche | Standard-Vektorähnlichkeit (wie bei traditionellem RAG) | Einfacher exakter Abruf zu Vergleichszwecken | Niedrig |
Umgebungsanforderungen
Bevor Sie beginnen, stellen Sie sicher, dass Ihre Umgebung die folgenden Anforderungen erfüllt.
| Abhängigkeiten | Versionsanforderungen | Beschreibung |
|---|---|---|
| Python | 3.10 ~ 3.12 | Offizieller Supportumfang; 3.13 wird derzeit nicht unterstützt. |
| pip | Neueste Version | Empfohlen, zuerstpip install --upgrade pip |
| Alibaba Cloud Bailian API-Schlüssel | — | Unterbailian.console.aliyun.com/beantragen |
| Speicherplatz | ≥ 2GB | Index-Artefakte (Parquet-Dateien, Vektordatenbank) werden erheblichen Speicherplatz belegen. |
Installation
GraphRAG ist auf PyPI veröffentlicht. Es wird empfohlen, es in einer virtuellen Python-Umgebung zu installieren, um die Systemumgebung nicht zu verunreinigen.
Ein Projektverzeichnis erstellen und eine virtuelle Umgebung initialisieren
mkdir graphrag_demo
cd graphrag_demo
python -m venv .venv
You can also useden uv-Befehlverwenden, um eine Python-Version anzugeben:uv venv --python 3.12
Virtuelle Umgebung aktivieren
macOS / Linux:
source .venv/bin/activate
Windows:
.venv\Scripts\activate
GraphRAG installieren
pip install graphrag
Nach Abschluss der Installation überprüfen:
graphrag --help
Es werden einigegraphrag-Befehlsinformationen ausgegeben. Die Ausgabe sieht ungefähr so aus:
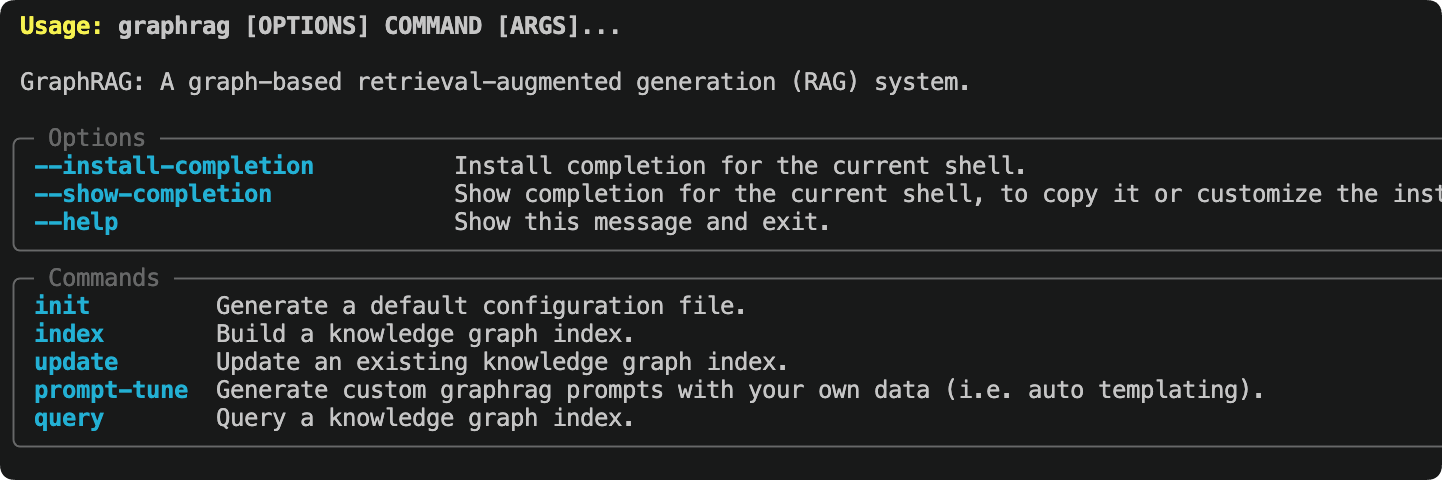
GraphRAG installiert automatisch Abhängigkeiten wie LiteLLM, LanceDB, pandas und numpy. Die erste Installation kann eine Weile dauern (normalerweise 1-3 Minuten). Bitte haben Sie Geduld.
Arbeitsbereich initialisieren
Führen Siegraphrag initden Befehl aus, GraphRAG generiert Konfigurationsdateien und die Verzeichnisstruktur im aktuellen Verzeichnis.
graphrag init
Es fordert uns auf, die Modelle festzulegen. Drücken Sie einfach die Eingabetaste, um die Standardwerte zu akzeptieren; wir können sie später ändern:
Specify the default chat model to use [gpt-4.1]:
Specify the default embedding model to use [text-embedding-3-large]:
Während der Initialisierung werden Sie aufgefordert, das Standard-Chat-Modell und das Embedding-Modell einzugeben. Sie können vorerst einfach die Eingabetaste drücken, um zu überspringen; wir werden sie später manuell ändern.settings.yaml。
Nach Abschluss der Initialisierung sieht die Verzeichnisstruktur wie folgt aus:
graphrag_demo/
├── .env                  # 存放 API Key 环境变量
├── settings.yaml         # 核心配置文件
├── input/                # 存放待处理的文本文件
├── output/               # 索引产物输出目录(自动生成)
└── prompts/              # Prompt 模板目录(自动生成)
Nach jedem Minor-Versions-Upgrade von GraphRAG wird empfohlen, erneut auszuführen
graphrag init --forceum das Konfigurationsformat zu aktualisieren; andernfalls können aufgrund von Änderungen der Konfigurationsstruktur Fehler auftreten. Beachten Sie, dass dieser Befehl vorhandenesettings.yamlund Prompts überschreibt. Es wird empfohlen, sie zuvor zu sichern.
Testdokumente vorbereiten
GraphRAG unterstützt.txt、.csv、.jsonDokumente im ...-Format. Alle zu verarbeitenden Dateien sollten iminput/Verzeichnis abgelegt werden.
Wir verwenden das offiziell empfohlene Testdokument – Charles Dickens' "A Christmas Carol" – direkt von Project Gutenberg heruntergeladen:
curl /static.jyshare.com/download/pg24022.txt?v=2 -o ./input/book.txt
Wenn kein Netzwerkzugriff besteht, können Sie auch selbst einen chinesischen Testtext erstellen. Je reichhaltiger der Inhalt (mit vielen Figuren, Orten und Ereignisbeziehungen), desto deutlicher wird der Knowledge-Graph-Effekt von GraphRAG:
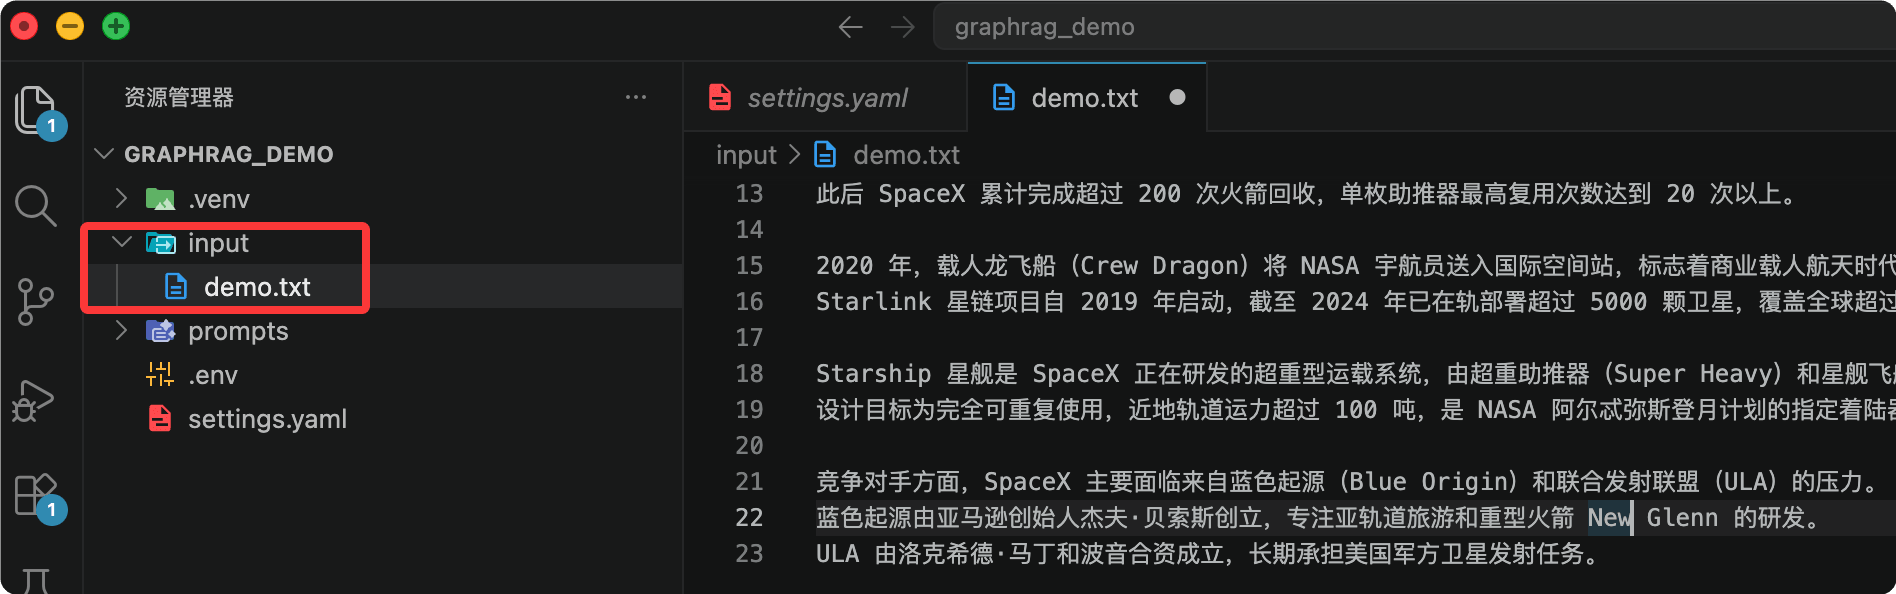
Legen Sie die Datei iminput-Verzeichnis ab, mit dem Dateinamendemo.txt:
SpaceX 太空探索技术公司成立于 2002 年,由埃隆·马斯克(Elon Musk)在美国加利福尼亚州霍桑市创办。
公司目标是大幅降低太空运输成本,最终实现人类移民火星。

马斯克早年联合创立了 PayPal,2002 年以 15 亿美元出售给 eBay,随后将个人资产投入 SpaceX。
联合创始人中,汤姆·穆勒(Tom Mueller)担任推进系统首席设计师,主导了 Merlin 和 Raptor 发动机的研发。
格温·肖特维尔(Gwynne Shotwell)于 2002 年加入,2008 年起担任总裁兼 COO,负责公司日常运营和商业拓展。

2008 年,猎鹰 1 号(Falcon 1)在经历三次失败后首次成功入轨,成为首个由私营公司研制的液体轨道火箭。
2010 年,猎鹰 9 号(Falcon 9)首飞成功,同年龙飞船(Dragon)完成首次商业发射与回收。
2012 年,龙飞船成为首个对接国际空间站的商业航天器。

2015 年 12 月,猎鹰 9 号一级火箭首次实现陆地垂直回收,开创了火箭重复使用的新纪元。
此后 SpaceX 累计完成超过 200 次火箭回收,单枚助推器最高复用次数达到 20 次以上。

2020 年,载人龙飞船(Crew Dragon)将 NASA 宇航员送入国际空间站,标志着商业载人航天时代的开始。
Starlink 星链项目自 2019 年启动,截至 2024 年已在轨部署超过 5000 颗卫星,覆盖全球超过 60 个国家和地区。

Starship 星舰是 SpaceX 正在研发的超重型运载系统,由超重助推器(Super Heavy)和星舰飞船组成,
设计目标为完全可重复使用,近地轨道运力超过 100 吨,是 NASA 阿尔忒弥斯登月计划的指定着陆器。

竞争对手方面,SpaceX 主要面临来自蓝色起源(Blue Origin)和联合发射联盟(ULA)的压力。
蓝色起源由亚马逊创始人杰夫·贝索斯创立,专注亚轨道旅游和重型火箭 New Glenn 的研发。
ULA 由洛克希德·马丁和波音合资成立,长期承担美国军方卫星发射任务。
qwen-plus und das Embedding-Modell konfigurieren
Dies ist der kritischste Schritt des gesamten Tutorials; Sie müssen.envundsettings.yamlzwei Dateien ändern.
Schritt 1: API-Schlüssel konfigurieren
Open.envDatei, und geben Sie Ihren API-Schlüssel ein:
Beispiel
# Alibaba Cloud Bailian API-Schlüssel
DASHSCOPE_API_KEY=sk-your-dashscope-api-key-here
Schritt 2: settings.yaml ändern
Opensettings.yaml, und ersetzen Sie den gesamten Inhalt durch die folgende Konfiguration.
GraphRAG 2.x verwendet LiteLLM, um verschiedene Modelle einheitlich aufzurufen,model_provider: openaiZusammen mitapi_baseSie können Anfragen an jede OpenAI-kompatible Schnittstelle weiterleiten:
completion_models:
  default_completion_model:
    model_provider: openai
    model: qwen-plus                              # 中文抽取稳定,成本低于 qwen-plus
    auth_method: api_key
    api_key: ${DASHSCOPE_API_KEY}
    api_base: https://dashscope.aliyuncs.com/compatible-mode/v1
    call_args:
      temperature: 0                              # 提高结构化稳定性
      max_tokens: 4096
    retry:
      type: exponential_backoff
      max_retries: 5
      base_delay: 2

embedding_models:
  default_embedding_model:
    model_provider: openai
    model: text-embedding-v4                      # 通义向量模型
    auth_method: api_key
    api_key: ${DASHSCOPE_API_KEY}
    api_base: https://dashscope.aliyuncs.com/compatible-mode/v1
    retry:
      type: exponential_backoff
      max_retries: 5

input:
  type: text

input_storage:
  type: file
  base_dir: input

chunking:
  type: tokens
  size: 600                                       # 中文推荐 500~800
  overlap: 100
  encoding_model: o200k_base

output_storage:
  type: file
  base_dir: output

reporting:
  type: file
  base_dir: logs

cache:
  type: json
  storage:
    type: file
    base_dir: cache

vector_store:
  type: lancedb
  db_uri: output/lancedb

embed_text:
  embedding_model_id: default_embedding_model    # 注意不要带逗号
  batch_size: 10                                 # 百炼 embedding 单次最多10条
  batch_max_tokens: 6000
  concurrency: 1                                 # 避免并发触发限流

extract_graph:
  completion_model_id: default_completion_model
  entity_types: []                               # 自动识别实体
  max_gleanings: 3                               # 提高关系补抽成功率

summarize_descriptions:
  completion_model_id: default_completion_model
  max_length: 500

cluster_graph:
  max_cluster_size: 20                           # 降低社区数量

extract_claims:
  enabled: false

community_reports:
  completion_model_id: default_completion_model
  max_length: 1500
  max_input_length: 4000                         # 防止生成阶段过慢

snapshots:
  graphml: true                                  # 导出图结构
  embeddings: false

local_search:
  completion_model_id: default_completion_model
  embedding_model_id: default_embedding_model
  top_k_entities: 10

global_search:
  completion_model_id: default_completion_model
  map_max_length: 500
  reduce_max_length: 1500
Über Qwens JSON-Ausgabe:GraphRAG erfordert, dass das Modell bei der Entitätsextraktion stabil das JSON-Format zurückgibt. Qwen unterstützt den JSON-Modus; setzen Sie
temperatureauf 0 kann die Ausgabestabilität weiter verbessern und die Wahrscheinlichkeit von Parsing-Fehlern verringern. Wenn weiterhin JSON-Parsing-Fehler auftreten, können Sie versuchencall_argsHinzufügen zuresponse_format: {type: json_object}。
Indexierung starten
Nach Abschluss der Konfiguration führen Sie den Indexierungsbefehl aus. GraphRAG liest automatischinput/alle Dateien im Verzeichnis, ruft qwen-plus für Entitätsextraktion, Relationserkennung und Zusammenfassungsgenerierung auf und erstellt schließlich einen vollständigen Wissensgraphen.
graphrag index
Sie sehen eine Fortschrittsausgabe ähnlich der folgenden:
⠹ GraphRAG Indexer
├── Loading Input (text) - 1 files loaded
├── create_base_text_units
├── extract_graph
│   └── Entity Extraction: 100%|████████████| 12/12 [02:34<00:00]
├── summarize_descriptions
├── cluster_graph
├── community_reports
└── generate_text_embeddings
All workflows completed successfully.
Nach Abschluss der Indexierung,output/wird eine Reihe von Parquet-Dateien im Verzeichnis generiert:
| Datei | Inhalt |
|---|---|
entities.parquet | Alle extrahierten Entitäten (Name, Typ, Beschreibung, Vektor) |
relationships.parquet | Beziehungen zwischen Entitäten (Quellentität, Zielentität, Beziehungsbeschreibung, Gewicht) |
communities.parquet | Von Leiden-Clustering generierte Communities (hierarchische Struktur) |
community_reports.parquet | Zusammenfassungsbericht für jede Community (Kerndaten für die Globale Suche) |
text_units.parquet | Originale Textabschnitte (Referenzquelle für die Lokale Suche) |
lancedb/ | Vektordatenbank, die Vektoren für verschiedene Entitäten und Textabschnitte speichert |
Referenz zur Indexierungsdauer:Für ein chinesisches Dokument mit einigen tausend Zeichen (etwa 10–20 Textabschnitte) dauert die Verwendung von qwen-plus ungefähr 3–10 Minuten; bei großen Dokumentensätzen mit über 100.000 Zeichen kann es mehrere Stunden dauern. Es wird empfohlen, den Workflow zunächst mit einem kleinen Dokument durchzuführen und dann große Datenmengen zu verarbeiten.
Abfragen ausführen
Nach Abschluss der Indexierung können Sie den Wissensgraphen abfragen. GraphRAG bietet zwei Methoden: CLI und Python-API.
CLI-Abfragen
Globale Suche (geeignet für Fragen auf Makroebene):
graphrag query "文档中涉及的主要组织和人物有哪些?它们之间有什么关系?"
Lokale Suche (geeignet für Fragen zu bestimmten Entitäten), ergänzen Sie--method local:
graphrag query "SpaceX 公司的主要业务和合作伙伴有哪些?" --method local
DRIFT-Suche (Ausgleich von Tiefe und Breite):
graphrag query "埃隆·马斯克的职业背景和主要贡献是什么?" --method drift
Einfache Vektorsuche (im Vergleich zu traditionellem RAG):
graphrag query "Starship 星舰的设计目标和能力是什么?" --method basic
Python-API-Abfragen
GraphRAG-Abfragen im Code aufrufen, geeignet für die Integration in Anwendungen.
Beispiel
# GraphRAG-Python-API für Abfragen verwenden
import asyncio
from graphrag.api import GraphRagConfig, search
async def run_query():
# Konfigurationsdatei laden (settings.yaml aus dem aktuellen Verzeichnis lesen)
config = GraphRagConfig.from_yaml("settings.yaml")
# ── Beispiel für Globale Suche ──────────────────────────────
print("=" * 60)
print("[Globale Suche] Globale Frage")
print("=" * 60)
global_result = await search(
config=config,
query="Wie ist das Beziehungsnetzwerk der in den Dokumenten erwähnten wichtigen Unternehmen und Personen?",
method="global", # Globale Suche verwenden
)
print(global_result.response)
print()
# ── Beispiel für Lokale Suche ──────────────────────────────
print("=" * 60)
print("[Lokale Suche] Frage zu einer bestimmten Entität")
print("=" * 60)
local_result = await search(
config=config,
query="Was ist der Hintergrund des Gründungsteams von SpaceX und seiner Hauptprodukte?",
method="local", # Lokale Suche verwenden
)
print(local_result.response)
print()
# Abgerufene Quellinformationen anzeigen (optional)
if hasattr(local_result, "context_data"):
entities = local_result.context_data.get("entities", [])
print(f"Anzahl der abgerufenen relevanten Entitäten: {len(entities)}")
if __name__ == "__main__":
asyncio.run(run_query())
python query_demo.py
============================================================
【Global Search】全局性问题
============================================================
根据文档内容,主要涉及以下公司和人物关系网络:

**公司层面:**
- SpaceX 公司:主要角色,覆盖商业发射、载人航天、卫星互联网三大方向
- NASA:重要合作伙伴,阿尔忒弥斯登月计划 Starship 着陆器供应商
- 蓝色起源 / 联合发射联盟:主要竞争对手

**人物层面:**
- 马斯克(创始人):PayPal 联合创始人,SpaceX CEO 兼首席工程师
- 汤姆·穆勒(联合创始人):推进系统首席设计师,Merlin 和 Raptor 发动机之父
- 格温·肖特维尔:总裁兼 COO,负责公司商业运营

**关键关系:**
SpaceX 与 NASA 于 2020 年建立战略合作关系,
三家公司(SpaceX、蓝色起源、ULA)在商业航天发射市场形成竞争格局...

============================================================
【Local Search】针对特定实体的问题
============================================================
SpaceX 公司成立于 2002 年,创始团队包括:
- 马斯克:PayPal 联合创始人,SpaceX CEO 兼首席工程师,航天领域超二十年经验
- 汤姆·穆勒:推进系统首席设计师,主导 Merlin 和 Raptor 发动机研发

主要产品:
1. 猎鹰 9 号:全球首个实现垂直回收的轨道级火箭,已完成 200 次以上回收
2. Starship 星舰:超重型运载系统,近地轨道运力超 100 吨,完全可重复使用

检索到相关实体数量:12
Automatisches Prompt-Tuning
GraphRAG empfiehlt offiziell nachdrücklich, vor der Verarbeitung eigener Daten ein automatisches Prompt-Tuning durchzuführen.
Beim automatischen Prompt-Tuning liest das LLM einen Teil Ihrer Dokumente und generiert dann auf Ihre Datendomäne zugeschnittene Prompts zur Entitätsextraktion, was zu einer höherwertigen Wissensgraph-Erstellung führt.
graphrag prompt-tune --config settings.yaml --root . --language Chinese
Nach Abschluss des Prompt-Tunings,prompts/die Prompt-Dateien im Verzeichnis werden automatisch aktualisiert. Wenn Ihre Dokumente auf Chinesisch sind, fügen Sie den--language ChineseParameter hinzu, damit der generierte Prompt ebenfalls Chinesisch verwendet und die Genauigkeit der chinesischen Entitätsextraktion verbessert wird.
Das Prompt-Tuning selbst verbraucht ebenfalls LLM-Token (ungefähr äquivalent zu einer schnellen Indexierung einer kleinen Anzahl von Dokumenten). Es wird empfohlen, bei jeder Änderung Ihres Datensatzes erneut zu tunen, anstatt immer die Standard-Prompts zu verwenden.
Kurzreferenz für gängige CLI-Befehle
Im Folgenden finden Sie die am häufigsten verwendeten Befehle im täglichen GraphRAG-Einsatz.
| Befehl | Beschreibung |
|---|---|
graphrag init | Arbeitsbereich initialisieren und generieren.env、settings.yaml、input/ |
graphrag init --force | Erneute Initialisierung erzwingen (nach Versions-Upgrades verwenden); überschreibt die vorhandene Konfiguration |
graphrag index | Pairinput/Die vollständige Indexierungspipeline für die Dokumente im Verzeichnis ausführen |
graphrag index --resume | Die Indexierung dort fortsetzen, wo sie unterbrochen wurde (LLM-Aufrufe werden zwischengespeichert, sodass Token nicht wiederholt verbraucht werden) |
graphrag index --update | Inkrementelle Indexierung; verarbeitet nur neu hinzugefügte Dokumente |
graphrag query "问题" | Global Search-Abfrage (Standardmodus) |
graphrag query "问题" --method local | Local Search-Abfrage |
graphrag query "问题" --method drift | DRIFT Search-Abfrage |
graphrag query "问题" --method basic | Basic Search (Vektorabruf) |
graphrag prompt-tune | Prompt automatisch tunen (empfohlen vor der Verarbeitung neuer Datensätze auszuführen) |
Vollständige Feldreferenz für settings.yaml
Im Folgenden bieten wirsettings.yamleine detaillierte Erklärung der am häufigsten verwendeten Konfigurationselemente, um weitere Anpassungen zu erleichtern.
Modellbezogen
| Feld | Type | Beschreibung |
|---|---|---|
model_provider | string | Modellanbieter; ausfüllen, wenn eine OpenAI-kompatible Schnittstelle verwendet wirdopenai |
model | string | Modellname; für Qwen ausfüllenqwen-plus 或 qwen-max |
api_key | string | API Key; empfohlen wird die Verwendung von${ENV_VAR}Umgebungsvariablen-Referenzen |
api_base | string | API-Endpunkt; für Qwen ist eshttps://dashscope.aliyuncs.com/compatible-mode/v1 |
call_args.temperature | float | Generierungstemperatur; empfohlen wird, sie während der Indexierung auf 0 zu setzen, um die Stabilität zu verbessern |
call_args.max_tokens | int | Maximale Anzahl von Token pro Generierung |
retry.max_retries | int | Maximale Anzahl von Wiederholungsversuchen, wenn eine Anfrage fehlschlägt |
Chunking-bezogen
| Feld | Beschreibung | Empfohlener Wert |
|---|---|---|
chunking.size | Maximale Anzahl von Token pro Text-Chunk | Englisch: 1200~1500; Chinesisch: 600~1000 |
chunking.overlap | Anzahl überlappender Token zwischen benachbarten Chunks, um zu vermeiden, dass Entitäten an den Grenzen abgeschnitten werden | 50~150 |
chunking.type | tokens(Chunk nach Token) odersentence(Chunk nach Satz) | Im Allgemeinen verwendentokens |
Entitätsextraktion-bezogen
| Feld | Beschreibung | Empfehlung |
|---|---|---|
extract_graph.entity_types | Dem Modell die Liste der Entitätstypen mitteilen, auf deren Extraktion der Fokus liegen soll | An Ihren Geschäftsbereich anpassen, z. B.person, company, product, technology |
extract_graph.max_gleanings | Maximale Anzahl von Folgefragen pro Text-Chunk (Folgefragen können den Recall verbessern, aber mehr Token verbrauchen) | Auf 1 setzen, wenn Kosten ausgeglichen werden sollen; auf 2 setzen, wenn Qualität angestrebt wird |
FAQ
Was tun, wenn die Indexierung mittendrin fehlschlägt?
GraphRAG speichert die Ergebnisse jedes LLM-Aufrufs zwischen. Nach einem Fehler einfach erneut ausführengraphrag indexDie bereits erfolgreich verarbeiteten Text-Chunks werden aus dem Cache gelesen und verbrauchen Token nicht erneut.
Wenn Sie von einem bestimmten Schritt aus neu starten möchten, verwenden Sie--resumeden Parameter:
graphrag index --resume
Wie werden JSON-Parse-Fehler behandelt?
Die Entitätsextraktionsphase erfordert, dass das Modell strikt das JSON-Format zurückgibt. WennJSONDecodeError, können Sie die folgenden Methoden ausprobieren:
- In
call_argshinzufügenresponse_format: {type: json_object}(erfordert, dass das Modell diesen Parameter unterstützt) - wird
temperatureAuf 0 setzen - wird
max_gleaningsAuf 0 setzen (reduziert Rückfragen, senkt Fehlerwahrscheinlichkeit) - Führen Sie
graphrag prompt-tuneDen Prompt erneut optimieren, um das Modell mit dem Ausgabeformat vertrauter zu machen
Wie wählt man zwischen Global Search und Local Search?
| Fragetyp | Empfohlener Modus | Beispiel |
|---|---|---|
| Zusammenfassend, global | Globale Suche | „Was ist das Kernthema dieser Dokumente?“ „Das Gesamtbild des gesamten Beziehungsnetzwerks der Figuren“ |
| Für spezifische Entitäten | Lokale Suche | „Musks Berufserfahrung?“ „Haupttechnische Merkmale der Falcon-9-Rakete“ |
| Erfordert sowohl Tiefe als auch Breite | DRIFT-Suche | „Analyse der Beziehung zwischen einer bestimmten Person und dem umgebenden Ökosystem“ |
| Einfache präzise Suche | Basissuche | „In welchem Jahr wurde SpaceX gegründet?“ |
Wie lässt sich hoher Token-Verbrauch kontrollieren?
- wird
chunking.sizeAngemessen erhöhen (weniger Textblöcke = weniger LLM-Aufrufe) - wird
extract_graph.max_gleaningsAuf 0 oder 1 setzen - In
entity_typesnur die für das Geschäft relevantesten Entitätstypen beibehalten - Während der Indexierung ein günstigeres Modell verwenden und während der Abfrage bei Bedarf zu einem leistungsfähigeren Modell wechseln
GraphRAG bietet eine Strategie der „asymmetrischen Modellkonfiguration“: in
completion_modelsDefinieren Sie mehrere Modelle in ..., verwenden Sie während der Indexierung kostengünstige Modelle und in der Abfragephase leistungsfähigere Modelle für kritische Abfragen, um eine Balance zwischen Kosten und Qualität zu finden.
Wie geht man mit chinesischen Dokumenten um?
Bei der Verarbeitung chinesischer Dokumente sind folgende Punkte zu beachten:
- Stellen Sie sicher
input.encoding: utf-8(UTF-8 ist bereits Standard) - Verringern
chunking.size(chinesische Schriftzeichen haben eine hohe Informationsdichte; 600~1000 Token genügen) - Führen Sie
graphrag prompt-tune --language ChineseChinesischen Prompt generieren entity_typesSie können chinaspezifische Typen angemessen ergänzen, wie z. B.government_agency(Regierungsbehörden),policy(Richtlinien)
Weiterführende Literatur
| Thema | Beschreibung | Link |
|---|---|---|
| Offizielle vollständige Dokumentation | Enthält detaillierte Beschreibungen aller Konfigurationselemente | microsoft.github.io/graphrag |
| Konfigurationsreferenz | Vollständige Feldbeschreibung von settings.yaml | microsoft.github.io/graphrag/config/yaml/ |
| Leitfaden zur Modellauswahl | Wie man verschiedene LLMs integriert (inklusive LiteLLM-Nutzung) | microsoft.github.io/graphrag/config/models/ |
| Detaillierte Erläuterung der Query-Engine | Prinzipien und Parameter-Tuning der vier Abfragemodi | microsoft.github.io/graphrag/query/overview/ |
| Leitfaden zur Prompt-Optimierung | Vollständige Beschreibung der automatischen und manuellen Prompt-Optimierung | microsoft.github.io/graphrag/prompt_tuning/overview/ |
| Visualisierungsleitfaden | Offizielle Tools verwenden, um den Wissensgraphen zu visualisieren | microsoft.github.io/graphrag/visualization_guide/ |
| GraphRAG-Paper | Originalarbeit von Microsoft Research, um die zugrunde liegenden Prinzipien zu verstehen | arxiv.org/pdf/2404.16130 |