Среди всего прикладного программного обеспечения базы данных, возможно, являются самыми сложными.
Руководство MySQL содержит более 3,000 страниц, руководство PostgreSQL — более 2,000 страниц, а руководство Oracle даже толще, чем оба вместе взятые.
Однако написать собственную простейшую базу данных не так уж сложно. На Reddit естьпост, в котором всего за несколько сотен слов ясно объясняется этот принцип. Ниже — материал, который я систематизировал на основе этого поста.
I. Данные, хранящиеся в текстовой форме
Первый шаг — записать данные, которые нужно сохранить, в текстовый файл. Этот текстовый файл и есть ваша база данных.
Для удобства чтения данные нужно разбить на записи, и длина каждой записи должна быть фиксированной. Например, если предположить, что каждая запись занимает 800 байт, начальная позиция 5-й записи находится на 3200 байтах.
В большинстве случаев мы не знаем, в какой позиции находится запись; мы знаем только значение её первичного ключа. В этом случае, чтобы прочитать данные, можно сравнивать записи одну за другой. Но это слишком неэффективно. В практических приложениях базы данных часто используют формат B-дерева для хранения данных.
II. Что такое B-дерево?
Чтобы понять B-деревья, нужно начать с двоичного дерева поиска.
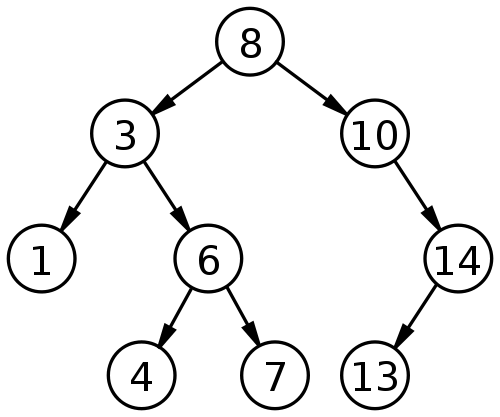
Двоичное дерево поиска — это структура данных с очень высокой эффективностью поиска. Оно обладает тремя характеристиками.
(1) Каждый узел имеет не более двух поддеревьев.
(2) Левое поддерево содержит значения меньше родительского узла, а правое поддерево содержит значения больше родительского узла.
(3) Чтобы найти целевое значение среди n узлов, обычно требуется всего log(n) сравнений.
Структура двоичного дерева поиска не подходит для баз данных, потому что её эффективность поиска связана с количеством уровней. Чем глубже данные, тем больше сравнений требуется. В крайних случаях для n элементов данных может потребоваться n сравнений, чтобы найти целевое значение. Для базы данных каждый вход на уровень требует однократного чтения данных с жёсткого диска. Это крайне критично, поскольку время чтения с жёсткого диска намного больше времени обработки данных. Чем меньше база данных читает с жёсткого диска, тем лучше.
B-дерево — это улучшение двоичного дерева поиска. Идея его устройства — максимально концентрировать связанные данные, чтобы считывать сразу несколько элементов данных и сократить количество операций с жёстким диском.
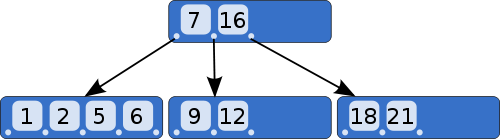
У B-дерева также есть три характеристики.
(1) Узел может хранить несколько значений. Например, на рисунке выше узел с наибольшим числом значений хранит 4 значения.
(2) Новые уровни не добавляются, если данные ещё не заполнены. Иными словами, B-дерево стремится к как можно меньшему числу «уровней».
(3) Значения в дочерних узлах имеют строгое соответствие по величине со значениями в родительском узле. Обычно, если в родительском узле a значений, то количество его дочерних узлов равно a+1. Например, на рисунке выше в родительском узле два значения (7 и 16), которым соответствуют три дочерних узла: первый дочерний узел содержит значения меньше 7, последний дочерний узел содержит значения больше 16, а средний дочерний узел содержит значения между 7 и 16.
Эта структура данных очень помогает сократить количество чтений с жёсткого диска. Предположим, узел может хранить 100 значений; 3-уровневое B-дерево может хранить 1 миллион элементов данных. Если заменить его двоичным деревом поиска, потребуется 20 уровней! Если предположить, что операционная система считывает за раз один узел, а корневой узел хранится в памяти, то B-дереву для поиска целевого значения среди 1 миллиона элементов данных потребуется всего два чтения с жёсткого диска.
III. Индексы
Хранение базы данных в формате B-дерева решает только проблему поиска данных по «первичному ключу». Если нужно искать по другим полям, необходимо создать индекс.
Индекс — это файл B-дерева, в котором некоторое поле используется как ключ. Предположим, есть «таблица сотрудников», содержащая два поля: номер сотрудника (первичный ключ) и имя. Для имён можно создать индексный файл. Файл хранит имена в формате B-дерева, причём за каждым именем следует его позиция в базе данных (т. е. номер записи). При поиске имени сначала нужно найти соответствующий номер записи в индексе, а затем прочитать его из таблицы.
Этот метод индексного поиска называется «Indexed Sequential Access Method», сокращённо ISAM. У него уже есть несколько реализаций (например, библиотека C-ISAM и библиотека D-ISAM). Если использовать эти библиотеки, можно написать собственную простейшую базу данных.
IV. Расширенные возможности
После реализации самого базового доступа к данным (включая индексы) можно также реализовать некоторые расширенные возможности.
(1) Язык SQLЭто универсальный язык работы с базами данных, поэтому нужен парсер SQL, чтобы разбирать команды SQL в соответствующие операции ISAM.
(2) Соединение таблиц базы данныхОно означает, что две таблицы в базе данных устанавливают связь через «внешний ключ». Эту операцию нужно оптимизировать.
(3) Транзакция базы данныхОна означает выполнение серии операций с базой данных пакетно. Если какой-либо шаг завершается неудачей, вся операция завершается неудачей. Поэтому нужен «журнал операций», чтобы можно было откатить операции при сбое.
(4) Механизм резервного копирования: Сохранить копию базы данных.
(5) Удалённая работа: Позволяет пользователям работать с базой данных с разных машин по протоколу TCP/IP.
Первоисточник: http://www.ruanyifeng.com/blog/2014/07/database_implementation.html