Entre todas las aplicaciones de software, la base de datos puede ser la más compleja.
El manual de MySQL tiene más de 3000 páginas, el de PostgreSQL más de 2000 páginas, y el manual de Oracle es incluso más grueso que ambos juntos.
Sin embargo, escribir uno mismo una base de datos muy simple no es difícil. En Reddit hay unpost, que con solo unos cientos de palabras explica claramente el principio. A continuación está el contenido que he organizado basándome en ese post.
1. Los datos se guardan en formato de texto
El primer paso es escribir los datos que se desean guardar en un archivo de texto. Este archivo de texto es tu base de datos.
Para facilitar la lectura, los datos deben dividirse en registros, y cada registro debe tener una longitud fija. Por ejemplo, si se supone que cada registro tiene 800 bytes de longitud, entonces la posición de inicio del quinto registro está en el byte 3200.
La mayoría de las veces, no sabemos en qué posición se encuentra un registro, solo conocemos el valor de la clave primaria (primary key). En este caso, para leer los datos, se pueden comparar los registros uno por uno. Pero esto es demasiado ineficiente; en la práctica, las bases de datos suelen almacenar los datos en formato de árbol B (B-tree).
2. ¿Qué es un árbol B?
Para entender el árbol B, hay que empezar por el árbol binario de búsqueda (Binary search tree).
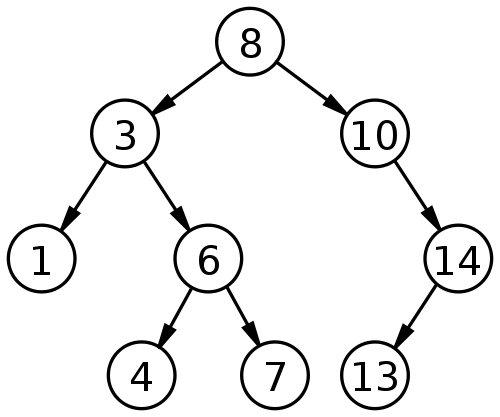
El árbol binario de búsqueda es una estructura de datos con una eficiencia de búsqueda muy alta. Tiene tres características.
(1) Cada nodo tiene como máximo dos subárboles.
(2) El subárbol izquierdo contiene valores menores que el nodo padre, y el subárbol derecho contiene valores mayores que el nodo padre.
(3) Para encontrar el valor objetivo entre n nodos, por lo general solo se necesitan log(n) comparaciones.
La estructura del árbol binario de búsqueda no es adecuada para bases de datos, porque su eficiencia de búsqueda está relacionada con la profundidad. Cuanto más abajo estén los datos, más comparaciones se necesitan. En casos extremos, con n datos se necesitan n comparaciones para encontrar el valor objetivo. Para una base de datos, cada nivel que se desciende requiere una lectura del disco duro, lo cual es muy crítico, porque el tiempo de lectura del disco duro es mucho mayor que el tiempo de procesamiento de datos. Cuantas menos lecturas de disco haga la base de datos, mejor.
El árbol B es una mejora del árbol binario de búsqueda. Su idea de diseño es concentrar los datos relacionados lo más posible, para poder leer múltiples datos de una sola vez y reducir el número de operaciones de disco duro.
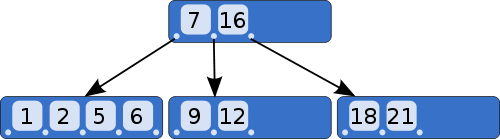
El árbol B también tiene tres características.
(1) Un nodo puede contener múltiples valores. Por ejemplo, en la figura anterior, el nodo más grande contiene 4 valores.
(2) A menos que los datos ya estén llenos, no se agregan nuevos niveles. Es decir, el árbol B busca tener la menor cantidad de "niveles" posible.
(3) Los valores en los nodos hijos tienen una correspondencia estricta de tamaño con los valores del nodo padre. En general, si el nodo padre tiene a valores, entonces tiene a+1 nodos hijos. Por ejemplo, en la figura anterior, el nodo padre tiene dos valores (7 y 16), que corresponden a tres nodos hijos: el primer nodo hijo contiene valores menores que 7, el último nodo hijo contiene valores mayores que 16, y el nodo hijo del medio contiene valores entre 7 y 16.
Esta estructura de datos es muy útil para reducir el número de lecturas del disco duro. Supongamos que un nodo puede contener 100 valores, entonces un árbol B de 3 niveles puede contener 1 millón de datos. Si se usara un árbol binario de búsqueda, ¡se necesitarían 20 niveles! Suponiendo que el sistema operativo lee un nodo a la vez y que el nodo raíz se mantiene en memoria, el árbol B solo necesita leer el disco duro dos veces para encontrar el valor objetivo entre 1 millón de datos.
3. Índices
Que la base de datos se almacene en formato de árbol B solo resuelve el problema de buscar datos por "clave primaria". Si se desea buscar por otros campos, es necesario crear un índice (index).
El llamado índice es un archivo de árbol B que utiliza un campo como clave. Supongamos que hay una "tabla de empleados" que contiene dos campos: número de empleado (clave primaria) y nombre. Se puede crear un archivo de índice para el nombre. Este archivo almacena los nombres en formato de árbol B, y después de cada nombre está su posición en la base de datos (es decir, el número de registro). Al buscar un nombre, primero se encuentra el número de registro correspondiente en el índice y luego se lee desde la tabla.
Este método de búsqueda por índice se llama "Método de acceso secuencial indexado" (Indexed Sequential Access Method), abreviado como ISAM. Ya existen múltiples implementaciones (como las bibliotecas C-ISAM y D-ISAM). Con solo usar estas bibliotecas de código, se puede escribir uno mismo una base de datos muy simple.
4. Funciones avanzadas
Después de implementar el almacenamiento y acceso básico de datos (incluidos los índices), también se pueden implementar algunas funciones avanzadas.
(1) Lenguaje SQLEs el lenguaje de operación universal de las bases de datos, por lo que se necesita un analizador SQL que traduzca los comandos SQL en las operaciones ISAM correspondientes.
(2) Combinación (join) de la base de datosSe refiere a que dos tablas de la base de datos establecen una relación de conexión a través de la "clave foránea". Necesitas optimizar esta operación.
(3) Transacción (transaction) de la base de datosSe refiere a realizar una serie de operaciones de base de datos en lote. Si un solo paso falla, toda la operación falla. Por lo tanto, se necesita un "registro de operaciones" para poder revertir las operaciones cuando ocurre un fallo.
(4) Mecanismo de copia de seguridad: guardar una copia de la base de datos.
(5) Operación remota: permite a los usuarios operar la base de datos desde diferentes máquinas mediante el protocolo TCP/IP.
Fuente original: http://www.ruanyifeng.com/blog/2014/07/database_implementation.html