すべてのアプリケーションソフトウェアの中で、データベースはおそらく最も複雑です。
MySQLのマニュアルは3000ページ以上、PostgreSQLのマニュアルは2000ページ以上、Oracleのマニュアルはそれらを合わせたものよりもさらに分厚いです。
しかし、自分で最も簡単なデータベースを書くことは、それほど難しくありません。Reddit上に、投稿があり、わずか数百語で原理を明確に説明しています。以下は、この投稿に基づいて私が整理した内容です。
一、データはテキスト形式で保存する
最初のステップは、保存したいデータをテキストファイルに書き込むことです。このテキストファイルがあなたのデータベースです。
読み取りを容易にするため、データはレコードに分割する必要があり、各レコードの長さは等長と定めます。例えば、各レコードの長さが800バイトだとすると、5番目のレコードの開始位置は3200バイトになります。
ほとんどの場合、特定のレコードがどの位置にあるかは分からず、主キー(primary key)の値だけが分かります。このとき、データを読み取るために、レコードを一つずつ比較することができます。しかし、この方法は効率が低すぎるため、実際の応用では、データベースはしばしばB-tree形式でデータを保存します。
二、B-treeとは?
B-treeを理解するには、二分探索木(Binary search tree)から説明する必要があります。
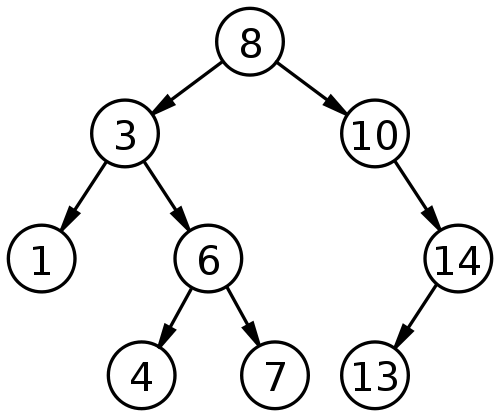
二分探索木は検索効率が非常に高いデータ構造であり、次の3つの特徴があります。
(1)各ノードが持つ部分木は最大で2つだけです。
(2)左の部分木の値はすべて親ノードより小さく、右の部分木の値はすべて親ノードより大きいです。
(3)n個のノードから目的の値を見つけるには、通常log(n)回の比較だけで済みます。
二分探索木の構造はデータベースには適していません。その検索効率は階層の数に関係するからです。下の階層にあるデータほど、より多くの比較が必要になります。極端な場合、n個のデータから目的の値を見つけるのにn回の比較が必要になります。データベースにとっては、1階層進むごとにハードディスクからデータを1回読み取る必要があり、これは非常に致命的です。ハードディスクの読み取り時間はデータ処理時間よりはるかに長いため、データベースがハードディスクを読み取る回数は少なければ少ないほど良いのです。
B-treeは二分探索木を改良したものです。その設計思想は、関連するデータをできるだけまとめて、一度に複数のデータを読み取り、ハードディスクの操作回数を減らすことです。
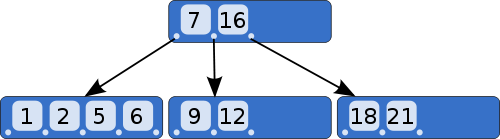
B-treeの特徴も3つあります。
(1)1つのノードは複数の値を格納できます。例えば上の図では、最も多いノードは4つの値を格納しています。
(2)データが満杯にならない限り、新しい階層は追加されません。つまり、B-treeは「階層」が少なければ少ないほど良いと追求します。
(3)子ノードの値と親ノードの値には、厳密な大小の対応関係があります。一般的に、親ノードがa個の値を持つならば、a+1個の子ノードがあります。例えば上の図では、親ノードが2つの値(7と16)を持ち、3つの子ノードに対応します。最初の子ノードはすべて7より小さい値で、最後の子ノードはすべて16より大きい値、真ん中の子ノードは7と16の間の値です。
このデータ構造は、ハードディスクの読み取り回数を減らすのに非常に役立ちます。1つのノードが100個の値を格納できると仮定すると、3階層のB-treeは100万個のデータを格納できます。もし二分探索木に置き換えると、20階層も必要になります!オペレーティングシステムが一度に1つのノードを読み取り、ルートノードがメモリ内に保持されていると仮定すると、B-treeは100万個のデータから目的の値を探すのに、ハードディスクを2回読み取るだけで済みます。
三、インデックス
データベースがB-tree形式で保存することは、「主キー」によるデータ検索の問題を解決しただけです。他のフィールドを検索したい場合は、インデックス(index)を構築する必要があります。
いわゆるインデックスとは、あるフィールドをキーとするB-treeファイルです。「従業員テーブル」に、従業員番号(主キー)と氏名という2つのフィールドが含まれていると仮定します。氏名に対してインデックスファイルを構築できます。このファイルはB-tree形式で氏名を保存し、各氏名の後ろにはデータベース内での位置(つまり何番目のレコードか)が格納されています。氏名を検索するときは、まずインデックスから対応するレコード番号を見つけ、それからテーブルから読み取ります。
このインデックス検索方法は、「索引順次アクセス法」(Indexed Sequential Access Method)と呼ばれ、略してISAMです。これにはすでに複数の実装(C-ISAMライブラリやD-ISAMライブラリなど)があり、これらのコードライブラリを使用するだけで、自分で最も簡単なデータベースを書くことができます。
四、高度な機能
最も基本的なデータアクセス(インデックスを含む)を実装した後、さらにいくつかの高度な機能を実装できます。
(1)SQL言語はデータベースの汎用操作言語であるため、SQLコマンドを対応するISAM操作に変換するSQLパーサーが必要です。
(2)データベース結合(join)とは、データベースの2つのテーブルが「外部キー」を通じて結合関係を確立することです。この操作を最適化する必要があります。
(3)データベーストランザクション(transaction)とは、一連のデータベース操作を一括で行うことであり、1つのステップが失敗すると、全体の操作が失敗します。そのため、失敗時に操作をロールバックできるよう、「操作ログ」が必要です。
(4)バックアップ機構:データベースのコピーを保存します。
(5)リモート操作:ユーザーが異なるマシン上でTCP/IPプロトコルを通じてデータベースを操作できるようにします。
原文の出典:http://www.ruanyifeng.com/blog/2014/07/database_implementation.html