Parmi tous les logiciels applicatifs, les bases de données sont peut-être les plus complexes.
Le manuel de MySQL compte plus de 3,000 pages, celui de PostgreSQL plus de 2,000 pages, et le manuel d'Oracle est encore plus épais que les deux réunis.
Cependant, écrire sa propre base de données la plus simple n'est pas difficile. Il y a unepublicationsur Reddit qui n'utilise que quelques centaines de mots pour expliquer clairement le principe. Voici le contenu que j'ai organisé à partir de cette publication.
I. Données stockées sous forme de texte
La première étape consiste à écrire les données à sauvegarder dans un fichier texte. Ce fichier texte est votre base de données.
Pour une lecture pratique, les données doivent être divisées en enregistrements, et la longueur de chaque enregistrement doit être fixe. Par exemple, en supposant que chaque enregistrement fasse 800 bytes, la position de départ du 5e enregistrement est à 3200 bytes.
La plupart du temps, nous ne savons pas dans quelle position se trouve un enregistrement ; nous connaissons seulement la valeur de sa clé primaire. Dans ce cas, pour lire les données, nous pouvons comparer les enregistrements un par un. Mais c'est trop inefficace. Dans les applications pratiques, les bases de données utilisent souvent le format d'arbre B pour stocker les données.
II. Qu'est-ce qu'un arbre B ?
Pour comprendre les arbres B, nous devons commencer par l'arbre binaire de recherche.
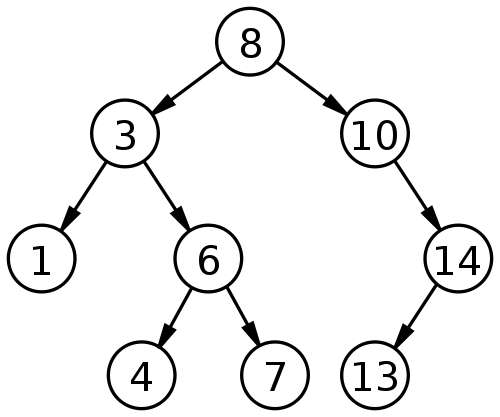
Un arbre binaire de recherche est une structure de données dont l'efficacité de recherche est très élevée. Il possède trois caractéristiques.
(1) Chaque nœud possède au plus deux sous-arbres.
(2) Le sous-arbre gauche contient des valeurs inférieures au nœud parent, et le sous-arbre droit contient des valeurs supérieures au nœud parent.
(3) Pour trouver la valeur cible parmi n nœuds, généralement seules log(n) comparaisons sont nécessaires.
La structure d'arbre binaire de recherche ne convient pas aux bases de données car son efficacité de recherche est liée au nombre de niveaux. Plus les données sont profondes, plus il faut de comparaisons. Dans les cas extrêmes, n éléments de données nécessitent n comparaisons pour trouver la valeur cible. Pour une base de données, chaque niveau franchi nécessite une lecture des données depuis le disque dur. C'est très fatal car le temps de lecture du disque dur est bien supérieur au temps de traitement des données. Moins une base de données effectue de lectures depuis le disque dur, mieux c'est.
L'arbre B est une amélioration de l'arbre binaire de recherche. Son idée de conception est de concentrer autant que possible les données liées, afin de lire plusieurs données à la fois et de réduire le nombre d'opérations sur le disque dur.
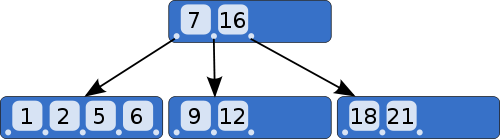
L'arbre B possède également trois caractéristiques.
(1) Un nœud peut contenir plusieurs valeurs. Par exemple, dans la figure ci-dessus, le nœud qui contient le plus de valeurs en contient 4.
(2) À moins que les données ne soient déjà pleines, aucun nouveau niveau ne sera ajouté. En d'autres termes, un arbre B recherche à avoir aussi peu de « niveaux » que possible.
(3) Les valeurs des nœuds enfants ont une correspondance de taille stricte avec les valeurs du nœud parent. Généralement, si le nœud parent possède a valeurs, alors il possède a+1 nœuds enfants. Par exemple, dans la figure ci-dessus, le nœud parent possède deux valeurs (7 et 16), correspondant à trois nœuds enfants : le premier nœud enfant contient des valeurs inférieures à 7, le dernier nœud enfant contient des valeurs supérieures à 16, et le nœud enfant intermédiaire contient des valeurs comprises entre 7 et 16.
Cette structure de données est très utile pour réduire le nombre de lectures sur le disque dur. En supposant qu'un nœud puisse contenir 100 valeurs, un arbre B à 3 niveaux peut contenir 1 million d'éléments de données. Si on le remplaçait par un arbre binaire de recherche, il faudrait 20 niveaux ! En supposant que le système d'exploitation lise un nœud à la fois et que le nœud racine soit conservé en mémoire, alors un arbre B recherchant une valeur cible parmi 1 million d'éléments de données n'a besoin de lire le disque dur que deux fois.
III. Index
Stocker une base de données au format arbre B ne résout que le problème de la recherche de données par « clé primaire ». Si vous souhaitez rechercher d'autres champs, vous devez créer un index.
Un index est un fichier B-tree utilisant un certain champ comme clé. Supposons qu'il existe une « table employé » contenant deux champs : numéro d'employé (clé primaire) et nom. Un fichier d'index peut être créé pour les noms. Le fichier stocke les noms au format B-tree, chaque nom étant suivi de sa position dans la base de données (c'est-à-dire le numéro d'enregistrement). Lors de la recherche d'un nom, on trouve d'abord le numéro d'enregistrement correspondant dans l'index, puis on le lit depuis la table.
Cette méthode de recherche par index est appelée « Indexed Sequential Access Method », en abrégé ISAM. Elle possède déjà plusieurs implémentations (telles que la bibliothèque C-ISAM et la bibliothèque D-ISAM). Tant que vous utilisez ces bibliothèques de code, vous pouvez écrire votre propre base de données la plus simple.
IV. Fonctionnalités avancées
Après avoir implémenté l'accès aux données le plus basique (y compris les index), certaines fonctionnalités avancées peuvent également être implémentées.
(1) Langage SQLC'est le langage d'exploitation universel des bases de données, donc un analyseur SQL est nécessaire pour analyser les commandes SQL en opérations ISAM correspondantes.
(2) Jointure de base de donnéesCela désigne deux tables d'une base de données établissant une connexion via une « clé étrangère ». Vous devez optimiser cette opération.
(3) Transaction de base de donnéesCela désigne l'exécution d'une série d'opérations de base de données en lot. Si une étape échoue, l'opération entière échoue. Par conséquent, un « journal d'opérations » est nécessaire afin que les opérations puissent être annulées en cas d'échec.
(4) Mécanisme de sauvegarde: Enregistrer une copie de la base de données.
(5) Opération distante: Permet aux utilisateurs d'exploiter la base de données depuis différentes machines via le protocole TCP/IP.
Source originale : http://www.ruanyifeng.com/blog/2014/07/database_implementation.html