Unter allen Anwendungsprogrammen sind Datenbanken möglicherweise am komplexesten.
Das Handbuch von MySQL hat über 3.000 Seiten, das Handbuch von PostgreSQL hat über 2.000 Seiten, und das Handbuch von Oracle ist sogar dicker als die beiden zusammen.
Es ist jedoch nicht schwierig, eine eigene einfachste Datenbank zu schreiben. Es gibt einenBeitragauf Reddit, der mit nur ein paar hundert Wörtern das Prinzip klar erklärt. Unten steht der Inhalt, den ich basierend auf diesem Beitrag zusammengestellt habe.
I. In Textform gespeicherte Daten
Der erste Schritt besteht darin, die zu speichernden Daten in eine Textdatei zu schreiben. Diese Textdatei ist deine Datenbank.
Um bequem lesen zu können, müssen die Daten in Datensätze aufgeteilt werden, und die Länge jedes Datensatzes muss fest sein. Angenommen, jeder Datensatz ist 800 Bytes lang, dann liegt die Startposition des 5. Datensatzes bei 3200 Bytes.
Meistens wissen wir nicht, an welcher Position sich ein Datensatz befindet; wir kennen nur den Wert seines Primärschlüssels. In diesem Fall können wir zum Lesen der Daten die Datensätze einzeln vergleichen. Aber das ist zu ineffizient. In praktischen Anwendungen verwenden Datenbanken oft das B-Baum-Format, um Daten zu speichern.
II. Was ist ein B-Baum?
Um B-Bäume zu verstehen, müssen wir mit dem binären Suchbaum beginnen.
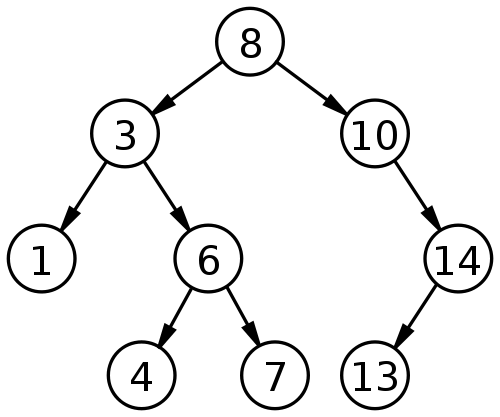
Ein binärer Suchbaum ist eine Datenstruktur mit sehr hoher Sucheffizienz. Er hat drei Eigenschaften.
(1) Jeder Knoten hat höchstens zwei Unterbäume.
(2) Der linke Unterbaum enthält Werte, die kleiner als der Elternknoten sind, und der rechte Unterbaum enthält Werte, die größer als der Elternknoten sind.
(3) Um den Zielwert unter n Knoten zu finden, sind im Allgemeinen nur log(n) Vergleiche erforderlich.
Die Struktur des binären Suchbaums ist nicht für Datenbanken geeignet, weil ihre Sucheffizienz von der Anzahl der Ebenen abhängt. Je tiefer die Daten liegen, desto mehr Vergleiche sind erforderlich. In Extremfällen benötigen n Datenelemente n Vergleiche, um den Zielwert zu finden. Für eine Datenbank erfordert jede durchlaufene Ebene ein einmaliges Lesen von Daten von der Festplatte. Das ist sehr fatal, weil die Festplattenlesezeit weit größer ist als die Datenverarbeitungszeit. Je seltener eine Datenbank von der Festplatte liest, desto besser.
Der B-Baum ist eine Verbesserung des binären Suchbaums. Seine Entwurfsidee besteht darin, zusammengehörige Daten so weit wie möglich zu bündeln, um mehrere Daten auf einmal zu lesen und die Anzahl der Festplattenoperationen zu reduzieren.
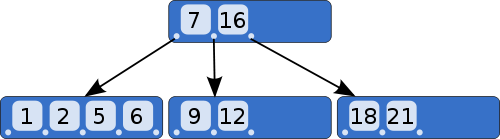
Der B-Baum hat außerdem drei Merkmale.
(1) Ein Knoten kann mehrere Werte enthalten. Zum Beispiel enthält in der obigen Abbildung der Knoten mit den meisten Werten 4 Werte.
(2) Solange die Daten nicht bereits voll sind, werden keine neuen Ebenen hinzugefügt. Mit anderen Worten: Ein B-Baum strebt so wenige "Ebenen" wie möglich an.
(3) Die Werte in Kindknoten stehen in einer strengen Größenentsprechung zu den Werten im Elternknoten. Im Allgemeinen gilt: Wenn der Elternknoten a Werte hat, dann hat er a+1 Kindknoten. Zum Beispiel hat in der obigen Abbildung der Elternknoten zwei Werte (7 und 16), denen drei Kindknoten entsprechen: Der erste Kindknoten enthält Werte kleiner als 7, der letzte Kindknoten enthält Werte größer als 16, und der mittlere Kindknoten enthält Werte zwischen 7 und 16.
Diese Datenstruktur ist sehr hilfreich, um die Anzahl der Festplattenlesevorgänge zu reduzieren. Angenommen, ein Knoten kann 100 Werte enthalten, dann kann ein 3-stufiger B-Baum 1 Million Datenelemente enthalten. Wenn man ihn durch einen binären Suchbaum ersetzen würde, wären 20 Ebenen erforderlich! Angenommen, das Betriebssystem liest jeweils einen Knoten und der Wurzelknoten wird im Speicher gehalten, dann muss ein B-Baum, der einen Zielwert unter 1 Million Datenelementen sucht, nur zweimal von der Festplatte lesen.
III. Indizes
Eine Datenbank im B-Baum-Format zu speichern, löst nur das Problem, Daten über den "Primärschlüssel" zu finden. Wenn Sie andere Felder durchsuchen möchten, müssen Sie einen Index erstellen.
Ein Index ist eine B-Tree-Datei, die ein bestimmtes Feld als Schlüssel verwendet. Angenommen, es gibt eine „Mitarbeitertabelle“ mit zwei Feldern: Mitarbeiternummer (Primärschlüssel) und Name. Für Namen kann eine Indexdatei erstellt werden. Die Datei speichert Namen im B-Tree-Format, wobei auf jeden Namen seine Position in der Datenbank folgt (d. h., welche Datensatznummer). Bei der Suche nach einem Namen wird zuerst die entsprechende Datensatznummer aus dem Index gefunden und dann aus der Tabelle gelesen.
Diese Indexsuchmethode heißt „Indexed Sequential Access Method“, abgekürzt ISAM. Es gibt bereits mehrere Implementierungen (wie die C-ISAM-Bibliothek und die D-ISAM-Bibliothek). Solange Sie diese Codebibliotheken verwenden, können Sie Ihre eigene einfachste Datenbank schreiben.
IV. Erweiterte Funktionen
Nach der Implementierung des grundlegendsten Datenzugriffs (einschließlich Indizes) können auch einige erweiterte Funktionen implementiert werden.
(1) SQL-SpracheSie ist die universelle Betriebssprache für Datenbanken, daher wird ein SQL-Parser benötigt, um SQL-Befehle in entsprechende ISAM-Operationen zu zerlegen.
(2) Datenbank-JoinEr bezieht sich darauf, dass zwei Tabellen in einer Datenbank über einen „Fremdschlüssel“ eine Verbindung herstellen. Diese Operation muss optimiert werden.
(3) DatenbanktransaktionSie bezieht sich auf die Ausführung einer Reihe von Datenbankoperationen im Batch. Wenn ein Schritt fehlschlägt, schlägt die gesamte Operation fehl. Daher ist ein „Operationsprotokoll“ erforderlich, damit Operationen bei Fehlschlag zurückgerollt werden können.
(4) Backup-Mechanismus: Speichern Sie eine Kopie der Datenbank.
(5) Remote-Betrieb: Ermöglicht Benutzern, die Datenbank über das TCP/IP-Protokoll von verschiedenen Rechnern aus zu bedienen.
Originalquelle: http://www.ruanyifeng.com/blog/2014/07/database_implementation.html