Основы PyTorch
PyTorch — это фреймворк глубокого обучения с открытым исходным кодом, широко популярный благодаря своей гибкости и динамическому графу вычислений.
PyTorch в основном включает следующие базовые концепции: Tensor, Autograd, модуль нейронной сети (nn.Module), оптимизаторы (optim) и т. д.
- Тензор: основная структура данных PyTorch, поддерживает многомерные массивы и может выполнять ускоренные вычисления на CPU или GPU.
- Autograd: PyTorch обеспечивает функциональность автоматического дифференцирования, что упрощает вычисление градиентов модели для обратного распространения и оптимизации.
- Нейронная сеть (nn.Module): PyTorch предоставляет простой и мощный API для построения моделей нейронных сетей, что удобно для выполнения прямого прохода и определения модели.
- Оптимизаторы: Используйте оптимизаторы (такие как Adam, SGD и т. д.) для обновления параметров модели, чтобы минимизировать потери.
- Устройство: Можно перемещать модели и тензоры на GPU для ускорения вычислений.
Обзор архитектуры PyTorch
PyTorch использует модульный дизайн, состоящий из нескольких основных компонентов, которые работают вместе. Понимание ролей и взаимосвязей этих компонентов — ключ к освоению PyTorch.
Схема архитектуры PyTorch
┌─────────────────────────────────────────────────────────────┐
│                    PyTorch 生态系统                          │
├─────────────────────────────────────────────────────────────┤
│  torchvision  │  torchtext  │  torchaudio  │  其他专业库     │
├─────────────────────────────────────────────────────────────┤
│                     PyTorch 核心                            │
├───────────────┬─────────────────┬───────────────────────────┤
│   torch.nn    │   torch.optim   │      torch.utils          │
│   (神经网络)   │   (优化器)      │      (工具函数)           │
├───────────────┼─────────────────┼───────────────────────────┤
│               │                 │   torch.utils.data        │
│  torch 核心   │  autograd       │   (数据加载)              │
│  (张量计算)   │  (自动微分)     │                           │
└───────────────┴─────────────────┴───────────────────────────┘
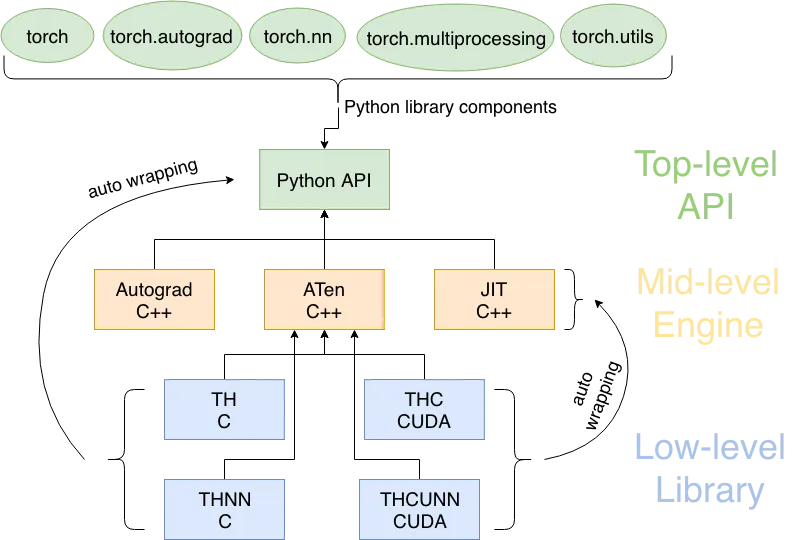
PyTorch используетмногоуровневую архитектуру, сверху вниз следующим образом:
1. Python API (верхний уровень)
torch: Основные тензорные вычисления (похоже на NumPy, поддерживает GPU).torch.nn: Слои нейронной сети, функции потерь и т. д.torch.autograd: Автоматическое дифференцирование (обратное распространение).- Интерфейсы, напрямую вызываемые разработчиками, простые и удобные в использовании.
2. Ядро на C++ (средний уровень)
- ATen: Основная библиотека для операций с тензорами (400+ операций).
- JIT: Компиляция just-in-time для оптимизации моделей.
- Движок Autograd: Низкоуровневая реализация автоматического дифференцирования.
- Высокопроизводительные вычисления, связывающие Python и нижележащее аппаратное обеспечение.
3. Базовые библиотеки (нижний уровень)
- TH/THNN: Базовые операции с тензорами и нейронными сетями, реализованные на C.
- THC/THCUNN: Соответствующая версия для CUDA (GPU).
- Напрямую работает с аппаратным обеспечением (CPU/GPU), оптимизируя скорость до предела.
Поток выполнения:
Код на Python → вычисления в ядре на C++ → низкоуровневое ускорение с помощью библиотеки CUDA/C → возврат результата.
Он сохраняет простоту использования, обеспечивая при этом высокую производительность.
Тензор
Тензор — это основная структура данных в PyTorch, используемая для хранения и обработки многомерных массивов.
Тензор можно рассматривать как многомерный массив, поддерживающий ускоренные вычислительные операции.
В PyTorch тензоры концептуально похожи на массивы в NumPy, но тензоры PyTorch могут выполняться на разных устройствах, таких как CPU и GPU, что делает их хорошо подходящими для крупномасштабных параллельных вычислений, особенно в глубоком обучении.
-
Размерность: Размерность тензора относится к многомерной структуре массива данных. Например, скаляр (0-мерный тензор) — это одно число, вектор (1-мерный тензор) — это одномерный массив, матрица (2-мерный тензор) — это двумерный массив, и так далее.
-
Форма: Форма тензора относится к размеру каждого измерения. Например, тензор с формой
(3, 4)означает, что он имеет 3 строки и 4 столбца. -
Dtype: Тип данных в тензоре определяет размер памяти, необходимый для хранения каждого элемента, и то, как он интерпретируется. PyTorch поддерживает несколько типов данных, включая целочисленные типы (например,
torch.int8、torch.int32), типы с плавающей точкой (например,torch.float32、torch.float64) и логический тип (torch.bool)。
Создание тензора:
Пример
# Создать тензор 2x3, заполненный нулями
a = torch.zeros(2, 3)
print(a)
# Создать тензор 2x3, состоящий из единиц
b = torch.ones(2, 3)
print(b)
# Создать тензор 2x3 со случайными числами
c = torch.randn(2, 3)
print(c)
# Создать тензор из массива NumPy
import numpy as np
numpy_array = np.array([[1, 2], [3, 4]])
tensor_from_numpy = torch.from_numpy(numpy_array)
print(tensor_from_numpy)
# Создать тензор на указанном устройстве (CPU/GPU)
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
d = torch.randn(2, 3, device=device)
print(d)
Вывод аналогичен следующему:
tensor([[0., 0., 0.],
        [0., 0., 0.]])
tensor([[1., 1., 1.],
        [1., 1., 1.]])
tensor([[ 1.0189, -0.5718, -1.2814],
        [-0.5865,  1.0855,  1.1727]])
tensor([[1, 2],
        [3, 4]])
tensor([[-0.3360,  0.2203,  1.3463],
        [-0.5982, -0.2704,  0.5429]])
Основные операции с тензорами:
Пример
e = torch.randn(2, 3)
f = torch.randn(2, 3)
print(e + f)
# поэлементное умножение
print(e * f)
# транспонирование тензора
g = torch.randn(3, 2)
print(g.t()) # или g.transpose(0, 1)
# форма тензора
print(g.shape) # Возвращаемая форма
Тензор и устройство
Тензоры PyTorch могут находиться на разных устройствах, включая CPU и GPU. Вы можете перемещать тензоры на GPU, чтобы ускорить вычисления:
if torch.cuda.is_available():
    tensor_gpu = tensor_from_list.to('cuda')  # 将张量移动到GPU
Градиенты и автоматическое дифференцирование
Тензоры PyTorch поддерживают автоматическое дифференцирование — ключевую особенность глубокого обучения. Когда вы создаёте тензор, требующий градиентов, PyTorch может автоматически вычислить его градиент:
Пример
tensor_requires_grad = torch.tensor([1.0], requires_grad=True)
# Выполните некоторые операции
tensor_result = tensor_requires_grad * 2
# Вычисление градиента
tensor_result.backward()
print(tensor_requires_grad.grad) # Вывод градиента
Память и производительность
Тензоры PyTorch также предоставляют некоторые функции управления памятью, такие как методы .clone(), .detach() и .to(), которые могут помочь оптимизировать использование памяти и повысить производительность.
Autograd (автоматическое дифференцирование)
Автоматическое дифференцирование, сокращённо Autograd, — это ключевая функция фреймворков глубокого обучения, которая позволяет компьютерам автоматически вычислять производные математических функций.
В глубоком обучении автоматическое дифференцирование в основном используется для двух целей:Первая — вычисление градиентов при обучении нейронных сетей,Вторая — реализация алгоритма обратного распространения ошибки。
Автоматическое дифференцирование основано на правиле цепочки — математическом правиле для вычисления производных сложных функций. Правило цепочки утверждает, что производная составной функции равна произведению производных её составных частей. В глубоком обучении модели обычно представляют собой сложные функции, состоящие из множества слоёв, и автоматическое дифференцирование может эффективно вычислять градиенты этих слоёв.
Динамический граф против статического графа:
-
Динамический граф: В динамическом графе граф вычислений строится динамически во время выполнения. Каждый раз, когда выполняется операция, граф вычислений обновляется, что упрощает отладку и изменение моделей. PyTorch использует динамические графы.
-
Статический граф: В статическом графе граф вычислений строится до начала выполнения и не изменяется. TensorFlow изначально использовал статические графы, но позже также поддержал динамические графы.
PyTorch предоставляет функциональность автоматического дифференцирования, используя модуль autograd для автоматического вычисления градиентов.
Объект torch.Tensor имеет атрибут requires_grad, который указывает, нужно ли вычислять градиент этого тензора.
Когда вы создаёте тензор с requires_grad=True, PyTorch автоматически отслеживает все операции над ним, чтобы позже вычислить градиенты.
Создание тензора, требующего вычисления градиентов:
Пример
x = torch.randn(2, 2, requires_grad=True)
print(x)
# Выполнить некоторые операции
y = x + 2
z = y * y * 3
out = z.mean()
print(out)
Вывод аналогичен следующему:
tensor([[0., 0., 0.],
        [0., 0., 0.]])
tensor([[1., 1., 1.],
        [1., 1., 1.]])
tensor([[ 1.0189, -0.5718, -1.2814],
        [-0.5865,  1.0855,  1.1727]])
tensor([[1, 2],
        [3, 4]])
tensor([[-0.3360,  0.2203,  1.3463],
        [-0.5982, -0.2704,  0.5429]])
tianqixin@Mac-mini example-test % python3 test.py
tensor([[-0.1908,  0.2811],
        [ 0.8068,  0.8002]], requires_grad=True)
tensor(18.1469, grad_fn=<MeanBackward0>)
Обратное распространение
После того как граф вычислений определён, можно использовать метод.backward()для вычисления градиентов.
Пример
out.backward()
# Просмотр градиента x
print(x.grad)
При обучении нейронных сетей автоматическое дифференцирование в основном используется для реализации алгоритма обратного распространения.
Обратное распространение — это метод обучения нейронных сетей путём вычисления градиента функции потерь по параметрам сети. На каждой итерации прямое распространение сети вычисляет выход и потери, затем обратное распространение вычисляет градиент потерь по каждому параметру и использует эти градиенты для обновления параметров.
Остановка вычисления градиента
Если вы не хотите, чтобы вычислялись градиенты определённых тензоров (например, когда обратное распространение не требуется), можно использоватьtorch.no_grad()или установитьrequires_grad=False。
Пример
with torch.no_grad():
y = x * 2
Нейронная сеть (nn.Module)
Нейронная сеть — это вычислительная модель, имитирующая связи нейронов в человеческом мозге. Она состоит из нескольких слоёв узлов (нейронов) и используется для изучения сложных закономерностей и взаимосвязей в данных.
Нейронные сети оптимизируют результаты прогнозирования, регулируя веса связей между нейронами. Этот процесс включает прямое распространение, вычисление потерь, обратное распространение и обновление параметров.
Типы нейронных сетей включают нейронные сети прямого распространения, свёрточные нейронные сети (CNNs), рекуррентные нейронные сети (RNNs) и сети долгой краткосрочной памяти (LSTMs). Они широко используются в таких областях, как распознавание изображений, обработка речи и обработка естественного языка.
PyTorch предоставляет очень удобный интерфейс для построения моделей нейронных сетей, а именноtorch.nn.Module。
Мы можем наследоваться от класса nn.Module и определять собственные слои сети.
Создание простой нейронной сети:
Пример
import torch.optim as optim
# Определение простой полносвязной нейронной сети
class SimpleNN(nn.Module):
def __init__(self):
super(SimpleNN, self).__init__()
self.fc1 = nn.Linear(2, 2) # Из входного слоя в скрытый слой
self.fc2 = nn.Linear(2, 1) # Из скрытого слоя в выходной слой
def forward(self, x):
x = torch.relu(self.fc1(x)) # Функция активации ReLU
x = self.fc2(x)
return x
# Создать экземпляр сети
model = SimpleNN()
# Вывести структуру модели
print(model)
Результат вывода:
SimpleNN(
  (fc1): Linear(in_features=2, out_features=2, bias=True)
  (fc2): Linear(in_features=2, out_features=1, bias=True)
)
Процесс обучения:
-
Прямое распространение: На этапе прямого распространения входные данные проходят через слои сети, при этом каждый слой применяет веса и функции активации, пока не будет получен выход.
-
Расчет потерь: Вычислите значение функции потерь на основе выходных данных сети и истинных меток.
-
Обратное распространение: Обратное распространение использует методы автоматического дифференцирования для вычисления градиента функции потерь по каждому параметру.
-
Обновление параметров: Используйте оптимизатор для обновления весов и смещений сети на основе градиентов.
-
Итерация: Повторяйте описанный выше процесс, пока производительность модели на обучающих данных не достигнет удовлетворительного уровня.
Прямое распространение и вычисление потерь
Пример
x = torch.randn(1, 2)
# Прямое распространение
output = model(x)
print(output)
# Определите функцию потерь (например, среднеквадратичная ошибка MSE)
criterion = nn.MSELoss()
# Предположим, целевое значение равно 1
target = torch.randn(1, 1)
# Вычислите потери
loss = criterion(output, target)
print(loss)
Оптимизаторы
Оптимизаторы обновляют параметры нейронной сети во время обучения, чтобы уменьшить значение функции потерь.
PyTorch предоставляет множество оптимизаторов, таких как SGD, Adam и т. д.
Использование оптимизатора для обновления параметров:
Пример
optimizer = optim.Adam(model.parameters(), lr=0.001)
# Шаг обучения
optimizer.zero_grad() # Очистить градиенты
loss.backward() # Обратное распространение
optimizer.step() # Обновить параметры
Обучение модели
Обучение модели — это основной процесс в машинном обучении и глубоком обучении. Его цель — изучить параметры модели на большом объёме данных, чтобы модель могла делать точные прогнозы на новых, невиданных данных.
Обучение модели обычно включает следующие шаги:
-
Подготовка данных:
- Соберите и обработайте данные, включая очистку, стандартизацию и нормализацию.
- Разделите данные на обучающую, валидационную и тестовую выборки.
-
Определите модель:
- Выберите архитектуру модели, например деревья решений, нейронные сети и т. д.
- Инициализируйте параметры модели (веса и смещения).
-
Выберите функцию потерь:
- Выберите подходящую функцию потерь в соответствии с типом задачи (например, классификация, регрессия).
-
Выберите оптимизатор:
- Выберите алгоритм оптимизации, например SGD, Adam и т. д., для обновления параметров модели.
-
Прямое распространение:
- На каждой итерации пропустите входные данные через модель и вычислите предсказанный выход.
-
Вычислите потери:
- Используйте функцию потерь, чтобы оценить разницу между предсказанным выходом и истинными метками.
-
Обратное распространение:
- Используйте автоматическое дифференцирование для вычисления градиента функции потерь по параметрам модели.
-
Обновление параметров:
- Обновите параметры модели в соответствии с вычисленными градиентами и стратегией оптимизатора.
-
Итеративная оптимизация:
- Повторяйте шаги 5-8, пока производительность модели на валидационном наборе не перестанет улучшаться или не будет достигнуто заранее заданное число итераций.
-
Оценка и тестирование:
- Используйте тестовый набор для оценки итоговой производительности модели, чтобы убедиться, что модель не переобучается.
-
Настройка модели:
- Настройте гиперпараметры на основе производительности модели на тестовом наборе, например, изменив скорость обучения, добавив регуляризацию и т. д.
-
Развертывание модели:
- Разверните обученную модель в производственной среде для выполнения реальных задач прогнозирования.
Пример
import torch.nn as nn
import torch.optim as optim
# 1. Определите простую модель нейронной сети
class SimpleNN(nn.Module):
def __init__(self):
super(SimpleNN, self).__init__()
self.fc1 = nn.Linear(2, 2) # Из входного слоя в скрытый слой
self.fc2 = nn.Linear(2, 1) # Из скрытого слоя в выходной слой
def forward(self, x):
x = torch.relu(self.fc1(x)) # Функция активации ReLU
x = self.fc2(x)
return x
# 2. Создать экземпляр модели
model = SimpleNN()
# 3. Определить функцию потерь и оптимизатор
criterion = nn.MSELoss() # Функция потерь среднеквадратичной ошибки
optimizer = optim.Adam(model.parameters(), lr=0.001) # Оптимизатор Adam
# 4. Предположим, у нас есть обучающие данные X и Y
X = torch.randn(10, 2) # 10 образцов, 2 признака
Y = torch.randn(10, 1) # 10 целевых значений
# 5. Цикл обучения
for epoch in range(100): # Обучение в течение 100 эпох
optimizer.zero_grad() # Очистить предыдущие градиенты
output = model(X) # Прямое распространение
loss = criterion(output, Y) # Вычислить потери
loss.backward() # Обратное распространение
optimizer.step() # Обновить параметры
# Выводить потери каждые 10 эпох
if (epoch+1) % 10 == 0:
print(f'Epoch [{epoch+1}/100], Loss: {loss.item():.4f}')
Результат вывода следующий:
Epoch [10/100], Loss: 1.7180
Epoch [20/100], Loss: 1.6352
Epoch [30/100], Loss: 1.5590
Epoch [40/100], Loss: 1.4896
Epoch [50/100], Loss: 1.4268
Epoch [60/100], Loss: 1.3704
Epoch [70/100], Loss: 1.3198
Epoch [80/100], Loss: 1.2747
Epoch [90/100], Loss: 1.2346
Epoch [100/100], Loss: 1.1991
Каждые 10 эпох программа выводит текущее значение потерь, помогая нам отслеживать прогресс обучения модели. По мере обучения значение потерь должно постепенно уменьшаться, что указывает на то, что модель непрерывно обучается и оптимизирует свои параметры.
Обучение модели — это итеративный процесс, требующий постоянной настройки и оптимизации до достижения удовлетворительной производительности. Этот процесс включает множество экспериментов и настройки, цель которых — обеспечить модели хорошую способность к обобщению на новых, ранее не встречавшихся данных.
Устройство
PyTorch позволяет переносить модели и данные на GPU для ускорения.
Используйтеtorch.deviceчтобы указать вычислительное устройство.
Переместите модель и данные на GPU:
Пример
# Переместите модель на устройство
model.to(device)
# Переместите данные на устройство
X = X.to(device)
Y = Y.to(device)
Во время обучения все тензоры и модели должны быть перемещены на одно и то же устройство (либо все на CPU, либо все на GPU).
Дополнительные расширения