Bases de PyTorch
PyTorch est un framework d'apprentissage profond open source, largement populaire pour sa flexibilité et son graphe de calcul dynamique.
PyTorch possède principalement les concepts de base suivants : Tensor, Autograd, module de réseau de neurones (nn.Module), optimiseurs (optim), etc.
- Tensor: structure de données centrale de PyTorch, prend en charge les tableaux multidimensionnels et peut effectuer des calculs accélérés sur CPU ou GPU.
- Autograd: PyTorch fournit une fonctionnalité de différenciation automatique, ce qui facilite le calcul des gradients du modèle pour la rétropropagation et l'optimisation.
- Réseau de neurones (nn.Module): PyTorch fournit une API simple et puissante pour construire des modèles de réseaux de neurones, ce qui facilite la propagation avant et la définition du modèle.
- Optimiseurs: Utilisez des optimiseurs (tels qu'Adam, SGD, etc.) pour mettre à jour les paramètres du modèle afin de minimiser la perte.
- Périphérique: Vous pouvez déplacer les modèles et les tenseurs vers le GPU pour accélérer les calculs.
Aperçu de l'architecture de PyTorch
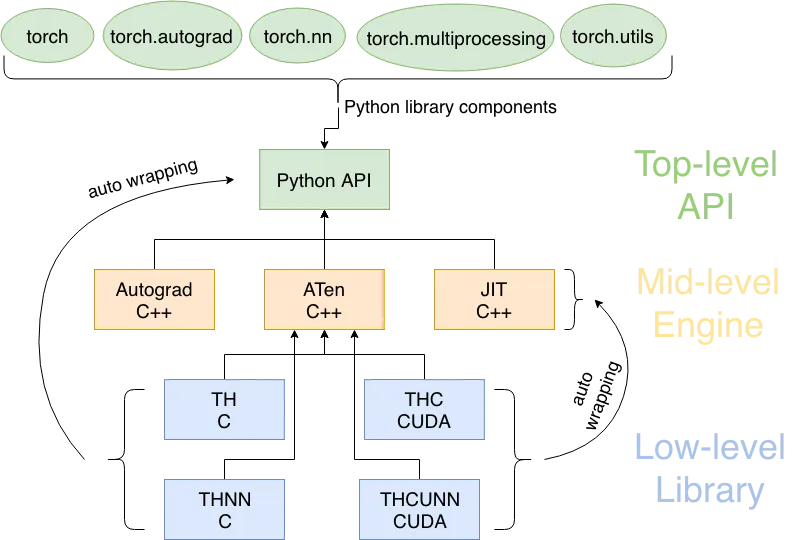
PyTorch adopte une conception modulaire, composée de plusieurs composants centraux qui fonctionnent ensemble. Comprendre les rôles et les relations de ces composants est essentiel pour maîtriser PyTorch.
Diagramme de l'architecture de PyTorch
┌─────────────────────────────────────────────────────────────┐
│                    PyTorch 生态系统                          │
├─────────────────────────────────────────────────────────────┤
│  torchvision  │  torchtext  │  torchaudio  │  其他专业库     │
├─────────────────────────────────────────────────────────────┤
│                     PyTorch 核心                            │
├───────────────┬─────────────────┬───────────────────────────┤
│   torch.nn    │   torch.optim   │      torch.utils          │
│   (神经网络)   │   (优化器)      │      (工具函数)           │
├───────────────┼─────────────────┼───────────────────────────┤
│               │                 │   torch.utils.data        │
│  torch 核心   │  autograd       │   (数据加载)              │
│  (张量计算)   │  (自动微分)     │                           │
└───────────────┴─────────────────┴───────────────────────────┘
PyTorch adopte une conception d'architecture en couches, de haut en bas comme suit :
1. API Python (couche supérieure)
torch: Calcul tensoriel de base (similaire à NumPy, prend en charge le GPU).torch.nn: Couches de réseaux de neurones, fonctions de perte, etc.torch.autograd: Différenciation automatique (rétropropagation).- Interfaces appelées directement par les développeurs, simples et faciles à utiliser.
2. Cœur C++ (couche intermédiaire)
- ATen: Bibliothèque centrale pour les opérations sur les tenseurs (plus de 400 opérations).
- JIT: Compilation juste-à-temps pour optimiser les modèles.
- Moteur Autograd: Implémentation de bas niveau de la différenciation automatique.
- Calcul haute performance, reliant Python au matériel sous-jacent.
3. Bibliothèques de base (couche inférieure)
- TH/THNN: Opérations de base sur les tenseurs et les réseaux de neurones implémentées en C.
- THC/THCUNN: Version CUDA (GPU) correspondante.
- Opère directement sur le matériel (CPU/GPU), en optimisant la vitesse à l'extrême.
Flux d'exécution:
Code Python → calcul du cœur C++ → accélération par la bibliothèque CUDA/C de bas niveau → retour du résultat.
Il conserve sa facilité d'utilisation tout en garantissant des performances élevées.
Tenseur
Le tenseur est la structure de données centrale de PyTorch, utilisée pour stocker et manipuler des tableaux multidimensionnels.
Un tenseur peut être considéré comme un tableau multidimensionnel qui prend en charge des opérations de calcul accélérées.
Dans PyTorch, les tenseurs sont conceptuellement similaires aux tableaux de NumPy, mais les tenseurs PyTorch peuvent s'exécuter sur différents appareils, tels que CPU et GPU, ce qui les rend particulièrement adaptés au calcul parallèle à grande échelle, en particulier en apprentissage profond.
-
Dimensionnalité: La dimensionnalité d'un tenseur fait référence à la structure de tableau multidimensionnel des données. Par exemple, un scalaire (tenseur 0-dimensionnel) est un nombre unique, un vecteur (tenseur 1-dimensionnel) est un tableau unidimensionnel, une matrice (tenseur 2-dimensionnel) est un tableau bidimensionnel, et ainsi de suite.
-
Forme: La forme d'un tenseur fait référence à la taille de chaque dimension. Par exemple, un tenseur de forme
(3, 4)signifie qu'il a 3 lignes et 4 colonnes. -
Type de données: Le type de données dans un tenseur définit la taille mémoire nécessaire pour stocker chaque élément et la façon dont il est interprété. PyTorch prend en charge plusieurs types de données, notamment les types entiers (par ex.,
torch.int8、torch.int32), les types à virgule flottante (par ex.,torch.float32、torch.float64) et le type booléen (torch.bool)。
Création de tenseur :
Exemple
# Créer un tenseur 2x3 rempli de zéros
a = torch.zeros(2, 3)
print(a)
# Créer un tenseur 2x3 rempli de uns
b = torch.ones(2, 3)
print(b)
# Créer un tenseur 2x3 de nombres aléatoires
c = torch.randn(2, 3)
print(c)
# Créer un tenseur à partir d'un tableau NumPy
import numpy as np
numpy_array = np.array([[1, 2], [3, 4]])
tensor_from_numpy = torch.from_numpy(numpy_array)
print(tensor_from_numpy)
# Créer un tenseur sur un appareil spécifié (CPU/GPU)
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
d = torch.randn(2, 3, device=device)
print(d)
La sortie est similaire à ce qui suit :
tensor([[0., 0., 0.],
        [0., 0., 0.]])
tensor([[1., 1., 1.],
        [1., 1., 1.]])
tensor([[ 1.0189, -0.5718, -1.2814],
        [-0.5865,  1.0855,  1.1727]])
tensor([[1, 2],
        [3, 4]])
tensor([[-0.3360,  0.2203,  1.3463],
        [-0.5982, -0.2704,  0.5429]])
Opérations courantes sur les tenseurs :
Exemple
e = torch.randn(2, 3)
f = torch.randn(2, 3)
print(e + f)
# multiplication élément par élément
print(e * f)
# transposition de tenseur
g = torch.randn(3, 2)
print(g.t()) # ou g.transpose(0, 1)
# forme du tenseur
print(g.shape) # Renvoie la forme
Tenseur et appareil
Les tenseurs PyTorch peuvent exister sur différents appareils, y compris CPU et GPU. Vous pouvez déplacer les tenseurs vers le GPU pour accélérer le calcul :
if torch.cuda.is_available():
    tensor_gpu = tensor_from_list.to('cuda')  # 将张量移动到GPU
Gradients et différenciation automatique
Les tenseurs PyTorch prennent en charge la différenciation automatique, une fonctionnalité clé en apprentissage profond. Lorsque vous créez un tenseur qui nécessite des gradients, PyTorch peut calculer automatiquement son gradient :
Exemple
tensor_requires_grad = torch.tensor([1.0], requires_grad=True)
# Effectuer quelques opérations
tensor_result = tensor_requires_grad * 2
# Calcul du gradient
tensor_result.backward()
print(tensor_requires_grad.grad) # Gradient de sortie
Mémoire et performances
Les tenseurs PyTorch offrent également certaines fonctionnalités de gestion de mémoire, telles que les méthodes .clone(), .detach() et .to(), qui peuvent vous aider à optimiser l'utilisation de la mémoire et à améliorer les performances.
Autograd (Différenciation automatique)
La différenciation automatique, abrégée en Autograd, est une fonctionnalité essentielle des frameworks d'apprentissage profond, qui permet aux ordinateurs de calculer automatiquement les dérivées de fonctions mathématiques.
En apprentissage profond, la différenciation automatique est principalement utilisée à deux fins :L'une consiste à calculer les gradients lors de l'entraînement des réseaux de neurones,L'autre consiste à implémenter l'algorithme de rétropropagation。
La différenciation automatique est basée sur la règle de dérivation en chaîne, une règle mathématique pour calculer les dérivées de fonctions complexes. La règle de dérivation en chaîne stipule que la dérivée d'une fonction composée est le produit des dérivées de ses parties constitutives. En apprentissage profond, les modèles sont généralement des fonctions complexes composées de nombreuses couches, et la différenciation automatique peut calculer efficacement les gradients de ces couches.
Graphe dynamique vs graphe statique
-
Graphe dynamique: Dans un graphe dynamique, le graphe de calcul est construit dynamiquement à l'exécution. Chaque fois qu'une opération est exécutée, le graphe de calcul est mis à jour, ce qui facilite le débogage et la modification des modèles. PyTorch utilise des graphes dynamiques.
-
Graphe statique: Dans un graphe statique, le graphe de calcul est construit avant le début de l'exécution et ne change pas. TensorFlow utilisait à l'origine des graphes statiques, mais a ensuite également pris en charge les graphes dynamiques.
PyTorch fournit une fonctionnalité de différenciation automatique, en utilisant le module autograd pour calculer automatiquement les gradients.
L'objet torch.Tensor possède un attribut requires_grad, qui indique si le gradient de ce tenseur doit être calculé.
Lorsque vous créez un tenseur avec requires_grad=True, PyTorch suit automatiquement toutes les opérations effectuées sur celui-ci afin de calculer les gradients ultérieurement.
Création d'un tenseur qui nécessite des gradients :
Exemple
x = torch.randn(2, 2, requires_grad=True)
print(x)
# Exécuter quelques opérations
y = x + 2
z = y * y * 3
out = z.mean()
print(out)
La sortie est similaire à ce qui suit :
tensor([[0., 0., 0.],
        [0., 0., 0.]])
tensor([[1., 1., 1.],
        [1., 1., 1.]])
tensor([[ 1.0189, -0.5718, -1.2814],
        [-0.5865,  1.0855,  1.1727]])
tensor([[1, 2],
        [3, 4]])
tensor([[-0.3360,  0.2203,  1.3463],
        [-0.5982, -0.2704,  0.5429]])
tianqixin@Mac-mini example-test % python3 test.py
tensor([[-0.1908,  0.2811],
        [ 0.8068,  0.8002]], requires_grad=True)
tensor(18.1469, grad_fn=<MeanBackward0>)
Rétropropagation
Une fois le graphe de calcul défini, vous pouvez utiliser la méthode.backward()pour calculer les gradients.
Exemple
out.backward()
# Afficher le gradient de x
print(x.grad)
Dans l'entraînement des réseaux de neurones, la différenciation automatique est principalement utilisée pour implémenter l'algorithme de rétropropagation.
La rétropropagation est une méthode d'entraînement des réseaux de neurones qui consiste à calculer le gradient de la fonction de perte par rapport aux paramètres du réseau. À chaque itération, la propagation avant du réseau calcule la sortie et la perte, puis la rétropropagation calcule le gradient de la perte par rapport à chaque paramètre et utilise ces gradients pour mettre à jour les paramètres.
Arrêt du calcul du gradient
Si vous ne voulez pas que les gradients de certains tenseurs soient calculés (par exemple, lorsque vous n'avez pas besoin de la rétropropagation), vous pouvez utilisertorch.no_grad()ou définirrequires_grad=False。
Exemple
with torch.no_grad():
y = x * 2
Réseau de neurones (nn.Module)
Un réseau de neurones est un modèle computationnel qui imite les connexions des neurones dans le cerveau humain. Il est constitué de plusieurs couches de nœuds (neurones) et est utilisé pour apprendre des motifs et des relations complexes dans les données.
Les réseaux de neurones optimisent les résultats de prédiction en ajustant les poids de connexion entre les neurones. Ce processus implique la propagation avant, le calcul de la perte, la rétropropagation et la mise à jour des paramètres.
Les types de réseaux de neurones incluent les réseaux de neurones à propagation avant, les réseaux de neurones convolutifs (CNNs), les réseaux de neurones récurrents (RNNs) et les réseaux de neurones à mémoire à long et court terme (LSTMs). Ils sont largement utilisés dans des domaines tels que la reconnaissance d'images, le traitement de la parole et le traitement du langage naturel.
PyTorch fournit une interface très pratique pour construire des modèles de réseaux de neurones, à savoirtorch.nn.Module。
Nous pouvons hériter de la classe nn.Module et définir nos propres couches de réseau.
Créer un réseau neuronal simple :
Exemple
import torch.optim as optim
# Définir un réseau de neurones entièrement connecté simple
class SimpleNN(nn.Module):
def __init__(self):
super(SimpleNN, self).__init__()
self.fc1 = nn.Linear(2, 2) # Couche d'entrée vers couche cachée
self.fc2 = nn.Linear(2, 1) # Couche cachée vers couche de sortie
def forward(self, x):
x = torch.relu(self.fc1(x)) # Fonction d'activation ReLU
x = self.fc2(x)
return x
# Créer une instance de réseau
model = SimpleNN()
# Afficher la structure du modèle
print(model)
Résultat de sortie :
SimpleNN(
  (fc1): Linear(in_features=2, out_features=2, bias=True)
  (fc2): Linear(in_features=2, out_features=1, bias=True)
)
Processus d'entraînement :
-
Propagation avant: Dans la phase de propagation avant, les données d'entrée sont transmises à travers les couches du réseau, chaque couche appliquant des poids et des fonctions d'activation jusqu'à ce qu'une sortie soit produite.
-
Calculer la perte: Calculez la valeur de la fonction de perte en fonction de la sortie du réseau et des étiquettes vraies.
-
Rétropropagation: La rétropropagation utilise des techniques de différenciation automatique pour calculer le gradient de la fonction de perte par rapport à chaque paramètre.
-
Mise à jour des paramètres: Utilisez un optimiseur pour mettre à jour les poids et biais du réseau en fonction des gradients.
-
Itération: Répétez le processus ci-dessus jusqu'à ce que la performance du modèle sur les données d'entraînement atteigne un niveau satisfaisant.
Propagation avant et calcul de la perte
Exemple
x = torch.randn(1, 2)
# Propagation avant
output = model(x)
print(output)
# Définir la fonction de perte (par ex., erreur quadratique moyenne MSE)
criterion = nn.MSELoss()
# Supposer que la valeur cible est 1
target = torch.randn(1, 1)
# Calculer la perte
loss = criterion(output, target)
print(loss)
Optimiseurs
Les optimiseurs mettent à jour les paramètres d'un réseau de neurones pendant l'entraînement afin de réduire la valeur de la fonction de perte.
PyTorch fournit une variété d'optimiseurs, tels que SGD, Adam, etc.
Utilisation d'un optimiseur pour la mise à jour des paramètres :
Exemple
optimizer = optim.Adam(model.parameters(), lr=0.001)
# Étape d'entraînement
optimizer.zero_grad() # Effacer les gradients
loss.backward() # Rétropropagation
optimizer.step() # Mettre à jour les paramètres
Entraînement du modèle
L'entraînement d'un modèle est le processus central en apprentissage automatique et en apprentissage profond. Il vise à apprendre les paramètres du modèle à partir d'une grande quantité de données afin que le modèle puisse faire des prédictions précises sur de nouvelles données inédites.
L'entraînement d'un modèle comprend généralement les étapes suivantes :
-
Préparation des données:
- Collecter et traiter les données, y compris le nettoyage, la standardisation et la normalisation.
- Diviser les données en ensembles d'entraînement, de validation et de test.
-
Définir le modèle:
- Choisir l'architecture du modèle, telle que les arbres de décision, les réseaux de neurones, etc.
- Initialiser les paramètres du modèle (poids et biais).
-
Sélectionner une fonction de perte:
- Choisir une fonction de perte appropriée en fonction du type de tâche (par exemple, classification, régression).
-
Sélectionner un optimiseur:
- Choisir un algorithme d'optimisation, tel que SGD, Adam, etc., pour mettre à jour les paramètres du modèle.
-
Propagation avant:
- À chaque itération, faire passer les données d'entrée dans le modèle et calculer la sortie prédite.
-
Calculer la perte:
- Utiliser la fonction de perte pour évaluer la différence entre la sortie prédite et les étiquettes réelles.
-
Rétropropagation:
- Utiliser la différenciation automatique pour calculer le gradient de la perte par rapport aux paramètres du modèle.
-
Mise à jour des paramètres:
- Mettre à jour les paramètres du modèle en fonction des gradients calculés et de la stratégie de l'optimiseur.
-
Optimisation itérative:
- Répéter les étapes 5 à 8 jusqu'à ce que les performances du modèle sur l'ensemble de validation ne s'améliorent plus ou qu'un nombre prédéterminé d'itérations soit atteint.
-
Évaluation et test:
- Utiliser l'ensemble de test pour évaluer les performances finales du modèle afin de garantir que le modèle ne surapprend pas.
-
Réglage du modèle:
- Ajuster les hyperparamètres en fonction des performances du modèle sur l'ensemble de test, par exemple en modifiant le taux d'apprentissage, en ajoutant une régularisation, etc.
-
Déployer le modèle:
- Déployer le modèle entraîné dans un environnement de production pour des tâches de prédiction réelles.
Exemple
import torch.nn as nn
import torch.optim as optim
# 1. Définir un modèle simple de réseau de neurones
class SimpleNN(nn.Module):
def __init__(self):
super(SimpleNN, self).__init__()
self.fc1 = nn.Linear(2, 2) # Couche d'entrée vers couche cachée
self.fc2 = nn.Linear(2, 1) # Couche cachée vers couche de sortie
def forward(self, x):
x = torch.relu(self.fc1(x)) # Fonction d'activation ReLU
x = self.fc2(x)
return x
# 2. Créer une instance de modèle
model = SimpleNN()
# 3. Définir la fonction de perte et l'optimiseur
criterion = nn.MSELoss() # Fonction de perte d'erreur quadratique moyenne
optimizer = optim.Adam(model.parameters(), lr=0.001) # Optimiseur Adam
# 4. Supposons que nous ayons des données d'entraînement X et Y
X = torch.randn(10, 2) # 10 échantillons, 2 caractéristiques
Y = torch.randn(10, 1) # 10 valeurs cibles
# 5. Boucle d'entraînement
for epoch in range(100): # Entraîner pendant 100 époques
optimizer.zero_grad() # Effacer les gradients précédents
output = model(X) # Propagation avant
loss = criterion(output, Y) # Calculer la perte
loss.backward() # Rétropropagation
optimizer.step() # Mettre à jour les paramètres
# Afficher la perte toutes les 10 époques
if (epoch+1) % 10 == 0:
print(f'Epoch [{epoch+1}/100], Loss: {loss.item():.4f}')
Le résultat de sortie est le suivant :
Epoch [10/100], Loss: 1.7180
Epoch [20/100], Loss: 1.6352
Epoch [30/100], Loss: 1.5590
Epoch [40/100], Loss: 1.4896
Epoch [50/100], Loss: 1.4268
Epoch [60/100], Loss: 1.3704
Epoch [70/100], Loss: 1.3198
Epoch [80/100], Loss: 1.2747
Epoch [90/100], Loss: 1.2346
Epoch [100/100], Loss: 1.1991
Toutes les 10 époques, le programme affiche la valeur de perte actuelle, ce qui nous aide à suivre la progression de l'entraînement du modèle. Au fur et à mesure de l'entraînement, la valeur de perte devrait diminuer progressivement, indiquant que le modèle apprend et optimise continuellement ses paramètres.
L'entraînement d'un modèle est un processus itératif qui nécessite des ajustements et une optimisation continus jusqu'à ce que des performances satisfaisantes soient atteintes. Ce processus implique un grand nombre d'expériences et de réglages, visant à donner au modèle une bonne capacité de généralisation sur de nouvelles données jamais vues.
Appareil
PyTorch vous permet de déplacer les modèles et les données vers un GPU pour l'accélération.
Utiliseztorch.devicepour spécifier le périphérique de calcul.
Déplacez le modèle et les données vers le GPU :
Exemple
# Déplacez le modèle vers le périphérique
model.to(device)
# Déplacez les données vers le périphérique
X = X.to(device)
Y = Y.to(device)
Pendant l'entraînement, tous les tenseurs et modèles doivent être déplacés vers le même périphérique (soit tous sur le CPU, soit tous sur le GPU).
Extensions supplémentaires