PyTorch: построение модели Transformer
Transformer — одна из самых мощных моделей в современном машинном обучении.
Модель Transformer — это архитектура глубокого обучения, основанная на механизме самовнимания. Она произвела революцию в области обработки естественного языка (NLP) и стала основой современных моделей глубокого обучения, таких как BERT, GPT и др.
Transformer — это ключевая архитектура в современном NLP. Благодаря мощной способности моделировать дальние зависимости и эффективным преимуществам параллельных вычислений она превосходит традиционные сети Long Short-Term Memory (LSTM) в таких задачах, как перевод текста и суммирование текста.
Если вы ещё не понимаете Transformer, можете обратиться к:Введение в модель Transformer。
Построение модели Transformer с помощью PyTorch
Этапы построения модели Transformer следующие:
1. Импортируйте необходимые библиотеки и модули
Импортируйте основную библиотеку PyTorch, модуль нейронных сетей, модуль оптимизатора, инструменты обработки данных, а также модули математических функций и копирования объектов, чтобы обеспечить поддержку определения архитектуры модели, управления данными и процесса обучения.
import torch
import torch.nn as nn
import torch.optim as optim
import torch.utils.data as data
import math
import copy
Описание:
torch: основная библиотека PyTorch, используемая для операций с тензорами и автоматического дифференцирования.torch.nn: модуль нейронных сетей PyTorch, содержащий различные слои и функции потерь.torch.optim: модуль алгоритмов оптимизации, таких как Adam, SGD и т. д.math: библиотека математических функций, используемая для вычисления квадратных корней и т. д.copy: используется для глубокого копирования объектов.
Определите базовые строительные блоки: многоголовое внимание, позиционно-независимая сеть прямого распространения, позиционное кодирование
Многоголовое вниманиеВычисляя связи между каждой парой позиций в последовательности через несколько «голов внимания», оно позволяет улавливать различные признаки и закономерности входной последовательности.
Класс MultiHeadAttention инкапсулирует механизм многоголового внимания, обычно используемый в моделях Transformer. Он отвечает за разделение входных данных на несколько голов внимания, применение внимания к каждой голове и последующее объединение результатов, чтобы модель могла улавливать различные связи во входных данных на разных масштабах и повышать свою выразительную способность.
Пример
def __init__(self, d_model, num_heads):
super(MultiHeadAttention, self).__init__()
assert d_model % num_heads == 0, "d_model должен делиться на num_heads"
self.d_model = d_model # Размерность модели (например, 512)
self.num_heads = num_heads # Количество голов внимания (например, 8)
self.d_k = d_model // num_heads # Размерность каждой головы (например, 64)
# Определить слои линейного преобразования (без смещения)
self.W_q = nn.Linear(d_model, d_model) # Преобразование запроса
self.W_k = nn.Linear(d_model, d_model) # Преобразование ключа
self.W_v = nn.Linear(d_model, d_model) # Преобразование значения
self.W_o = nn.Linear(d_model, d_model) # Преобразование выхода
def scaled_dot_product_attention(self, Q, K, V, mask=Отсутствует):
"""
Вычислить внимание с масштабированным скалярным произведением
Форма входных данных:
Q: (batch_size, num_heads, seq_length, d_k)
K, V: такие же, как Q
Форма выходных данных: (batch_size, num_heads, seq_length, d_k)
"""
# Вычислить оценки внимания (скалярное произведение Q и K)
attn_scores = torch.matmul(Q, K.transpose(-2, -1)) / math.sqrt(self.d_k)
# Применить маску (например, маску заполнения или маску будущей информации)
if mask is not None:
attn_scores = attn_scores.masked_fill(mask == 0, -1e9)
# Вычислить веса внимания (нормализация softmax)
attn_probs = torch.softmax(attn_scores, dim=-1)
# Взвешенная сумма векторов значений
output = torch.matmul(attn_probs, V)
return output
def split_heads(self, x):
"""
Разделить входной тензор на несколько голов
Форма входных данных: (batch_size, seq_length, d_model)
Форма выходных данных: (batch_size, num_heads, seq_length, d_k)
"""
batch_size, seq_length, d_model = x.size()
return x.view(batch_size, seq_length, self.num_heads, self.d_k).transpose(1, 2)
def combine_heads(self, x):
"""
Объединить выходы нескольких голов обратно в исходную форму
Форма входных данных: (batch_size, num_heads, seq_length, d_k)
Форма выходных данных: (batch_size, seq_length, d_model)
"""
batch_size, _, seq_length, d_k = x.size()
return x.transpose(1, 2).contiguous().view(batch_size, seq_length, self.d_model)
def forward(self, Q, K, V, mask=Отсутствует):
"""
Прямое распространение
Форма входа: Q/K/V: (batch_size, seq_length, d_model)
Форма выходных данных: (batch_size, seq_length, d_model)
"""
# Линейное преобразование и разделение на несколько голов
Q = self.split_heads(self.W_q(Q)) # (batch, heads, seq_len, d_k)
K = self.split_heads(self.W_k(K))
V = self.split_heads(self.W_v(V))
# Вычисление внимания
attn_output = self.scaled_dot_product_attention(Q, K, V, mask)
# Объединить головы и применить выходное преобразование
output = self.W_o(self.combine_heads(attn_output))
return output
Описание:
Механизм многоголового внимания: Разделить вход на несколько голов, каждая голова независимо вычисляет внимание, и в конце объединить результаты.
Внимание на основе масштабированного скалярного произведения: Вычислить скалярное произведение запросов и ключей, масштабировать его, использовать softmax для вычисления весов внимания и в конце взять взвешенную сумму значений.
Маска: Используется для маскирования недопустимых позиций (например, дополненных частей).
Позиционно-независимая сеть прямого распространения
Пример
def __init__(self, d_model, d_ff):
super(PositionWiseFeedForward, self).__init__()
self.fc1 = nn.Linear(d_model, d_ff) # Первый полносвязный слой
self.fc2 = nn.Linear(d_ff, d_model) # Второй полносвязный слой
self.relu = nn.ReLU() # Функция активации
def forward(self, x):
# Вычисление в сети прямого распространения
return self.fc2(self.relu(self.fc1(x)))
Сеть прямого распространения:Она состоит из двух полносвязных слоёв и функции активации ReLU, которые используются для дальнейшей обработки выхода механизма внимания.
Позиционное кодирование
Позиционное кодирование используется для внедрения информации о позиции каждого токена во входной последовательности.
Используйте функции синуса и косинуса разных частот для генерации позиционных кодировок.
Пример
def __init__(self, d_model, max_seq_length):
super(PositionalEncoding, self).__init__()
pe = torch.zeros(max_seq_length, d_model) # Инициализировать матрицу позиционного кодирования
position = torch.arange(0, max_seq_length, dtype=torch.float).unsqueeze(1)
div_term = torch.exp(torch.arange(0, d_model, 2).float() * -(math.log(10000.0) / d_model))
pe[:, 0::2] = torch.sin(position * div_term) # Использовать функцию синуса для чётных позиций
pe[:, 1::2] = torch.cos(position * div_term) # Использовать функцию косинуса для нечётных позиций
self.register_buffer('pe', pe.unsqueeze(0)) # Зарегистрировать как буфер
def forward(self, x):
# Добавить позиционное кодирование к входу
return x + self.pe[:, :x.size(1)]
Построение блока энкодера (слой энкодера)
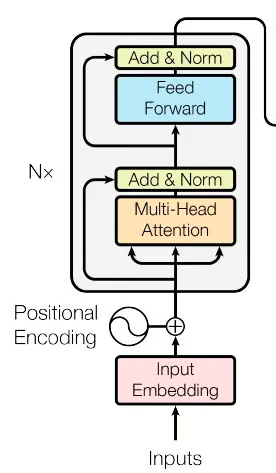
Слой энкодера:Содержит механизм самовнимания и сеть прямого распространения; каждый подуровень сопровождается остаточными соединениями и нормализацией слоя.
Пример
def __init__(self, d_model, num_heads, d_ff, dropout):
super(EncoderLayer, self).__init__()
self.self_attn = MultiHeadAttention(d_model, num_heads) # Механизм самовнимания
self.feed_forward = PositionWiseFeedForward(d_model, d_ff) # Сеть прямого распространения
self.norm1 = nn.LayerNorm(d_model) # Нормализация слоя
self.norm2 = nn.LayerNorm(d_model)
self.dropout = nn.Dropout(dropout) # Dropout
def forward(self, x, mask):
# Механизм самовнимания
attn_output = self.self_attn(x, x, x, mask)
x = self.norm1(x + self.dropout(attn_output)) # Остаточное соединение и нормализация слоя
# Сеть прямого распространения
ff_output = self.feed_forward(x)
x = self.norm2(x + self.dropout(ff_output)) # Остаточное соединение и нормализация слоя
return x
Соберите модуль декодера

Слой декодера:Содержит механизм самовнимания, механизм перекрёстного внимания и сеть прямого распространения, при этом за каждым подслоем следуют остаточные соединения и нормализация слоя.
Пример
def __init__(self, d_model, num_heads, d_ff, dropout):
super(DecoderLayer, self).__init__()
self.self_attn = MultiHeadAttention(d_model, num_heads) # Механизм самовнимания
self.cross_attn = MultiHeadAttention(d_model, num_heads) # Механизм перекрёстного внимания
self.feed_forward = PositionWiseFeedForward(d_model, d_ff) # Сеть прямого распространения
self.norm1 = nn.LayerNorm(d_model) # Нормализация слоя
self.norm2 = nn.LayerNorm(d_model)
self.norm3 = nn.LayerNorm(d_model)
self.dropout = nn.Dropout(dropout) # Dropout
def forward(self, x, enc_output, src_mask, tgt_mask):
# Механизм самовнимания
attn_output = self.self_attn(x, x, x, tgt_mask)
x = self.norm1(x + self.dropout(attn_output)) # Остаточное соединение и нормализация слоя
# Механизм перекрёстного внимания
attn_output = self.cross_attn(x, enc_output, enc_output, src_mask)
x = self.norm2(x + self.dropout(attn_output)) # Остаточное соединение и нормализация слоя
# Сеть прямого распространения
ff_output = self.feed_forward(x)
x = self.norm3(x + self.dropout(ff_output)) # Остаточное соединение и нормализация слоя
return x
Соберите полную модель Transformer

Пример
def __init__(self, src_vocab_size, tgt_vocab_size, d_model, num_heads, num_layers, d_ff, max_seq_length, dropout):
super(Transformer, self).__init__()
self.encoder_embedding = nn.Embedding(src_vocab_size, d_model) # Встраивание слов энкодера
self.decoder_embedding = nn.Embedding(tgt_vocab_size, d_model) # Встраивание слов декодера
self.positional_encoding = PositionalEncoding(d_model, max_seq_length) # Позиционное кодирование
# Слои энкодера и декодера
self.encoder_layers = nn.ModuleList([EncoderLayer(d_model, num_heads, d_ff, dropout) for _ in range(num_layers)])
self.decoder_layers = nn.ModuleList([DecoderLayer(d_model, num_heads, d_ff, dropout) for _ in range(num_layers)])
self.fc = nn.Linear(d_model, tgt_vocab_size) # Финальный полносвязный слой
self.dropout = nn.Dropout(dropout) # Dropout
def generate_mask(self, src, tgt):
# Маска источника: маскировать токены заполнения (предполагается, что индекс заполнения равен 0)
# Форма: (batch_size, 1, 1, seq_length)
src_mask = (src != 0).unsqueeze(1).unsqueeze(2)
# Маска цели: маскировать токены заполнения и будущую информацию
# Форма: (batch_size, 1, seq_length, 1)
tgt_mask = (tgt != 0).unsqueeze(1).unsqueeze(3)
seq_length = tgt.size(1)
# Сгенерировать маску в виде верхнетреугольной матрицы, чтобы предотвратить просмотр будущей информации во время декодирования
nopeak_mask = (1 - torch.triu(torch.ones(1, seq_length, seq_length), diagonal=1)).bool()
tgt_mask = tgt_mask & nopeak_mask # Объединить маску заполнения и маску будущей информации
return src_mask, tgt_mask
def forward(self, src, tgt):
# Сгенерировать маски
src_mask, tgt_mask = self.generate_mask(src, tgt)
# Часть энкодера
src_embedded = self.dropout(self.positional_encoding(self.encoder_embedding(src)))
enc_output = src_embedded
for enc_layer in self.encoder_layers:
enc_output = enc_layer(enc_output, src_mask)
# Часть декодера
tgt_embedded = self.dropout(self.positional_encoding(self.decoder_embedding(tgt)))
dec_output = tgt_embedded
for dec_layer in self.decoder_layers:
dec_output = dec_layer(dec_output, enc_output, src_mask, tgt_mask)
# Финальный вывод
output = self.fc(dec_output)
return output
Описание:
Модель TransformerСодержит части энкодера и декодера, каждая из которых состоит из нескольких слоёв, объединённых в стек.
Генерация маскиИспользуется для маскирования недопустимых позиций и будущей информации.
Прямое распространениеПоследовательно проходит через энкодер и декодер и в итоге выводится через полносвязный слой.
Описание параметров инициализации модели:
class Transformer(nn.Module):
    def __init__(
        self,
        src_vocab_size,  # 源语言词汇表大小(如英文单词数)
        tgt_vocab_size,  # 目标语言词汇表大小(如中文单词数)
        d_model=512,     # 模型维度(每个词向量的长度)
        num_heads=8,     # 多头注意力的头数
        num_layers=6,    # 编码器/解码器的堆叠层数
        d_ff=2048,       # 前馈网络隐藏层维度
        max_seq_length=100, # 最大序列长度(用于位置编码)
        dropout=0.1      # Dropout概率
    ):
Обучение модели Transformer в PyTorch
Используйте случайные данные для обучения модели, вычислите потери и обновите параметры.
Пример
src_vocab_size = 5000 # Размер исходного словаря
tgt_vocab_size = 5000 # Размер целевого словаря
d_model = 512 # Размерность модели
num_heads = 8 # Количество голов внимания
num_layers = 6 # Количество слоёв энкодера и декодера
d_ff = 2048 # Внутренняя размерность сети прямого распространения
max_seq_length = 100 # Максимальная длина последовательности
dropout = 0.1 # Вероятность dropout
# Инициализация модели
transformer = Transformer(src_vocab_size, tgt_vocab_size, d_model, num_heads, num_layers, d_ff, max_seq_length, dropout)
# Сгенерировать случайные данные
src_data = torch.randint(1, src_vocab_size, (64, max_seq_length)) # Исходная последовательность
tgt_data = torch.randint(1, tgt_vocab_size, (64, max_seq_length)) # Целевая последовательность
# Определяем функцию потерь и оптимизатор
criterion = nn.CrossEntropyLoss(ignore_index=0) # Игнорировать потерю для части с заполнением
optimizer = optim.Adam(transformer.parameters(), lr=0.0001, betas=(0.9, 0.98), eps=1e-9)
# Цикл обучения
transformer.train()
for epoch in range(100):
optimizer.zero_grad() # Очистить градиенты, чтобы предотвратить накопление
# Удалить последнее слово при подаче целевой последовательности (используется для предсказания следующего слова)
output = transformer(src_data, tgt_data[:, :-1])
# При вычислении функции потерь целевая последовательность начинается со второго слова (т. е. предсказать следующее слово)
# Форма выходных данных: (batch_size, seq_length-1, tgt_vocab_size)
# Форма целевых данных: (batch_size, seq_length-1)
loss = criterion(
output.contiguous().view(-1, tgt_vocab_size),
tgt_data[:, 1:].contiguous().view(-1)
)
loss.backward() # Обратное распространение
optimizer.step() # Обновить параметры
print(f"Эпоха: {epoch+1}, Потери: {loss.item()}")
Оценка модели
Процесс оценки:Вычислите потери на валидационных данных для оценки производительности модели.
Пример
# Генерация валидационных данных
val_src_data = torch.randint(1, src_vocab_size, (64, max_seq_length))
val_tgt_data = torch.randint(1, tgt_vocab_size, (64, max_seq_length))
# Предположим, что входные данные — это батч английских предложений и соответствующих им китайских переводов (преобразованных в индексы)
# Пример данных:
# src_data: [[3, 14, 25, ..., 0, 0], ...] # Английские предложения (0 — токен заполнения)
# tgt_data: [[5, 20, 36, ..., 0, 0], ...] # Китайские переводы (0 — токен заполнения)
# Примечание: в практических приложениях текст требует предварительной обработки, такой как токенизация, кодирование и паддинг
with torch.no_grad():
val_output = transformer(val_src_data, val_tgt_data[:, :-1])
val_loss = criterion(val_output.contiguous().view(-1, tgt_vocab_size), val_tgt_data[:, 1:].contiguous().представление(-1))
print(f"Потери при валидации: {val_loss.item()}")