PyTorch 基礎
PyTorch は、オープンソースの深層学習フレームワークであり、その柔軟性と動的計算グラフで広く人気があります。
PyTorch には、主に以下の基本概念があります:テンソル(Tensor)、自動微分(Autograd)、ニューラルネットワークモジュール(nn.Module)、オプティマイザー(optim)など。
- テンソル(Tensor):PyTorch の中心的なデータ構造であり、多次元配列をサポートし、CPU または GPU 上で高速計算できます。
- 自動微分(Autograd):PyTorch は自動微分機能を提供し、モデルの勾配を簡単に計算できるため、逆伝播と最適化が容易です。
- ニューラルネットワーク(nn.Module):PyTorch は、ニューラルネットワークモデルを構築するためのシンプルかつ強力な API を提供し、順伝播とモデル定義を簡単に行えます。
- オプティマイザー(Optimizers):オプティマイザー(Adam、SGD など)を使用してモデルのパラメータを更新し、損失を最小化します。
- デバイス(Device):モデルとテンソルを GPU に移動して計算を高速化できます。
PyTorch アーキテクチャ概要
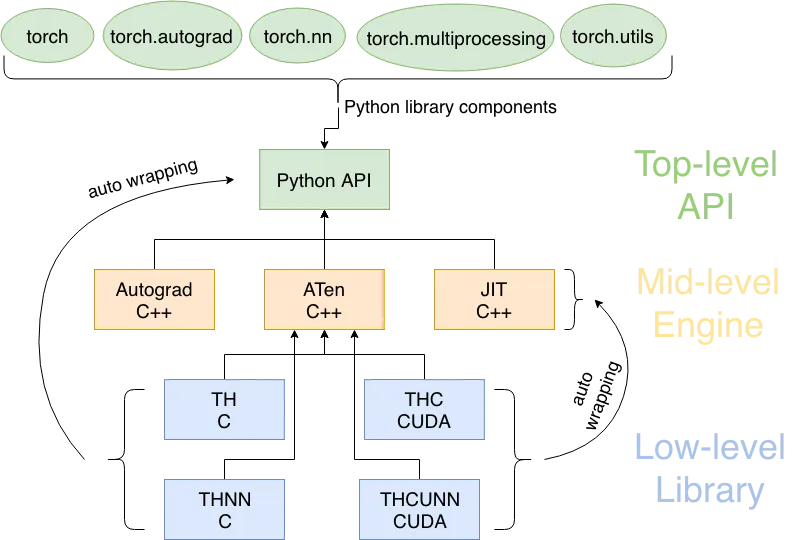
PyTorch はモジュール式設計を採用しており、相互に連携する複数のコアコンポーネントで構成されています。これらのコンポーネントの役割と相互関係を理解することが、PyTorch を習得する鍵です。
PyTorch アーキテクチャ図
┌─────────────────────────────────────────────────────────────┐
│                    PyTorch 生态系统                          │
├─────────────────────────────────────────────────────────────┤
│  torchvision  │  torchtext  │  torchaudio  │  其他专业库     │
├─────────────────────────────────────────────────────────────┤
│                     PyTorch 核心                            │
├───────────────┬─────────────────┬───────────────────────────┤
│   torch.nn    │   torch.optim   │      torch.utils          │
│   (神经网络)   │   (优化器)      │      (工具函数)           │
├───────────────┼─────────────────┼───────────────────────────┤
│               │                 │   torch.utils.data        │
│  torch 核心   │  autograd       │   (数据加载)              │
│  (张量计算)   │  (自动微分)     │                           │
└───────────────┴─────────────────┴───────────────────────────┘
PyTorch が採用するのは階層アーキテクチャ設計であり、上層から下層へ順に次のようになります:
1、Python API(最上層)
torch:コアテンソル計算(NumPy に類似、GPU サポート)。torch.nn:ニューラルネットワーク層、損失関数など。torch.autograd:自動微分(逆伝播)。- 開発者が直接呼び出すインターフェースであり、シンプルで使いやすい。
2、C++ コア(中間層)
- ATen:テンソル演算コアライブラリ(400以上の操作)。
- JIT:JIT コンパイルでモデルを最適化。
- Autograd エンジン:自動微分の低レベル実装。
- 高性能な計算であり、Python と低レベルハードウェアを接続します。
3、基本ライブラリ(最下層)
- TH/THNN:C言語で実装された基本テンソルとニューラルネットワーク操作。
- THC/THCUNN:対応する CUDA(GPU)バージョン。
- ハードウェア(CPU/GPU)を直接操作し、速度を極限まで最適化します。
実行フロー:
Python コード → C++ コア計算 → 低レベル CUDA/C ライブラリによる高速化 → 結果を返す。
使いやすさを保ちながら、高性能を確保します。
テンソル(Tensor)
テンソル(Tensor)は PyTorch の中心的なデータ構造であり、多次元配列の保存と操作に使用されます。
テンソルは多次元配列と見なすことができ、高速計算の操作をサポートします。
PyTorch におけるテンソルの概念は NumPy の配列に似ていますが、PyTorch のテンソルは CPU や GPU などの異なるデバイス上で実行できます。これにより、特に深層学習の分野での大規模並列計算に非常に適しています。
-
次元(Dimensionality):テンソルの次元とは、データの多次元配列構造を指します。例えば、スカラー(0次元テンソル)は単一の数値、ベクトル(1次元テンソル)は1次元配列、行列(2次元テンソル)は2次元配列であり、以下同様に続きます。
-
形状(Shape):テンソルの形状とは、各次元のサイズを指します。例えば、形状が
(3, 4)のテンソルは、3行4列であることを意味します。 -
データ型(Dtype):テンソルのデータ型は、各要素の保存に必要なメモリサイズと解釈方法を定義します。PyTorch は複数のデータ型をサポートしており、整数型(例:
torch.int8、torch.int32)、浮動小数点型(例:torch.float32、torch.float64)およびブール型(torch.bool)。
テンソルの作成:
例
# 2x3 の全要素が 0 のテンソルを作成
a = torch.zeros(2, 3)
print(a)
# 2x3 の全要素が 1 のテンソルを作成
b = torch.ones(2, 3)
print(b)
# 2x3 の乱数テンソルを作成
c = torch.randn(2, 3)
print(c)
# NumPy 配列からテンソルを作成
import numpy as np
numpy_array = np.array([[1, 2], [3, 4]])
tensor_from_numpy = torch.from_numpy(numpy_array)
print(tensor_from_numpy)
# 指定したデバイス(CPU/GPU)上でテンソルを作成
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
d = torch.randn(2, 3, device=device)
print(d)
出力結果は次のようになります:
tensor([[0., 0., 0.],
        [0., 0., 0.]])
tensor([[1., 1., 1.],
        [1., 1., 1.]])
tensor([[ 1.0189, -0.5718, -1.2814],
        [-0.5865,  1.0855,  1.1727]])
tensor([[1, 2],
        [3, 4]])
tensor([[-0.3360,  0.2203,  1.3463],
        [-0.5982, -0.2704,  0.5429]])
一般的なテンソル操作:
例
e = torch.randn(2, 3)
f = torch.randn(2, 3)
print(e + f)
# 要素ごとの乗算
print(e * f)
# テンソルの転置
g = torch.randn(3, 2)
print(g.t()) # または g.transpose(0, 1)
# テンソルの形状
print(g.shape) # 形状を返す
テンソルとデバイス
PyTorch のテンソルは、CPU や GPU を含む異なるデバイス上に存在できます。テンソルを GPU に移動して計算を高速化できます:
if torch.cuda.is_available():
    tensor_gpu = tensor_from_list.to('cuda')  # 将张量移动到GPU
勾配と自動微分
PyTorch のテンソルは自動微分をサポートしており、これは深層学習における重要な機能です。勾配が必要なテンソルを作成すると、PyTorch は自動的にその勾配を計算できます:
例
tensor_requires_grad = torch.tensor([1.0], requires_grad=True)
# いくつかの操作を実行
tensor_result = tensor_requires_grad * 2
# 勾配を計算
tensor_result.backward()
print(tensor_requires_grad.grad) # 勾配を出力
メモリとパフォーマンス
PyTorch のテンソルは、.clone()、.detach()、.to() などのメモリ管理機能も提供しており、メモリ使用の最適化とパフォーマンスの向上に役立ちます。
自動微分(Autograd)
自動微分(Automatic Differentiation、略して Autograd)は、深層学習フレームワークにおける中核的な機能であり、コンピュータが数学関数の導関数を自動的に計算することを可能にします。
深層学習において、自動微分は主に次の2つの側面で使用されます:1つ目は、ニューラルネットワークのトレーニング時に勾配を計算すること,2つ目は、逆伝播アルゴリズムの実装を行うこと。
自動微分は連鎖律(Chain Rule)に基づいています。これは複雑な関数の導関数を計算するための数学的法則です。連鎖律は、合成関数の導関数が各構成部分の導関数の積であることを示します。深層学習では、モデルは通常多くの層からなる複雑な関数であり、自動微分はこれらの層の勾配を効率的に計算できます。
動的グラフと静的グラフ:
-
動的グラフ(Dynamic Graph):動的グラフでは、計算グラフは実行時に動的に構築されます。操作を実行するたびに計算グラフが更新されるため、モデルのデバッグや修正が容易になります。PyTorch は動的グラフを使用します。
-
静的グラフ(Static Graph):静的グラフでは、計算グラフは実行開始前に構築され、変更されることはありません。TensorFlow は当初静的グラフを使用していましたが、後に動的グラフもサポートしました。
PyTorch は自動微分機能を提供し、autograd モジュールを通じて勾配を自動計算します。
torch.Tensor オブジェクトには requires_grad 属性があり、そのテンソルの勾配を計算する必要があるかどうかを示します。
requires_grad=True のテンソルを作成すると、PyTorch はそのテンソルに対するすべての操作を自動的に追跡し、後で勾配を計算できるようにします。
勾配が必要なテンソルの作成:
例
x = torch.randn(2, 2, requires_grad=True)
print(x)
# 何らかの操作を実行
y = x + 2
z = y * y * 3
out = z.mean()
print(out)
出力結果は次のようになります:
tensor([[0., 0., 0.],
        [0., 0., 0.]])
tensor([[1., 1., 1.],
        [1., 1., 1.]])
tensor([[ 1.0189, -0.5718, -1.2814],
        [-0.5865,  1.0855,  1.1727]])
tensor([[1, 2],
        [3, 4]])
tensor([[-0.3360,  0.2203,  1.3463],
        [-0.5982, -0.2704,  0.5429]])
tianqixin@Mac-mini サンプル-test % python3 test.py
tensor([[-0.1908,  0.2811],
        [ 0.8068,  0.8002]], requires_grad=True)
tensor(18.1469, grad_fn=<MeanBackward0>)
逆伝播(Backpropagation)
計算グラフが定義されたら、.backward()メソッドを使用して勾配を計算できます。
例
out.backward()
# x の勾配を確認
print(x.grad)
ニューラルネットワークのトレーニングにおいて、自動微分は主に逆伝播アルゴリズムを実装するために使用されます。
逆伝播は、損失関数のネットワークパラメータに関する勾配を計算することでニューラルネットワークをトレーニングする方法です。各イテレーションで、ネットワークの順伝播が出力と損失を計算し、次に逆伝播が各パラメータに関する損失の勾配を計算し、これらの勾配を使用してパラメータを更新します。
勾配計算の停止
一部のテンソルの勾配を計算したくない場合(例えば、逆伝播が不要な場合)は、次を使用できますtorch.no_grad()または設定requires_grad=False。
例
with torch.no_grad():
y = x * 2
ニューラルネットワーク(nn.Module)
ニューラルネットワークは、人間の脳のニューロン結合を模倣した計算モデルであり、複数層のノード(ニューロン)で構成され、データ間の複雑なパターンと関係を学習するために使用されます。
ニューラルネットワークは、ニューロン間の接続重みを調整して予測結果を最適化します。このプロセスには、順伝播、損失計算、逆伝播、パラメータ更新が含まれます。
ニューラルネットワークの種類には、順伝播型ニューラルネットワーク、畳み込みニューラルネットワーク(CNN)、再帰型ニューラルネットワーク(RNN)、長短期記憶ネットワーク(LSTM)があり、画像認識、音声処理、自然言語処理など多くの分野で広く応用されています。
PyTorch は、ニューラルネットワークモデルを構築するための非常に便利なインターフェースを提供します。すなわちtorch.nn.Module。
nn.Module クラスを継承して独自のネットワーク層を定義できます。
簡単なニューラルネットワークを作成します:
例
import torch.optim as optim
# 簡単な全結合ニューラルネットワークを定義する
class SimpleNN(nn.Module):
def __init__(self):
super(SimpleNN, self).__init__()
self.fc1 = nn.Linear(2, 2) # 入力層から隠れ層へ
self.fc2 = nn.Linear(2, 1) # 隠れ層から出力層へ
def forward(self, x):
x = torch.relu(self.fc1(x)) # ReLU活性化関数
x = self.fc2(x)
return x
# ネットワークインスタンスを作成
model = SimpleNN()
# モデル構造を出力
print(model)
出力結果:
SimpleNN(
  (fc1): Linear(in_features=2, out_features=2, bias=True)
  (fc2): Linear(in_features=2, out_features=1, bias=True)
)
トレーニングプロセス:
-
順伝播(Forward Propagation):順伝播段階では、入力データはネットワーク層を通過し、各層で重みと活性化関数が適用され、出力が生成されます。
-
損失の計算(Calculate Loss):ネットワークの出力と正解ラベルに基づいて、損失関数の値を計算します。
-
逆伝播(Backpropagation):逆伝播は自動微分技術を利用して、損失関数の各パラメータに関する勾配を計算します。
-
パラメータ更新(Parameter Update):オプティマイザを使用して勾配に基づいてネットワークの重みとバイアスを更新します。
-
反復(Iteration):上記のプロセスを繰り返し、モデルのトレーニングデータに対する性能が満足できる水準に達するまで続けます。
順伝播と損失計算
例
x = torch.randn(1, 2)
# 順伝播
output = model(x)
print(output)
# 損失関数を定義(例:平均二乗誤差 MSE)
criterion = nn.MSELoss()
# 目標値を 1 と仮定
target = torch.randn(1, 1)
# 損失を計算
loss = criterion(output, target)
print(loss)
オプティマイザー(Optimizers)
オプティマイザはトレーニング中にニューラルネットワークのパラメータを更新し、損失関数の値を減らします。
PyTorch は SGD、Adam など複数のオプティマイザを提供しています。
オプティマイザを使用したパラメータ更新:
例
optimizer = optim.Adam(model.parameters(), lr=0.001)
# トレーニング手順
optimizer.zero_grad() # 勾配をクリア
loss.backward() # 逆伝播
optimizer.step() # パラメータを更新
モデルのトレーニング
モデルのトレーニングは、機械学習とディープラーニングの中核となるプロセスであり、大量のデータを通じてモデルパラメータを学習し、モデルが新しく未見のデータに対して正確な予測を行えるようにすることを目的としています。
モデルのトレーニングには通常、以下の手順が含まれます:
-
データ準備:
- データの収集と処理。クレンジング、標準化、正規化を含みます。
- データをトレーニングセット、検証セット、テストセットに分割します。
-
モデルの定義:
- 決定木、ニューラルネットワークなどのモデルアーキテクチャを選択します。
- モデルパラメータ(重みとバイアス)を初期化します。
-
損失関数の選択:
- タスクの種類(分類、回帰など)に応じて適切な損失関数を選択します。
-
オプティマイザの選択:
- SGD、Adam などの最適化アルゴリズムを選択して、モデルパラメータを更新します。
-
順伝播:
- 各イテレーションで、入力データをモデルに通し、予測出力を計算します。
-
損失の計算:
- 損失関数を使用して、予測出力と正解ラベルの差を評価します。
-
逆伝播:
- 自動微分を利用して、モデルパラメータに対する損失の勾配を計算します。
-
パラメータ更新:
- 計算された勾配とオプティマイザの戦略に基づいてモデルパラメータを更新します。
-
反復最適化:
- 手順5〜8を繰り返し、モデルの検証セットでの性能が向上しなくなるか、所定のイテレーション回数に達するまで続けます。
-
評価とテスト:
- テストセットを使用してモデルの最終性能を評価し、過学習がないことを確認します。
-
モデルのチューニング:
- テストセットでのモデルのパフォーマンスに基づいて、学習率の変更や正則化の追加など、パラメータを調整します。
-
モデルのデプロイ:
- トレーニング済みモデルを本番環境にデプロイし、実際の予測タスクに使用します。
例
import torch.nn as nn
import torch.optim as optim
# 1. 簡単なニューラルネットワークモデルを定義する
class SimpleNN(nn.Module):
def __init__(self):
super(SimpleNN, self).__init__()
self.fc1 = nn.Linear(2, 2) # 入力層から隠れ層へ
self.fc2 = nn.Linear(2, 1) # 隠れ層から出力層へ
def forward(self, x):
x = torch.relu(self.fc1(x)) # ReLU活性化関数
x = self.fc2(x)
return x
# 2. モデルインスタンスを作成
model = SimpleNN()
# 3. 損失関数とオプティマイザを定義
criterion = nn.MSELoss() # 平均二乗誤差損失関数
optimizer = optim.Adam(model.parameters(), lr=0.001) # Adam オプティマイザ
# 4. トレーニングデータ X と Y があると仮定
X = torch.randn(10, 2) # 10個のサンプル、2つの特徴
Y = torch.randn(10, 1) # 10個の目標値
# 5. トレーニングループ
for epoch in range(100): # 100エポックトレーニング
optimizer.zero_grad() # 前回の勾配をクリア
output = model(X) # 順伝播
loss = criterion(output, Y) # 損失を計算
loss.backward() # 逆伝播
optimizer.step() # パラメータを更新
# 10エポックごとに損失を出力
if (epoch+1) % 10 == 0:
print(f'Epoch [{epoch+1}/100], Loss: {loss.item():.4f}')
出力結果は次のとおりです:
Epoch [10/100], Loss: 1.7180
Epoch [20/100], Loss: 1.6352
Epoch [30/100], Loss: 1.5590
Epoch [40/100], Loss: 1.4896
Epoch [50/100], Loss: 1.4268
Epoch [60/100], Loss: 1.3704
Epoch [70/100], Loss: 1.3198
Epoch [80/100], Loss: 1.2747
Epoch [90/100], Loss: 1.2346
Epoch [100/100], Loss: 1.1991
10エポックごとに、プログラムは現在の損失値を出力し、モデルのトレーニング進行状況を追跡するのに役立ちます。トレーニングが進むにつれて、損失値は徐々に低下し、モデルが学習を続けてパラメータを最適化していることを示します。
モデルのトレーニングは反復的なプロセスであり、満足できる性能に達するまで継続的な調整と最適化が必要です。このプロセスには多くの実験とチューニングが含まれ、モデルが新しく未見のデータに対しても良好な汎化能力を持つことを目的としています。
デバイス(Device)
PyTorch では、モデルとデータを GPU に移動して高速化できます。
使用torch.deviceを使用して計算デバイスを指定します。
モデルとデータを GPU に移動:
例
# モデルをデバイスに移動
model.to(device)
# データをデバイスに移動
X = X.to(device)
Y = Y.to(device)
トレーニング中、すべてのテンソルとモデルは同じデバイス(すべて CPU かすべて GPU)に移動する必要があります。
その他の拡張