PyTorch Dataset
В задачах глубокого обучения загрузка и обработка данных являются важнейшей частью.
PyTorch предоставляет мощные инструменты для загрузки и обработки данных, включая, в частности:
torch.utils.data.Dataset: Абстрактный класс для наборов данных, который необходимо настроить и реализовать__len__(размер набора данных) и__getitem__(получение образцов по индексу).torch.utils.data.TensorDataset: Набор данных на основе тензоров, подходящий для обработки пар данных и меток, напрямую поддерживает пакетирование и итерацию.torch.utils.data.DataLoader: Итератор, который оборачивает Dataset, обеспечивая пакетирование, перемешивание данных, многопоточную загрузку и т. д., чтобы упростить подачу данных для обучения модели.torchvision.datasets.ImageFolder: Загружает данные изображений из папок, каждая подпапка представляет класс, подходит для задач классификации изображений.
Встроенные наборы данных PyTorch
PyTorch предоставляет множество часто используемых наборов данных через модуль torchvision.datasets, например:
- MNIST: Набор данных изображений рукописных цифр, используемый для задач классификации изображений.
- CIFAR: Набор данных из 60,000 цветных изображений размером 32x32 в 10 классах, используемый для задач классификации изображений.
- COCO: Крупномасштабный набор данных для общего обнаружения объектов, сегментации и обнаружения ключевых точек, содержащий более 330k изображений и 2.5M экземпляров объектов.
- ImageNet: Содержит более 14 миллионов изображений, используется для таких задач, как классификация изображений и обнаружение объектов.
- STL-10: Набор данных, содержащий 100k цветных изображений размером 96x96, используемый для задач классификации изображений.
- Cityscapes: Содержит 5,000 тщательно аннотированных изображений городских улиц, используемых для задач семантической сегментации.
- SQUAD: набор данных, используемый для задач машинного понимания прочитанного.
Вышеуказанные наборы данных можно загрузить через функции в модуле torchvision.datasets, а другие наборы данных также можно загружать с помощью пользовательских методов.
torchvision и torchtext
- torchvision: библиотека графики, предоставляющая API и интерфейсы наборов данных, связанные с обработкой данных изображений, включая функции загрузки наборов данных и распространённые преобразования изображений.
- torchtext: инструментарий обработки естественного языка, предоставляющий инструменты для обработки и моделирования текстовых данных, включая методы предварительной обработки данных и загрузки данных.
torch.utils.data.Dataset
Dataset — это класс в PyTorch, используемый для абстракции набора данных.
Чтобы создать пользовательский набор данных, нужно наследоваться от torch.utils.data.Dataset и переопределить следующие два метода:
__len__: Возвращает размер набора данных.__getitem__: Получает образец данных и его метку по индексу.
Пример
from torch.utils.data import Dataset
# Пользовательский набор данных
class MyDataset(Dataset):
def __init__(self, data, labels):
# Инициализация данных
self.data = data
self.labels = labels
def __len__(self):
# Возвращает размер набора данных
return len(self.data)
def __getitem__(self, idx):
# Возвращает данные и метку по индексу
sample = self.data[idx]
label = self.labels[idx]
return sample, label
# Сгенерировать пример данных
data = torch.randn(100, 5) # 100 образцов, каждый с 5 признаками
labels = torch.randint(0, 2, (100,)) # 100 меток, значения 0 или 1
# Создание экземпляра набора данных
dataset = MyDataset(data, labels)
# Тестовый набор данных
print("Размер набора данных:", len(dataset))
print("Пример 0:", dataset[0])
Результат вывода следующий:
数据集大小: 100
第 0 个样本: (tensor([-0.2006,  0.7304, -1.3911, -0.4408,  1.1447]), tensor(0))
torch.utils.data.DataLoader
DataLoader — это загрузчик данных, предоставляемый PyTorch и используемый для загрузки наборов данных пакетами.
Он предоставляет следующие возможности:
- Пакетная загрузка: Установив
batch_size。 - Перемешивание данных: Установив
shuffle=True。 - Многопоточное ускорение: Установив
num_workers。 - Итеративный доступ: Удобно получать данные пакет за пакетом.
Пример
from torch.utils.data import Dataset
from torch.utils.data import DataLoader
# Пользовательский набор данных
class MyDataset(Dataset):
def __init__(self, data, labels):
# Инициализация данных
self.data = data
self.labels = labels
def __len__(self):
# Возвращает размер набора данных
return len(self.data)
def __getitem__(self, idx):
# Возвращает данные и метку по индексу
sample = self.data[idx]
label = self.labels[idx]
return sample, label
# Сгенерировать пример данных
data = torch.randn(100, 5) # 100 образцов, каждый с 5 признаками
labels = torch.randint(0, 2, (100,)) # 100 меток, значения 0 или 1
# Создание экземпляра набора данных
dataset = MyDataset(data, labels)
# Создать экземпляр DataLoader
dataloader = DataLoader(dataset, batch_size=10, shuffle=True, num_workers=0)
# Итерация по DataLoader
for batch_idx, (batch_data, batch_labels) in enumerate(dataloader):
print(f"Пакет {batch_idx + 1}")
print("Данные:", batch_data)
print("Метки:", batch_labels)
if batch_idx == 2: # Отображать только первые 3 пакета
break
Результат вывода следующий:
批次 1
数据: tensor([[ 0.4689,  0.6666, -1.0234,  0.8948,  0.4503],
        [ 0.0273, -0.4684, -0.7762,  0.7963,  0.2168],
        [ 1.0677, -0.3502, -0.9594, -1.1318, -0.2196],
        [-1.4989,  0.0267,  1.0405, -0.7284,  0.2335],
        [-0.5887, -0.4934,  1.6283,  1.4638,  0.0157],
        [-1.1047, -0.6550, -0.0381,  0.3617, -1.2792],
        [ 0.3592, -0.8264,  0.0231, -1.5508,  0.6833],
        [-0.6835,  0.6979,  0.9048, -0.4756,  0.3003],
        [ 1.1562, -0.4516, -1.2415,  0.2859,  0.5837],
        [ 0.7937,  1.5316, -0.6139,  0.7999,  0.5506]])
标签: tensor([0, 1, 1, 1, 1, 0, 1, 1, 0, 0])
批次 2
数据: tensor([[-0.0388, -0.3658,  0.8993, -1.5027,  1.0738],
        [-0.6182,  1.0684, -2.3049,  0.8338,  0.1363],
        [-0.5289,  0.1661, -0.0349,  0.2112,  1.4745],
        [-0.3304, -1.2114, -0.2982, -0.3006,  0.5252],
        [-1.4394, -0.3732,  1.0281,  0.5754,  1.0081],
        [ 0.8714, -0.1945, -0.2451, -0.2879, -2.0520],
        [ 0.0235,  0.4360,  0.1233,  0.0504,  0.5908],
        [ 0.5927,  0.1785, -0.9052, -0.9012,  0.8914],
        [ 0.4693,  0.5533, -0.1903,  0.0267,  0.4077],
        [-1.1683,  1.6699, -0.4846, -0.7404,  0.3370]])
标签: tensor([1, 1, 0, 1, 0, 1, 1, 0, 1, 1])
批次 3
数据: tensor([[ 0.2103, -0.7839,  1.4899,  2.2749, -0.7548],
        [-1.2836,  1.0025, -1.1162, -0.4261,  1.0690],
        [-0.7969,  1.0418, -0.7405,  0.8766,  0.2347],
        [-1.1071,  1.8560, -1.2979, -0.8364, -0.2925],
        [-1.0488,  0.4802, -0.6453,  0.2009,  0.5693],
        [ 0.8883,  0.4619, -0.2087,  0.2189, -0.3708],
        [-1.4578,  0.3629,  1.8282,  0.5353, -1.1783],
        [-1.2813,  0.5129, -0.4598, -0.2131, -1.2804],
        [ 1.7831,  1.1730, -0.2305, -0.6550,  0.1197],
        [-0.9384, -0.0483,  1.9626,  0.3342,  0.1700]])
标签: tensor([0, 0, 0, 1, 0, 1, 1, 1, 0, 1])
Использование встроенных наборов данных
PyTorch предоставляет несколько часто используемых наборов данных в torchvision, особенно подходящих для задач обработки изображений.
Загрузите набор данных MNIST:
Пример
import torchvision.transforms as transforms
from torch.utils.data import DataLoader
# Определение предварительной обработки данных
transform = transforms.Compose([
transforms.ToTensor(), # Преобразовать в тензор
transforms.Normalize((0.5,), (0.5,)) # Стандартизировать
])
# Загрузить обучающий набор данных
train_dataset = torchvision.datasets.MNIST(
root='./data', train=True, transform=transform, download=True)
# Использовать DataLoader для загрузки данных
train_loader = DataLoader(train_dataset, batch_size=32, shuffle=True)
# Просмотреть пакет данных
data_iter = iter(train_loader)
images, labels = next(data_iter)
print(f"Размер изображений в пакете: {images.shape}") # Форма выхода: [batch_size, 1, 28, 28]
print(f"Метки пакета: {labels}")
Результат вывода:
批次图像大小: torch.Size([32, 1, 28, 28])
批次标签: tensor([0, 4, 9, 8, 1, 3, 8, 1, 7, 2, 1, 1, 1, 2, 6, 3, 9, 7, 6, 9, 4, 9, 7, 1,
        3, 7, 3, 0, 7, 7, 6, 7])
Пользовательское применение Dataset и DataLoader
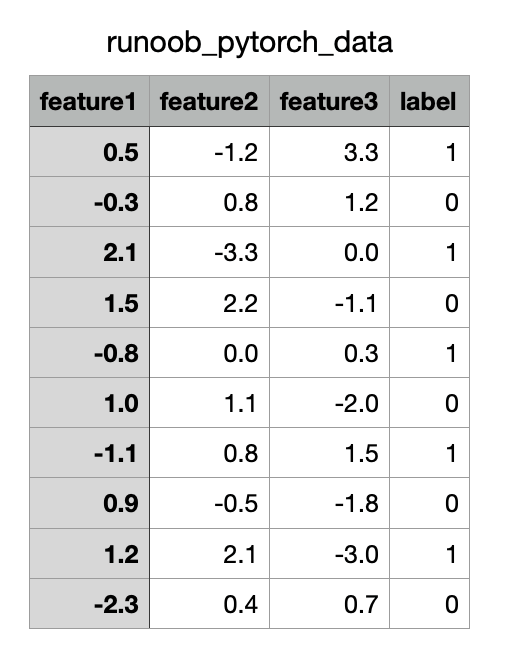
Ниже приведён пример использования CSV-файла в качестве источника данных и чтения данных через пользовательские Dataset и DataLoader.
Содержимое CSV-файла выглядит следующим образом (скачатьexample_pytorch_data.csv):
Пример
import pandas as pd
from torch.utils.data import Dataset, DataLoader
# Пользовательский набор данных CSV
class CSVDataset(Dataset):
def __init__(self, file_path):
# Чтение CSV-файла
self.data = pd.read_csv(file_path)
def __len__(self):
# Возвращает размер набора данных
return len(self.data)
def __getitem__(self, idx):
# Используйте .iloc для явного применения позиционной индексации
row = self.data.iloc[idx]
# Разделение признаков и меток
features = torch.tensor(row.iloc[:-1].to_numpy(), dtype=torch.float32) # Признаки
label = torch.tensor(row.iloc[-1], dtype=torch.float32) # Метки
return features, label
# Создать экземпляр dataset и DataLoader
dataset = CSVDataset("example_pytorch_data.csv")
dataloader = DataLoader(dataset, batch_size=4, shuffle=True)
# Итерация по DataLoader
for features, label in dataloader:
print("Features:", features)
print("Labels:", label)
break
Результат вывода:
特征: tensor([[ 1.2000,  2.1000, -3.0000],
        [ 1.0000,  1.1000, -2.0000],
        [ 0.5000, -1.2000,  3.3000],
        [-0.3000,  0.8000,  1.2000]])
标签: tensor([1., 0., 1., 0.])
tianqixin@Mac-mini example-test % python3 test.py
特征: tensor([[ 1.5000,  2.2000, -1.1000],
        [ 2.1000, -3.3000,  0.0000],
        [-2.3000,  0.4000,  0.7000],
        [-0.3000,  0.8000,  1.2000]])
标签: tensor([0., 1., 0., 0.])
Другие расширения