Reguläre Ausdrücke -Metazeichen
Metazeichen in regulären Ausdrücken sind Zeichen mit besonderen Bedeutungen. Sie repräsentieren keine Literalzeichen, sondern werden verwendet, um das Übereinstimmungsmuster zu steuern.
Grundlegende Metazeichen
.(Punkt)
-
Entspricht jedem einzelnen Zeichen außer Zeilenumbruch (
\n) außerhalb eines beliebigen einzelnen ZeichensBeispiel:
a.bEntspricht "aab", "a1b", "a b" usw.
^(Zirkumflex)
-
Entspricht der Startposition der Zeichenkette
-
Beispiel:
^abcEntspricht Zeichenketten, die mit "abc" beginnen
$(Dollarzeichen)
-
Entspricht der Endposition der Zeichenkette
-
Beispiel:
xyz$Entspricht Zeichenketten, die mit "xyz" enden
\(Backslash)
-
Escape-Zeichen, es bewirkt, dass das folgende Zeichen seine besondere Bedeutung verliert
-
Beispiel:
\.Entspricht einem tatsächlichen Punkt anstelle eines beliebigen Zeichens
Metazeichen für Zeichenklassen
[](eckige Klammern)
-
Definiert eine Zeichenmenge, entspricht einem beliebigen Zeichen darin
-
Beispiel:
[aeiou]Entspricht einem beliebigen Vokalbuchstaben
[^](negierte Zeichenklasse)
-
Entspricht jedem Zeichen, das nicht in den eckigen Klammern steht
-
Beispiel:
[^0-9]Entspricht jedem Zeichen, das keine Ziffer ist
-(Bindestrich)
-
Stellt einen Bereich innerhalb einer Zeichenklasse dar
-
Beispiel:
[a-z]Entspricht einem beliebigen Kleinbuchstaben
Quantifizierer-Metazeichen
*(Sternchen)
-
Entspricht dem vorangehenden Teilausdruck null Mal oder mehr
-
Beispiel:
ab*cEntspricht "ac", "abc", "abbc" usw.
+(Pluszeichen)
-
Entspricht dem vorangehenden Teilausdruck ein Mal oder mehr
-
Beispiel:
ab+cEntspricht "abc", "abbc", aber nicht "ac"
?(Fragezeichen)
-
Entspricht dem vorangehenden Teilausdruck null Mal oder einmal
-
Beispiel:
colou?rEntspricht "color" und "colour"
{n}(geschweifte Klammern)
-
Genau n-mal abgleichen
-
Beispiel:
a{3}Entspricht "aaa"
{n,}
-
Mindestens n-mal abgleichen
-
Beispiel:
a{2,}Entspricht "aa", "aaa", usw.
{n,m}
-
n- bis m-mal abgleichen
-
Beispiel:
a{2,4}Entspricht "aa", "aaa", "aaaa"
Gruppierungs- und Alternierungs-Metazeichen
()(runde Klammern)
-
Definiert einen Unterausdruck oder eine Capture-Gruppe
-
Beispiel:
(ab)+Entspricht "ab", "abab", usw.
|(senkrechter Strich)
-
Stellt eine "oder"-Beziehung dar
-
Beispiel:
cat|dogEntspricht "cat" oder "dog"
Metazeichen für spezielle Zeichenklassen
\d
-
Entspricht einer beliebigen Ziffer, äquivalent zu
[0-9]
\D
-
Entspricht einem beliebigen Nicht-Ziffer-Zeichen, äquivalent zu
[^0-9]
\w
-
Entspricht einem beliebigen Wortzeichen (Buchstabe, Ziffer, Unterstrich), äquivalent zu
[a-zA-Z0-9_]
\W
-
Entspricht einem beliebigen Nicht-Wortzeichen, äquivalent zu
[^a-zA-Z0-9_]
\s
-
Entspricht einem beliebigen Whitespace-Zeichen (Leerzeichen, Tabulator, Zeilenumbruch usw.)
\S
-
Entspricht jedem Nicht-Whitespace-Zeichen.
Metazeichen für Grenzübereinstimmungen
\b
-
Entspricht einer Wortgrenze
-
Beispiel:
\bcat\bEntspricht "cat", aber nicht "category"
\B
-
Entspricht einer Nicht-Wortgrenze
-
Beispiel:
\Bcat\BEntspricht "cat" in "scattered", aber nicht dem alleinstehenden "cat"
Andere Metazeichen
\n
-
Entspricht Zeilenumbruch
\t
-
Entspricht Tabulatorzeichen
\r
-
Entspricht Wagenrücklauf
\f
-
Entspricht Seitenvorschub
\v
-
Entspricht vertikalem Tabulator
Gierige und nicht-gierige Quantifizierer
Standardmäßig sind Quantifizierer (*, +, ?, {}) gierig und stimmen mit so vielen Zeichen wie möglich überein. Fügen Sie nach dem Quantifizierer?hinzu, um ihn in den nicht-gierigen (faulen) Modus zu versetzen:
-
*?: null oder mehr, aber so wenige wie möglich -
+?: eins oder mehr, aber so wenige wie möglich -
??: null oder eins, aber so wenige wie möglich -
{n,m}?: n- bis m-mal, aber so wenige wie möglich
Beispiel:<.*?>Beim Abgleichen von HTML-Tags wird nicht über Tags hinweg abgeglichen
Positiver und negativer Lookahead
(?=...)(positiver Lookahead)
-
Entspricht einer Position, auf die ein bestimmtes Muster folgt
-
Beispiel:
Windows(?=95|98)Entspricht "Windows", gefolgt von 95 oder 98
(?!...)(negativer Lookahead)
-
Entspricht einer Position, auf die kein bestimmtes Muster folgt
-
Beispiel:
Windows(?!95|98)Entspricht "Windows", nicht gefolgt von 95 oder 98
(?<=...)(positiver Lookbehind)
-
Entspricht einer Position, der ein bestimmtes Muster vorausgeht
-
Beispiel:
(?<=95|98)WindowsEntspricht "Windows", dem 95 oder 98 vorausgeht
(?<!...)(negatives Lookbehind)
-
Entspricht einer Position, der kein bestimmtes Muster vorausgeht
-
Beispiel:
(?<!95|98)WindowsEntspricht "Windows", dem weder 95 noch 98 vorausgeht
Beispiele
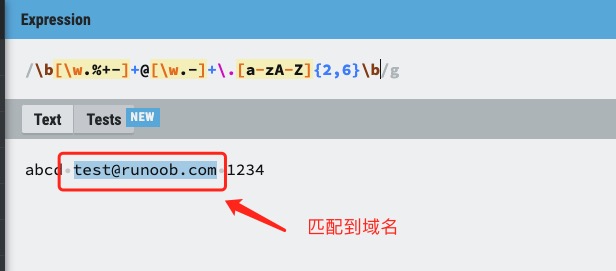
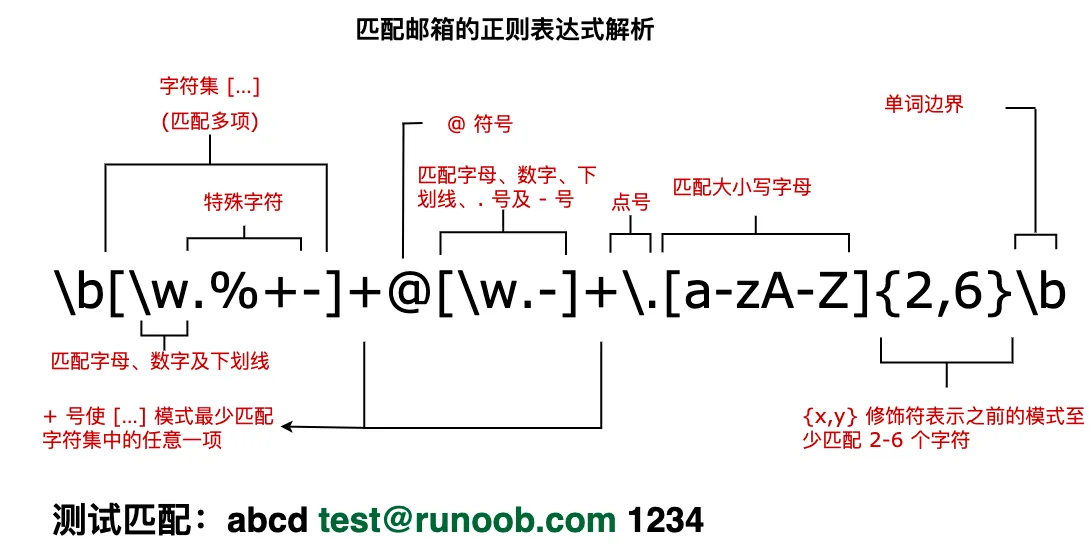
Als Nächstes analysieren wir einen regulären Ausdruck zum Abgleichen von E-Mail-Adressen, wie unten gezeigt:
Beispiele
Der unten markierte Text ist der Ausdruck mit den erhaltenen Übereinstimmungen:
test@example.com
Ausprobieren »
Die folgende Tabelle enthält eine vollständige Liste der Metazeichen und ihres Verhaltens im Kontext regulärer Ausdrücke:
| Zeichen | Beschreibung |
|---|---|
| \ | Markiert das nächste Zeichen als Sonderzeichen, ein literales Zeichen, eine Rückreferenz oder einen Oktal-Escape. Zum Beispiel entspricht 'n' dem Zeichen "n". '\n' entspricht einem Zeilenumbruch. Die Sequenz '\\' entspricht "\" und "\(" entspricht "(". |
| ^ | Entspricht dem Anfang der Eingabezeichenfolge. Wenn die Multiline-Eigenschaft des RegExp-Objekts gesetzt ist, stimmt ^ auch mit Positionen nach '\n' oder '\r' überein. |
| $ | Entspricht dem Ende der Eingabezeichenfolge. Wenn die Multiline-Eigenschaft des RegExp-Objekts gesetzt ist, stimmt $ auch mit Positionen vor '\n' oder '\r' überein. |
| * | Stimmt mit dem vorangehenden Teilausdruck null oder mehr Mal überein. Zum Beispiel kann zo* sowohl mit "z" als auch mit "zoo" übereinstimmen. * ist äquivalent zu {0,}. |
| + | Stimmt mit dem vorangehenden Teilausdruck ein oder mehr Mal überein. Zum Beispiel kann 'zo+' sowohl mit "zo" als auch mit "zoo" übereinstimmen, aber nicht mit "z". + ist äquivalent zu {1,}. |
| ? | Stimmt mit dem vorangehenden Teilausdruck null oder ein Mal überein. Zum Beispiel kann "do(es)?" mit "do" oder "does" übereinstimmen. ? ist äquivalent zu {0,1}. |
| {n} | n ist eine nichtnegative ganze Zahl. Stimmt genau n Mal überein. Zum Beispiel kann 'o{2}' nicht mit 'o' in "Bob" übereinstimmen, kann aber mit den beiden o's in "food" übereinstimmen. |
| {n,} | n ist eine nichtnegative ganze Zahl. Stimmt mindestens n Mal überein. Zum Beispiel kann 'o{2,}' nicht mit 'o' in "Bob" übereinstimmen, kann aber mit allen o's in "foooood" übereinstimmen. 'o{1,}' ist äquivalent zu 'o+'. 'o{0,}' ist äquivalent zu 'o*'. |
| {n,m} | m und n sind beide nichtnegative ganze Zahlen, wobei n <= m. Stimmt mindestens n Mal und höchstens m Mal überein. Zum Beispiel stimmt "o{1,3}" mit den ersten drei o's in "fooooood" überein. 'o{0,1}' ist äquivalent zu 'o?'. Beachten Sie, dass zwischen dem Komma und den beiden Zahlen keine Leerzeichen stehen dürfen. |
| ? | Wenn dieses Zeichen unmittelbar auf einen anderen Quantifizierer (*, +, ?, {n}, {n,}, {n,m}) folgt, ist der Übereinstimmungsmodus nicht gierig. Der nicht gierige Modus stimmt mit so wenig der durchsuchten Zeichenfolge wie möglich überein, während der standardmäßige gierige Modus mit so viel wie möglich übereinstimmt. Zum Beispiel stimmt für die Zeichenfolge "oooo" 'o+?' mit einem einzelnen "o" überein, während 'o+' mit allen 'o's übereinstimmt. |
| . | Stimmt mit jedem einzelnen Zeichen außer Zeilenumbruch (\n, \r) überein. Um mit jedem Zeichen einschließlich '\n' übereinzustimmen, verwenden Sie ein Muster wie das "(.|\n)"-Muster. |
| (pattern) | Muster abgleichen und diese Übereinstimmung abrufen. Die erhaltene Übereinstimmung kann aus der resultierenden Matches-Auflistung abgerufen werden, wobei in VBScript die SubMatches-Auflistung und in JScript die Eigenschaften $0…$9 verwendet werden. Um Klammerzeichen abzugleichen, verwenden Sie '\(' oder '\)'. |
| (?:pattern) | Entspricht dem Muster, erfasst jedoch nicht das Übereinstimmungsergebnis; das heißt, dies ist eine nicht erfassende Übereinstimmung, die nicht für die spätere Verwendung gespeichert wird. Dies ist nützlich, wenn das Zeichen "oder" (|) verwendet wird, um Teile eines Musters zu kombinieren. Zum Beispiel ist 'industr(?:y|ies)' ein prägnanterer Ausdruck als 'industry|industries'. |
| (?=pattern) | Positive Lookahead-Assertion. Entspricht der Suchzeichenfolge am Anfang jeder Zeichenfolge, die dem Muster entspricht. Dies ist eine nicht erfassende Übereinstimmung; das heißt, die Übereinstimmung muss nicht für die spätere Verwendung erfasst werden. Beispielsweise entspricht "Windows(?=95|98|NT|2000)" dem "Windows" in "Windows2000", kann jedoch nicht dem "Windows" in "Windows3.1" entsprechen. Lookahead verbraucht keine Zeichen; das heißt, nachdem eine Übereinstimmung aufgetreten ist, beginnt die Suche nach der nächsten Übereinstimmung unmittelbar nach der letzten Übereinstimmung, nicht nach den im Lookahead enthaltenen Zeichen. |
| (?!pattern) | Negative Lookahead-Assertion. Entspricht der Suchzeichenfolge am Anfang jeder Zeichenfolge, die nicht dem Muster entspricht. Dies ist eine nicht erfassende Übereinstimmung; das heißt, die Übereinstimmung muss nicht für die spätere Verwendung erfasst werden. Beispielsweise entspricht "Windows(?!95|98|NT|2000)" dem "Windows" in "Windows3.1", kann jedoch nicht dem "Windows" in "Windows2000" entsprechen. Lookahead verbraucht keine Zeichen; das heißt, nachdem eine Übereinstimmung aufgetreten ist, beginnt die Suche nach der nächsten Übereinstimmung unmittelbar nach der letzten Übereinstimmung, nicht nach den im Lookahead enthaltenen Zeichen. |
| (?<=pattern) | Positive Lookbehind-Assertion, ähnlich der positiven Lookahead-Assertion, außer dass die Richtung entgegengesetzt ist. Zum Beispiel, "(?<=95|98|NT|2000)Windows"kann übereinstimmen"2000Windows"in"Windows", kann aber nicht übereinstimmen"3.1Windows"in"Windows"。 |
| (?<!pattern) | Negative Lookbehind-Assertion, ähnlich der negativen Lookahead-Assertion, außer dass die Richtung entgegengesetzt ist. Zum Beispiel(?<!95|98|NT|2000)Windows"kann übereinstimmen"3.1Windows"in"Windows", kann aber nicht übereinstimmen"2000Windows"in"Windows"。 |
| x|y | Entspricht x oder y. Beispielsweise kann 'z|food' "z" oder "food" entsprechen. '(z|f)ood' entspricht "zood" oder "food". |
| [xyz] | Zeichensatz. Entspricht einem beliebigen der enthaltenen Zeichen. Zum Beispiel kann '[abc]' mit 'a' in "plain" übereinstimmen. |
| [^xyz] | Negierter Zeichensatz. Entspricht jedem nicht enthaltenen Zeichen. Zum Beispiel kann '[^abc]' mit 'p', 'l', 'i', 'n' in "plain" übereinstimmen. |
| [a-z] | Zeichenbereich. Entspricht jedem Zeichen innerhalb des angegebenen Bereichs. Zum Beispiel kann '[a-z]' mit jedem Kleinbuchstaben im Bereich 'a' bis 'z' übereinstimmen. |
| [^a-z] | Negierter Zeichenbereich. Entspricht jedem Zeichen, das nicht innerhalb des angegebenen Bereichs liegt. Zum Beispiel entspricht '[^a-z]' jedem Zeichen, das nicht im Bereich 'a' bis 'z' liegt. |
| \b | Entspricht einer Wortgrenze, also der Position zwischen einem Wort und einem Leerzeichen. Zum Beispiel kann 'er\b' mit 'er' in "never" übereinstimmen, aber nicht mit 'er' in "verb". |
| \B | Entspricht einer Nicht-Wortgrenze. 'er\B' kann mit 'er' in "verb" übereinstimmen, aber nicht mit 'er' in "never". |
| \cx | Entspricht einem durch x angegebenen Steuerzeichen. Zum Beispiel entspricht \cM einem Control-M oder Wagenrücklauf. Der Wert von x muss eines von A-Z oder a-z sein. Andernfalls wird c als literales Zeichen 'c' behandelt. |
| \d | Entspricht einem Ziffernzeichen. Äquivalent zu [0-9]. |
| \D | Entspricht einem Nicht-Ziffernzeichen. Äquivalent zu [^0-9]. |
| \f | Entspricht einem Seitenvorschubzeichen. Äquivalent zu \x0c und \cL. |
| \n | Entspricht einem Zeilenumbruchzeichen. Äquivalent zu \x0a und \cJ. |
| \r | Entspricht einem Wagenrücklaufzeichen. Äquivalent zu \x0d und \cM. |
| \s | Entspricht jedem Leerraumzeichen, einschließlich Leerzeichen, Tabulator, Seitenvorschub usw. Äquivalent zu [ \f\n\r\t\v]. |
| \S | Entspricht jedem Nicht-Leerraumzeichen. Äquivalent zu [^ \f\n\r\t\v]. |
| \t | Entspricht einem Tabulatorzeichen. Äquivalent zu \x09 und \cI. |
| \v | Entspricht einem vertikalen Tabulatorzeichen. Äquivalent zu \x0b und \cK. |
| \w | Entspricht Buchstaben, Ziffern und Unterstrichen. Äquivalent zu '[A-Za-z0-9_]'. |
| \W | Entspricht Zeichen, die keine Buchstaben, Ziffern oder Unterstriche sind. Äquivalent zu '[^A-Za-z0-9_]'. |
| \xn | Entspricht n, wobei n ein hexadezimaler Escape-Wert ist. Der hexadezimale Escape-Wert muss genau zwei Ziffern lang sein. Zum Beispiel entspricht '\x41' "A". '\x041' ist äquivalent zu '\x04' & "1". ASCII-Kodierung kann in regulären Ausdrücken verwendet werden. |
| \num | Entspricht num, wobei num eine positive ganze Zahl ist. Eine Rückreferenz auf eine erfasste Übereinstimmung. Zum Beispiel entspricht '(.)\1' zwei aufeinanderfolgenden identischen Zeichen. |
| \n | Identifiziert einen oktalen Escape-Wert oder eine Rückreferenz. Wenn vor \n mindestens n erfasste Teilausdrücke stehen, dann ist n eine Rückreferenz. Andernfalls, wenn n eine Oktalziffer (0-7) ist, dann ist n ein oktaler Escape-Wert. |
| \nm | Identifiziert einen oktalen Escape-Wert oder eine Rückreferenz. Wenn vor \nm mindestens nm erfasste Teilausdrücke stehen, dann ist nm eine Rückreferenz. Wenn vor \nm mindestens n Erfassungen stehen, dann ist n eine Rückreferenz, gefolgt von wörtlichem m. Wenn keine der vorhergehenden Bedingungen erfüllt ist und n und m beide Oktalziffern (0-7) sind, dann entspricht \nm dem oktalen Escape-Wert nm. |
| \nml | Wenn n eine Oktalziffer (0-3) ist und m und l beide Oktalziffern (0-7) sind, dann entspricht dies dem Oktal-Escape-Wert nml. |
| \un | Entspricht n, wobei n ein Unicode-Zeichen ist, das durch vier Hexadezimalziffern dargestellt wird. Zum Beispiel entspricht \u00A9 dem Copyright-Symbol (?). |