Exemple PyTorch - Projet d'analyse de sentiments textuels
L'analyse de sentiments textuels est une tâche fondamentale du traitement du langage naturel (NLP), qui vise à déterminer l'orientation des sentiments (positive/négative) exprimée dans un texte. Ce projet utilisera PyTorch pour construire un modèle d'apprentissage profond afin de réaliser une classification des sentiments des critiques de films.
Scénarios d'application de l'analyse de sentiments
- Analyse des avis sur les produits
- Surveillance de l'opinion publique sur les réseaux sociaux
- Classification des retours du service client
- Prédiction des tendances du marché
Préparation de l’environnement
Outils et bibliothèques requis
Exemple
import torch
import torch.nn as nn
import torch.optim as optim
from torchtext.data import Field, TabularDataset, BucketIterator
import spacy
import numpy as np
import torch.nn as nn
import torch.optim as optim
from torchtext.data import Field, TabularDataset, BucketIterator
import spacy
import numpy as np
Installer les dépendances
pip install torch torchtext spacy
python -m spacy download en_core_web_sm
Préparation des données
Introduction au jeu de données
Utilisez le jeu de données d'avis de films IMDB, contenant 50,000 avis avec des étiquettes de sentiment (positif/négatif).
Prétraitement des données
Exemple
# Définir le traitement des champs
TEXT = Field(tokenize='spacy',
tokenizer_language='en_core_web_sm',
include_lengths=True)
LABEL = Field(sequential=False, use_vocab=False)
# Charger le jeu de données
train_data, test_data = TabularDataset.splits(
path='./data',
train='train.csv',
test='test.csv',
format='csv',
fields=[('text', TEXT), ('label', LABEL)]
)
# Construire le vocabulaire
TEXT.build_vocab(train_data,
max_size=25000,
vectors="glove.6B.100d")
TEXT = Field(tokenize='spacy',
tokenizer_language='en_core_web_sm',
include_lengths=True)
LABEL = Field(sequential=False, use_vocab=False)
# Charger le jeu de données
train_data, test_data = TabularDataset.splits(
path='./data',
train='train.csv',
test='test.csv',
format='csv',
fields=[('text', TEXT), ('label', LABEL)]
)
# Construire le vocabulaire
TEXT.build_vocab(train_data,
max_size=25000,
vectors="glove.6B.100d")
Modèle
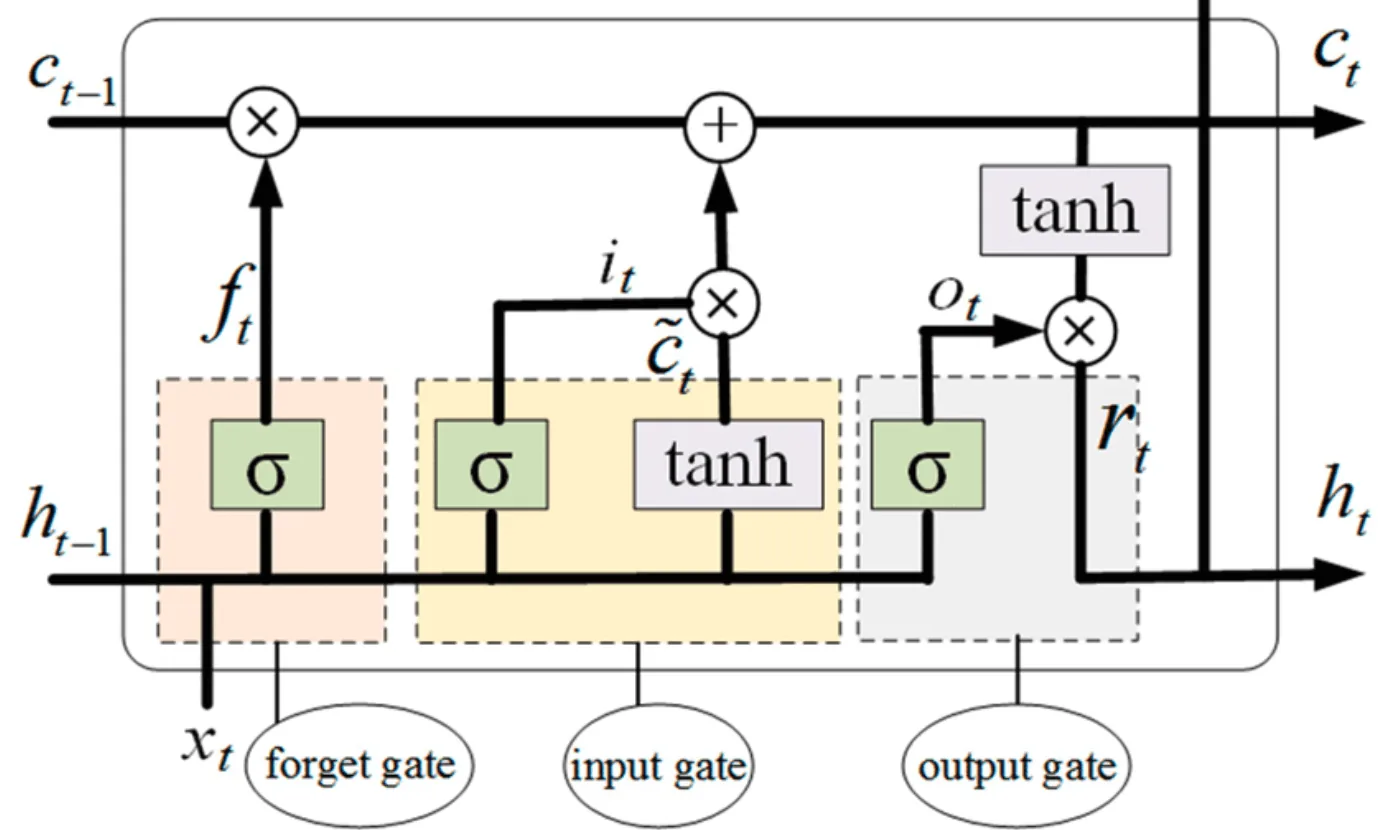
Architecture du modèle LSTM
4.2 Code d'implémentation du modèle
Exemple
class SentimentLSTM(nn.Module):
def __init__(self, vocab_size, embedding_dim, hidden_dim, output_dim, n_layers):
super().__init__()
self.embedding = nn.Embedding(vocab_size, embedding_dim)
self.lstm = nn.LSTM(embedding_dim,
hidden_dim,
num_layers=n_layers,
bidirectional=True)
self.fc = nn.Linear(hidden_dim * 2, output_dim)
self.dropout = nn.Dropout(0.5)
def forward(self, text, text_lengths):
embedded = self.dropout(self.embedding(text))
packed_embedded = nn.utils.rnn.pack_padded_sequence(
embedded, text_lengths.to('cpu'))
packed_output, (hidden, cell) = self.lstm(packed_embedded)
hidden = self.dropout(torch.cat((hidden[-2,:,:], hidden[-1,:,:]), dim=1))
return self.fc(hidden)
def __init__(self, vocab_size, embedding_dim, hidden_dim, output_dim, n_layers):
super().__init__()
self.embedding = nn.Embedding(vocab_size, embedding_dim)
self.lstm = nn.LSTM(embedding_dim,
hidden_dim,
num_layers=n_layers,
bidirectional=True)
self.fc = nn.Linear(hidden_dim * 2, output_dim)
self.dropout = nn.Dropout(0.5)
def forward(self, text, text_lengths):
embedded = self.dropout(self.embedding(text))
packed_embedded = nn.utils.rnn.pack_padded_sequence(
embedded, text_lengths.to('cpu'))
packed_output, (hidden, cell) = self.lstm(packed_embedded)
hidden = self.dropout(torch.cat((hidden[-2,:,:], hidden[-1,:,:]), dim=1))
return self.fc(hidden)
Entraînement du modèle
Paramètres d'entraînement
Exemple
# Paramètres du modèle
INPUT_DIM = len(TEXT.vocab)
EMBEDDING_DIM = 100
HIDDEN_DIM = 256
OUTPUT_DIM = 1
N_LAYERS = 2
# Initialiser le modèle
model = SentimentLSTM(INPUT_DIM, EMBEDDING_DIM, HIDDEN_DIM, OUTPUT_DIM, N_LAYERS)
# Optimiseur et fonction de perte
optimizer = optim.Adam(model.parameters())
criterion = nn.BCEWithLogitsLoss()
INPUT_DIM = len(TEXT.vocab)
EMBEDDING_DIM = 100
HIDDEN_DIM = 256
OUTPUT_DIM = 1
N_LAYERS = 2
# Initialiser le modèle
model = SentimentLSTM(INPUT_DIM, EMBEDDING_DIM, HIDDEN_DIM, OUTPUT_DIM, N_LAYERS)
# Optimiseur et fonction de perte
optimizer = optim.Adam(model.parameters())
criterion = nn.BCEWithLogitsLoss()
Boucle d'entraînement
Exemple
def train(model, iterator, optimizer, criterion):
epoch_loss = 0
epoch_acc = 0
model.train()
for batch in iterator:
text, text_lengths = batch.text
predictions = model(text, text_lengths).squeeze(1)
loss = criterion(predictions, batch.label)
optimizer.zero_grad()
loss.backward()
optimizer.step()
epoch_loss += loss.item()
epoch_acc += accuracy(predictions, batch.label)
return epoch_loss / len(iterator), epoch_acc / len(itérateur)
epoch_loss = 0
epoch_acc = 0
model.train()
for batch in iterator:
text, text_lengths = batch.text
predictions = model(text, text_lengths).squeeze(1)
loss = criterion(predictions, batch.label)
optimizer.zero_grad()
loss.backward()
optimizer.step()
epoch_loss += loss.item()
epoch_acc += accuracy(predictions, batch.label)
return epoch_loss / len(iterator), epoch_acc / len(itérateur)
Évaluation du modèle
Fonction d'évaluation
Exemple
def evaluate(model, iterator, criterion):
epoch_loss = 0
epoch_acc = 0
model.eval()
with torch.no_grad():
for batch in iterator:
text, text_lengths = batch.text
predictions = model(text, text_lengths).squeeze(1)
loss = criterion(predictions, batch.label)
epoch_loss += loss.item()
epoch_acc += accuracy(predictions, batch.label)
return epoch_loss / len(iterator), epoch_acc / len(itérateur)
epoch_loss = 0
epoch_acc = 0
model.eval()
with torch.no_grad():
for batch in iterator:
text, text_lengths = batch.text
predictions = model(text, text_lengths).squeeze(1)
loss = criterion(predictions, batch.label)
epoch_loss += loss.item()
epoch_acc += accuracy(predictions, batch.label)
return epoch_loss / len(iterator), epoch_acc / len(itérateur)
Calcul de précision
Exemple
def accuracy(preds, y):
rounded_preds = torch.round(torch.sigmoid(preds))
correct = (rounded_preds == y).float()
acc = correct.sum() / len(correct)
return acc
rounded_preds = torch.round(torch.sigmoid(preds))
correct = (rounded_preds == y).float()
acc = correct.sum() / len(correct)
return acc
Application du modèle
Prédire un nouveau texte
Exemple
def predict_sentiment(model, sentence):
tokenized = [tok.text for tok in nlp.tokenizer(sentence)]
indexed = [TEXT.vocab.stoi[t] for t in tokenized]
length = [len(indexed)]
tensor = torch.LongTensor(indexé).vers(device)
tensor = tensor.unsqueeze(1)
length_tensor = torch.LongTensor(length)
prediction = torch.sigmoid(model(tensor, length_tensor))
return prediction.item()
tokenized = [tok.text for tok in nlp.tokenizer(sentence)]
indexed = [TEXT.vocab.stoi[t] for t in tokenized]
length = [len(indexed)]
tensor = torch.LongTensor(indexé).vers(device)
tensor = tensor.unsqueeze(1)
length_tensor = torch.LongTensor(length)
prediction = torch.sigmoid(model(tensor, length_tensor))
return prediction.item()
Exemple de prédiction
Exemple
positive_review = "Ce film était fantastique ! Je l'ai vraiment apprécié."
negative_review = "Le film était terrible et ennuyeux."
print(f"Score de l'avis positif : {predict_sentiment(model, positive_review):.4f}")
print(f"Score de l'avis négatif : {predict_sentiment(model, negative_review):.4f}")
negative_review = "Le film était terrible et ennuyeux."
print(f"Score de l'avis positif : {predict_sentiment(model, positive_review):.4f}")
print(f"Score de l'avis négatif : {predict_sentiment(model, negative_review):.4f}")