Construction d'un modèle Transformer avec PyTorch
Le Transformer est l'un des modèles les plus puissants de l'apprentissage automatique moderne.
Le modèle Transformer est une architecture d'apprentissage profond basée sur le mécanisme d'auto-attention. Il a révolutionné le domaine du traitement du langage naturel (NLP) et est devenu le fondement de modèles d'apprentissage profond modernes tels que BERT, GPT, etc.
Transformer est une architecture centrale dans le NLP moderne. Grâce à sa puissante capacité de modélisation des dépendances à longue distance et à ses avantages en calcul parallèle efficace, il surpasse les réseaux traditionnels de type Long Short-Term Memory (LSTM) dans des tâches telles que la traduction de langues et le résumé de texte.
Si vous ne comprenez pas encore Transformer, vous pouvez vous référer à :Introduction au modèle Transformer。
Construire un modèle Transformer avec PyTorch
Les étapes pour construire un modèle Transformer sont les suivantes :
1. Importer les bibliothèques et modules nécessaires
Importer la bibliothèque principale PyTorch, le module de réseaux de neurones, le module d'optimisation, les outils de traitement des données, ainsi que les modules mathématiques et de copie d'objets pour fournir un support à la définition de l'architecture du modèle, à la gestion des données et au processus d'entraînement.
import torch
import torch.nn as nn
import torch.optim as optim
import torch.utils.data as data
import math
import copy
Description:
torch: Bibliothèque principale de PyTorch, utilisée pour les opérations sur les tenseurs et la différenciation automatique.torch.nn: Module de réseaux de neurones de PyTorch, contenant diverses couches et fonctions de perte.torch.optim: Module d'algorithmes d'optimisation, tels que Adam, SGD, etc.math: Bibliothèque de fonctions mathématiques, utilisée pour calculer des racines carrées, etc.copy: Utilisé pour la copie profonde d'objets.
Définir les briques de base : attention multi-têtes, réseau feed-forward position-wise, encodage positionnel
Attention multi-têtesEn calculant la relation entre chaque paire de positions dans la séquence via plusieurs "têtes d'attention", elle peut capturer différentes caractéristiques et motifs de la séquence d'entrée.
La classe MultiHeadAttention encapsule le mécanisme d'attention multi-têtes couramment utilisé dans les modèles Transformer. Elle est responsable de diviser l'entrée en plusieurs têtes d'attention, d'appliquer l'attention à chaque tête, puis de combiner les résultats, afin que le modèle puisse capturer diverses relations dans les données d'entrée à différentes échelles et améliorer son pouvoir expressif.
Exemple
def __init__(self, d_model, num_heads):
super(MultiHeadAttention, self).__init__()
assert d_model % num_heads == 0, "d_model doit être divisible par num_heads"
self.d_model = d_model # Dimension du modèle (par ex., 512)
self.num_heads = num_heads # Nombre de têtes d'attention (par ex., 8)
self.d_k = d_model // num_heads # Dimension de chaque tête (par ex., 64)
# Définir les couches de transformation linéaire (sans biais)
self.W_q = nn.Linear(d_model, d_model) # Transformation de requête
self.W_k = nn.Linear(d_model, d_model) # Transformation de clé
self.W_v = nn.Linear(d_model, d_model) # Transformation de valeur
self.W_o = nn.Linear(d_model, d_model) # Transformation de sortie
def scaled_dot_product_attention(self, Q, K, V, mask=Aucune):
"""
Calculer l'attention par produit scalaire mise à l'échelle
Forme d'entrée :
Q : (batch_size, num_heads, seq_length, d_k)
K, V : identiques à Q
Forme de sortie : (batch_size, num_heads, seq_length, d_k)
"""
# Calculer les scores d'attention (produit scalaire de Q et K)
attn_scores = torch.matmul(Q, K.transpose(-2, -1)) / math.sqrt(self.d_k)
# Appliquer le masque (par exemple, masque de padding ou masque d'information future)
if mask is not None:
attn_scores = attn_scores.masked_fill(mask == 0, -1e9)
# Calculer les poids d'attention (normalisation softmax)
attn_probs = torch.softmax(attn_scores, dim=-1)
# Somme pondérée des vecteurs de valeur
output = torch.matmul(attn_probs, V)
return output
def split_heads(self, x):
"""
Diviser le tenseur d’entrée en plusieurs têtes
Forme d’entrée : (batch_size, seq_length, d_model)
Forme de sortie : (batch_size, num_heads, seq_length, d_k)
"""
batch_size, seq_length, d_model = x.size()
return x.view(batch_size, seq_length, self.num_heads, self.d_k).transpose(1, 2)
def combine_heads(self, x):
"""
Fusionner les sorties de plusieurs têtes pour revenir à la forme d’origine
Forme d’entrée : (batch_size, num_heads, seq_length, d_k)
Forme de sortie : (batch_size, seq_length, d_model)
"""
batch_size, _, seq_length, d_k = x.size()
return x.transpose(1, 2).contiguous().view(batch_size, seq_length, self.d_model)
def forward(self, Q, K, V, mask=Aucune):
"""
Propagation avant
Forme d'entrée : Q/K/V : (batch_size, seq_length, d_model)
Forme de sortie : (batch_size, seq_length, d_model)
"""
# Transformation linéaire et découpage en plusieurs têtes
Q = self.split_heads(self.W_q(Q)) # (batch, heads, seq_len, d_k)
K = self.split_heads(self.W_k(K))
V = self.split_heads(self.W_v(V))
# Calcul de l'attention
attn_output = self.scaled_dot_product_attention(Q, K, V, mask)
# Fusionner les têtes et appliquer la transformation de sortie
output = self.W_o(self.combine_heads(attn_output))
return output
Description:
Mécanisme d'attention multi-têtes: Diviser l'entrée en plusieurs têtes, chaque tête calcule l'attention indépendamment, et enfin fusionner les résultats.
Attention par produit scalaire mise à l'échelle: Calculer le produit scalaire des requêtes et des clés, le mettre à l'échelle, utiliser softmax pour calculer les poids d'attention, et enfin effectuer une somme pondérée des valeurs.
Mask: Utilisé pour masquer les positions invalides (par exemple, les parties de remplissage).
Réseau feed-forward positionnel
Exemple
def __init__(self, d_model, d_ff):
super(PositionWiseFeedForward, self).__init__()
self.fc1 = nn.Linear(d_model, d_ff) # Première couche entièrement connectée
self.fc2 = nn.Linear(d_ff, d_model) # Deuxième couche entièrement connectée
self.relu = nn.ReLU() # Fonction d'activation
def forward(self, x):
# Calcul du réseau feed-forward
return self.fc2(self.relu(self.fc1(x)))
Réseau feed-forward :Il se compose de deux couches entièrement connectées et d'une fonction d'activation ReLU, utilisée pour traiter davantage la sortie du mécanisme d'attention.
Encodage positionnel
L'encodage positionnel est utilisé pour injecter les informations de position de chaque token dans la séquence d'entrée.
Utiliser des fonctions sinus et cosinus de différentes fréquences pour générer les encodages positionnels.
Exemple
def __init__(self, d_model, max_seq_length):
super(PositionalEncoding, self).__init__()
pe = torch.zeros(max_seq_length, d_model) # Initialiser la matrice d'encodage positionnel
position = torch.arange(0, max_seq_length, dtype=torch.float).unsqueeze(1)
div_term = torch.exp(torch.arange(0, d_model, 2).float() * -(math.log(10000.0) / d_model))
pe[:, 0::2] = torch.sin(position * div_term) # Utiliser la fonction sinus pour les positions paires
pe[:, 1::2] = torch.cos(position * div_term) # Utiliser la fonction cosinus pour les positions impaires
self.register_buffer('pe', pe.unsqueeze(0)) # Enregistrer comme buffer
def forward(self, x):
# Ajouter l'encodage positionnel à l'entrée
return x + self.pe[:, :x.size(1)]
Construire le bloc encodeur (couche d'encodeur)
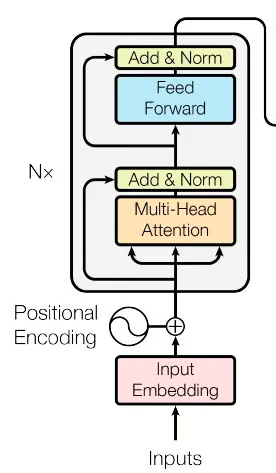
Couche encodeur :Contient un mécanisme d'auto-attention et un réseau feed-forward, chaque sous-couche étant suivie de connexions résiduelles et d'une normalisation de couche.
Exemple
def __init__(self, d_model, num_heads, d_ff, dropout):
super(EncoderLayer, self).__init__()
self.self_attn = MultiHeadAttention(d_model, num_heads) # Mécanisme d'auto-attention
self.feed_forward = PositionWiseFeedForward(d_model, d_ff) # Réseau feed-forward
self.norm1 = nn.LayerNorm(d_model) # Normalisation de couche
self.norm2 = nn.LayerNorm(d_model)
self.dropout = nn.Dropout(dropout) # Dropout
def forward(self, x, mask):
# Mécanisme d'auto-attention
attn_output = self.self_attn(x, x, x, mask)
x = self.norm1(x + self.dropout(attn_output)) # Connexion résiduelle et normalisation de couche
# Réseau de propagation avant
ff_output = self.feed_forward(x)
x = self.norm2(x + self.dropout(ff_output)) # Connexion résiduelle et normalisation de couche
return x
Construire le module décodeur

Couche de décodeur :Contient un mécanisme d'auto-attention, un mécanisme d'attention croisée et un réseau feed-forward, chaque sous-couche étant suivie de connexions résiduelles et d'une normalisation de couche.
Exemple
def __init__(self, d_model, num_heads, d_ff, dropout):
super(DecoderLayer, self).__init__()
self.self_attn = MultiHeadAttention(d_model, num_heads) # Mécanisme d'auto-attention
self.cross_attn = MultiHeadAttention(d_model, num_heads) # Mécanisme d'attention croisée
self.feed_forward = PositionWiseFeedForward(d_model, d_ff) # Réseau feed-forward
self.norm1 = nn.LayerNorm(d_model) # Normalisation de couche
self.norm2 = nn.LayerNorm(d_model)
self.norm3 = nn.LayerNorm(d_model)
self.dropout = nn.Dropout(dropout) # Dropout
def forward(self, x, enc_output, src_mask, tgt_mask):
# Mécanisme d'auto-attention
attn_output = self.self_attn(x, x, x, tgt_mask)
x = self.norm1(x + self.dropout(attn_output)) # Connexion résiduelle et normalisation de couche
# Mécanisme d'attention croisée
attn_output = self.cross_attn(x, enc_output, enc_output, src_mask)
x = self.norm2(x + self.dropout(attn_output)) # Connexion résiduelle et normalisation de couche
# Réseau de propagation avant
ff_output = self.feed_forward(x)
x = self.norm3(x + self.dropout(ff_output)) # Connexion résiduelle et normalisation de couche
return x
Construire le modèle Transformer complet

Exemple
def __init__(self, src_vocab_size, tgt_vocab_size, d_model, num_heads, num_layers, d_ff, max_seq_length, dropout):
super(Transformer, self).__init__()
self.encoder_embedding = nn.Embedding(src_vocab_size, d_model) # Plongement de mots de l'encodeur
self.decoder_embedding = nn.Embedding(tgt_vocab_size, d_model) # Plongement de mots du décodeur
self.positional_encoding = PositionalEncoding(d_model, max_seq_length) # Encodage positionnel
# Couches d'encodeur et de décodeur
self.encoder_layers = nn.ModuleList([EncoderLayer(d_model, num_heads, d_ff, dropout) for _ in range(num_layers)])
self.decoder_layers = nn.ModuleList([DecoderLayer(d_model, num_heads, d_ff, dropout) for _ in range(num_layers)])
self.fc = nn.Linear(d_model, tgt_vocab_size) # Couche finale entièrement connectée
self.dropout = nn.Dropout(dropout) # Dropout
def generate_mask(self, src, tgt):
# Masque source : masquer les jetons de remplissage (on suppose que l'indice de remplissage est 0)
# Forme : (batch_size, 1, 1, seq_length)
src_mask = (src != 0).unsqueeze(1).unsqueeze(2)
# Masque cible : masquer les jetons de remplissage et les informations futures
# Forme : (batch_size, 1, seq_length, 1)
tgt_mask = (tgt != 0).unsqueeze(1).unsqueeze(3)
seq_length = tgt.size(1)
# Générer un masque matriciel triangulaire supérieur pour empêcher de voir les informations futures pendant le décodage
nopeak_mask = (1 - torch.triu(torch.ones(1, seq_length, seq_length), diagonal=1)).bool()
tgt_mask = tgt_mask & nopeak_mask # Combiner le masque de remplissage et le masque d'informations futures
return src_mask, tgt_mask
def forward(self, src, tgt):
# Générer les masques
src_mask, tgt_mask = self.generate_mask(src, tgt)
# Partie encodeur
src_embedded = self.dropout(self.positional_encoding(self.encoder_embedding(src)))
enc_output = src_embedded
for enc_layer in self.encoder_layers:
enc_output = enc_layer(enc_output, src_mask)
# Partie décodeur
tgt_embedded = self.dropout(self.positional_encoding(self.decoder_embedding(tgt)))
dec_output = tgt_embedded
for dec_layer in self.decoder_layers:
dec_output = dec_layer(dec_output, enc_output, src_mask, tgt_mask)
# Sortie finale
output = self.fc(dec_output)
return output
Description:
Modèle TransformerContient des parties encodeur et décodeur, chacune composée de plusieurs couches empilées.
Génération de masqueSert à masquer les positions invalides et les informations futures.
Propagation avantTraverse l'encodeur et le décodeur en séquence, puis produit finalement la sortie via une couche entièrement connectée.
Description des paramètres d'initialisation du modèle :
class Transformer(nn.Module):
    def __init__(
        self,
        src_vocab_size,  # 源语言词汇表大小(如英文单词数)
        tgt_vocab_size,  # 目标语言词汇表大小(如中文单词数)
        d_model=512,     # 模型维度(每个词向量的长度)
        num_heads=8,     # 多头注意力的头数
        num_layers=6,    # 编码器/解码器的堆叠层数
        d_ff=2048,       # 前馈网络隐藏层维度
        max_seq_length=100, # 最大序列长度(用于位置编码)
        dropout=0.1      # Dropout概率
    ):
Entraîner le modèle Transformer PyTorch
Utiliser des données aléatoires pour entraîner le modèle, calculer la perte et mettre à jour les paramètres.
Exemple
src_vocab_size = 5000 # Taille du vocabulaire source
tgt_vocab_size = 5000 # Taille du vocabulaire cible
d_model = 512 # Dimension du modèle
num_heads = 8 # Nombre de têtes d'attention
num_layers = 6 # Nombre de couches d'encodeur et de décodeur
d_ff = 2048 # Dimension interne du réseau feed-forward
max_seq_length = 100 # Longueur maximale de séquence
dropout = 0.1 # Probabilité de dropout
# Initialiser le modèle
transformer = Transformer(src_vocab_size, tgt_vocab_size, d_model, num_heads, num_layers, d_ff, max_seq_length, dropout)
# Générer des données aléatoires
src_data = torch.randint(1, src_vocab_size, (64, max_seq_length)) # Séquence source
tgt_data = torch.randint(1, tgt_vocab_size, (64, max_seq_length)) # Séquence cible
# Définir la fonction de perte et l'optimiseur
criterion = nn.CrossEntropyLoss(ignore_index=0) # Ignorer la perte de la partie de remplissage
optimizer = optim.Adam(transformer.parameters(), lr=0.0001, betas=(0.9, 0.98), eps=1e-9)
# Boucle d'entraînement
transformer.train()
for epoch in range(100):
optimizer.zero_grad() # Effacer les gradients pour éviter l'accumulation
# Supprimer le dernier mot lors de la saisie de la séquence cible (utilisé pour prédire le mot suivant)
output = transformer(src_data, tgt_data[:, :-1])
# Lors du calcul de la perte, la séquence cible commence à partir du deuxième mot (c'est-à-dire prédire le mot suivant)
# Forme de sortie : (batch_size, seq_length-1, tgt_vocab_size)
# Forme de la cible : (batch_size, seq_length-1)
loss = criterion(
output.contiguous().view(-1, tgt_vocab_size),
tgt_data[:, 1:].contiguous().view(-1)
)
loss.backward() # Rétropropagation
optimizer.step() # Mettre à jour les paramètres
print(f"Époque : {epoch+1}, Perte : {loss.item()}")
Évaluation du modèle
Processus d'évaluation :Calculer la perte sur les données de validation pour évaluer la performance du modèle.
Exemple
# Générer des données de validation
val_src_data = torch.randint(1, src_vocab_size, (64, max_seq_length))
val_tgt_data = torch.randint(1, tgt_vocab_size, (64, max_seq_length))
# Supposons que l'entrée soit un lot de phrases anglaises et leurs traductions chinoises correspondantes (converties en indices)
# Exemple de données :
# src_data: [[3, 14, 25, ..., 0, 0], ...] # Phrases anglaises (0 est le jeton de remplissage)
# tgt_data: [[5, 20, 36, ..., 0, 0], ...] # Traductions chinoises (0 est le jeton de remplissage)
# Remarque : Dans les applications pratiques, le texte nécessite un prétraitement tel que la tokenisation, l'encodage et le remplissage
with torch.no_grad():
val_output = transformer(val_src_data, val_tgt_data[:, :-1])
val_loss = criterion(val_output.contiguous().view(-1, tgt_vocab_size), val_tgt_data[:, 1:].contiguous().vue(-1))
print(f"Perte de validation : {val_loss.item()}")