Ingénierie des boucles
Loop Engineering est un nouveau concept qui s'est rapidement répandu dans la communauté de la programmation en IA en juin 2026. Il a été systématiquement organisé par l'ingénieur Google Addy Osmani, et le responsable d'Anthropic Claude Code Boris Cherny ainsi que le développeur Peter Steinberger ont tous deux publiquement avancé le même point de vue.
Cet article vous guidera de zéro pour comprendre ce qu'est le Loop Engineering, ses différences essentielles avec le Prompt Engineering, les six éléments clés qui constituent un Agent Loop complet, et comment concevoir votre première Loop exécutable.
L'évolution de l'ingénierie de l'IA
Au cours des deux dernières années, le centre d'intérêt du développement de l'IA n'a cessé de se déplacer : de la recherche sur la manière d'écrire de bons prompts, en évoluant progressivement vers l'organisation du contexte et l'orchestration des outils et des workflows (Harness), puis vers la construction de systèmes de boucle (Loop) capables de fonctionner de manière autonome et de produire des résultats en continu.
Prompt:怎么问 AI
↓
Context:给 AI 什么信息
↓
Harness:如何组织 AI 的能力
↓
Loop:如何让 AI 持续创造结果
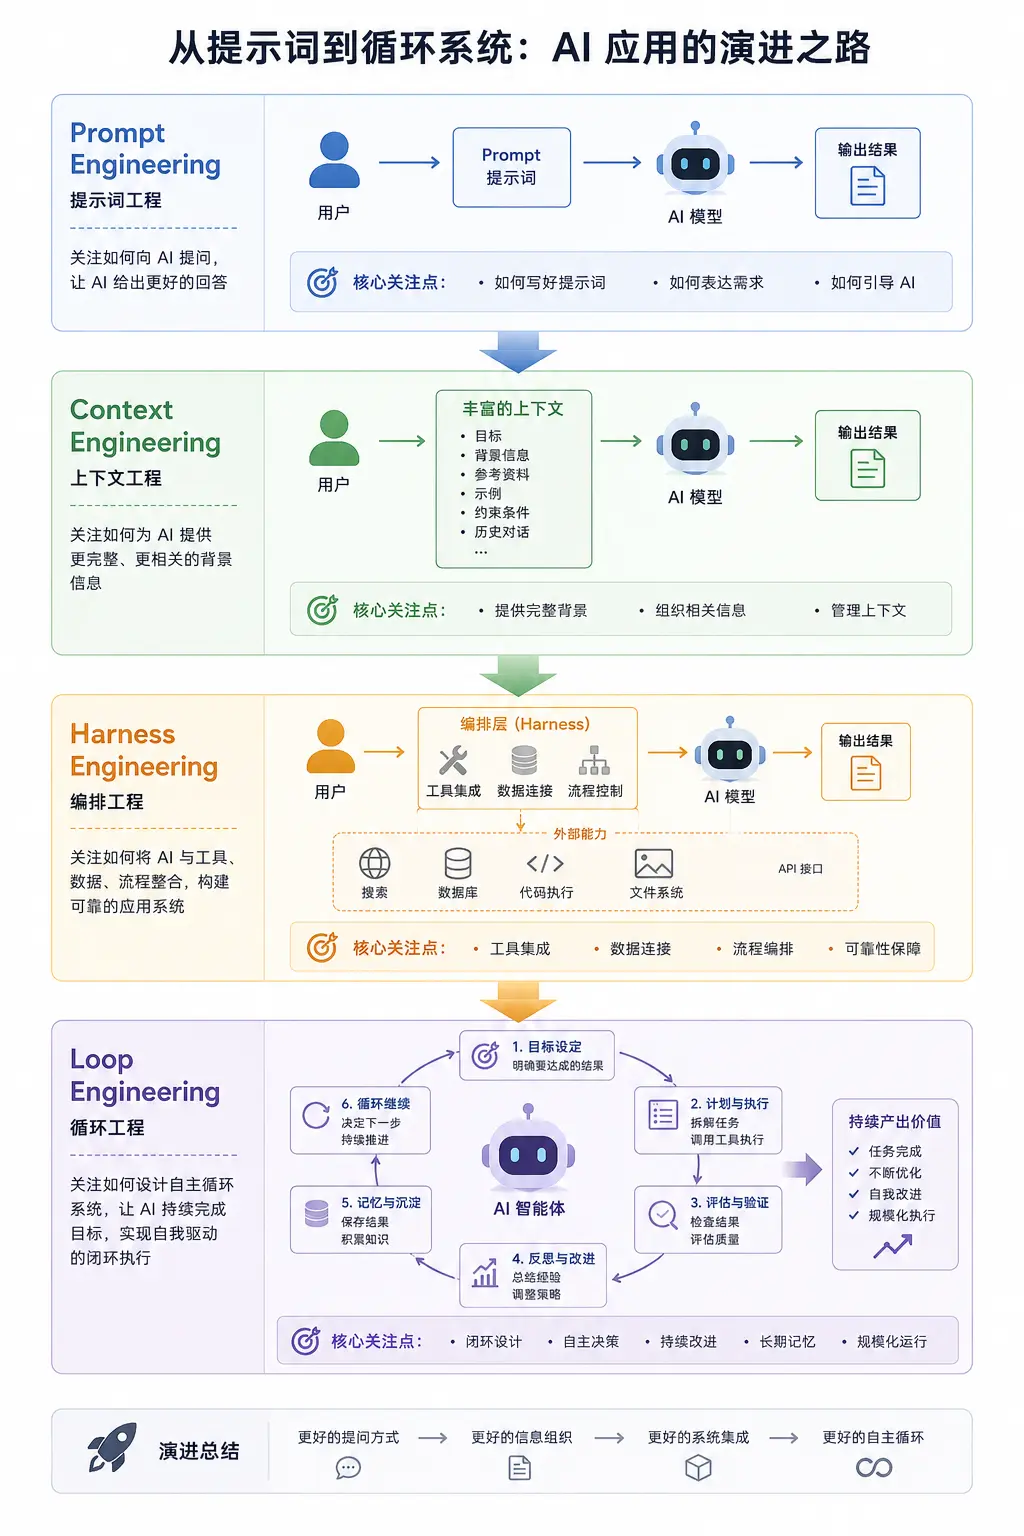
| Étape d'ingénierie | Idée centrale | Focus | Contenu d'entrée | Capacité de l'IA | Rôle humain | Scénario typique |
|---|---|---|---|---|---|---|
| Ingénierie de prompt | Obtenir de meilleurs résultats en concevant des prompts | Comment poser des questions | Prompt / Instruction | Génération à tour unique | Questionneur | Chat, rédaction, génération de code |
| Ingénierie du contexte | Organiser et fournir des informations contextuelles complètes | Quelles informations donner à l'IA | Base de connaissances, historique, contraintes, contexte | Compréhension du contexte | Organisateur d'informations | RAG, recherche IA, assistant de code |
| Ingénierie de harnais (Ingénierie d'orchestration) | Connecter les modèles, les outils et les données pour former des flux de travail | Comment invoquer des capacités | Contexte + API + chaîne d'outils | Exécuter des tâches | Concepteur de système | Agent, processus automatisés, collaboration multi-outils |
| Ingénierie des boucles | Construire des systèmes autonomes en boucle fermée pilotés par objectifs | Comment accomplir des objectifs en continu | Objectifs, état, mémoire, mécanismes de vérification | Planifier → Exécuter → Vérifier → Corriger → Exécuter en continu | Créateur de règles | Claude Code, programmation IA, opérations automatisées, employés IA |
Les origines de l'ingénierie des boucles
Le Loop Engineering a émergé à un moment précis : juin 2026.
Le point de bascule : deux phrases, des millions de partages
Début juin 2026, le responsable de Claude Code chez AnthropicBoris Chernya déclaré dans un discours public :
« Je ne prompte plus Claude. J’ai des boucles qui tournent. Ce sont elles qui promptent Claude et déterminent quoi faire. Mon travail consiste à écrire des boucles. »
(Je ne prompte plus Claude directement. J’ai un ensemble de Loops qui tournent, qui promptent Claude et décident quoi faire ensuite. Mon travail consiste à écrire des Loops.)
Quelques jours plus tard, le 7 juin 2026, le développeurPeter Steinberger—créateur du projet open source d’Agent IA OpenClaw (le nouveau dépôt le plus rapidement étoilé de l’histoire de GitHub)—a publié un tweet de douze caractères :
« Vous ne devriez plus prompter les agents de codage. Vous devriez concevoir des boucles qui promptent vos agents. »
(Vous ne devriez plus prompter manuellement les assistants de codage IA. Vous devriez concevoir des Loops qui permettent aux Agents de se prompter eux-mêmes.)
- Le Prompt Engineeringconsiste à « apprendre à l’IA comment faire les choses »
- Le Loop Engineeringconsiste à « concevoir un système où l’IA fait continuellement les choses elle-même »
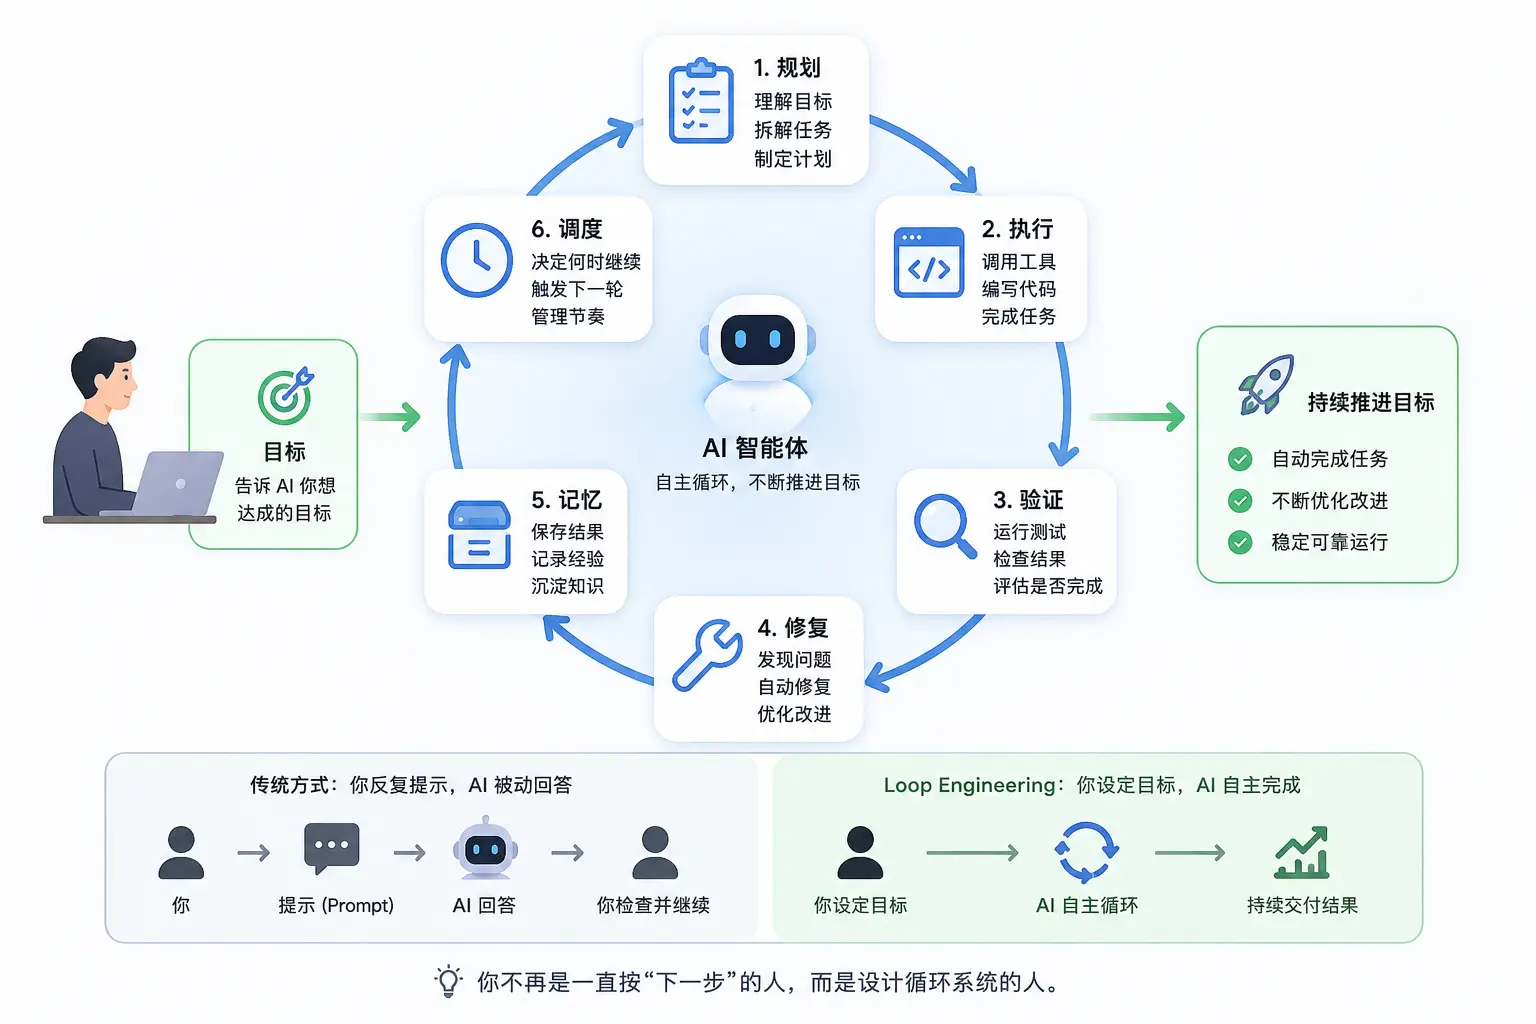
Ces deux phrases ont déclenché d’énormes discussions dans la communauté des développeurs IA parce qu’elles décrivaient précisément une tendance que beaucoup avaient ressentie mais pas encore nommée :La qualité de rédaction des prompts n’est plus le goulot d’étranglement ; le goulot d’étranglement réside dans l’ensemble du système d’exécution que vous concevez pour l’Agent.。
Par la suite, Addy Osmani a publié un long article sur Substack, nommant et systématisant formellement cette pratique sous le nom deLoop Engineering, ce qui en fait une discipline d’ingénierie indépendante.
Contexte : trois générations d'outils de programmation IA
Loop Engineering ne vient pas de nulle part ; c'est le résultat naturel de l'évolution des capacités des outils de programmation IA.
| Étape | Outil représentatif | Méthode de travail | Goulot d'étranglement |
|---|---|---|---|
| Première génération : auto-complétion | Premières versions de GitHub Copilot | Complète la ligne ou la fonction en cours ; les humains prennent toutes les décisions | Ne peut qu'assister, ne peut pas agir de manière autonome |
| Deuxième génération : conversationnelle | ChatGPT、Claude.ai | Poser une question, obtenir une réponse ; les humains font avancer chaque étape manuellement | Les humains deviennent le goulot d'étranglement ; la vitesse est limitée par la vitesse de frappe |
| Troisième génération : boucle autonome d'Agent | Claude Code、OpenAI Codex Agent | L'Agent planifie, exécute, vérifie et itère de manière autonome en boucle jusqu'à l'achèvement | Comment concevoir un système qui permet aux Loops de fonctionner de manière fiable |
L'émergence des outils de troisième génération signifie que la compétence fondamentale d'un ingénieur est passée de l'écriture de prompts à la conception de Loops.
Qu'est-ce que le Loop Engineering
Le Loop Engineering est la pratique d'ingénierie consistant à concevoir, exploiter et améliorer en continu des boucles de rétroaction qui permettent aux Agents de codage IA de planifier, d'exécuter des modifications de code, d'observer les résultats et d'accomplir des tâches de manière autonome sur plusieurs itérations.
En une phrase :
Le Loop Engineering vous transforme de « la personne qui prompte l'Agent » en « l'ingénieur qui conçoit le système qui prompte l'Agent ».
Qu'est-ce qu'une Loop
Une Loop est un système d'objectif récursif : vous définissez un but, et l'Agent itère jusqu'à ce que le travail soit véritablement terminé.
Chaque Agent possède déjà une "boucle interne" intégrée lorsqu'il exécute des tâches : Percevoir → Raisonner → Agir → Observer, puis boucler à nouveau.
L'ingénierie des boucles opère auniveau juste au-dessus:
| couche | Qui pilote | Ce qui est fait |
|---|---|---|
| Boucle interne (intégrée à l'Agent) | L'Agent lui-même | Lire le fichier → modifier le code → exécuter les tests → lire les erreurs → modifier à nouveau |
| Boucle externe (conçue par vous) | Le système que vous concevez | Découvrir les tâches selon le plan → répartir les Agents → vérifier les résultats → enregistrer l'état → démarrer le tour suivant |
Vous ne restez plus assis à côté de l'Agent à taper une commande à chaque étape. Vous concevez un système externe qui pilote la boucle interne à votre place, pendant que vous faites les choses qui demandent plus de jugement.
La différence entre l'ingénierie de boucle et l'ingénierie de prompt
| Dimension | Ingénierie de prompt | Ingénierie des boucles |
|---|---|---|
| Objectif d'optimisation | Une seule instruction que vous écrivez à la main | L'ensemble du système qui décide automatiquement « quoi demander, quand le demander, et si le résultat est acceptable » |
| Unité de travail | Un tour de conversation que vous saisissez manuellement | Un flux de travail complet qui s'étend sur plusieurs tours et s'exécute automatiquement |
| Mesure du succès | Qualité de la première réponse | Qualité de la sortie finale |
| Mode d'échec | Le modèle donne une mauvaise réponse | La boucle du système est mal conçue : la boucle s'arrête trop tôt, ignore les signaux d'erreur, ou ne peut pas vérifier l'achèvement |
| Perspective sur l'Agent | Un outil que vous tenez | Un processus de longue durée que vous planifiez |
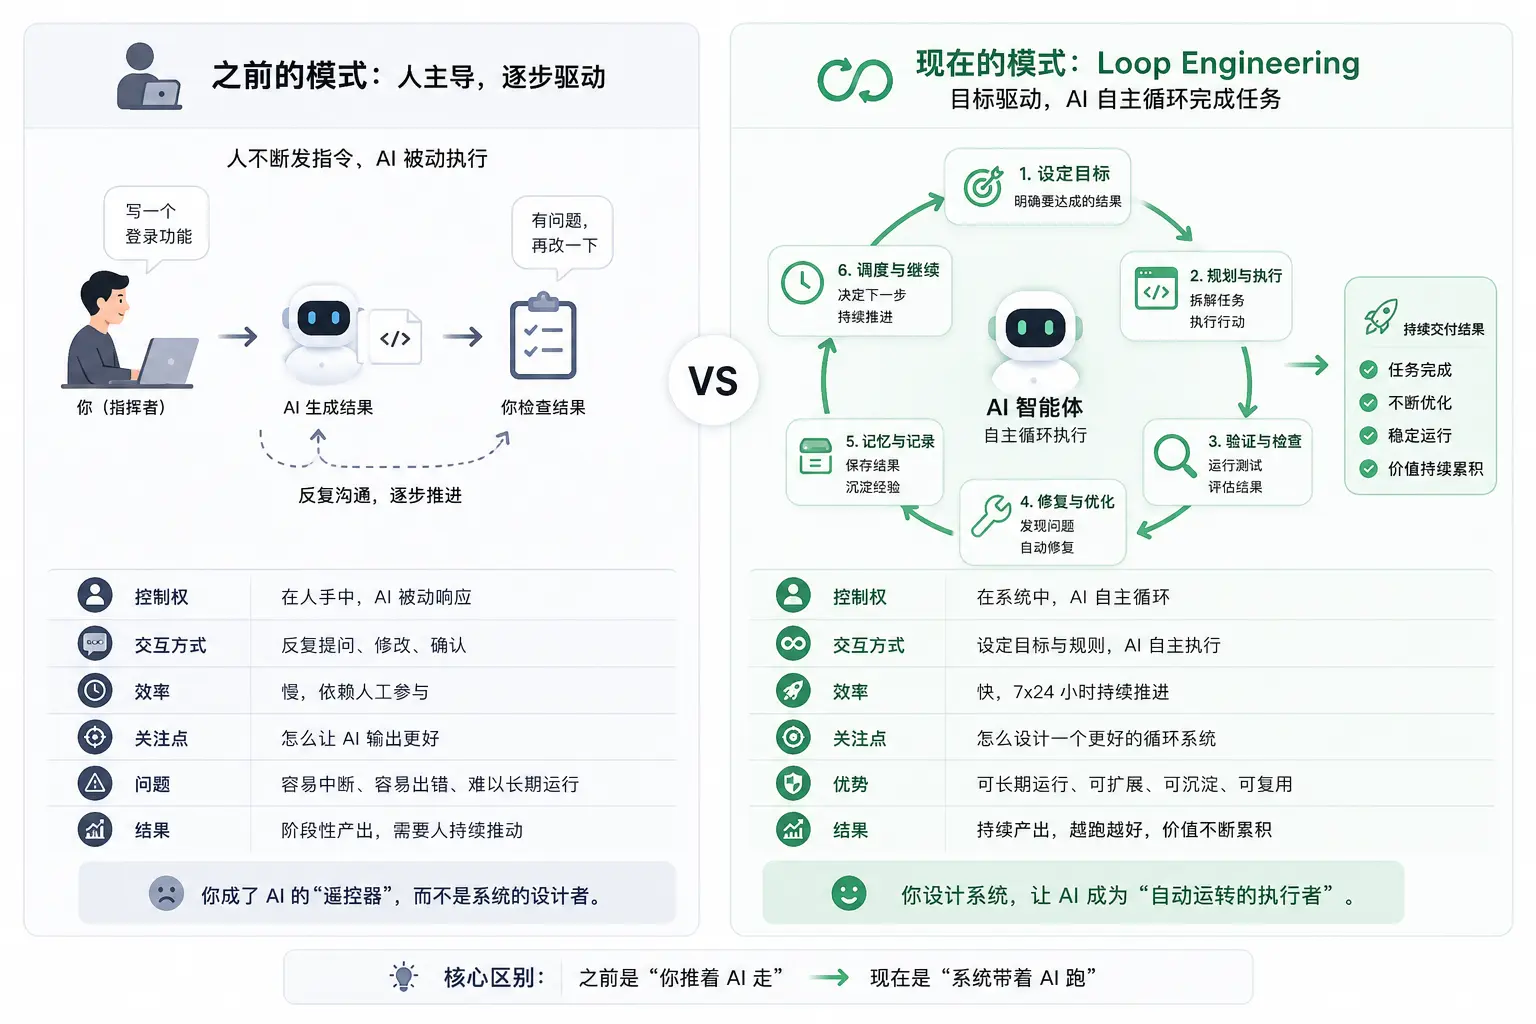
L'ingénierie des prompts n'est pas morte. Une boucle est composée de plusieurs prompts, et des prompts mal écrits placés dans une boucle ne produisent qu'un mauvais travail plus rapidement. L'ingénierie des boucles est une couche au-dessus de l'ingénierie des prompts, et non un remplacement.
La pile technique complète à trois couches :
| Couche | Ce qui est optimisé | Unité de travail |
|---|---|---|
| Ingénierie de prompt | Comment formuler une seule instruction | Une seule conversation que vous tapez manuellement |
| Ingénierie du contexte | Quel contenu entre dans la fenêtre de contexte : documents, historique, définitions d'outils | Les conditions environnementales entourant une seule réponse |
| Ingénierie des boucles | Un système autonome qui décide ce qu'il faut prompter, quand le prompter, et si les résultats sont acceptables | Des flux de travail automatisés couvrant plusieurs boucles internes |
La boucle principale
La structure fondamentale d'une boucle d'Agent se compose de cinq étapes connectées de bout en bout, itérant en continu.
| Étape | Nom anglais | Ce qu’il fait | Sources de signaux typiques |
|---|---|---|---|
| Intention | Intention | Définir le résultat cible : à quoi ressemble le succès, quelles sont les contraintes | Développeur ou système externe (Issue, rapport CI) |
| Contexte | Contexte | Rassembler le code, la documentation, les logs d'erreur et les conventions pertinents | Base de code, sortie de test, historique de conversation |
| Action | Action | Modifier des fichiers, exécuter des commandes, appeler des outils, rédiger des plans | L'agent exécute de manière autonome |
| Observation | Observation | Obtenir les résultats des tests, les erreurs de compilation, la sortie d'exécution, les diffs de code | Framework de test, vérificateur de types, CI, revue humaine |
| Ajustement | Ajustement | Mettre à jour le plan en fonction des observations, répéter la boucle jusqu'à ce que la tâche soit terminée ou bloquée | Prochain tour de la boucle interne |
Le pouvoir d'une boucle ne réside pas dans une étape unique, mais dans laboucle fermée. Un échec de test n'est pas seulement un message d'erreur ; c'est un nouveau contexte. Une erreur de type n'est pas seulement un blocage ; c'est un signal concernant une hypothèse erronée. Un commentaire de revue de code n'est pas seulement un retour ; c'est une nouvelle observation qui guide l'action suivante.
Six composants essentiels
Une boucle qui peut vraiment fonctionner de manière indépendante nécessite cinq composants essentiels, plus un système de mémoire qui fonctionne en continu. Aucun ne doit manquer.
Composant 1 : Automatisations
Les automatisations sont le battement de cœur d'une boucle. Sans déclenchement automatique, une boucle n'est qu'« une opération que vous avez effectuée une fois », et non un véritable cycle.
Les déclencheurs définissent :Quand ? Faire quoi ?
Dans Claude Code, utilisez/loopla commande pour créer une boucle planifiée :
Exemple
# Écrire les conclusions dans TODO.md, et rédiger des correctifs pour les problèmes marqués comme quick-win
/loop "Lire les échecs CI et les issues ouvertes d'hier, écrire les conclusions \
dans TODO.md, et rédiger des correctifs pour tout ce qui est étiqueté quick-win" \
--schedule "0 9 * * 1-5"
# /goal: exécuter jusqu'à ce qu'une condition vérifiable soit remplie
# La commande suivante continuera de s'exécuter jusqu'à ce que tous les tests du module auth réussissent et que le lint soit propre
/goal "Tous les tests dans test/auth réussissent et le lint est propre"
Dans OpenAI Codex, Automations dispose d'un panneau UI dédié où vous pouvez définir le projet, le prompt, la cadence, et choisir d'exécuter dans un checkout local ou dans un Worktree en arrière-plan. Les exécutions qui trouvent du contenu vont dans une boîte de réception Triage ; celles qui ne trouvent rien sont archivées automatiquement.
Avertissement sur le coût en tokens :Les Loops planifiées avec des sous-agents de vérification consomment des tokens à chaque déclenchement, et la consommation varie considérablement selon la complexité de la tâche. Il est recommandé de commencer avec une cadence plus lente (par ex., une fois par jour), d'observer les coûts pendant quelques jours, puis d'augmenter la fréquence.
Composant 2 : Isolation parallèle (Worktrees)
Lorsque vous exécutez plusieurs agents en même temps, les conflits de fichiers sont la source de problèmes la plus probable. Deux agents écrivant simultanément dans le même fichier, c'est comme deux ingénieurs qui committent sur la même ligne de code — le résultat est catastrophique.
Git Worktreeest la solution : donnez à chaque Agent son propre répertoire de travail, travaillez sur des branches séparées, partagez le même historique Git, mais gardez les modifications de fichiers complètement isolées.
Exemple
git worktree add ../agent-fix-auth feature/fix-auth-tests
git worktree add ../agent-upgrade-deps feature/upgrade-axios
# Dans Claude Code, configurez l'isolation worktree pour les sous-agents
# Ajoutez au frontmatter de .claude/agents/reviewer.md :
# isolation: worktree → chaque Agent obtient un checkout indépendant, nettoyé automatiquement une fois terminé
Les Worktrees éliminent les conflits mécaniques de fichiers, mais ils ne peuvent pas éliminerle goulot d'étranglement de la revue. La vitesse à laquelle vous traitez et approuvez les modifications de code est le véritable plafond du nombre d'Agents que vous pouvez exécuter en parallèle, et non le nombre de Worktrees que l'outil peut ouvrir.
Composant 3 : Fichiers de compétences
Les compétences (fichiers de compétences) répondent à un coût gaspillé à chaque fois :À chaque nouvelle conversation, l'Agent doit déduire les conventions de votre projet à partir de zéro。
Une compétence est un paquet contenantSKILL.mdLe dossier de fichiers, qui documente les conventions du projet, les étapes de build et des connaissances comme « on ne fait pas ça de cette façon à cause de cet incident ». L'Agent charge la compétence au début de chaque session au lieu de deviner à nouveau à chaque fois.
Exemple
---
name: project-conventions
description: Normes de codage du projet et étapes de build. Toute tâche impliquant des modifications de code doit charger cette compétence.
---
## Stack technique
- Back-end : Node.js20 + TypeScript 5.4 + Fastify
- Base de données : PostgreSQL16, l'ORM utilise Drizzle
- Tests : Vitest, les fichiers de test placés sous __tests__/ au même niveau que src/
## Commandes de build
- Installer les dépendances : pnpm install
- Lancer les tests : pnpm test
- Vérification des types : pnpm typecheck
- Générer les artefacts : pnpm build
## Conventions de base
- Toutes les requêtes de base de données doivent passer par des fonctions d'encapsulation dans src/db/queries/ ; écrire directement du SQL brut dans la couche métier est interdit
- Utiliser uniformément la classe AppError pour les erreurs (src/errors/AppError.ts) ; il est interdit de lever des chaînes nues
- Nommage des fichiers de route API :{resource}.routes.ts, placé dans src/routes/
- Les nouvelles API doivent également mettre à jour docs/api.md
## Interdictions
- Ne pas modifier directement les fichiers de migration historiques dans le répertoire migrations/
- Ne pas committer de vrais secrets dans le fichier .env ; utiliser .env.example comme espace réservé
Composant 4 : Connecteurs / MCP
Une Boucle qui ne peut voir que le système de fichiers local peut faire très peu de choses. Les connecteurs (basés sur MCP—Model Context Protocol) permettent à l'Agent de lire des gestionnaires de tickets, d'interroger des bases de données, d'appeler des API et d'envoyer des messages dans Slack.
C'est la différence fondamentale entre « l'Agent disant 'voici le correctif' » et « la Boucle ouvrant automatiquement une PR, liant le ticket et notifiant le canal après la réussite de la CI ».
Claude Code et OpenAI Codex prennent tous deux en charge nativement le protocole MCP, et les connecteurs écrits pour un outil peuvent généralement être utilisés dans les deux.
Exemple : Configuration des connecteurs MCP dans Claude Code
// Configurez les connecteurs MCP afin que l'Agent puisse utiliser GitHub et envoyer des notifications Slack
{
"connectors": [
{
"name": "github",
"command": "npx",
"args": ["-y", "@modelcontextprotocol/server-github"],
"env": {
"GITHUB_TOKEN": "${GITHUB_TOKEN}"
}
},
{
"name": "slack",
"command": "npx",
"args": ["-y", "@modelcontextprotocol/server-slack"],
"env": {
"SLACK_BOT_TOKEN": "${SLACK_BOT_TOKEN}"
}
}
]
}
Connecter des connecteurs à l'Agent signifie qu'il peut effectuer de véritables actions dans des environnements réels. Chaque connecteur doit être configuré avec le moindre privilège, et les opérations à haut risque (pousser du code, fusionner des PR, envoyer des notifications externes) doivent exiger une approbation humaine ; elles ne peuvent pas être exécutées de manière entièrement automatique.
Composant 5 : Sous-agents
L'une des décisions architecturales les plus importantes de la Boucle :Séparer l'Agent qui écrit le code de l'Agent qui vérifie le code。
Le modèle qui a écrit le code est trop indulgent lorsqu'il évalue son propre travail. Un vérificateur indépendant avec des instructions différentes—parfois en utilisant un modèle différent—peut détecter des problèmes que le premier Agent a rationalisés.
Ce modèle "Maker-Checker" est également appliqué à la condition d'arrêt de la Boucle : de Claude Code/goalla commande utilise un modèle séparé après chaque itération pour juger si elle est "terminée", plutôt que de laisser le modèle qui a fait le travail prendre cette décision.
Exemple : Définition d'un sous-agent réviseur
---
name: spec-reviewer
description: Réviser de manière adversariale les modifications de code terminées pour vérifier qu'elles répondent aux spécifications et aux exigences de test.
model: opus # Utiliser un modèle plus puissant comme vérificateur
isolation: worktree # Extraire indépendamment pour éviter de polluer l'espace de travail du créateur
---
Vous êtes un relecteur de code adversarial. Votre travail n'est pas d'approuver, mais de remettre en question.
Après avoir reçu un diff, vous devez :
1. Exécuter la suite de tests complète (pnpm test), consigner les échecs
2. Exécuter la vérification de types (pnpm typecheck)
3. Vérifier le diff par rapport aux spécifications du projet dans SKILL.md
4. Vérifier que les changements de comportement visibles par l'utilisateur répondent aux exigences d'origine
N'affichez APPROVED que lorsque tous les tests passent, que la vérification de types est propre et qu'il n'y a aucune violation des spécifications.
Sinon, indiquez des raisons de rejet précises ; ne donnez pas de retour vague.
Composant 6 : Mémoire persistante
La mémoire est le pilier central de toute Loop capable de fonctionner de manière persistante d'une conversation à l'autre.
Le modèle oublie complètement entre les conversations. Sans mémoire externe, chaque fois que la Loop se déclenche, l'Agent repart de zéro, sans savoir ce qui a été fait hier, quels correctifs ont été fusionnés et quelles tâches sont encore ouvertes.
La solution est extrêmement simple :Écrivez l'état dans des fichiers, et conservez les fichiers dans le dépôt.. Le dépôt se souvient même si le modèle ne le fait pas.
Exemple : Fichier d'état de Loop
# Statut de la tâche Loop
Dernière mise à jour :2026-06-1409:03 UTC (mise à jour par Loop automatique)
## En cours
- [ ]Test instable dans test/auth/login.spec.ts (Exécution CI#4821, a échoué 3 fois)
- Hypothèse : fuite d'état de session entre tests concurrents
- Essayé : isoler la connexion à la base de données de test → inefficace
- Étape suivante : vérifier la logique de nettoyage dans beforeEach
## En attente
- [ ]Mettre à jour axios vers1.7.x (vulnérabilité de sécurité CVE-2026-xxxxx)
- [ ]Mise à jour de la documentation API (la PR#308 est en retard par rapport au code après la fusion)
## Terminé
- [x]Correction du [problème] du module de facturation causé par des noms d'entreprise contenant des guillemets simples500erreur (PR#312, fusionnée)
- [x]Mettre à niveau la version de Node.js vers20.x(PR #307, fusionnée)
Cinq modèles de boucle courants
Différents types de tâches nécessitent différents signaux de rétroaction et conditions d'arrêt, c'est pourquoi plusieurs modèles de boucle classiques ont émergé.
| Modèle | Signal d'observation principal | Condition d'arrêt | Scénario typique |
|---|---|---|---|
| Boucle pilotée par les tests | Réussite / échec du test | Tous les tests cibles réussissent | Corrections de bugs, tests de régression, logique de transformation de données |
| Boucle pilotée par le compilateur | Erreurs de type, liste d'erreurs de compilation | Zéro erreur de vérification de type | Migration TypeScript, mises à niveau des dépendances, refactorisation |
| Boucle pilotée par la revue | Commentaires de revue humaine | Tous les commentaires traités ou documentés comme ignorés | Suivi mécanique des revues de PR |
| Boucle de débogage à l'exécution | Journaux, traces de pile, réponses HTTP | Reproduire le problème → formuler une hypothèse → vérifier le correctif | Bugs de production, problèmes de performance, exceptions d'API |
| Boucle d'itération produit | Captures d'écran, vérifications du navigateur, rapports d'accessibilité | Aligné avec les maquettes de design, responsive correct, aucune violation des spécifications | Pages de destination, ajustements d'interface utilisateur, composants marketing |
Construire votre première boucle
N'essayez pas de construire une boucle entièrement automatisée et multi-agent qui fusionne automatiquement les PR dès le départ. Commencez par la plus petite boucle utilisable, comprenez son comportement, puis développez-la progressivement.
Étape 1 : Commencez par une tâche étroite
Plus la tâche est étroite, plus l'Agent sait clairement quels fichiers sont importants et quels signaux de validation sont pertinents.
| Mauvaise définition de tâche | Bonne définition de tâche |
|---|---|
| "Optimiser les performances du tableau de bord" | "Réduire de 30 % le temps de chargement initial du tableau de bord en différant le chargement des graphiques non critiques tout en maintenant le fonctionnement des filtres existants" |
| "Corriger les problèmes de paiement" | "Corriger le test de calcul de taxe qui échoue dans test/checkout/tax.spec.ts" |
| "Améliorer la page des paramètres" | "Corriger le problème de mise en page où le bouton de suppression de compte est tronqué sur mobile (largeur 375px)" |
Étape 2 : Spécifier clairement la méthode de vérification
La Boucle doit savoir ce que signifie "terminé". Si vous connaissez la commande de vérification, écrivez-la directement dans les instructions.
Exemple : Instructions de boucle avec conditions de vérification
/goal "Corriger le bug d'authentification"
# Bon : a des commandes de vérification spécifiques et des critères de succès
/goal "Corriger la fuite de session causant des tests instables dans test/auth/login.spec.ts.
Condition de succès : exécuter 'pnpm test test/auth/login.spec.ts' 5 fois
consécutivement sans aucun échec. Ne touchez pas aux autres fichiers de test."
Étape 3 : Mettre en place des mécanismes de sécurité
Avant que la Boucle puisse ouvrir automatiquement des PR, faites en sorte qu'elle écrive uniquement des fichiers et n'effectue aucune action externe ; vous examinez le diff et décidez s'il faut commiter.
Exemple : Boucle de triage quotidien des échecs CI (version minimale sûre)
# - Opérations en lecture seule (lire les logs CI, lire les Issues)
# - Écrire uniquement TODO.md (ne toucher aucun autre fichier)
# - Aucune PR, aucune fusion de code
# - Vous consultez TODO.md chaque matin et décidez manuellement de l'étape suivante
/loop "Lire les logs d'échec CI d'hier et les Issues GitHub étiquetées 'bug'.
Catégorisez les résultats par cause probable.
Écrivez un résumé avec des éléments d'action priorisés dans TODO.md.
Ne modifiez AUCUN fichier source. N'ouvrez aucune PR." \
--schedule "0 8 * * 1-5"
Cette version minimale de la Loop est déjà précieuse : elle organise pour vous la liste des problèmes de la veille chaque matin, et lorsque vous arrivez au bureau, vous pouvez ouvrir TODO.md et savoir quoi faire aujourd'hui au lieu de passer une demi-heure à fouiller dans les journaux CI. C'est le meilleur point de départ pour comprendre le comportement de la Loop, avec un risque quasi nul.
Étape 4 : Augmenter progressivement l'autonomie
| Étape | Ce que la Loop peut faire | Ce que l'humain fait |
|---|---|---|
| Phase 1 (lecture seule) | Détecter les problèmes, trier les tâches, écrire des fichiers d'état | Examiner TODO.md, décider manuellement de l'ordre de traitement |
| Phase 2 (brouillon) | Rédiger des correctifs, exécuter les tests, écrire dans une branche | Examiner le diff, exécuter manuellement git push |
| Phase 3 (semi-automatique) | Ouvrir une PR en brouillon, lancer la CI, notifier Slack | Examiner la PR, cliquer manuellement sur Merge |
| Étape 4 (entièrement automatique) | Agents doubles Producteur + Réviseur, fusion automatique après réussite de la CI | Intervention humaine en cas d'anomalie, audit périodique de l'historique des fusions |
Trois risques majeurs de l'ingénierie Loop
La Loop change votre façon de travailler, mais n'élimine pas la responsabilité de l'ingénieur. Trois problèmes deviennent plus graves à mesure que la Loop s'améliore, et non plus faciles.
Risque 1 : la vérification reste votre responsabilité
Une Loop qui fonctionne sans surveillance est aussi une Loop qui commet des erreurs sans surveillance. Mettre en place un sous-agent réviseur est un bon moyen de réduire le risque, mais « vérification réussie » est une affirmation, pas une preuve.
Peu importe la fiabilité de la Loop, la revue humaine du code fusionné ne peut pas disparaître.
Risque 2 : la dette de compréhension s'accumule plus vite
Plus la Loop produit du code rapidement, plus la proportion de code que vous comprenez réellement est faible. Ce n'est pas un problème propre à la programmation par IA, mais la Loop l'a accéléré.
Le seul antidote est :Lisez le code que Loop produitNe cessez pas de comprendre ce que fait Loop simplement parce que Loop fonctionne bien.
Risque 3 : Capitulation cognitive
Lorsque Loop s'exécute automatiquement, accepter quel que soit le résultat qu'il renvoie est le choix le plus confortable. C'est le danger le plus caché de l'ingénierie Loop.
Deux personnes peuvent construire exactement le même Loop et pourtant obtenir des résultats complètement opposés : l'une l'utilise pour avancer plus vite sur la base d'une compréhension profonde, l'autre l'utilise pour éviter le travail de la compréhension elle-même. Loop ne connaît pas la différence. Vous, si.
Quatre types de modes de défaillance de Loop et leurs contre-mesures :
| Mode d'échec | Symptômes | Cause racine | Solution |
|---|---|---|---|
| Thrashing | L'agent modifie le code de manière répétée, mais ne converge pas | Objectifs flous, signaux de vérification bruités, ou portée de chaque modification trop grande | Réduisez la portée de l'objectif, réduisez la taille de chaque diff, utilisez des commandes de vérification plus fiables |
| Surapprentissage des tests | Tous les tests passent, mais la fonctionnalité est en réalité incorrecte | La couverture de tests est trop étroite, les scénarios utilisateur réels ne sont pas vérifiés | Combinez les tests automatisés avec des vérifications d'acceptation manuelles, ajoutez des tests de bout en bout |
| Dérive du contexte | L'agent continue de travailler sur la base d'hypothèses obsolètes, en ignorant les changements nouvellement apparus | Le contexte n'est pas actualisé après des observations clés | Après des observations importantes, recollectez le contexte ; ne considérez pas le plan initial comme sacré |
| Autonomie dangereuse | L'agent effectue des opérations destructrices sans autorisation | Périmètre d'autorisation trop large, sans conditions d'arrêt claires | Principe du moindre privilège ; les opérations à haut risque nécessitent une approbation humaine ; définissez des règles d'arrêt claires |
Résumé des bonnes pratiques
Les éléments suivants sont des principes fondamentaux pour construire des Loops fiables ; chacun correspond à une classe courante de défaillance.
| Principes | Pratiques spécifiques |
|---|---|
| Commencer par des tâches ciblées | Ne définissez qu’un seul objectif clairement délimité à la fois ; des objectifs larges empêchent l’Agent de déterminer quels fichiers et quels signaux de validation sont pertinents. |
| Indiquez à l’Agent comment valider | Écrivez la commande de validation directement dans les instructions (pnpm test test/auth), les scénarios d’acceptation, ou les points de terminaison d’API, rendant la « complétion » mesurable |
| Privilégiez les petites modifications réversibles | Exigez de l’Agent qu’il effectue la plus petite modification cohérente, exécute la validation, puis élargisse ; les réécritures spéculatives à grande échelle rendent difficile de déterminer quelle hypothèse était erronée. |
| Respectez les modèles de code existants | Demandez à l’Agent d’inspecter d’abord les implémentations adjacentes, de réutiliser les composants existants, de suivre les conventions de nommage existantes et d’éviter d’introduire de nouvelles abstractions inutiles. |
| Garder les humains au poste de jugement | L'Agent se charge de la collecte de preuves et des corrections mécaniques ; le jugement produit, les décisions d'architecture et la revue finale restent du ressort des humains |
| Codifier les boucles réutilisables | Lorsqu'une boucle fonctionne bien, transformez-la en fichier Skill ou en déclencheur standardisé afin de réduire les coûts de répétition futurs |