Tutoriel de prise en main de LangGraph
LangGraph est unframework d'orchestration d'agents de bas niveau développé par l'équipe LangChain, conçu spécifiquement pour construire des workflows IA avec état et de longue durée.
Contrairement aux chaînes d'appels LLM linéaires traditionnelles, LangGraph modélise les workflows sous forme degraphe orienté:
- Nœud: Fonctions qui effectuent des actions spécifiques (par exemple, appeler des LLM, exécuter des outils, traiter des données)
- Arête: Définit les chemins de flux entre les nœuds, prenant en charge les branchements conditionnels
- État: Données partagées et transmises tout au long du workflow
Dépôt open source :https://github.com/langchain-ai/langgraph。
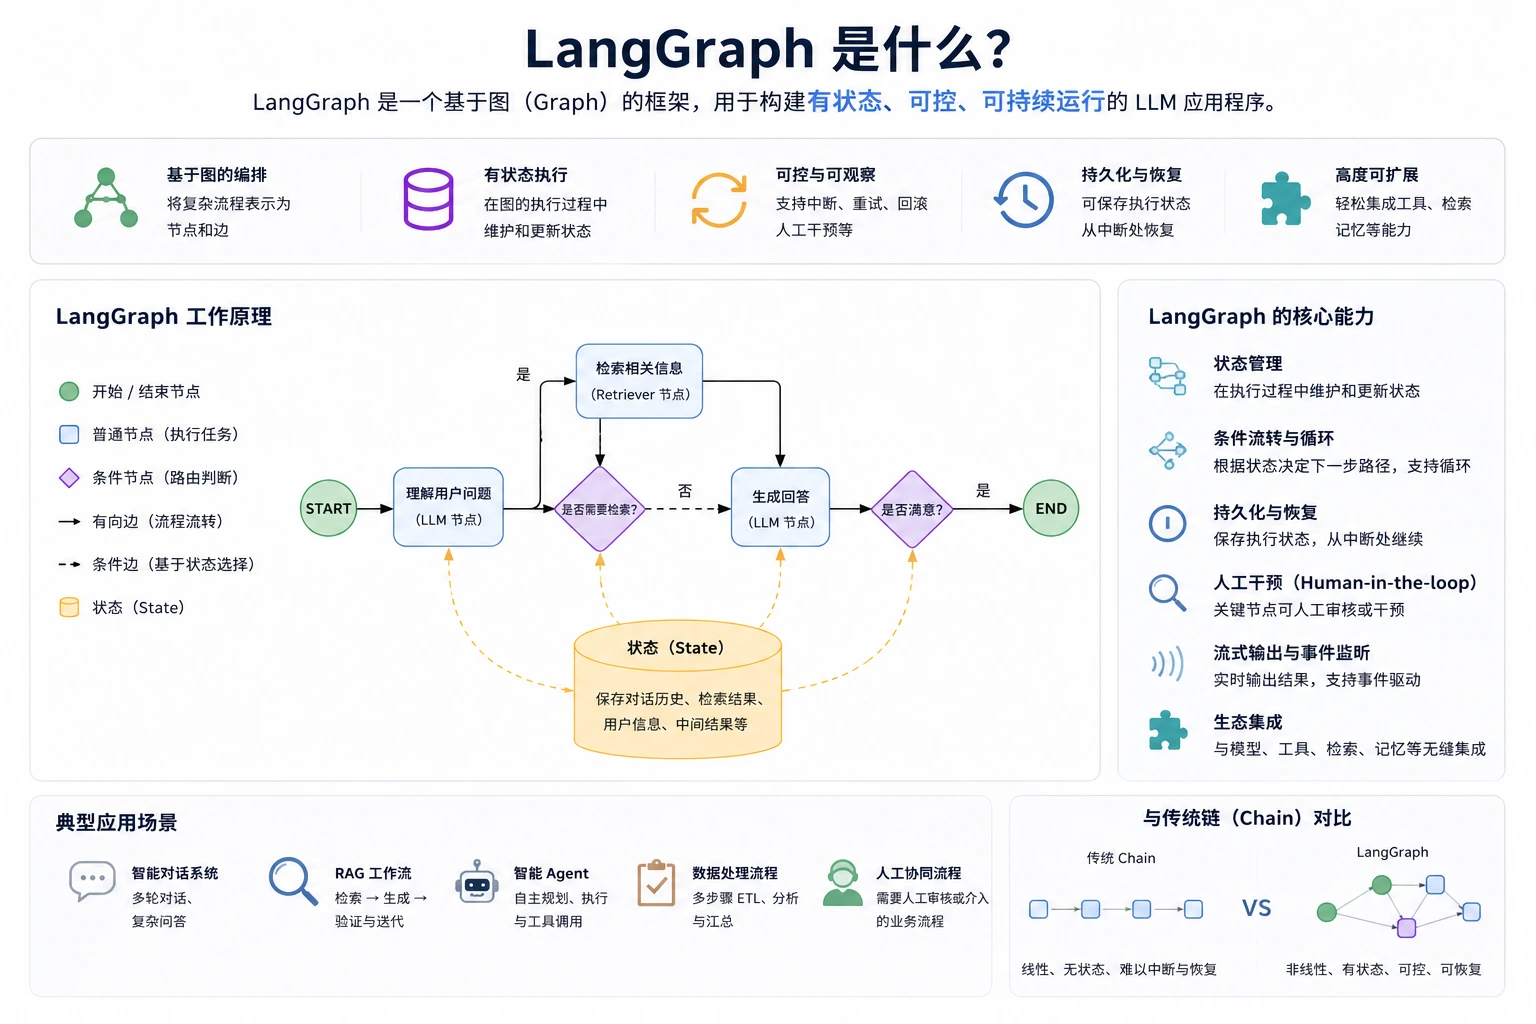
Imaginez que vous dirigez une symphonie : une chaîne LLM traditionnelle ressemble à l'exécution d'une pièce du début à la fin, de manière uniquement séquentielle ; tandis que LangGraph est comme un chef d'orchestre qui peut ajuster l'ordre d'interprétation à tout moment en fonction des réactions du public en direct, répéter un certain mouvement ou sauter vers un passage précis. Il donne aux workflows d'IA la sagesse d'un « chef d'orchestre » — capable de boucler, de ramifier et de revenir en arrière, permettant véritablement une prise de décision autonome complexe.
Pourquoi choisir LangGraph ?
Le tableau ci-dessous compare les principales différences entre les chaînes LLM traditionnelles et LangGraph :
| Fonctionnalité | Chaîne LLM traditionnelle | LangGraph |
|---|---|---|
| Structure du workflow | Exécution linéaire et unidirectionnelle | Structure de graphe, prend en charge les boucles |
| Gestion d'état | Nécessite une gestion manuelle | Persistance d'état intégrée |
| Routage conditionnel | Complexe à implémenter | Prise en charge native |
| Humain dans la boucle | Nécessite un développement supplémentaire | Prise en charge intégrée des interruptions |
| Coordination multi-agents | Difficile à implémenter | Prise en charge de premier ordre |
| Outils de débogage | Limité | LangGraph Studio |
Scénarios applicables
- Chatbots: Doivent se souvenir du contexte de dialogue multi-tours
- Agent autonome: Peut planifier, utiliser des outils et itérer la réflexion
- Système multi-agent: Plusieurs IA collaborent pour accomplir des tâches complexes
- Workflow d'approbation: Un processus automatisé qui nécessite une revue humaine
- Assistant de recherche: Nécessite un raisonnement en plusieurs étapes et une récupération d'informations
Concepts fondamentaux
Avant de commencer à écrire du code, comprenez d'abord les trois concepts fondamentaux de LangGraph.
Graphe
Le graphe est le plan de l'ensemble du workflow, définissant la structure logique complète de l'Agent. Il est composé de Nœuds et d'Arêtes :
StateGraph
   |-- Nodes(节点)
   |     |-- node_a
   |     |-- node_b
   |     +-- node_c
   +-- Edges(边)
         |-- START -> node_a
         |-- node_a -> node_b(条件边)
         |-- node_a -> node_c(条件边)
         +-- node_b -> END
State
State est ce qui traverse tout le graphestructure de données partagée. Chaque nœud peut lire et mettre à jour State, et le State mis à jour est transmis au nœud suivant.
from typing import TypedDict, Annotated
from langgraph.graph import add_messages

class MyState(TypedDict):
    messages: Annotated[list, add_messages]  # 消息列表(自动追加)
    user_name: str                            # 用户名称
    step_count: int                           # 步骤计数
Annotated[list, add_messages]Indique que ce champ utiliseadd_messagescomme un reducer—les nouveaux messages sont ajoutés à la liste plutôt que d'être écrasés. C'est le mécanisme central de la gestion d'état de LangGraph.Nœuds
Les nœuds sont des fonctions Python ordinaires qui reçoivent le State actuel et renvoient le State mis à jour (champs partiels).
def my_node(state: MyState) -> dict:
    # 读取状态
    messages = state["messages"]

    # 执行操作...
    result = "处理结果"

    # 返回更新的字段(不需要返回所有字段)
    return {"messages": [{"role": "ai", "content": result}]}
Arêtes
Les arêtes définissent le flux entre les nœuds :
- Arête normale: chemin fixe,
node_a -> node_b - Arête conditionnelle: route dynamiquement en fonction du State,
node_a -> node_b 或 node_c - Arête de début:
START -> 第一个节点 - Arête de fin:
某节点 -> END
Configuration de l'environnement
Installer les dépendances
Installer LangGraph et les dépendances associées en utilisant un miroir domestique :
# 创建虚拟环境(推荐)
python -m venv venv
source venv/bin/activate      # macOS/Linux
# venv\Scripts\activate       # Windows

# 安装 LangGraph 和 LangChain
pip install langgraph langchain langchain-openai python-dotenv -i https://mirrors.aliyun.com/pypi/simple/

# 可选:安装开发工具
pip install langgraph-cli jupyter -i https://mirrors.aliyun.com/pypi/simple/
Configurer la clé API
Dans le répertoire racine du projet, créez.envun fichier, et configurez OpenAI et DeepSeek :
# .env 文件内容

# OpenAI 配置(国外用户)
OPENAI_API_KEY=sk-xxx
OPENAI_BASE_URL=https://api.openai.com/v1

# DeepSeek 配置(国内用户推荐)
DEEPSEEK_API_KEY=sk-xxx
DEEPSEEK_BASE_URL=https://api.deepseek.com
DEEPSEEK_MODEL=deepseek-v4-pro
https://api.deepseek.com(sans /v1) ; LangChain ajoutera automatiquement le chemin. La clé API DeepSeek peut êtrehttps://platform.deepseek.com/api_keyscréée.Vérifier l'installation
import langgraph
print(f"LangGraph 版本: {langgraph.__version__}")
Votre premier programme LangGraph
Commençons par l'exemple le plus simple — un flux de travail linéaire avec seulement deux nœuds.
Exemple
from typing import TypedDict
# Étape 1 : Définir l'état
class SimpleState(TypedDict):
message: str
processed: bool
# Étape 2 : Définir les fonctions de nœud
def greet_node(state: SimpleState) -> dict:
"""Nœud d'accueil : génère une salutation"""
print(f"[greet_node] Message reçu : {state['message']}")
return {"message": f"Bonjour ! {state['message']}"}
def process_node(state: SimpleState) -> dict:
"""Nœud de traitement : marquer comme traité"""
print(f"[process_node] Traitement du message : {state['message']}")
return {"processed": True}
# Étape 3 : Construire le graphe
builder = StateGraph(SimpleState)
# Ajouter les nœuds
builder.add_node("greet", greet_node)
builder.add_node("process", process_node)
# Ajouter des arêtes
builder.add_edge(START, "greet")
builder.add_edge("greet", "process")
builder.add_edge("process", END)
# Étape 4 : Compiler le graphe
graph = builder.compile()
# Étape 5 : Exécuter
result = graph.invoke({
"message": "world",
"processed": False
})
print(f"\nRésultat final : {result}")
Résultat de l'exécution :
[greet_node] 收到消息: 世界
[process_node] 处理消息: 你好!世界

最终结果: {'message': '你好!世界', 'processed': True}
Visualiser la structure du graphe
Dans Jupyter Notebook, vous pouvez directement visualiser la structure du graphe :
# 在 Jupyter Notebook 中可视化
from IPython.display import Image
Image(graph.get_graph().draw_mermaid_png())

# 或者打印 Mermaid 格式
print(graph.get_graph().draw_mermaid())
Gestion d'état
Définir l'état avec TypedDict
from typing import TypedDict, Annotated, Optional
from langgraph.graph.message import add_messages

class AgentState(TypedDict):
    # 消息历史(add_messages reducer 自动追加而非覆盖)
    messages: Annotated[list, add_messages]

    # 普通字段(直接覆盖)
    user_id: str
    session_id: str

    # 可选字段
    error: Optional[str]

    # 计数器(使用 operator.add 作为 reducer)
    retry_count: Annotated[int, lambda x, y: x + y]
Définir l'état avec Pydantic (recommandé pour la production)
from pydantic import BaseModel, Field
from typing import Annotated
from langgraph.graph.message import add_messages

class ProductionState(BaseModel):
    messages: Annotated[list, add_messages] = Field(default_factory=list)
    user_id: str = ""
    confidence_score: float = 0.0

    class Config:
        arbitrary_types_allowed = True
MessagesState (état pratique intégré)
LangGraph fournit une fonctionnalité intégréeMessagesState, conçue spécifiquement pour les scénarios de conversation :
from langgraph.graph import MessagesState

# MessagesState 等价于:
# class MessagesState(TypedDict):
#     messages: Annotated[list[AnyMessage], add_messages]

# 直接使用,无需自定义
builder = StateGraph(MessagesState)
Nœuds
Nœuds de fonction standard
def simple_node(state: AgentState) -> dict:
    # 读取状态
    last_message = state["messages"][-1]

    # 执行操作
    response = f"收到: {last_message.content}"

    # 返回部分状态更新
    return {
        "messages": [{"role": "assistant", "content": response}]
    }
Nœuds d'appel LLM
Exemple
from dotenv import load_dotenv
from langchain_openai import ChatOpenAI
from langchain_core.messages import SystemMessage
load_dotenv()
# Utiliser le modèle DeepSeek
llm = ChatOpenAI(
model=os.getenv('DEEPSEEK_MODEL', 'deepseek-v4-pro'),
openai_api_key=os.getenv('DEEPSEEK_API_KEY'),
openai_api_base=os.getenv('DEEPSEEK_BASE_URL', 'https://api.deepseek.com'),
temperature=0
)
def llm_node(state: dict) -> dict:
"""Nœud qui appelle le LLM"""
system_prompt = SystemMessage(content="Vous êtes un assistant serviable.")
# Fusionner le prompt système avec l'historique de conversation
messages = [system_prompt] + state["messages"]
# Appeler le LLM
response = llm.invoke(messages)
return {"messages": [response]}
Nœuds asynchrones
import asyncio

async def async_node(state: AgentState) -> dict:
    """异步节点,适合 I/O 密集型操作"""
    # 模拟异步操作(如 API 调用、数据库查询)
    await asyncio.sleep(0.1)

    result = await some_async_api_call(state["messages"][-1].content)
    return {"messages": [{"role": "assistant", "content": result}]}

# 使用异步图
result = await graph.ainvoke({"messages": [...]})
Utiliser des classes comme nœuds
class RouterNode:
    def __init__(self, llm, system_prompt: str):
        self.llm = llm
        self.system_prompt = system_prompt

    def __call__(self, state: AgentState) -> dict:
        """类实例可以作为节点使用"""
        messages = [
            SystemMessage(content=self.system_prompt),
            *state["messages"]
        ]
        response = self.llm.invoke(messages)
        return {"messages": [response]}

# 添加类节点
router = RouterNode(llm, "你是一个专业的路由助手。")
builder.add_node("router", router)
Arêtes et routage conditionnel
Arêtes régulières
# 固定路径:node_a 完成后始终执行 node_b
builder.add_edge("node_a", "node_b")

# 结束:node_a 完成后图结束
builder.add_edge("node_a", END)
Arêtes conditionnelles
Les arêtes conditionnelles sont une fonctionnalité essentielle de LangGraph, décidant dynamiquement l'étape suivante en fonction de l'État actuel.
def route_after_llm(state: AgentState) -> str:
    """
    路由函数:根据 LLM 的最新输出决定走哪条路径
    返回值必须是已注册节点名称或 END
    """
    last_message = state["messages"][-1]

    # 如果 LLM 请求使用工具
    if hasattr(last_message, "tool_calls") and last_message.tool_calls:
        return "tools"

    # 否则结束
    return END

# 添加条件边
builder.add_conditional_edges(
    "llm",              # 源节点
    route_after_llm,    # 路由函数
    {
        "tools": "tool_executor",   # 返回 "tools" 时 -> tool_executor 节点
        END: END                    # 返回 END 时 -> 结束
    }
)
Exécution parallèle (Fan-out)
# 从一个节点并行分叉到多个节点
builder.add_edge("start_node", "branch_a")
builder.add_edge("start_node", "branch_b")
builder.add_edge("start_node", "branch_c")

# 多个节点汇聚到一个节点(Fan-in)
builder.add_edge("branch_a", "merge_node")
builder.add_edge("branch_b", "merge_node")
builder.add_edge("branch_c", "merge_node")
Exemple complet de routage conditionnel
Exemple
from dotenv import load_dotenv
from langgraph.graph import StateGraph, START, END, MessagesState
from langchain_openai import ChatOpenAI
from langchain_core.messages import SystemMessage, HumanMessage
load_dotenv()
# Initialiser le LLM
llm = ChatOpenAI(
model=os.getenv('DEEPSEEK_MODEL', 'deepseek-v4-pro'),
openai_api_key=os.getenv('DEEPSEEK_API_KEY'),
openai_api_base=os.getenv('DEEPSEEK_BASE_URL', 'https://api.deepseek.com'),
temperature=0.7
)
# Fonction de routage
def classify_intent(state: MessagesState) -> str:
"""Router vers différents agents en fonction de l'intention de l'utilisateur"""
last_message = state["messages"][-1]
content = last_message.content.lower()
if "Weather" in content or "Temperature" in content:
return "weather_agent"
elif "Code" in content or "Programming" in content:
return "code_agent"
elif "Goodbye" in content or "Exit" in content:
return "farewell"
else:
return "general_agent"
# Définir divers nœuds Agent
def router_node(state: MessagesState) -> dict:
"""Nœud routeur : n'effectue aucun traitement, sert uniquement à déclencher les décisions de routage"""
return {}
def weather_node(state: MessagesState) -> dict:
"""Agent météo"""
response = llm.invoke([
SystemMessage(content="Vous êtes un assistant météo, aimable pour répondre aux questions liées à la météo. S'il n'y a pas de données en temps réel, vous pouvez fournir des conseils généraux."),
*state["messages"]
])
return {"messages": [response]}
def code_node(state: MessagesState) -> dict:
"""Agent de code"""
response = llm.invoke([
SystemMessage(content="Vous êtes un assistant en programmation, compétent pour répondre aux questions de code et fournir des exemples de code clairs."),
*state["messages"]
])
return {"messages": [response]}
def general_node(state: MessagesState) -> dict:
"""Agent général"""
response = llm.invoke([
SystemMessage(content="Vous êtes un assistant IA amical, capable de répondre à diverses questions."),
*state["messages"]
])
return {"messages": [response]}
def farewell_node(state: MessagesState) -> dict:
"""Nœud d'adieu"""
return {"messages": [{"role": "assistant", "content": "Au revoir ! Au plaisir de poursuivre notre conversation."}]}
# Construire le graphe
builder = StateGraph(MessagesState)
# Ajouter les nœuds
builder.add_node("router", router_node)
builder.add_node("weather_agent", weather_node)
builder.add_node("code_agent", code_node)
builder.add_node("general_agent", general_node)
builder.add_node("farewell", farewell_node)
# Ajouter des arêtes
builder.add_edge(START, "router")
builder.add_conditional_edges(
"router",
classify_intent,
{
"weather_agent": "weather_agent",
"code_agent": "code_agent",
"general_agent": "general_agent",
"farewell": "farewell",
}
)
# Terminer après que tous les nœuds d'agent ont été traités
for node in ["weather_agent", "code_agent", "general_agent", "farewell"]:
builder.add_edge(node, END)
# Compiler le graphe
graph = builder.compile()
# Tester différentes intentions
test_inputs = [
"Quel temps fait-il à Pékin aujourd'hui ?",
"Aide-moi à écrire un tri rapide en Python",
"Bonjour, présente-toi",
"Au revoir !"
]
for user_input in test_inputs:
print(f"\nUtilisateur : {user_input}")
result = graph.invoke({"messages": [HumanMessage(content=user_input)]})
print(f"Assistant : {result['messages'][-1].content[:100]}...")
print("-" * 50)
Exemple de résultat d'exécution :
User: 北京今天天气怎么样?
Assistant: 很抱歉,我没有实时天气数据。不过北京现在是春季,建议您出门时关注天气预报...
--------------------------------------------------

User: 帮我写一个 Python 快速排序
Assistant: 好的,下面是一个 Python 实现的快速排序算法:

```python
def quicksort(arr):
    if len(arr) <= 1:
        return arr
    ...
--------------------------------------------------

User: 你好,介绍一下你自己
Assistant: 你好!我是一个 AI 助手,很高兴为你服务。我可以帮你回答各种问题...
--------------------------------------------------

User: 再见啦!
Assistant: 再见!期待下次与你交流。
--------------------------------------------------
END. Si un nom non enregistré est renvoyé, le graphe lèvera une erreur lors de l'exécution.Créer un chatbot
Maintenant, utilisez ce que vous avez appris pour construire un robot qui prend en charge les conversations à plusieurs tours. Ce robot peut se souvenir du contexte de la conversation et offrir une expérience interactive continue.
Exemple
from dotenv import load_dotenv
from langgraph.graph import StateGraph, MessagesState, START, END
from langchain_openai import ChatOpenAI
from langchain_core.messages import SystemMessage, HumanMessage
load_dotenv()
# Initialiser le LLM (avec DeepSeek)
llm = ChatOpenAI(
model=os.getenv('DEEPSEEK_MODEL', 'deepseek-v4-pro'),
openai_api_key=os.getenv('DEEPSEEK_API_KEY'),
openai_api_base=os.getenv('DEEPSEEK_BASE_URL', 'https://api.deepseek.com'),
temperature=0.7
)
SYSTEM_PROMPT = """Vous êtes un assistant IA amical et professionnel.
Vos réponses doivent :
- Être concises et claires
- Répondre en chinois
- Poser activement des questions à l'utilisateur en cas de doute
"""
def chatbot_node(state: MessagesState) -> dict:
"""Nœud de conversation principal"""
system = SystemMessage(content=SYSTEM_PROMPT)
messages = [system] + state["messages"]
response = llm.invoke(messages)
return {"messages": [response]}
# Construire le graphe
builder = StateGraph(MessagesState)
builder.add_node("chatbot", chatbot_node)
builder.add_edge(START, "chatbot")
builder.add_edge("chatbot", END)
graph = builder.compile()
# Fonction de conversation multi-tours
def chat(conversation_history: list, user_input: str) -> tuple[str, list]:
"""Traite un seul tour de conversation, renvoie la réponse de l'IA et l'historique mis à jour"""
conversation_history.append(HumanMessage(content=user_input))
result = graph.invoke({"messages": conversation_history})
conversation_history = result["messages"]
ai_response = conversation_history[-1].content
return ai_response, conversation_history
# Exemple de conversation multi-tours
history = []
while True:
user_input = input("Vous : ")
if user_input.lower() in ["Exit", "exit", "quit"]:
print("Au revoir !")
break
response, history = chat(history, user_input)
print(f"Assistant : {response}\n")
Exemple de résultat d'exécution :
You: 你好,我叫小明
Assistant: 你好,小明!很高兴认识你。有什么我可以帮助你的吗?

You: 我想学习 Python 编程
Assistant: 太好了!Python 是一门很适合初学者的编程语言。我可以帮你从基础开始:
1. 首先了解变量和数据类型
2. 学习条件语句和循环
3. 掌握函数的定义和使用
你想从哪个部分开始呢?

You: 你还记得我叫什么吗?
Assistant: 当然记得,你叫小明!你刚才说想学习 Python 编程,我们可以继续这个话题。

You: 退出
再见!
Appel d'outils - Agent ReAct
Permettre à l'Agent d'utiliser des outils externes est l'une des fonctionnalités les plus puissantes de LangGraph.ReAct(Reason + Act) est le modèle d'Agent le plus courant : le LLM réfléchit -> sélectionne un outil -> exécute l'outil -> observe le résultat -> continue de réfléchir.
Définir les outils
Tout d'abord, définissez les outils que l'Agent peut utiliser :
from langchain_core.tools import tool

@tool
def search_web(query: str) -> str:
    """搜索网络获取最新信息。

    Args:
        query: 搜索关键词

    Returns:
        搜索结果摘要
    """
    # 实际项目中替换为真实搜索 API
    return f"关于 '{query}' 的搜索结果:这是模拟的搜索结果..."

@tool
def calculate(expression: str) -> str:
    """计算数学表达式。

    Args:
        expression: 数学表达式,如 '2 + 2' 或 '100 * 0.8'

    Returns:
        计算结果
    """
    import ast
    import operator

    # 安全的运算符映射
    ops = {
        ast.Add: operator.add,
        ast.Sub: operator.sub,
        ast.Mult: operator.mul,
        ast.Div: operator.truediv,
        ast.Pow: operator.pow,
        ast.USub: operator.neg,
    }

    def safe_eval(node):
        if isinstance(node, ast.Expression):
            return safe_eval(node.body)
        elif isinstance(node, ast.Constant):
            return node.value
        elif isinstance(node, ast.BinOp):
            left = safe_eval(node.left)
            right = safe_eval(node.right)
            return ops[type(node.op)](left, right)
        elif isinstance(node, ast.UnaryOp):
            operand = safe_eval(node.operand)
            return ops[type(node.op)](operand)
        else:
            raise ValueError(f"不支持的表达式类型: {type(node)}")

    try:
        tree = ast.parse(expression, mode='eval')
        result = safe_eval(tree)
        return f"计算结果: {expression} = {result}"
    except Exception as e:
        return f"计算错误: {str(e)}"

@tool
def get_weather(city: str) -> str:
    """获取指定城市的天气信息。

    Args:
        city: 城市名称

    Returns:
        天气信息
    """
    # 实际项目中替换为真实天气 API
    return f"{city} 今日天气:晴,温度 22C,湿度 60%"

tools = [search_web, calculate, get_weather]
eval(). L'utilisation directeeval()présente de graves risques de sécurité car elle peut exécuter du code Python arbitraire. Dans les environnements de production, veillez à utiliser une méthode d'analyse d'expression sécurisée.Créer un agent ReAct
Exemple
from dotenv import load_dotenv
from langgraph.graph import StateGraph, MessagesState, START, END
from langgraph.prebuilt import ToolNode, tools_condition
from langchain_openai import ChatOpenAI
from langchain_core.tools import tool
from langchain_core.messages import HumanMessage
import ast
import operator
load_dotenv()
# Définir les outils
@tool
def search_web(query: str) -> str:
"""Rechercher sur le web pour obtenir les dernières informations."""
return f"Résultats de recherche pour '{query}' : Ceci est un résultat de recherche simulé..."
@tool
def calculate(expression: str) -> str:
"""Calculer une expression mathématique."""
ops = {
ast.Add: operator.add,
ast.Sub: operator.sub,
ast.Mult: operator.mul,
ast.Div: operator.truediv,
ast.Pow: operator.pow,
ast.USub: operator.neg,
}
def safe_eval(node):
if isinstance(node, ast.Expression):
return safe_eval(node.body)
elif isinstance(node, ast.Constant):
return node.value
elif isinstance(node, ast.BinOp):
left = safe_eval(node.left)
right = safe_eval(node.right)
return ops[type(node.op)](left, right)
elif isinstance(node, ast.UnaryOp):
operand = safe_eval(node.operand)
return ops[type(node.op)](operand)
else:
raise ValueError(f"Type d'expression non pris en charge : {type(node)}")
try:
tree = ast.parse(expression, mode='eval')
result = safe_eval(tree)
return f"Résultat du calcul : {expression} = {result}"
except Exception as e:
return f"Erreur de calcul : {str(e)}"
@tool
def get_weather(city: str) -> str:
"""Obtenir les informations météorologiques pour une ville spécifiée."""
return f"{city} Météo aujourd'hui : ensoleillé, 22C, humidité 60%"
tools = [search_web, calculate, get_weather]
# Initialiser le LLM et lier les outils
llm = ChatOpenAI(
model=os.getenv('DEEPSEEK_MODEL', 'deepseek-v4-pro'),
openai_api_key=os.getenv('DEEPSEEK_API_KEY'),
openai_api_base=os.getenv('DEEPSEEK_BASE_URL', 'https://api.deepseek.com'),
temperature=0
)
llm_with_tools = llm.bind_tools(tools)
def agent_node(state: MessagesState) -> dict:
"""Nœud de raisonnement de l'agent : Appeler le LLM pour décider de l'action suivante"""
response = llm_with_tools.invoke(state["messages"])
return {"messages": [response]}
# Construire le graphe ReAct
builder = StateGraph(MessagesState)
# Ajouter les nœuds
builder.add_node("agent", agent_node)
builder.add_node("tools", ToolNode(tools)) # Le ToolNode intégré gère automatiquement les appels d'outils
# Ajouter des arêtes
builder.add_edge(START, "agent")
# Routage conditionnel : si le LLM demande un outil, exécuter l'outil ; sinon, terminer
builder.add_conditional_edges(
"agent",
tools_condition, # Fonction de routage intégrée
{
"tools": "tools",
END: END
}
)
# Une fois l'outil exécuté, revenir à l'agent pour poursuivre le raisonnement
builder.add_edge("tools", "agent")
graph = builder.compile()
# Test
result = graph.invoke({
"messages": [HumanMessage(content="Quel temps fait-il à Pékin aujourd'hui ? Aide-moi aussi à calculer 1234 * 5678")]
})
for message in result["messages"]:
print(f"[{message.type}]: {message.content[:200] if message.content else '(appel d’outil)'}")
Diffusion en continu du processus d'appel des outils
# 流式观察 Agent 的每一步
for chunk in graph.stream(
    {"messages": [HumanMessage(content="搜索 LangGraph 的最新特性")]},
    stream_mode="updates"
):
    for node_name, updates in chunk.items():
        print(f"\n=== 节点: {node_name} ===")
        for msg in updates.get("messages", []):
            if hasattr(msg, "tool_calls") and msg.tool_calls:
                for tc in msg.tool_calls:
                    print(f"  -> 调用工具: {tc['name']}({tc['args']})")
            else:
                print(f"  -> 输出: {msg.content[:200] if msg.content else '(无内容)'}")
ToolNodeettools_conditionest un composant intégré de LangGraph.ToolNodeAnalyser automatiquement les appels d'outils renvoyés par le LLM et exécuter les fonctions d'outil correspondantes.tools_conditionC'est une fonction de routage qui vérifie si la sortie du LLM contient une demande d'appel d'outil. Si c'est le cas, elle renvoie "tools" ; sinon, elle renvoie END.Collaboration humain dans la boucle
LangGraph prend nativement en charge la pause pendant l'exécution du flux de travail pour attendre une révision ou une entrée humaine. C'est très utile pour les opérations sensibles qui nécessitent une confirmation humaine.
Utiliser interrupt pour suspendre l'exécution
from langgraph.types import interrupt
from langgraph.checkpoint.memory import MemorySaver

def sensitive_action_node(state: MessagesState) -> dict:
    """执行敏感操作前请求人工审批"""
    last_msg = state["messages"][-1].content

    # 暂停图的执行,等待人工决策
    human_decision = interrupt({
        "question": "是否批准执行以下操作?",
        "action": last_msg,
        "risk_level": "中等"
    })

    if human_decision == "approve":
        return {"messages": [{"role": "assistant", "content": "操作已批准并执行完毕。"}]}
    else:
        return {"messages": [{"role": "assistant", "content": "操作已取消。"}]}

# 必须使用 checkpointer 才能支持 interrupt
checkpointer = MemorySaver()
graph = builder.compile(checkpointer=checkpointer)
Flux de travail d'approbation complet
Exemple
from dotenv import load_dotenv
from langgraph.graph import StateGraph, MessagesState, START, END
from langgraph.types import Command, interrupt
from langgraph.checkpoint.memory import MemorySaver
from langchain_core.messages import HumanMessage
load_dotenv()
def request_node(state: MessagesState) -> dict:
"""Recevoir la requête de l'utilisateur"""
return {"messages": state["messages"]}
def approval_node(state: MessagesState) -> dict:
"""Nœud d'approbation : mettre en pause et attendre l'approbation humaine"""
last_msg = state["messages"][-1].content
# Suspendre l'exécution et attendre la décision humaine
human_decision = interrupt({
"question": "Approuver l'opération suivante ?",
"action": last_msg
})
if human_decision == "approve":
return {"messages": [{"role": "assistant", "content": f"Opération approuvée : {last_msg}"}]}
else:
return {"messages": [{"role": "assistant", "content": "Opération rejetée."}]}
def execute_node(state: MessagesState) -> dict:
"""Nœud d'exécution"""
return {"messages": [{"role": "assistant", "content": "Exécution de la tâche terminée !"}]}
# Construire le graphe
builder = StateGraph(MessagesState)
builder.add_node("request", request_node)
builder.add_node("approval", approval_node)
builder.add_node("execute", execute_node)
builder.add_edge(START, "request")
builder.add_edge("request", "approval")
builder.add_edge("approval", "execute")
builder.add_edge("execute", END)
# Compiler le graphe avec un checkpointer
checkpointer = MemorySaver()
graph = builder.compile(checkpointer=checkpointer)
# Utilisez un thread_id unique pour chaque conversation
config = {"configurable": {"thread_id": "approval-session-001"}}
# Étape 1 : Démarrez le graphe ; il se mettra en pause au niveau de l'interruption
print("=== Étape 1 : Soumettre la requête ===")
result = graph.invoke(
{"messages": [HumanMessage(content="Veuillez supprimer toutes les données de test dans la base de données")]},
config=config
)
print("Graphe en pause, en attente d'approbation...")
# Étape 2 : Après approbation humaine, reprendre l'exécution avec Command
print("\n"=== Étape 2 : Approbation humaine ===")
# Approuver l'opération
result = graph.invoke(
Command(resume="approve"),
config=config
)
print(f"Résultat final : {result['messages'][-1].content}")
# Si vous souhaitez rejeter, utilisez :
# graph.invoke(Command(resume="reject"), config=config)
Définir des points d'arrêt sur les arêtes
# 另一种方式:在编译时指定断点
graph = builder.compile(
    checkpointer=checkpointer,
    interrupt_before=["sensitive_node"],   # 执行该节点前暂停
    # interrupt_after=["review_node"],     # 执行该节点后暂停
)
checkpointerest d'implémenterinterruptLe prérequis pour la fonctionnalité. Sans checkpointer, le graphe ne peut pas sauvegarder son état en pause, et donc ne peut pas reprendre l'exécution. MemorySaver convient au développement et aux tests ; pour les environnements de production, il est recommandé d'utiliser SqliteSaver ou un autre stockage persistant.Mémoire persistante
LangGraph fournit un mécanisme de persistance d'état intégré qui permet aux agents de se souvenir de l'historique de conversation entre les sessions.
Stockage en mémoire (adapté au développement et aux tests)
from langgraph.checkpoint.memory import MemorySaver

checkpointer = MemorySaver()
graph = builder.compile(checkpointer=checkpointer)

# 使用 thread_id 区分不同会话
config_user_a = {"configurable": {"thread_id": "user-alice"}}
config_user_b = {"configurable": {"thread_id": "user-bob"}}

# Alice 的对话
graph.invoke({"messages": [HumanMessage(content="我叫 Alice")]}, config=config_user_a)
graph.invoke({"messages": [HumanMessage(content="我叫什么名字?")]}, config=config_user_a)
# Agent 能记住:你叫 Alice

# Bob 的对话完全独立
graph.invoke({"messages": [HumanMessage(content="我叫什么名字?")]}, config=config_user_b)
# Agent 不知道 Bob 的名字(不同 thread_id)
Stockage persistant SQLite (adapté aux projets locaux)
# 安装依赖
# pip install langgraph-checkpoint-sqlite

from langgraph.checkpoint.sqlite import SqliteSaver

# 数据持久化到文件,程序重启后对话历史仍存在
with SqliteSaver.from_conn_string("./chat_memory.db") as checkpointer:
    graph = builder.compile(checkpointer=checkpointer)

    config = {"configurable": {"thread_id": "persistent-chat"}}

    # 第一次运行
    graph.invoke({"messages": [HumanMessage(content="我叫张三")]}, config=config)

    # 程序重启后再次运行,记忆仍然存在
    result = graph.invoke(
        {"messages": [HumanMessage(content="你还记得我叫什么吗?")]},
        config=config
    )
Afficher l'historique de conversation
# 获取某个 thread 的完整状态历史
history = list(graph.get_state_history(config))

for snapshot in history:
    print(f"时间: {snapshot.created_at}")
    print(f"消息数: {len(snapshot.values['messages'])}")
    print("---")

# 获取当前状态
current_state = graph.get_state(config)
print(f"当前消息数: {len(current_state.values['messages'])}")
thread_idIl s'agit de l'identifiant unique de la session, utilisé pour isoler l'état de différents utilisateurs ou de différentes conversations. Tous les appels avec le même thread_id partagent l'historique de conversation, et différents thread_ids sont complètement indépendants. Dans les scénarios multi-utilisateurs, un ID utilisateur ou un ID de session est généralement utilisé comme thread_id.Systèmes multi-agents
LangGraph excelle dans la coordination de plusieurs agents spécialisés pour travailler ensemble. En décomposant des tâches complexes et en les confiant à différents agents experts, il peut atteindre des capacités de résolution de problèmes plus puissantes.
Modèle superviseur
Exemple
from dotenv import load_dotenv
from langgraph.graph import StateGraph, MessagesState, START, END
from langchain_openai import ChatOpenAI
from langchain_core.messages import SystemMessage, HumanMessage
load_dotenv()
# Initialiser le LLM
llm = ChatOpenAI(
model=os.getenv('DEEPSEEK_MODEL', 'deepseek-v4-pro'),
openai_api_key=os.getenv('DEEPSEEK_API_KEY'),
openai_api_base=os.getenv('DEEPSEEK_BASE_URL', 'https://api.deepseek.com'),
temperature=0
)
# Définir des agents experts
def research_agent(state: MessagesState) -> dict:
"""Agent de recherche : responsable de la collecte d'informations"""
system = SystemMessage(content="Vous êtes un chercheur professionnel, responsable de la collecte et de l'organisation des informations. Veuillez résumer les informations clés de manière concise.")
response = llm.invoke([system] + state["messages"])
return {"messages": [response]}
def writing_agent(state: MessagesState) -> dict:
"""Agent de rédaction : responsable de la création de contenu"""
system = SystemMessage(content="Vous êtes un rédacteur professionnel, responsable de la rédaction de contenu à partir des informations existantes. Veuillez garder le contenu clair et fluide.")
response = llm.invoke([system] + state["messages"])
return {"messages": [response]}
def review_agent(state: MessagesState) -> dict:
"""Agent de révision : responsable du contrôle qualité"""
system = SystemMessage(content="Vous êtes un éditeur professionnel, responsable de la révision et de l'amélioration de la qualité du contenu. Veuillez signaler les problèmes et donner des suggestions d'amélioration.")
response = llm.invoke([system] + state["messages"])
return {"messages": [response]}
# L'agent superviseur décide du flux de travail
def supervisor_node(state: MessagesState) -> dict:
"""Superviseur : coordonne le travail de chaque Agent expert"""
system = SystemMessage(content="""Vous êtes un superviseur de workflow.
Déterminer quel Agent doit gérer l'étape suivante en fonction de l'avancement de la tâche.
Analyser l'historique de la conversation et renvoyer uniquement l'un des éléments suivants : RESEARCH, WRITING, REVIEW, FINISH
- RESEARCH : Besoin de collecter plus d'informations
- WRITING : Les informations sont suffisantes, on peut commencer à écrire
REVIEW : Rédaction terminée, nécessite une relecture
FINISH : Tâche terminée
""")
response = llm.invoke([system] + state["messages"])
return {"messages": [response]}
def route_by_supervisor(state: MessagesState) -> str:
"""Router selon la décision du superviseur"""
last_msg = state["messages"][-1].content.strip().upper()
if "RESEARCH" in last_msg:
return "research"
elif "WRITING" in last_msg:
return "writing"
elif "REVIEW" in last_msg:
return "review"
else:
return END
# Construire un graphe multi-agents
builder = StateGraph(MessagesState)
builder.add_node("supervisor", supervisor_node)
builder.add_node("research", research_agent)
builder.add_node("writing", writing_agent)
builder.add_node("review", review_agent)
builder.add_edge(START, "supervisor")
builder.add_conditional_edges("supervisor", route_by_supervisor)
# Après la fin de chaque expert, revenir au superviseur
for agent in ["research", "writing", "review"]:
builder.add_edge(agent, "supervisor")
graph = builder.compile()
# Tester la collaboration multi-agents
result = graph.invoke({
"messages": [HumanMessage(content="Veuillez m'aider à écrire un court article d'introduction sur les décorateurs Python")]
})
print("=== Collaboration multi-agents terminée ===")
for i, msg in enumerate(result["messages"]):
print(f"\n[{i+1}] {msg.type}: {msg.content[:150]}...")
Sous-graphe
Encapsuler des sous-processus complexes sous forme de sous-graphes et les réutiliser dans le graphe principal :
# 将复杂子流程封装为子图,在主图中复用
sub_builder = StateGraph(MessagesState)
sub_builder.add_node("step1", step1_node)
sub_builder.add_node("step2", step2_node)
sub_builder.add_edge(START, "step1")
sub_builder.add_edge("step1", "step2")
sub_builder.add_edge("step2", END)
sub_graph = sub_builder.compile()

# 在主图中使用子图
main_builder = StateGraph(MessagesState)
main_builder.add_node("preprocessing", preprocess_node)
main_builder.add_node("sub_workflow", sub_graph)  # 直接使用编译好的子图
main_builder.add_node("postprocessing", postprocess_node)

main_builder.add_edge(START, "preprocessing")
main_builder.add_edge("preprocessing", "sub_workflow")
main_builder.add_edge("sub_workflow", "postprocessing")
main_builder.add_edge("postprocessing", END)

main_graph = main_builder.compile()
Débogage visuel avec LangGraph Studio
LangGraph Studio est l'environnement de développement visuel officiel qui vous permet de visualiser en temps réel le processus d'exécution de l'Agent, ce qui améliore grandement l'efficacité du développement et du débogage.
Installer LangGraph CLI
pip install langgraph-cli -i https://mirrors.aliyun.com/pypi/simple/
Créer le fichier de configuration du projet
Créer dans le répertoire racine du projetlanggraph.jsonFichier de configuration :
{
  "dependencies": ["."],
  "graphs": {
    "my_agent": "./my_agent.py:graph"
  },
  "env": ".env"
}
Démarrer le serveur de développement
langgraph dev
Après le démarrage, visitezhttp://localhost:8123Vous pouvez ensuite utiliser LangGraph Studio dans votre navigateur.
Principales fonctionnalités de Studio
- Visualisation en temps réel: Affiche graphiquement le processus d'exécution des nœuds pour comprendre intuitivement l'état du workflow
- Inspection de l'état: Mettez en pause à n'importe quel nœud pour consulter l'état actuel, ce qui facilite le diagnostic des problèmes
- Voyage dans le temps: Rejouez les étapes d'exécution historiques pour suivre les changements d'état à chaque étape
- Rechargement à chaud: Met automatiquement à jour la structure du graphe après les modifications de code, aucun redémarrage du service n'est nécessaire
Bonnes pratiques et FAQ
Bonnes pratiques
Points clés de la conception de l'état
- Gardez l'état concis, ne contenant que les champs nécessaires
- Définissez des reducers explicites pour les champs complexes (par ex.
add_messages) - Utilisez des modèles Pydantic pour valider les types d'état dans les environnements de production
- Évitez de stocker des objets trop volumineux dans l'état ; envisagez d'utiliser un stockage externe
Points clés de la conception des nœuds
- Chaque nœud a une responsabilité unique, ce qui facilite les tests et la réutilisation
- Les fonctions de nœud doivent être idempotentes (même entrée produit même sortie)
- Évitez de modifier directement l'état transmis dans les nœuds ; retournez plutôt de nouvelles valeurs
- Utilisez raisonnablement des nœuds asynchrones pour les opérations intensives en E/S
Gestion des erreurs
def robust_node(state: AgentState) -> dict:
    try:
        result = risky_operation(state)
        return {"messages": [result], "error": None}
    except Exception as e:
        return {
            "error": str(e),
            "messages": [{"role": "assistant", "content": f"操作失败: {e}"}]
        }
Évitez les boucles infinies
def route_with_limit(state: AgentState) -> str:
    # 设置最大重试次数,防止无限循环
    if state.get("retry_count", 0) >= 3:
        return END

    if needs_retry(state):
        return "retry_node"
    return END
Questions fréquemment posées (FAQ)
Q1 : Que faire si le format de la valeur de retour d'un nœud est incorrect ?
# 错误:直接修改 state 对象
def bad_node(state):
    state["messages"].append(...)  # 不要直接修改
    return state

# 正确:返回需要更新的字段
def good_node(state):
    return {"messages": [new_message]}  # 只返回变更字段
Q2 : Comment transmettre des données temporaires entre les nœuds ?
Ajoutez des données temporaires à la définition de State, ou utilisez une convention de préfixe avec un underscore pour les champs internes :
from typing import TypedDict

class PublicState(TypedDict):
    messages: list  # 对外暴露

class PrivateState(TypedDict):
    messages: list
    _internal_cache: dict  # 以下划线开头约定为内部使用
Q3 : Comment déboguer le processus d'exécution des nœuds ?
# 使用 stream 模式观察每个节点的输出
for event in graph.stream(initial_state, stream_mode="updates"):
    for node_name, state_update in event.items():
        print(f"\n[节点: {node_name}]")
        print(f"更新: {state_update}")
Q4 : Quelle est la différence entre StateGraph et MessageGraph ?
MessageGraphC'est une version antérieure de l'API, avec des fonctionnalités relativement limitées. Il est désormais recommandé d'utiliser uniformémentStateGraph, qui est plus flexible et riche en fonctionnalités. Pour gérer les messages, utilisezStateGraph(MessagesState)ou personnalisez-en un qui contientmessagesdes champs dans le State.
MessageGrapha été déprécié, veuillez utiliser uniformémentStateGraph. Si votre code utilise encore MessageGraph, il est recommandé de migrer vers StateGraph(MessagesState) dès que possible pour une meilleure prise en charge et plus de fonctionnalités.Résumé
Cet article présente systématiquement les concepts fondamentaux et les applications pratiques du framework LangGraph. Grâce à l'orchestration de flux de travail basée sur des graphes, LangGraph permet aux développeurs de construire des agents IA complexes avec des capacités telles que les boucles, le branchement et la persistance d'état. Comparé aux chaînes LLM linéaires traditionnelles, LangGraph présente des avantages significatifs dans les scénarios nécessitant un raisonnement multi-étapes, une collaboration homme-machine et une coordination multi-agents.
| Concept | Description | Code clé |
|---|---|---|
| StateGraph | Moteur de flux de travail à graphe orienté, le cœur de LangGraph | StateGraph(MyState) |
| State | Structure de données d'état partagée entre les nœuds | TypedDict + Annotated |
| Nœuds | Nœuds de fonction qui exécutent des opérations spécifiques | builder.add_node() |
| Arêtes | Chemins de flux entre les nœuds, prenant en charge le branchement conditionnel | add_edge() / add_conditional_edges() |
| Agent ReAct | Mode de boucle raisonnement + action | ToolNode + tools_condition |
| Humain dans la boucle | Mécanisme d'approbation et d'intervention humaines | interrupt() + Command(resume=) |
| Persistance | Mémoire de session et sauvegarde de l'état | MemorySaver / SqliteSaver |
| Multi-agents | Système de collaboration multi-experts | Modèle superviseur |