DeepSeek Harness Multimodal
DeepSeek ha lanzado el modelo experimental de comprensión visual multimodal DeepSeek-V4-Flash-Vision-Exp, y ha abierto simultáneamente el servicio de API multimodal y la API gratuita de Files.
Antes de usarlo, instala la versión más reciente:
npm install -g @deepseek-ai/dsh@latest
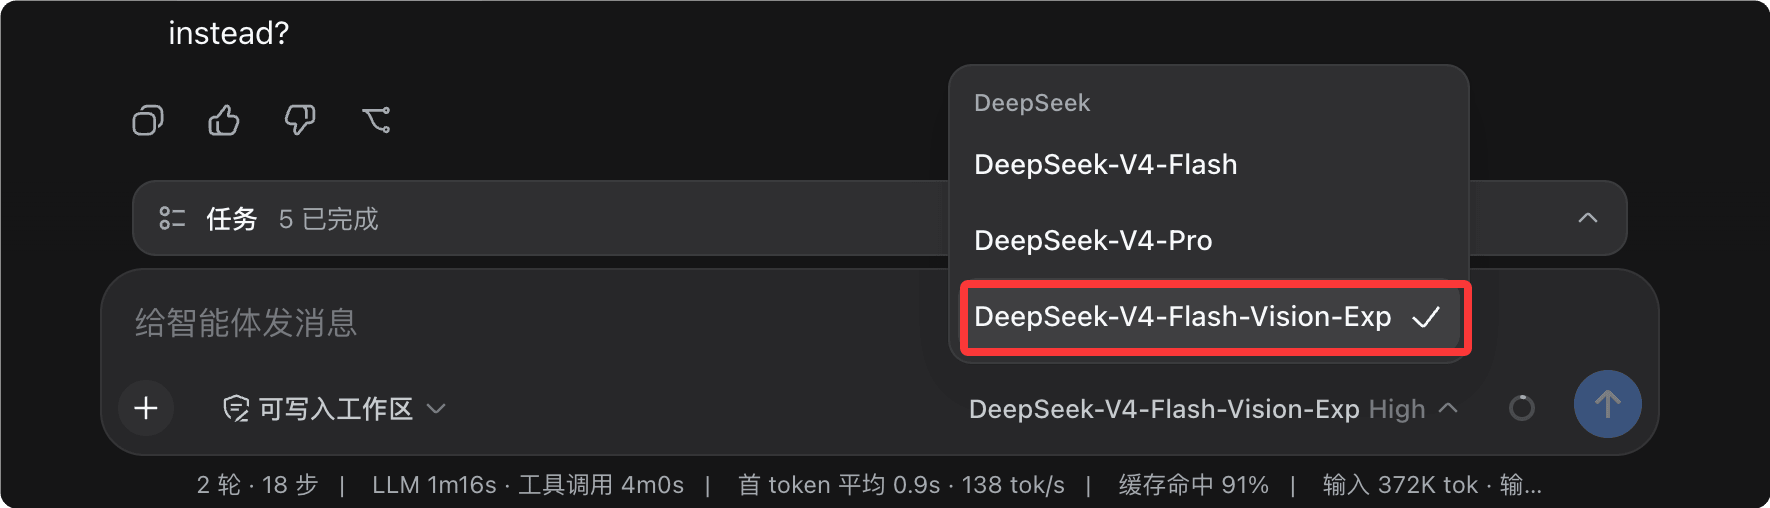
Después de actualizar a la última versión, puedes ver que el modelo ya tiene DeepSeek-V4-Flash-Vision-Exp:
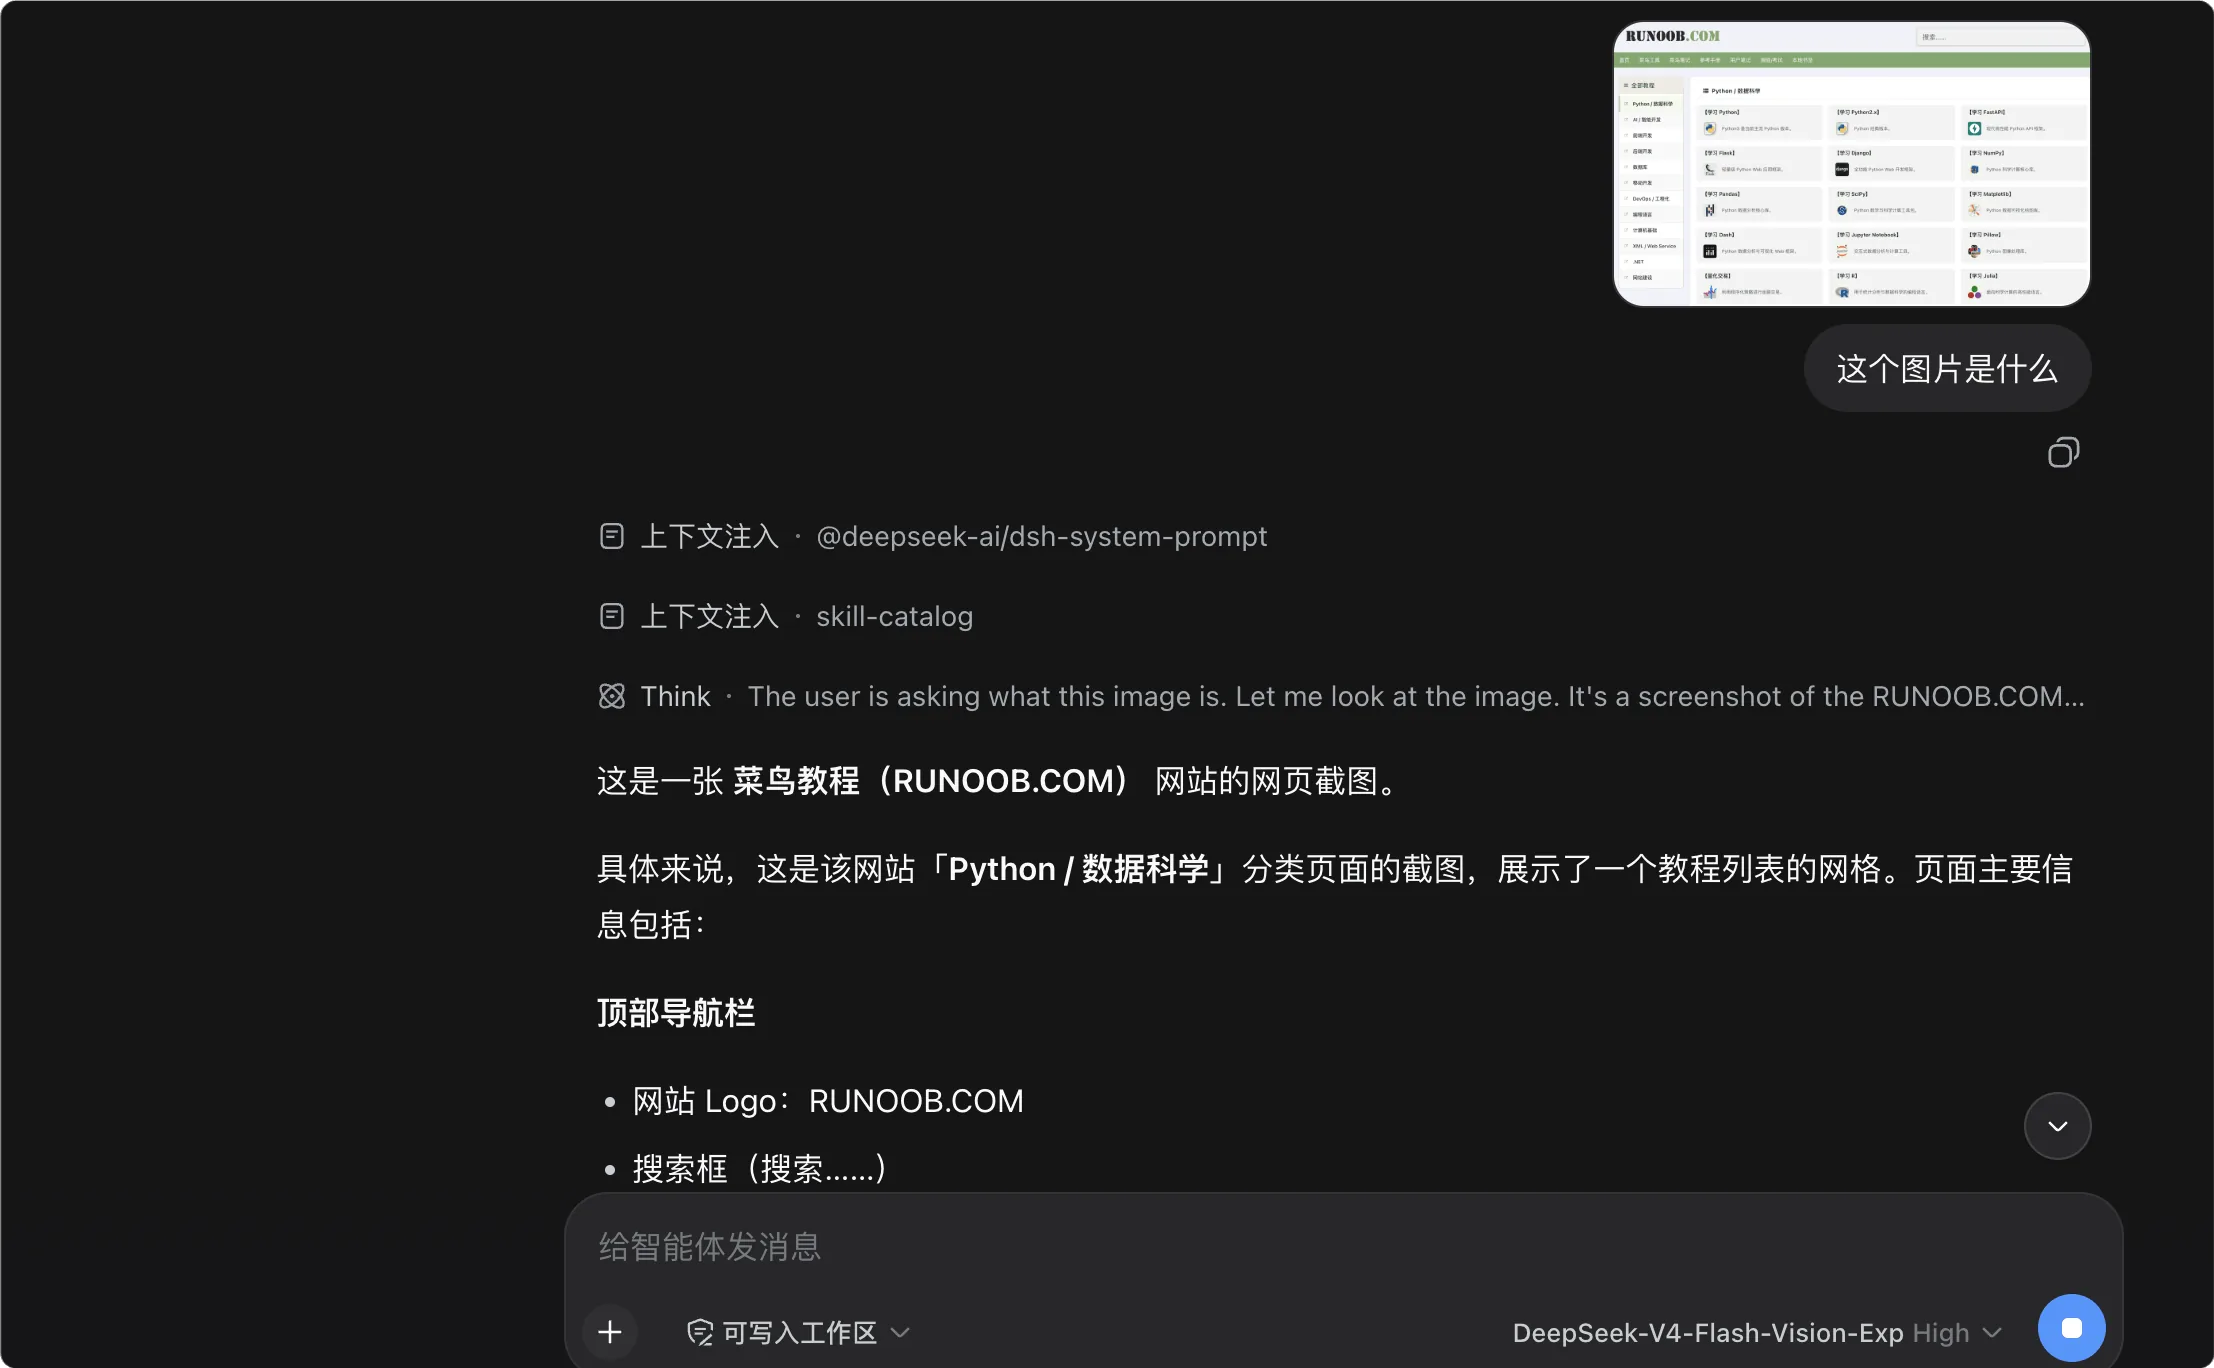
Cambia al modelo de visión y luego podemos arrastrar directamente imágenes o archivos ppt al documento para que vea el contenido de las imágenes ( Descargar imagen de prueba):
Qué es multimodal
Para entender multimodal, primero hay que entender la palabra "modalidad" (modality). La modalidad se refiere a las diferentes formas de representación de la información: el texto es una modalidad; la imagen, el audio y el video también son modalidades distintas.
| Modalidad | Forma común | Capacidad de IA correspondiente |
|---|---|---|
| Texto | Artículos, código, conversaciones | Modelo de lenguaje grande (LLM) |
| Imagen | Fotos, capturas de pantalla, diseños, gráficos | Modelo de comprensión visual |
| Audio | Voz, música | Modelos de reconocimiento y generación de voz |
| Video | Cortometrajes, grabaciones de pantalla, imágenes de vigilancia | Modelo de comprensión de video |
En el pasado, los modelos de lenguaje grandes solo procesaban una modalidad, el texto. Todo lo que les enviaras debía convertirse primero en texto.
Los modelos multimodales pueden recibir imágenes y texto simultáneamente, unificándolos en una secuencia de tokens para procesarlos juntos.

La clave es: la imagen no es "vista directamente" por el modelo; primero el codificador visual la divide en parches (patch) y la convierte en vectores, que luego se combinan con los tokens de texto en la misma secuencia.
Las imágenes también consumen tokens; una imagen ocupa hasta 384 tokens, que es precisamente el origen de las reglas de facturación multimodal que se explican más adelante.
Para los agentes, la multimodalidad representa un cambio cualitativo, no un simple añadido.
| Elemento de comparación | Modelo de solo texto | Modelo multimodal |
|---|---|---|
| Forma de entrada | Solo texto | Texto e imágenes combinados |
| Depurar errores de código | El usuario debe transcribir manualmente el error como texto | Enviar directamente la captura de pantalla del error |
| Reproducir el diseño | No puede consultar el diseño visual | Escribir la página directamente comparando con el diseño |
| Analizar gráficos de datos | No puede leer los gráficos dentro de la imagen | Ver la imagen y dar conclusiones directamente |
V4-Flash-Vision-Exp: modelo de visión multimodal disponible
DeepSeek-V4-Flash-Vision-Exp es un modelo experimental de comprensión visual multimodal, ya disponible en la plataforma API de DeepSeek.
Los usuarios pueden acceder a este modelo configurandomodel='deepseek-v4-flash-vision-exp'.
Su posicionamiento de capacidades puede resumirse en una frase: las capacidades de texto no se reducen, las capacidades visuales dan un gran salto.
En capacidades de solo texto (Agent, razonamiento, conocimiento mundial, etc.), está a la par con la versión oficial de DeepSeek-V4-Flash.
En los Agent Benchmark que requieren comprensión visual, ha logrado un gran avance en comparación con DeepSeek-V4-Flash, y su capacidad multimodal como agente se acerca a Opus-4.8.
| Dimensión de capacidad | DeepSeek-V4-Flash | DeepSeek-V4-Flash-Vision-Exp |
|---|---|---|
| Tareas de agente de solo texto | Referencia de la versión oficial | A la par con la versión oficial |
| Razonamiento y conocimiento mundial | Referencia de la versión oficial | A la par con la versión oficial |
| Tareas de agente con comprensión visual | No compatible; los elementos multimodales se ignoran en la evaluación | Gran salto, cerca de Opus-4.8 |
| Posicionamiento del modelo | Versión oficial | Versión experimental |
Nota sobre el criterio de evaluación: para las tareas de texto de Code Agent en los conjuntos de referencia públicos, los modelos de la serie DeepSeek se prueban utilizando el modo minimalista de DeepSeek Harness como marco, con el nivel max, temperature=1.0, topp=0.95.
En las evaluaciones de ApexBench y Agents' Last Exam, el modelo de texto DeepSeek-V4-Flash ignora los elementos multimodales.
Inicio rápido de la API multimodal
La API multimodal admite tres formatos de llamada: Chat Completions, Messages y Responses, lo que permite integrarse fácilmente con diversas herramientas de agente.
Las capacidades de los tres formatos son equivalentes; elige según el estilo de interfaz que te resulte familiar.
| Formato de llamada | Estilo de interfaz | Para quién es adecuado |
|---|---|---|
| Chat Completions | Interfaz de diálogo clásica de OpenAI | Desarrolladores que ya tienen código con SDK de OpenAI |
| Messages | Interfaz Messages de Anthropic, base_url es https://api.deepseek.com/anthropic | Desarrolladores que ya tienen código o herramientas con estilo Anthropic |
| Responses | Nueva interfaz Responses de OpenAI | Desarrolladores que usan SDK nuevos y prefieren estructuras de entrada simples |
Los tres formatos admiten entrada mixta de imagen y texto. Las imágenes tienen tres métodos de entrada: base64 en línea, URL externa y API de Files.

| Método de entrada | Tamaño del cuerpo de la solicitud | ¿Necesita alojamiento de imágenes? | Escenario adecuado |
|---|---|---|---|
| base64 en línea | grande | No | Imágenes locales, imágenes pequeñas de un solo uso |
| URL externa | Pequeño | Sí | Imagen ya desplegada en un servidor de acceso público |
| Files API | Pequeño | No | Reutilizar la misma imagen varias veces, tareas masivas de alta frecuencia |
Método 1: base64 en línea
La imagen local se codifica como cadena base64 y se escribe directamente en el cuerpo de la solicitud como URL de datos.
Ejemplo
# Dependencia: pip install openai
import base64
from openai import OpenAI
# El endpoint de DeepSeek es compatible con el SDK de OpenAI; cambia base_url para alternar
client = OpenAI(
api_key="sk-tu-clave", # Obligatorio: reemplázalo con tu propia clave de API de DeepSeek
base_url="https://api.deepseek.com" # Obligatorio: endpoint oficial de DeepSeek
)
# Lee la imagen local y la codifica como cadena base64
with open("ejemplo-logo.png", "rb") as f:
b64 = base64.b64encode(f.read()).decode("utf-8")
response = client.chat.completions.create(
model="deepseek-v4-flash-vision-exp", # Obligatorio: modelo de comprensión visual multimodal
messages=[
{
"role": "user",
"content": [
# El texto y las imágenes se mezclan en orden según la matriz; el modelo comprende en orden
{"type": "text", "text": "¿Qué dice el texto en la imagen?"},
{
"type": "image_url",
# base64 en línea: data:formato_de_imagen;base64,contenido_codificado
"image_url": {"url": f"data:image/png;base64,{b64}"}
}
]
}
],
stream=False # Opcional: si se emite en streaming; el valor predeterminado es False
)
print(response.choices[0].message.content)
Salida de ejecución:
图片中的文字是 "EJEMPLO"。
Método 2: URL externa
La imagen está desplegada en un servidor de acceso público. La solicitud solo envía una cadena URL, por lo que el cuerpo de la solicitud es muy pequeño.
Ejemplo
curl https://api.deepseek.com/chat/completions \
-H "Content-Type: application/json" \
-H "Authorization: Bearer ${DEEPSEEK_API_KEY}" \
-d '{
"model": "deepseek-v4-flash-vision-exp",
"messages": [
{
"role": "user",
"content": [
{"type": "text", "text": "Resume la tendencia de este gráfico en un párrafo"},
{"type": "image_url", "image_url": {"url": "https://static.example.com/images/chart-demo.png"}}
]
}
]
}'
La URL debe ser una dirección pública accesible desde la plataforma. Las direcciones de intranet y las direcciones de bucle local no pueden ser recuperadas.
Tanto base64 como URL pueden añadir un campo opcional detail en image_url para controlar la precisión de análisis de la imagen.
| Valor de detail | Comportamiento | Escenario adecuado |
|---|---|---|
| low | Redimensionar a 512×512 y luego analizar, menor consumo de tokens | Solo necesitas ver aproximadamente: identificar el tipo de imagen, encontrar el sujeto principal. |
| high | Equivalente a original. | Necesitas ver los detalles con claridad. |
| original | Conservar el análisis de precisión de la imagen original. | Leer texto, ver iconos pequeños, analizar gráficos. |
| auto | Actualmente equivalente a original. | Valor predeterminado, comportamiento cuando no se pasa detail. |
Al ejecutar tareas de capturas de pantalla en lote, establecer detail en low es la forma más directa de controlar los costos multimodales.
Formatos Messages y Responses
Quienes ya tienen código estilo Anthropic o el nuevo estilo OpenAI pueden cambiar casi sin problemas a la multimodalidad de DeepSeek.
El formato Messages utiliza bloques de contenido image, y las imágenes se pasan mediante el campo source.
Ejemplo
# El endpoint utiliza la ruta compatible con Anthropic de DeepSeek /anthropic, y los campos de cabecera también coinciden con Anthropic.
curl https://api.deepseek.com/anthropic/v1/messages \
-H "Content-Type: application/json" \
-H "x-api-key: ${DEEPSEEK_API_KEY}" \
-d '{
"model": "deepseek-v4-flash-vision-exp",
"max_tokens": 1024,
"messages": [
{
"role": "user",
"content": [
{
"type": "image",
"source": {
"type": "url",
"url": "https://static.example.com/images/code-screenshot.png"
}
},
{"type": "text", "text": "Este código dará error al ejecutarse, ¿en qué línea está el problema?"}
]
}
]
}'
El formato Responses utiliza el arreglo input; el texto usa input_text y las imágenes usan input_image.
Ejemplo
# La forma de crear client es la misma que en el ejemplo base64 anterior.
response = client.responses.create(
model="deepseek-v4-flash-vision-exp", # Obligatorio: modelo de comprensión visual multimodal.
input=[
{
"role": "user",
"content": [
# El texto usa input_text, las imágenes usan input_image.
{"type": "input_text", "text": "Convierte las tablas de la captura de pantalla en Markdown".},
{
"type": "input_image",
"image_url": "https://static.example.com/images/table.png"
}
]
}
]
)
# En el formato Responses, basta con tomar output_text directamente.
print(response.output_text)
API de Files: primero subir, luego referenciar
La Files API ya está disponible y esta API no tiene costo.
Los usuarios pueden subir primero las imágenes a la plataforma y luego referenciarlas mediante file_id en las solicitudes.
Esto tiene dos ventajas directas: las solicitudes ya no llevan grandes bloques de base64, ahorrando ancho de banda de la solicitud; y la misma imagen no necesita subirse repetidamente en múltiples solicitudes.
Primer paso: subir la imagen y obtener el file_id.
Ejemplo
# La subida en sí es gratuita y no genera ningún costo.
curl https://api.deepseek.com/files \
-H "Authorization: Bearer ${DEEPSEEK_API_KEY}" \
-F "purpose=user_data" \
-F "file=@ejemplo-chart.png"
Tras subir con éxito, la plataforma devuelve la metainformación del archivo.
Ejemplo
"id": "file-api-qw3x8v2m6n",
"object": "file",
"filename": "ejemplo-chart.png",
"purpose": "user_data",
"bytes": 154320,
"created_at": 1787300000,
"expires_at": 1789900000
}
| Campo | Descripción |
|---|---|
| id | Identificador del archivo, comienza con file-api-, las solicitudes posteriores lo usan para referenciar la imagen. |
| filename | Nombre original del archivo al subirlo. |
| purpose | Propósito del archivo, actualmente solo admite user_data. |
| bytes | Tamaño del archivo, en bytes. |
| created_at | Hora de subida, marca de tiempo Unix. |
| expires_at | Hora de expiración, opcional, solo se devuelve si se estableció un período de validez al subir. |
Al subir, también se puede especificar el período de validez con el parámetro expires_after, con valores de 1 hora a 30 días; si no se pasa, es válido permanentemente.
Segundo paso: referenciar esta imagen con file_id en la solicitud multimodal.
{
  "model": "deepseek-v4-flash-vision-exp",
  "messages": [
    {
      "role": "user",
      "content": [
        {"type": "text", "text": "这个图表的整体趋势是什么?"},
        {"type": "file", "file_id": "file-api-qw3x8v2m6n"}
      ]
    }
  ]
}
¿Cuándo usar la Files API?
Cuando la misma imagen debe usarse repetidamente en múltiples solicitudes (por ejemplo, tareas de Agent que procesan el mismo lote de capturas de pantalla), subir una vez y referenciarla en todas partes ahorra más ancho de banda y es más rápido que enviar base64 cada vez.
El bloque file también admite file_data para incrustar base64 directamente (mutuamente excluyente con file_id, se puede combinar con el campo filename), adecuado para escenarios donde ocasionalmente se omite el paso de subida.
Al referenciar file_id a través del endpoint Messages compatible con Anthropic, se debe incluir adicionalmente la cabecera de solicitud anthropic-beta: files-api-2025-04-14.
Notas de facturación y precauciones
Las solicitudes multimodales se facturan por token; las imágenes se convierten en tokens y luego se incluyen en la facturación.
| Elemento de facturación | Regla |
|---|---|
| Facturación de imágenes | Las imágenes se facturan por token después de convertirse en tokens. |
| Límite por imagen individual | Ocupa como máximo 384 tokens. |
| Precio | Consistente con el modelo DeepSeek-V4-Flash. |
| Files API | Gratis |
Los tokens de imagen ocupan la ventana de contexto; en tareas con múltiples imágenes hay que prestar atención al consumo total: 10 imágenes pueden ocupar hasta 3840 tokens.
Las imágenes se escalan automáticamente antes de entrar al modelo: las imágenes más pequeñas que aproximadamente 384×384 se amplían, y las más grandes se reducen a un total de píxeles equivalente a aproximadamente 800×800.
Por lo tanto, el consumo de tokens solo se relaciona con el tamaño después del escalado; las imágenes de 2000×2000 y 5000×5000 tienen el mismo consumo; en solicitudes con múltiples imágenes, cada imagen se calcula de forma independiente según la misma regla.
El base64 hace que el cuerpo de la solicitud sea significativamente más grande; para imágenes grandes o llamadas de alta frecuencia, se recomienda usar una URL externa o la Files API.
Las solicitudes multimodales también tienen algunas limitaciones estrictas; superarlas devolverá directamente un error 400.
| Elemento de limitación | Regla |
|---|---|
| Formato de imagen | JPEG, PNG, GIF, WebP; se determina por el contenido real del archivo, no por la extensión. |
| Longitud de URL externa | No más de 8192 caracteres, y la imagen debe poder descargarse en 60 segundos. |
| Tamaño del cuerpo de la solicitud | No más de 48 MiB. |
| Tamaño de imagen individual | Máximo 32 MiB para los métodos base64 y URL; máximo 64 MiB para la Files API. |
| Número de imágenes por solicitud | Máximo 600 imágenes. |
| Longitud máxima del lado de la imagen | 8192 píxeles; se reduce a 4096 píxeles cuando la solicitud contiene 15 o más imágenes. |
| Ubicación de la imagen | Solo se puede colocar en mensajes de user; incluir imágenes en mensajes de system y assistant dará error. |
V4-Flash-Vision-Exp es un modelo de carácter experimental; sus capacidades y especificaciones de servicio pueden ajustarse con las iteraciones de versión. Para cadenas de producción críticas, se recomienda evaluar también el modelo de versión oficial.
Para instrucciones de uso más completas, consulte la documentación oficial de la API:Guía de API - Comprensión de imágenes、Guía de API - Files API。
Resumen
V4-Flash-Vision-Exp, con el posicionamiento de "texto sin pérdida, gran salto visual", ha llevado las capacidades multimodales al ecosistema de Agent de DeepSeek.
Para los desarrolladores, el costo de empezar es muy bajo: con solo cambiar el nombre del modelo, los Agent en DeepSeek Harness pueden entender capturas de pantalla, diseños y gráficos.
Se recomienda primero probar los tres ejemplos oficiales para familiarizarse, luego integrar las imágenes de su propio negocio y completar la primera tarea de Agent de "ver la imagen y trabajar".