DeepSeek Harness multimodal
DeepSeek a lancé un modèle expérimental de compréhension visuelle multimodale, DeepSeek-V4-Flash-Vision-Exp, et a simultanément ouvert des services API multimodaux et une API Files gratuite.
Installez la dernière version avant utilisation :
npm install -g @deepseek-ai/dsh@latest
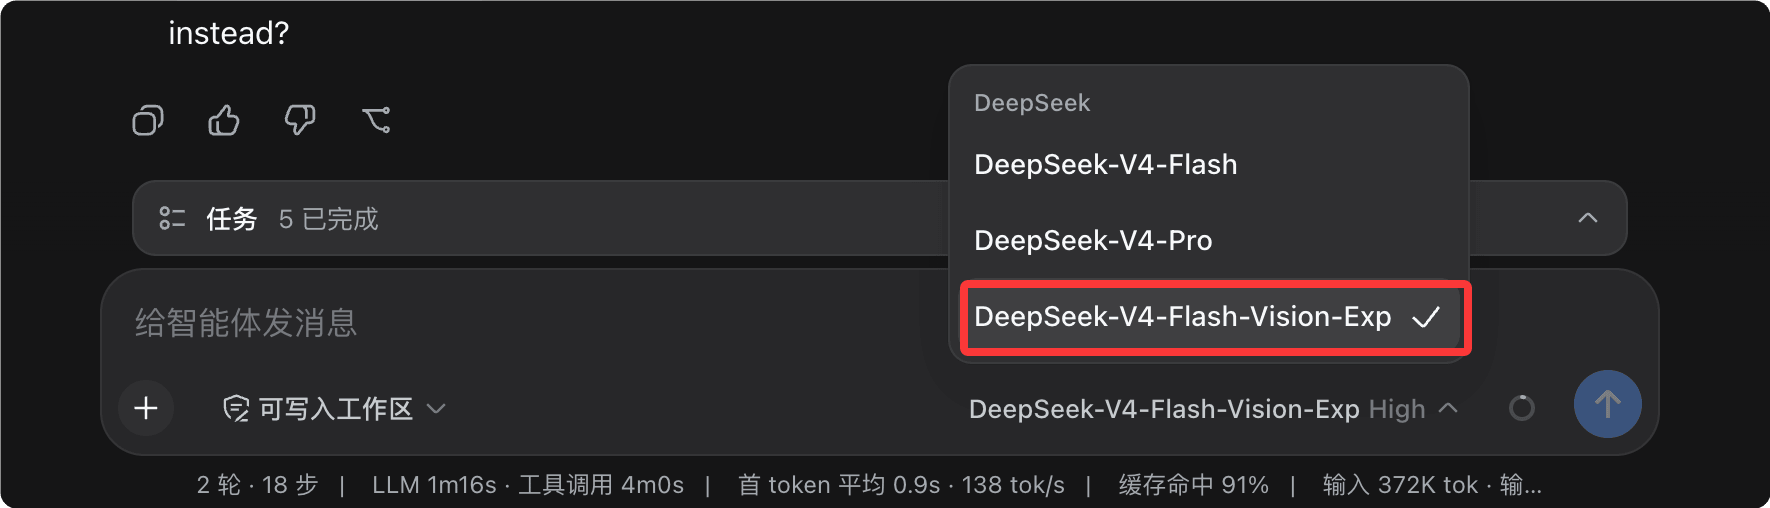
Après avoir mis à jour vers la dernière version, vous pouvez voir que la liste des modèles inclut déjà DeepSeek-V4-Flash-Vision-Exp :
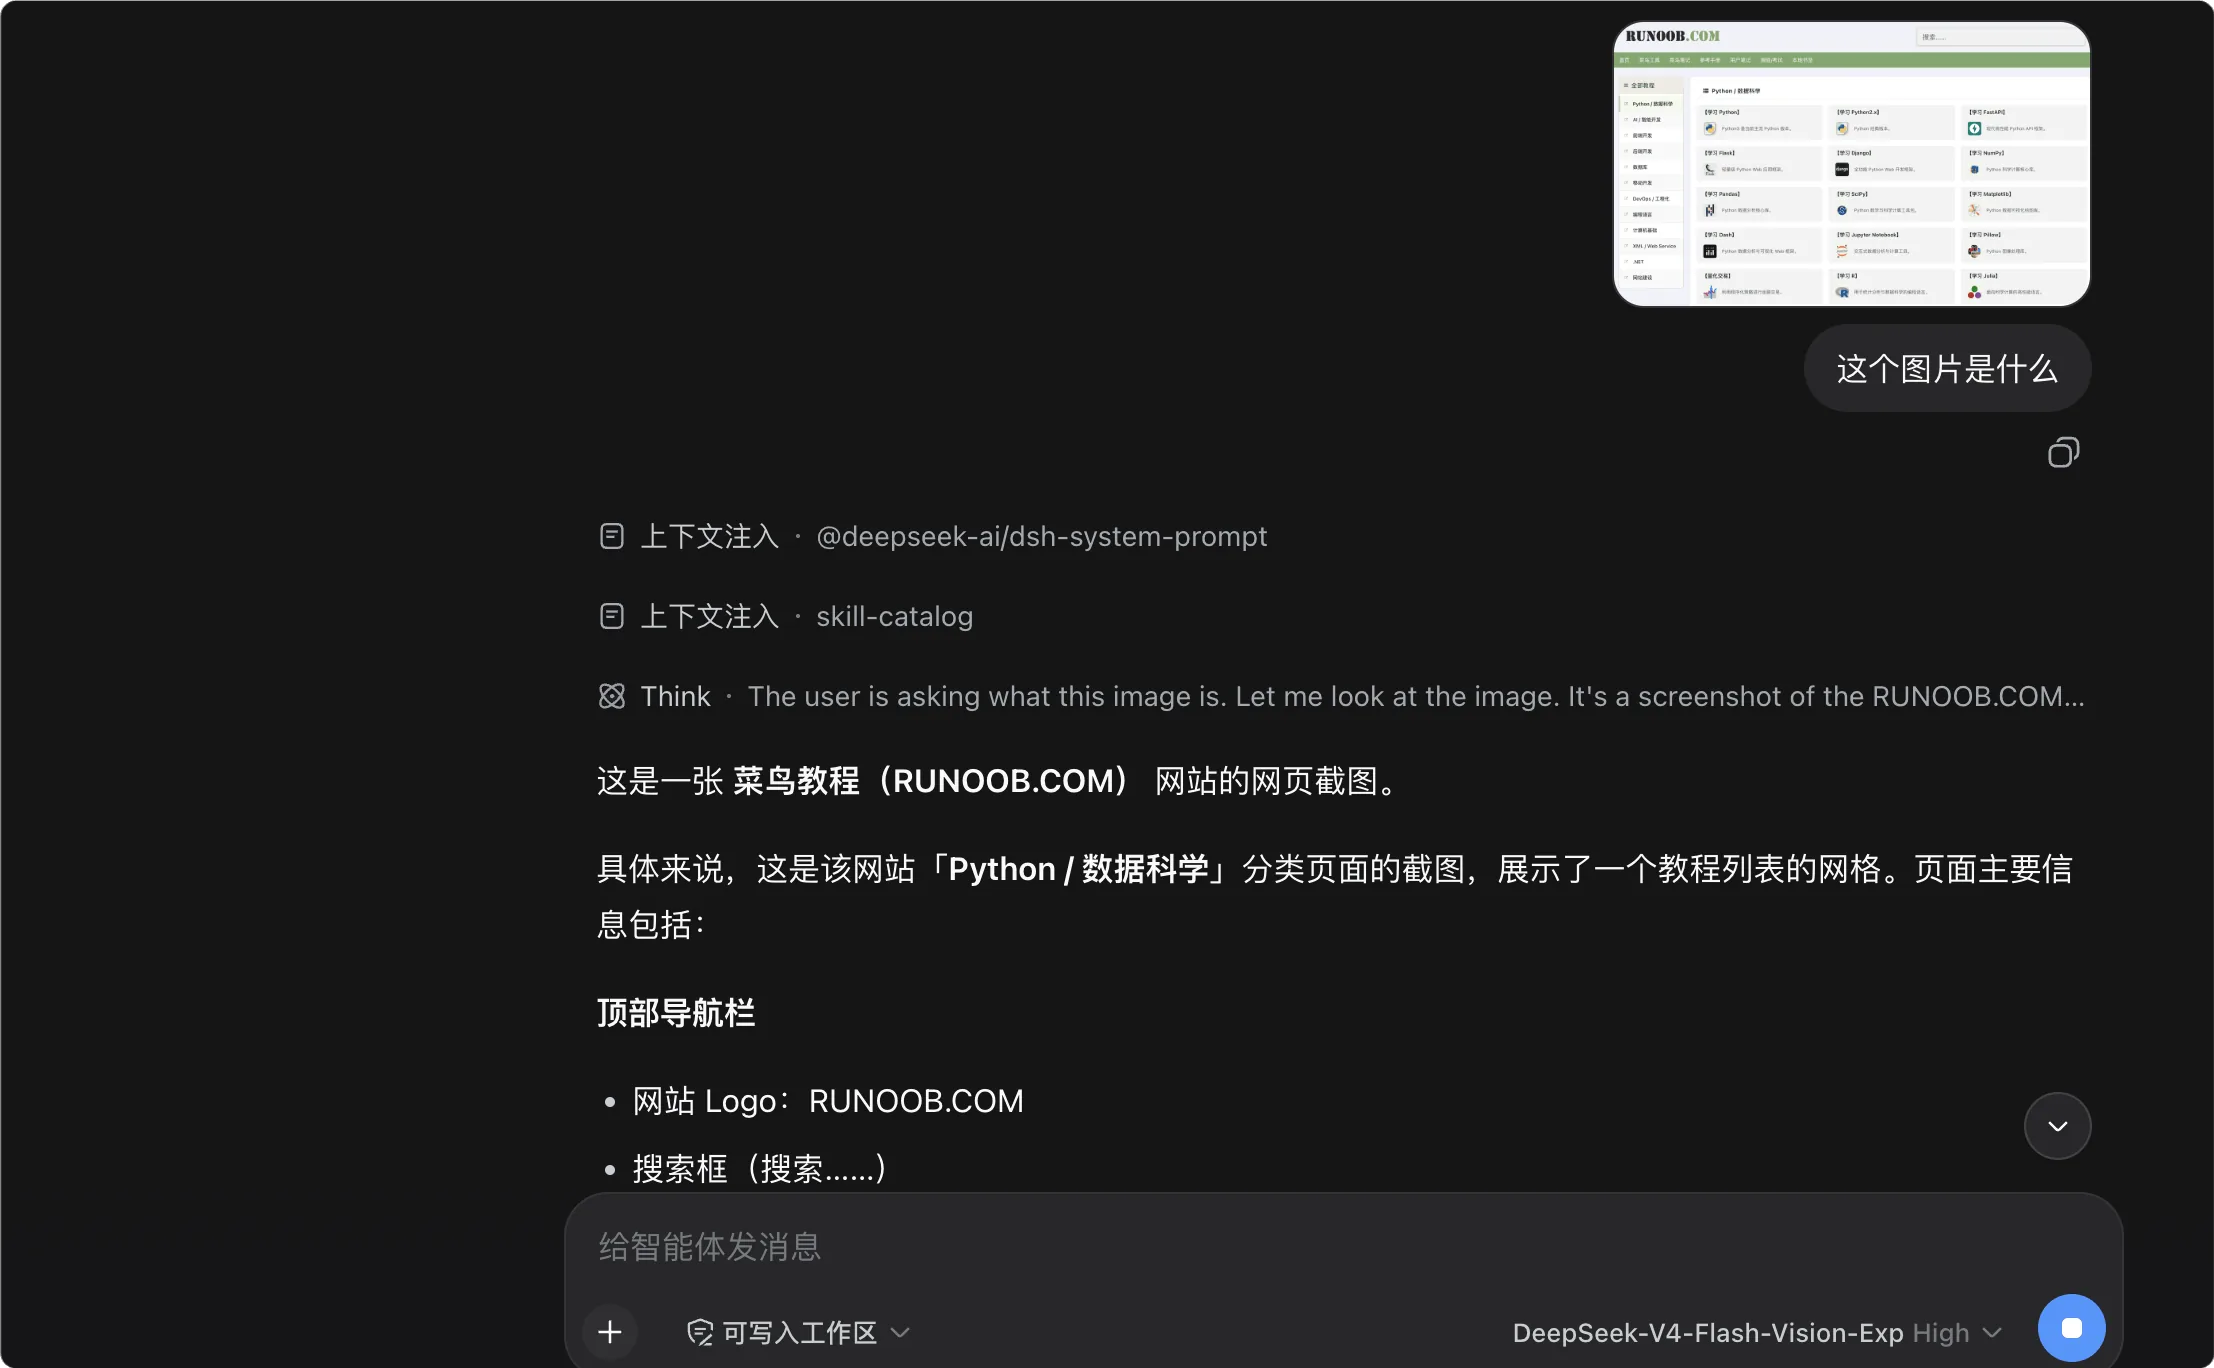
Passez au modèle de vision, puis nous pouvons directement glisser des images ou des fichiers PPT dans le document pour lui faire examiner le contenu des images ( Téléchargement de l'image de test):
Qu'est-ce que le multimodal
Pour comprendre la multimodalité, nous devons d'abord comprendre le mot « modalité ». La modalité désigne différentes formes de représentation de l'information : le texte est une modalité, et les images, l'audio et la vidéo sont également des modalités différentes.
| modalité | Formes courantes | Capacités d'IA correspondantes |
|---|---|---|
| Texte | Articles, code, conversations | Grand modèle de langage (LLM) |
| image | Photos, captures d'écran, maquettes de design, graphiques | Modèle de compréhension visuelle |
| audio | Parole, musique | Modèles de reconnaissance et de génération de la parole |
| Vidéo | Vidéos courtes, enregistrements d'écran, séquences de surveillance | Modèle de compréhension vidéo |
Auparavant, les grands modèles de langage ne traitaient qu'une seule modalité : le texte. Tout ce que vous leur envoyiez devait d'abord être converti en texte.
Les modèles multimodaux peuvent recevoir simultanément des images et du texte, en les convertissant uniformément en séquences de tokens avant de les traiter ensemble.

Le point clé : les images ne sont pas « directement vues » par le modèle. À la place, un encodeur visuel les découpe d'abord en patchs et les convertit en vecteurs, qui sont ensuite concaténés avec les tokens de texte dans la même séquence.
Les images consomment aussi des tokens. Une image peut occuper jusqu'à 384 tokens—c'est exactement la source des règles de facturation multimodales mentionnées plus tard.
Pour les Agents, la multimodalité apporte un changement qualitatif, et non une simple amélioration facultative.
| Élément de comparaison | Modèle exclusivement textuel | Modèle multimodal |
|---|---|---|
| Forme d'entrée | Texte uniquement | Texte et images mélangés |
| Résoudre les erreurs de code | Nécessite que les utilisateurs transcrivent manuellement les messages d'erreur en texte | Envoyer directement des captures d'écran d'erreur |
| Reproduire la maquette de conception | Impossible de référencer des brouillons visuels | Écrire des pages directement à partir de maquettes de conception |
| Analyser des graphiques de données | Impossible de lire des images à l'intérieur d'images | Regarder l'image et donner directement des conclusions |
V4-Flash-Vision-Exp : modèle de vision multimodal désormais disponible
DeepSeek-V4-Flash-Vision-Exp est un modèle expérimental de compréhension visuelle multimodale, désormais disponible sur la plateforme API DeepSeek.
Les utilisateurs peuvent définir viamodel='deepseek-v4-flash-vision-exp'Ensuite, vous pouvez accéder au modèle.
Son positionnement de capacités peut se résumer en une phrase : des capacités textuelles sans compromis, des capacités visuelles avec un bond majeur.
En capacités purement textuelles (Agent, raisonnement, connaissances du monde, etc.), il est au niveau de la version officielle DeepSeek-V4-Flash.
Sur les benchmarks Agent nécessitant une compréhension visuelle, il a réalisé un bond significatif par rapport à DeepSeek-V4-Flash, avec des capacités Agent multimodales désormais proches d'Opus-4.8.
| Dimension de capacité | DeepSeek-V4-Flash | DeepSeek-V4-Flash-Vision-Exp |
|---|---|---|
| Tâches Agent en texte pur | Référence de version | Au niveau de la version officielle |
| Raisonnement et connaissances du monde | Référence de version | Au niveau de la version officielle |
| Tâches Agent de compréhension visuelle | Non pris en charge ; les éléments multimodaux sont ignorés dans l’évaluation | Un bond majeur, approchant Opus-4.8 |
| Positionnement du modèle | Version officielle | Version expérimentale |
Note sur la méthodologie d’évaluation : pour les tâches textuelles de Code Agent dans les ensembles de benchmarks publics, les modèles de la série DeepSeek sont testés en utilisant le mode minimal de DeepSeek Harness comme framework, avec le réglage max, temperature=1.0, topp=0.95.
Dans les évaluations ApexBench et Agents' Last Exam, le modèle textuel DeepSeek-V4-Flash ignore les éléments multimodaux qu’elles contiennent.
Démarrage rapide de l’API multimodale
L’API multimodale prend en charge trois formats d’appel : Chat Completions, Messages et Responses, ce qui facilite l’intégration avec divers outils Agent.
Les trois formats ont des capacités identiques — choisissez simplement en fonction du style d’interface qui vous est familier.
| Format d’appel | Style d'interface | À qui s'adresse-t-il ? |
|---|---|---|
| Chat Completions | Interface de chat classique OpenAI | Développeurs disposant déjà de code avec le SDK OpenAI |
| Messages | Interface Anthropic Messages, base_url est https://api.deepseek.com/anthropic | Développeurs disposant déjà de code ou de chaînes d'outils de style Anthropic |
| Responses | Nouvelle API Responses d'OpenAI | Développeurs utilisant le nouveau SDK qui préfèrent des structures d'entrée concises |
Les trois formats prennent en charge l'entrée mixte image-texte. Les images peuvent être transmises de trois façons : base64 en ligne, URL externe ou API Files.

| Méthode de transmission | Taille du corps de la requête | Nécessité d'un service d'hébergement d'images | Scénarios applicables |
|---|---|---|---|
| base64 intégré | grand | Non requis | Images locales, petites images ponctuelles |
| URL externe | petit | nécessite | Images déjà déployées sur des serveurs accessibles publiquement |
| API de fichiers | petit | Non requis | La même image utilisée plusieurs fois, tâches par lots à haute fréquence |
Méthode 1 : base64 intégré
Après avoir encodé une image locale en chaîne base64, écrivez-la directement dans le corps de la requête sous forme de data URL.
Exemple
# Dépendance : pip install openai
import base64
from openai import OpenAI
# Le point de terminaison DeepSeek est compatible avec le SDK OpenAI, il suffit de modifier base_url pour basculer
client = OpenAI(
api_key="sk-your-secret-key", # Obligatoire : remplacez par votre propre clé API DeepSeek
base_url="https://api.deepseek.com" # Requis : point de terminaison officiel de DeepSeek
)
# Lire une image locale, encoder en chaîne base64
with open("example-logo.png", "rb") as f:
b64 = base64.b64encode(f.read()).decode("utf-8")
response = client.chat.completions.create(
model="deepseek-v4-flash-vision-exp", # Requis : modèle visuel multimodal
messages=[
{
"role": "user",
"content": [
# Le texte et les images sont entrelacés dans l'ordre du tableau, et le modèle les comprend dans l'ordre.
{"type": "text", "text": "Quel est le texte dans l'image ?"},
{
"type": "image_url",
# base64 en ligne : format data:image;base64,contenu encodé
"image_url": {"url": f"data:image/png;base64,{b64}"}
}
]
}
],
stream=False # Facultatif : s'il faut diffuser la sortie en flux, False par défaut
)
print(response.choices[0].message.content)
Sortie de l'exécution :
图片中的文字是 "EXAMPLE"。
Méthode 2 : URL externe
Les images sont hébergées sur des serveurs accessibles publiquement, et la requête ne contient qu'une chaîne d'URL, ce qui rend la requête très légère.
Exemple
curl https://api.deepseek.com/chat/completions \
-H "Content-Type: application/json" \
-H "Authorization: Bearer ${DEEPSEEK_API_KEY}" \
-d '{
"model": "deepseek-v4-flash-vision-exp",
"messages": [
{
"role": "user",
"content": [
{"type": "text", "text": "Résumez la tendance de ce graphique en un paragraphe."},
{"type": "image_url", "image_url": {"url": "https://static.example.com/images/chart-demo.png"}}
]
}
]
}'
L'URL doit être une adresse publique accessible par la plateforme. Les adresses réseau internes et les adresses de bouclage local ne peuvent pas être récupérées.
Les méthodes base64 et URL prennent toutes deux en charge l'ajout d'un champ detail facultatif dans image_url pour contrôler la précision de résolution de l'image.
| valeur de detail | Comportement | Scénarios applicables |
|---|---|---|
| low | Redimensionner à 512×512 avant l'analyse, réduire la consommation de tokens | Besoin d'un simple coup d'œil : identifier le type d'image, trouver le sujet principal |
| élevé | Équivalent à l'original | Besoin de voir clairement les détails |
| original | Analyse préservant la précision de l'image d'origine | Lire du texte, voir de petites icônes, analyser des graphiques |
| auto | Actuellement équivalent à l'original | Valeur par défaut, comportement lorsque detail n'est pas transmis |
Définir detail sur low lors de l'exécution de tâches de type capture d'écran par lots est le moyen le plus direct de contrôler les coûts multimodaux.
Format Messages et Responses
Ceux qui disposent déjà de code Anthropic ou OpenAI de nouveau style peuvent passer au multimodal DeepSeek presque sans transition.
Le format Messages utilise des blocs de contenu d'image, et les images sont transmises via le champ source.
Exemple
# Le point de terminaison utilise le chemin /anthropic compatible avec Anthropic de DeepSeek, et les champs d’en-tête sont également conformes à Anthropic
curl https://api.deepseek.com/anthropic/v1/messages \
-H "Content-Type: application/json" \
-H "x-api-key: ${DEEPSEEK_API_KEY}" \
-d '{
"model": "deepseek-v4-flash-vision-exp",
"max_tokens": 1024,
"messages": [
{
"role": "user",
"content": [
{
"type": "image",
"source": {
"type": "url",
"url": "https://static.example.com/images/code-screenshot.png"
}
},
{"type": "text", "text": "Ce code signalera une erreur lors de son exécution ; quelle ligne est le problème ?"}
]
}
]
}'
Le format Responses utilise un tableau d’entrée, avec input_text pour le texte et input_image pour les images.
Exemple
# La méthode de création du client est la même que dans l’exemple base64 ci-dessus.
response = client.responses.create(
model="deepseek-v4-flash-vision-exp", # Requis : modèle visuel multimodal
input=[
{
"role": "user",
"content": [
# Utilisez input_text pour le texte et input_image pour les images
{"type": "input_text", "text": "Organisez le tableau de la capture d'écran au format Markdown"},
{
"type": "input_image",
"image_url": "https://static.example.com/images/table.png"
}
]
}
]
)
# Pour le format Responses, utilisez simplement output_text
print(response.output_text)
Files API : téléversez d'abord, puis référencez
L'API Files est désormais ouverte, et cette API est gratuite.
Les utilisateurs peuvent d'abord téléverser des images sur la plateforme, puis les référencer via file_id dans les requêtes.
Cela présente deux avantages directs : les requêtes ne transportent plus de gros blocs de base64, ce qui économise la bande passante des requêtes ; la même image n'a pas besoin d'être téléversée plusieurs fois sur plusieurs requêtes.
Étape 1 : téléversez l'image et récupérez le file_id.
Exemple
# Le téléversement lui-même est gratuit et n'entraîne aucun frais.
curl https://api.deepseek.com/files \
-H "Authorization: Bearer ${DEEPSEEK_API_KEY}" \
-F "purpose=user_data" \
-F "file=@example-chart.png"
Après un téléversement réussi, la plateforme renvoie les métadonnées du fichier.
Exemple
"id": "file-api-qw3x8v2m6n",
"object": "file",
"filename": "example-chart.png",
"purpose": "user_data",
"bytes": 154320,
"created_at": 1787300000,
"expires_at": 1789900000
}
| Fields | Description |
|---|---|
| id | Identifiant de fichier, commence par file-api-, utilisé pour référencer l'image dans les requêtes suivantes |
| filename | Nom d'origine du fichier au moment du téléversement |
| purpose | Objet du fichier, ne prend actuellement en charge que user_data |
| bytes | Taille du fichier, en octets |
| created_at | Heure de téléversement, horodatage Unix |
| expires_at | Heure d'expiration, facultative, renvoyée uniquement si une période de validité a été définie lors du téléversement |
Lors du téléversement, vous pouvez également utiliser le paramètre expires_after pour spécifier une période de validité, allant de 1 heure à 30 jours. S'il n'est pas transmis, le fichier reste valide de façon permanente.
Étape 2 : Référencez l'image à l'aide de file_id dans la requête multimodale.
{
  "model": "deepseek-v4-flash-vision-exp",
  "messages": [
    {
      "role": "user",
      "content": [
        {"type": "text", "text": "这个图表的整体趋势是什么?"},
        {"type": "file", "file_id": "file-api-qw3x8v2m6n"}
      ]
    }
  ]
}
Quand faut-il utiliser l'API Files ?
Lorsqu'une même image doit être réutilisée dans plusieurs requêtes (par exemple, des tâches d'Agent exécutées par lots sur le même ensemble de captures d'écran), la téléverser une fois et y faire référence partout économise davantage de bande passante et est plus rapide que de transmettre du base64 à chaque fois.
Le bloc file prend également en charge file_data pour du base64 en ligne direct (mutuellement exclusif avec file_id, peut être combiné avec le champ filename), adapté aux scénarios où vous souhaitez occasionnellement ignorer l'étape de téléversement.
Lorsque vous référencez un file_id via le point de terminaison Messages compatible avec Anthropic, vous devez en plus inclure l'en-tête de requête anthropic-beta: files-api-2025-04-14.
Instructions et notes de facturation
Les requêtes multimodales sont facturées au token. Les images sont converties en tokens et participent ensuite à la facturation.
| Élément de facturation | Règles |
|---|---|
| Facturation des images | Les images sont converties en tokens et facturées au token |
| Maximum par image | Jusqu'à 384 tokens |
| Tarification | Conforme au modèle DeepSeek-V4-Flash |
| API de fichiers | Gratuit |
Les tokens d'image occupent de l'espace dans la fenêtre de contexte. Pour les tâches multi-images, surveillez la consommation totale : 10 images peuvent occuper jusqu'à 3840 tokens.
Les images sont automatiquement redimensionnées avant d'entrer dans le modèle : les images plus petites qu'environ 384×384 sont agrandies, tandis que les images plus grandes sont réduites à peu près au nombre total de pixels équivalent à 800×800.
Par conséquent, la consommation de jetons dépend uniquement des dimensions redimensionnées ; une image de 2000×2000 et une image de 5000×5000 consomment la même quantité ; dans les requêtes multi-images, chaque image est calculée indépendamment selon la même règle.
base64 agrandit sensiblement le corps de la requête. Pour les images volumineuses ou les appels à haute fréquence, envisagez plutôt d'utiliser des URL externes ou la Files API.
Les requêtes multimodales ont aussi des limites strictes. Les dépasser renverra directement une erreur 400.
| Élément de restriction | Règles |
|---|---|
| Format d'image | JPEG, PNG, GIF, WebP ; déterminé par le contenu réel du fichier, et non par le nom de l'extension |
| Longueur de l'URL externe | Pas plus de 8192 caractères, et l'image doit être téléchargeable en 60 secondes |
| Taille du corps de la requête | Pas plus de 48 MiB |
| Taille d'une seule image | les méthodes base64 et URL : max 32 MiB, Files API : max 64 MiB |
| Nombre d'images par requête | Jusqu'à 600 images |
| Longueur maximale d'un côté de l'image | 8192 pixels ; lorsqu'une requête contient 15 images ou plus, cette valeur passe à 4096 pixels |
| Position de l'image | Ne peut être placé que dans les messages utilisateur. L'inclusion d'images dans les messages système et assistant générera une erreur. |
V4-Flash-Vision-Exp est un modèle expérimental. Les capacités et les spécifications de service peuvent évoluer avec les itérations de version. Pour les pipelines de production critiques, il est recommandé d'évaluer également les modèles officiels.
Pour des instructions d'utilisation plus complètes, consultez la documentation officielle de l'API :Guide API - Compréhension des images、Guide API - API de fichiers。
Résumé
V4-Flash-Vision-Exp apporte des capacités multimodales à l'écosystème Agent de DeepSeek avec le positionnement : « texte sans compromis, vision avec un bond majeur ».
Pour les développeurs, le coût de démarrage est très faible : il suffit de changer un nom de modèle, et les Agents dans DeepSeek Harness peuvent comprendre les captures d'écran, les maquettes de conception et les graphiques.
Il est recommandé d'essayer d'abord les trois exemples officiels pour vous familiariser, puis d'importer vos propres images métier et de lancer votre première tâche Agent « voir l'image et faire le travail ».