Мультимодальность DeepSeek Harness
DeepSeek выпустила экспериментальную мультимодальную модель визуального понимания DeepSeek-V4-Flash-Vision-Exp и одновременно открыла мультимодальные API-сервисы и бесплатный Files API.
Перед использованием установите последнюю версию:
npm install -g @deepseek-ai/dsh@latest
После обновления до последней версии вы увидите, что в списке моделей уже есть DeepSeek-V4-Flash-Vision-Exp:
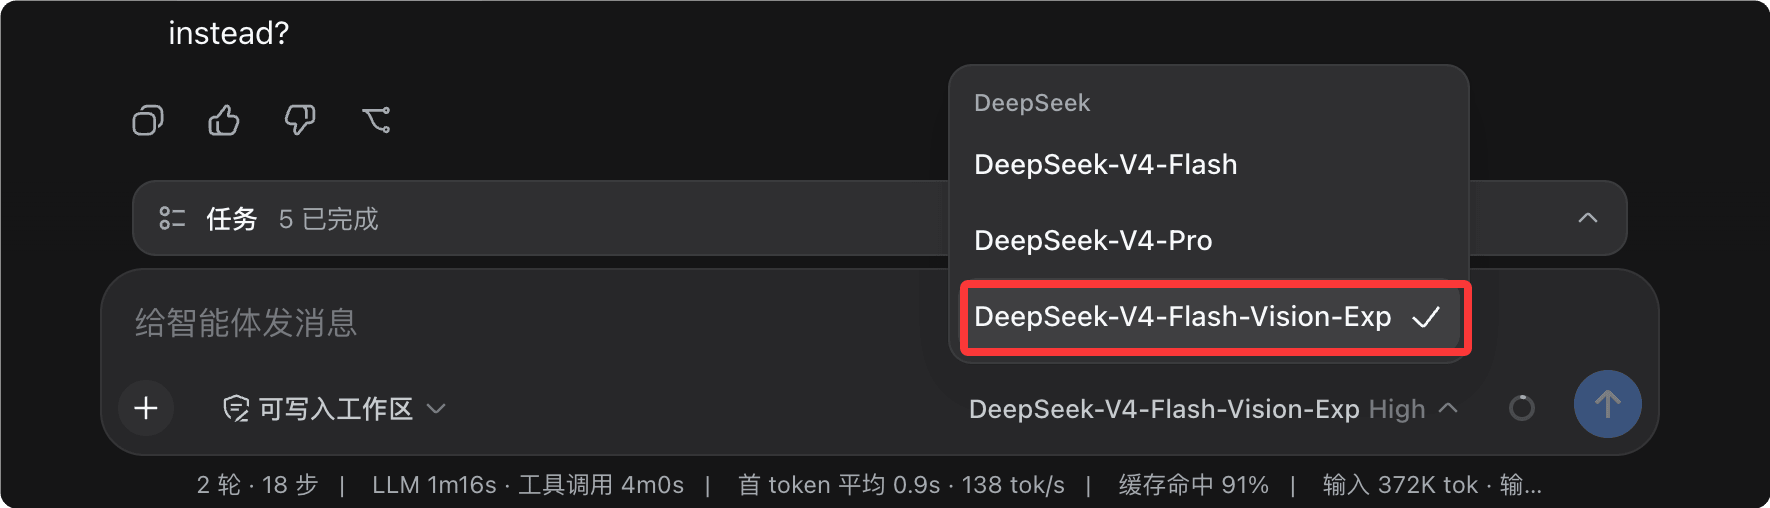
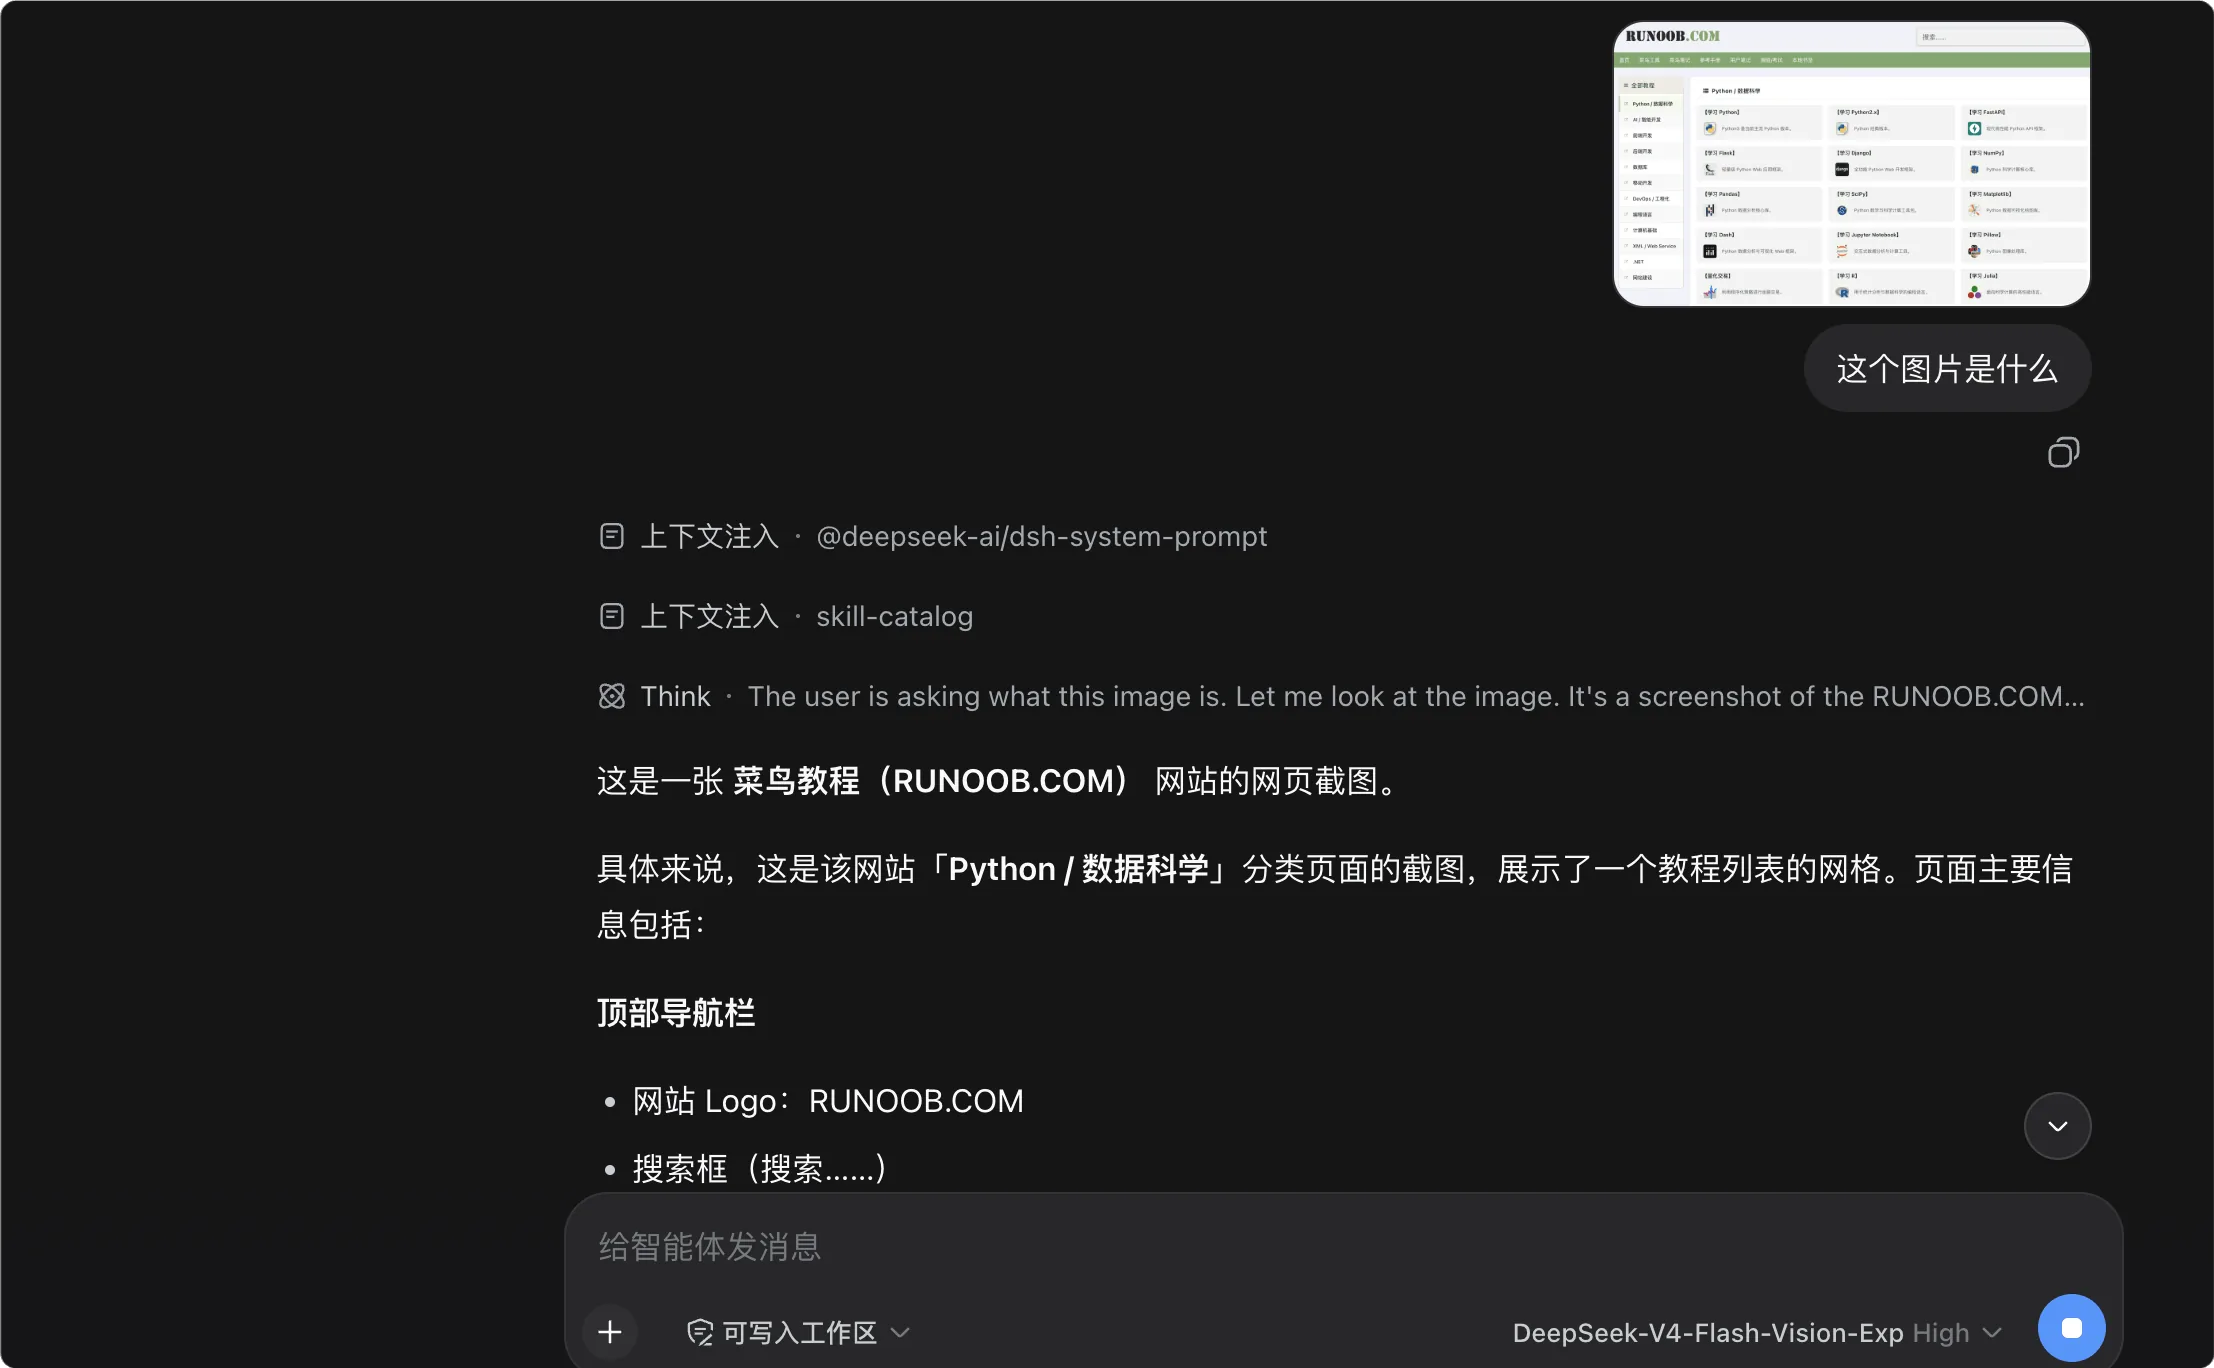
Переключитесь на модель зрения, и тогда мы сможем напрямую перетаскивать изображения или файлы PPT в документ, чтобы она посмотрела на содержимое изображений ( Скачивание тестового изображения):
Что такое мультимодальность
Чтобы понять мультимодальность, сначала нужно понять слово «модальность». Модальность означает различные формы представления информации: текст — это одна модальность, а изображения, аудио и видео — тоже отдельные модальности.
| модальность | Распространённые формы | Соответствующие возможности ИИ |
|---|---|---|
| Текст | Статьи, код, разговоры | Большая языковая модель (LLM) |
| image | Фотографии, скриншоты, макеты дизайна, диаграммы | Модель визуального понимания |
| аудио | Речь, музыка | Модели распознавания и генерации речи |
| Видео | Короткие видео, записи экрана, материалы видеонаблюдения | Модель понимания видео |
Раньше большие языковые модели обрабатывали только одну модальность — текст. Всё, что вы им отправляли, сначала нужно было преобразовать в текст.
Мультимодальные модели могут одновременно принимать изображения и текст, единообразно преобразуя их в последовательности токенов, а затем обрабатывать их вместе.

Ключевой момент: изображения не «видит» модель напрямую. Вместо этого визуальный энкодер сначала разбивает их на патчи и преобразует в векторы, которые затем объединяются с текстовыми токенами в одну и ту же последовательность.
Изображения также расходуют токены. Одно изображение занимает до 384 токенов — именно отсюда берутся правила тарификации мультимодальных запросов, упомянутые позже.
Для агентов мультимодальность даёт качественное изменение, а не просто приятное дополнение.
| Пункт сравнения | Модель, работающая только с текстом | Мультимодальная модель |
|---|---|---|
| Форма ввода | Только текст | Смешанный текст и изображения |
| Устранение ошибок в коде | Требует от пользователей вручную переносить сообщения об ошибках в текст | Отправлять скриншоты ошибок напрямую |
| Воспроизвести дизайн-макет | Невозможно ссылаться на визуальные черновики | Создавать страницы напрямую по дизайн-макетам |
| Анализировать графики данных | Не может распознавать изображения внутри изображений | Посмотреть на изображение и сразу дать выводы |
V4-Flash-Vision-Exp: теперь доступна мультимодальная модель зрения
DeepSeek-V4-Flash-Vision-Exp — экспериментальная мультимодальная модель визуального понимания, теперь доступна на платформе DeepSeek API.
Пользователи могут задать с помощьюmodel='deepseek-v4-flash-vision-exp'После этого можно получить доступ к модели.
Её позиционирование возможностей можно суммировать одной фразой: текстовые возможности без компромиссов, визуальные возможности — значительный скачок.
По возможностям в чистом тексте (Agent, рассуждение, знания о мире и т. д.) она на одном уровне с официальным релизом DeepSeek-V4-Flash.
В Agent-бенчмарках, требующих визуального понимания, она достигла значительного скачка по сравнению с DeepSeek-V4-Flash, а её мультимодальные Agent-возможности теперь приближаются к Opus-4.8.
| Аспект возможностей | DeepSeek-V4-Flash | DeepSeek-V4-Flash-Vision-Exp |
|---|---|---|
| Чисто текстовые агентные задачи | Базовый уровень релиза | На одном уровне с официальной версией |
| Рассуждение и знания о мире | Базовый уровень релиза | На одном уровне с официальной версией |
| Агентные задачи визуального понимания | Не поддерживается; мультимодальные элементы игнорируются при оценке | Крупный скачок, приближающийся к Opus-4.8 |
| Позиционирование модели | Официальная версия | Экспериментальная версия |
Примечание к методологии оценки: для текстовых задач Code Agent в публичных наборах бенчмарков модели серии DeepSeek тестируются с использованием DeepSeek Harness в минимальном режиме в качестве фреймворка, с настройкой max, temperature=1.0, topp=0.95.
В оценках ApexBench и Agents' Last Exam текстовая модель DeepSeek-V4-Flash игнорирует мультимодальные элементы в них.
Быстрый старт мультимодального API
Мультимодальный API поддерживает три формата вызова: Chat Completions, Messages и Responses, что упрощает интеграцию с различными инструментами Agent.
Все три формата обладают идентичными возможностями — просто выберите тот, который соответствует привычному вам стилю интерфейса.
| Формат вызова | Стиль интерфейса | Для кого это? |
|---|---|---|
| Chat Completions | Классический интерфейс чата OpenAI | Разработчики, у которых уже есть код с OpenAI SDK |
| Messages | Интерфейс Anthropic Messages, base_url: https://api.deepseek.com/anthropic | Разработчики, у которых уже есть код или инструментальные цепочки в стиле Anthropic |
| Responses | Новый Responses API от OpenAI | Разработчики, использующие новый SDK и предпочитающие лаконичные структуры входных данных |
Все три формата поддерживают смешанный ввод изображений и текста. Изображения можно передавать тремя способами: встроенный base64, внешний URL или Files API.

| Способ передачи | Размер тела запроса | Требуется ли сервис хостинга изображений | Применимые сценарии |
|---|---|---|---|
| встроенный base64 | большие | Не требуется | Локальные изображения, разовые небольшие изображения |
| Внешний URL | малый | требует | Изображения, уже размещённые на общедоступных серверах |
| API файлов | малый | Не требуется | Одно и то же изображение, используемое несколько раз; высокочастотные пакетные задачи |
Способ 1: встроенный base64
После кодирования локального изображения в строку base64 запишите его напрямую в тело запроса как data URL.
Пример
# Зависимость: pip install openai
import base64
from openai import OpenAI
# Эндпоинт DeepSeek совместим с OpenAI SDK, просто измените base_url для переключения
client = OpenAI(
api_key="sk-your-secret-key", # Обязательно: замените на свой собственный ключ DeepSeek API
base_url="https://api.deepseek.com" # Обязательно: официальная конечная точка DeepSeek
)
# Прочитать локальное изображение, закодировать в строку base64
with open("example-logo.png", "rb") as f:
b64 = base64.b64encode(f.read()).decode("utf-8")
response = client.chat.completions.create(
model="deepseek-v4-flash-vision-exp", # Обязательно: мультимодальная модель визуального понимания
messages=[
{
"role": "user",
"content": [
# Текст и изображения чередуются в порядке массива, и модель понимает их в этом порядке.
{"type": "text", "text": "Какой текст на изображении?"},
{
"type": "image_url",
# Встроенный base64: формат data:image;base64,закодированное содержимое
"image_url": {"url": f"data:image/png;base64,{b64}"}
}
]
}
],
stream=False # Необязательно: использовать ли потоковый вывод, по умолчанию False
)
print(response.choices[0].message.content)
Вывод при запуске:
图片中的文字是 "EXAMPLE"。
Способ 2: внешний URL
Изображения размещены на общедоступных серверах, а запрос содержит только строку URL, что делает тело запроса очень маленьким.
Пример
curl https://api.deepseek.com/chat/completions \
-H "Content-Type: application/json" \
-H "Authorization: Bearer ${DEEPSEEK_API_KEY}" \
-d '{
"model": "deepseek-v4-flash-vision-exp",
"messages": [
{
"role": "user",
"content": [
{"type": "text", "text": "Обобщите тенденцию этого графика в одном абзаце."},
{"type": "image_url", "image_url": {"url": "https://static.example.com/images/chart-demo.png"}}
]
}
]
}'
URL должен быть публичным адресом, доступным платформе. Внутренние сетевые адреса и локальные адреса обратной петли не могут быть загружены.
Оба метода, base64 и URL, поддерживают добавление необязательного поля detail в image_url для управления точностью разрешения изображения.
| Значение detail | Поведение | Применимые сценарии |
|---|---|---|
| low | Масштабирование до 512×512 перед парсингом снижает потребление токенов. | Достаточно беглого взгляда: определить тип изображения, найти основной объект |
| высокий | Эквивалентно оригиналу | Нужно чётко видеть детали |
| original | Анализ с сохранением исходной точности изображения | Чтение текста, просмотр мелких значков, анализ диаграмм |
| auto | Сейчас эквивалентно оригиналу | Значение по умолчанию, поведение, когда detail не передан |
Установка detail в low при пакетном выполнении задач типа скриншотов — самый прямой способ контролировать мультимодальные затраты.
Формат Messages и Responses
Те, у кого уже есть код для Anthropic или OpenAI нового стиля, могут почти бесшовно перейти на мультимодальные возможности DeepSeek.
Формат Messages использует блоки содержимого изображения, а изображения передаются через поле source.
Пример
# Конечная точка использует совместимый с Anthropic путь DeepSeek /anthropic, и поля заголовка также соответствуют Anthropic
curl https://api.deepseek.com/anthropic/v1/messages \
-H "Content-Type: application/json" \
-H "x-api-key: ${DEEPSEEK_API_KEY}" \
-d '{
"model": "deepseek-v4-flash-vision-exp",
"max_tokens": 1024,
"messages": [
{
"role": "user",
"content": [
{
"type": "image",
"source": {
"type": "url",
"url": "https://static.example.com/images/code-screenshot.png"
}
},
{"type": "text", "text": "Этот код выдаст ошибку при запуске; в какой строке проблема?"}
]
}
]
}'
Формат Responses использует входной массив, в котором input_text — для текста, а input_image — для изображений.
Пример
# Способ создания клиента такой же, как в примере с base64 выше.
response = client.responses.create(
model="deepseek-v4-flash-vision-exp", # Обязательно: мультимодальная модель визуального понимания
input=[
{
"role": "user",
"content": [
# Используйте input_text для текста, а input_image — для изображений
{"type": "input_text", "text": "Преобразуйте таблицу на скриншоте в Markdown"},
{
"type": "input_image",
"image_url": "https://static.example.com/images/table.png"
}
]
}
]
)
# Для формата Responses просто используйте output_text
print(response.output_text)
Files API: сначала загрузите, затем ссылайтесь
Files API теперь открыт, и этот API бесплатен.
Пользователи могут сначала загрузить изображения на платформу, а затем ссылаться на них через file_id в запросах.
Это даёт два прямых преимущества: запросы больше не содержат большие фрагменты base64, что экономит пропускную способность запросов; одно и то же изображение не нужно загружать повторно в нескольких запросах.
Шаг 1: загрузите изображение и получите file_id.
Пример
# Сама загрузка бесплатна и не влечёт никаких расходов.
curl https://api.deepseek.com/files \
-H "Authorization: Bearer ${DEEPSEEK_API_KEY}" \
-F "purpose=user_data" \
-F "file=@example-chart.png"
После успешной загрузки платформа возвращает метаданные файла.
Пример
"id": "file-api-qw3x8v2m6n",
"object": "file",
"filename": "example-chart.png",
"purpose": "user_data",
"bytes": 154320,
"created_at": 1787300000,
"expires_at": 1789900000
}
| Fields | Описание |
|---|---|
| id | Идентификатор файла, начинается с file-api-, используется для ссылки на изображение в последующих запросах |
| filename | Исходное имя файла на момент загрузки |
| purpose | Назначение файла, в настоящее время поддерживается только user_data |
| bytes | Размер файла в байтах |
| created_at | Время загрузки, временная метка Unix |
| expires_at | Время истечения срока действия, необязательно, возвращается только если при загрузке был задан срок действия |
При загрузке вы также можете использовать параметр expires_after, чтобы указать срок действия от 1 часа до 30 дней. Если он не передан, файл остаётся действительным бессрочно.
Шаг 2: Используйте file_id для ссылки на изображение в мультимодальном запросе.
{
  "model": "deepseek-v4-flash-vision-exp",
  "messages": [
    {
      "role": "user",
      "content": [
        {"type": "text", "text": "这个图表的整体趋势是什么?"},
        {"type": "file", "file_id": "file-api-qw3x8v2m6n"}
      ]
    }
  ]
}
Когда следует использовать Files API?
Когда одно и то же изображение нужно повторно использовать в нескольких запросах (например, задачи Agent, выполняемые пакетами на одном и том же наборе скриншотов), загрузка один раз и ссылка на него везде экономит больше трафика и работает быстрее, чем передача base64 каждый раз.
Блок file также поддерживает file_data для прямого встраивания base64 (взаимоисключающий с file_id, может сочетаться с полем filename), подходит для сценариев, когда вы иногда хотите пропустить этап загрузки.
При ссылке на file_id через эндпоинт Messages, совместимый с Anthropic, необходимо дополнительно указать заголовок запроса anthropic-beta: files-api-2025-04-14.
Инструкции и примечания по тарификации
Мультимодальные запросы тарифицируются по токенам. Изображения преобразуются в токены и затем участвуют в тарификации.
| Пункт тарификации | Правила |
|---|---|
| Тарификация изображений | Изображения преобразуются в токены и тарифицируются по токенам |
| Максимум на изображение | До 384 токенов |
| Цены | Согласуется с моделью DeepSeek-V4-Flash |
| API файлов | Бесплатно |
Токены изображений занимают место в контекстном окне. Для задач с несколькими изображениями следите за общим потреблением: 10 изображений могут занимать до 3840 токенов.
Изображения автоматически масштабируются перед поступлением в модель: изображения меньше примерно 384×384 увеличиваются, а более крупные уменьшаются до примерно эквивалентного общего количества пикселей 800×800.
Следовательно, расход токенов зависит только от размеров после изменения размера; изображение 2000×2000 и изображение 5000×5000 потребляют одинаковое количество; в запросах с несколькими изображениями каждое изображение рассчитывается независимо по одному и тому же правилу.
base64 заметно увеличивает тело запроса. Для больших изображений или частых вызовов рассмотрите использование внешних URL или Files API вместо этого.
Мультимодальные запросы также имеют некоторые жёсткие ограничения. При их превышении сразу возвращается ошибка 400.
| Пункт ограничения | Правила |
|---|---|
| Формат изображения | JPEG, PNG, GIF, WebP; определяется фактическим содержимым файла, а не по расширению |
| Длина внешнего URL | Не более 8192 символов, и изображение должно загружаться в течение 60 секунд |
| Размер тела запроса | Не более 48 MiB |
| Размер одного изображения | для методов base64 и URL — максимум 32 MiB, для Files API — максимум 64 MiB |
| Количество изображений на запрос | До 600 изображений |
| Максимальная длина стороны изображения | 8192 пикселя; если запрос содержит 15 или более изображений, значение снижается до 4096 пикселей |
| Позиция изображения | Изображения можно размещать только в сообщениях пользователя. Добавление изображений в системные сообщения и сообщения ассистента приведёт к ошибке. |
V4-Flash-Vision-Exp — экспериментальная модель. Возможности и спецификации обслуживания могут меняться от версии к версии. Для критически важных производственных пайплайнов рекомендуется также протестировать официальные модели.
Для более полных инструкций по использованию обратитесь к официальной документации API:Руководство по API — Понимание изображений、Руководство по API — Files API。
Итог
V4-Flash-Vision-Exp привносит мультимодальные возможности в экосистему агентов DeepSeek с позиционированием «текст без компромиссов, зрение — значительный скачок».
Для разработчиков стоимость начала работы очень низка: достаточно изменить одно название модели, и агенты в DeepSeek Harness смогут понимать скриншоты, дизайн-макеты и диаграммы.
Рекомендуется сначала попробовать три официальных примера, чтобы освоиться, затем подключить собственные бизнес-изображения и запустить первую задачу агента по принципу «увидеть изображение и выполнить работу».