DeepSeek Harness Multimodal
DeepSeek hat ein experimentelles multimodales Vision-Verständnis-Modell, DeepSeek-V4-Flash-Vision-Exp, eingeführt und gleichzeitig multimodale API-Dienste und eine kostenlose Files-API geöffnet.
Installieren Sie vor der Verwendung die neueste Version:
npm install -g @deepseek-ai/dsh@latest
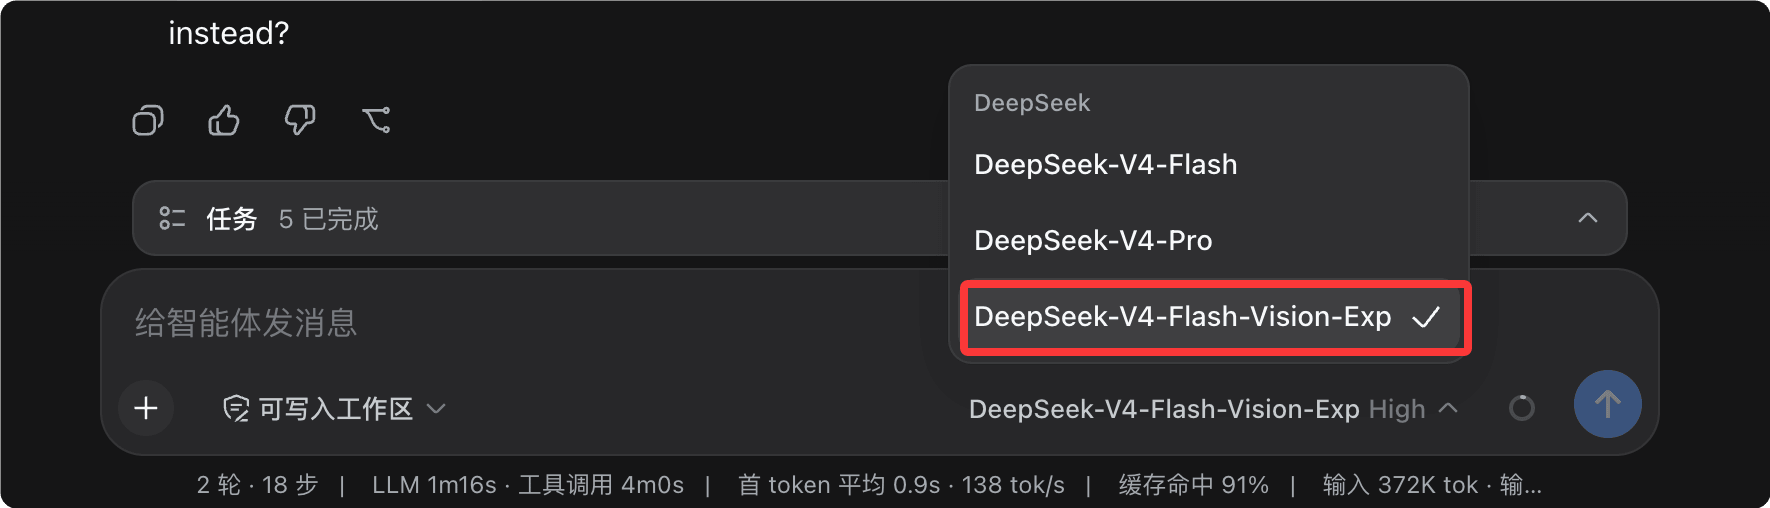
Nach dem Update auf die neueste Version sehen Sie, dass die Modellliste bereits DeepSeek-V4-Flash-Vision-Exp enthält:
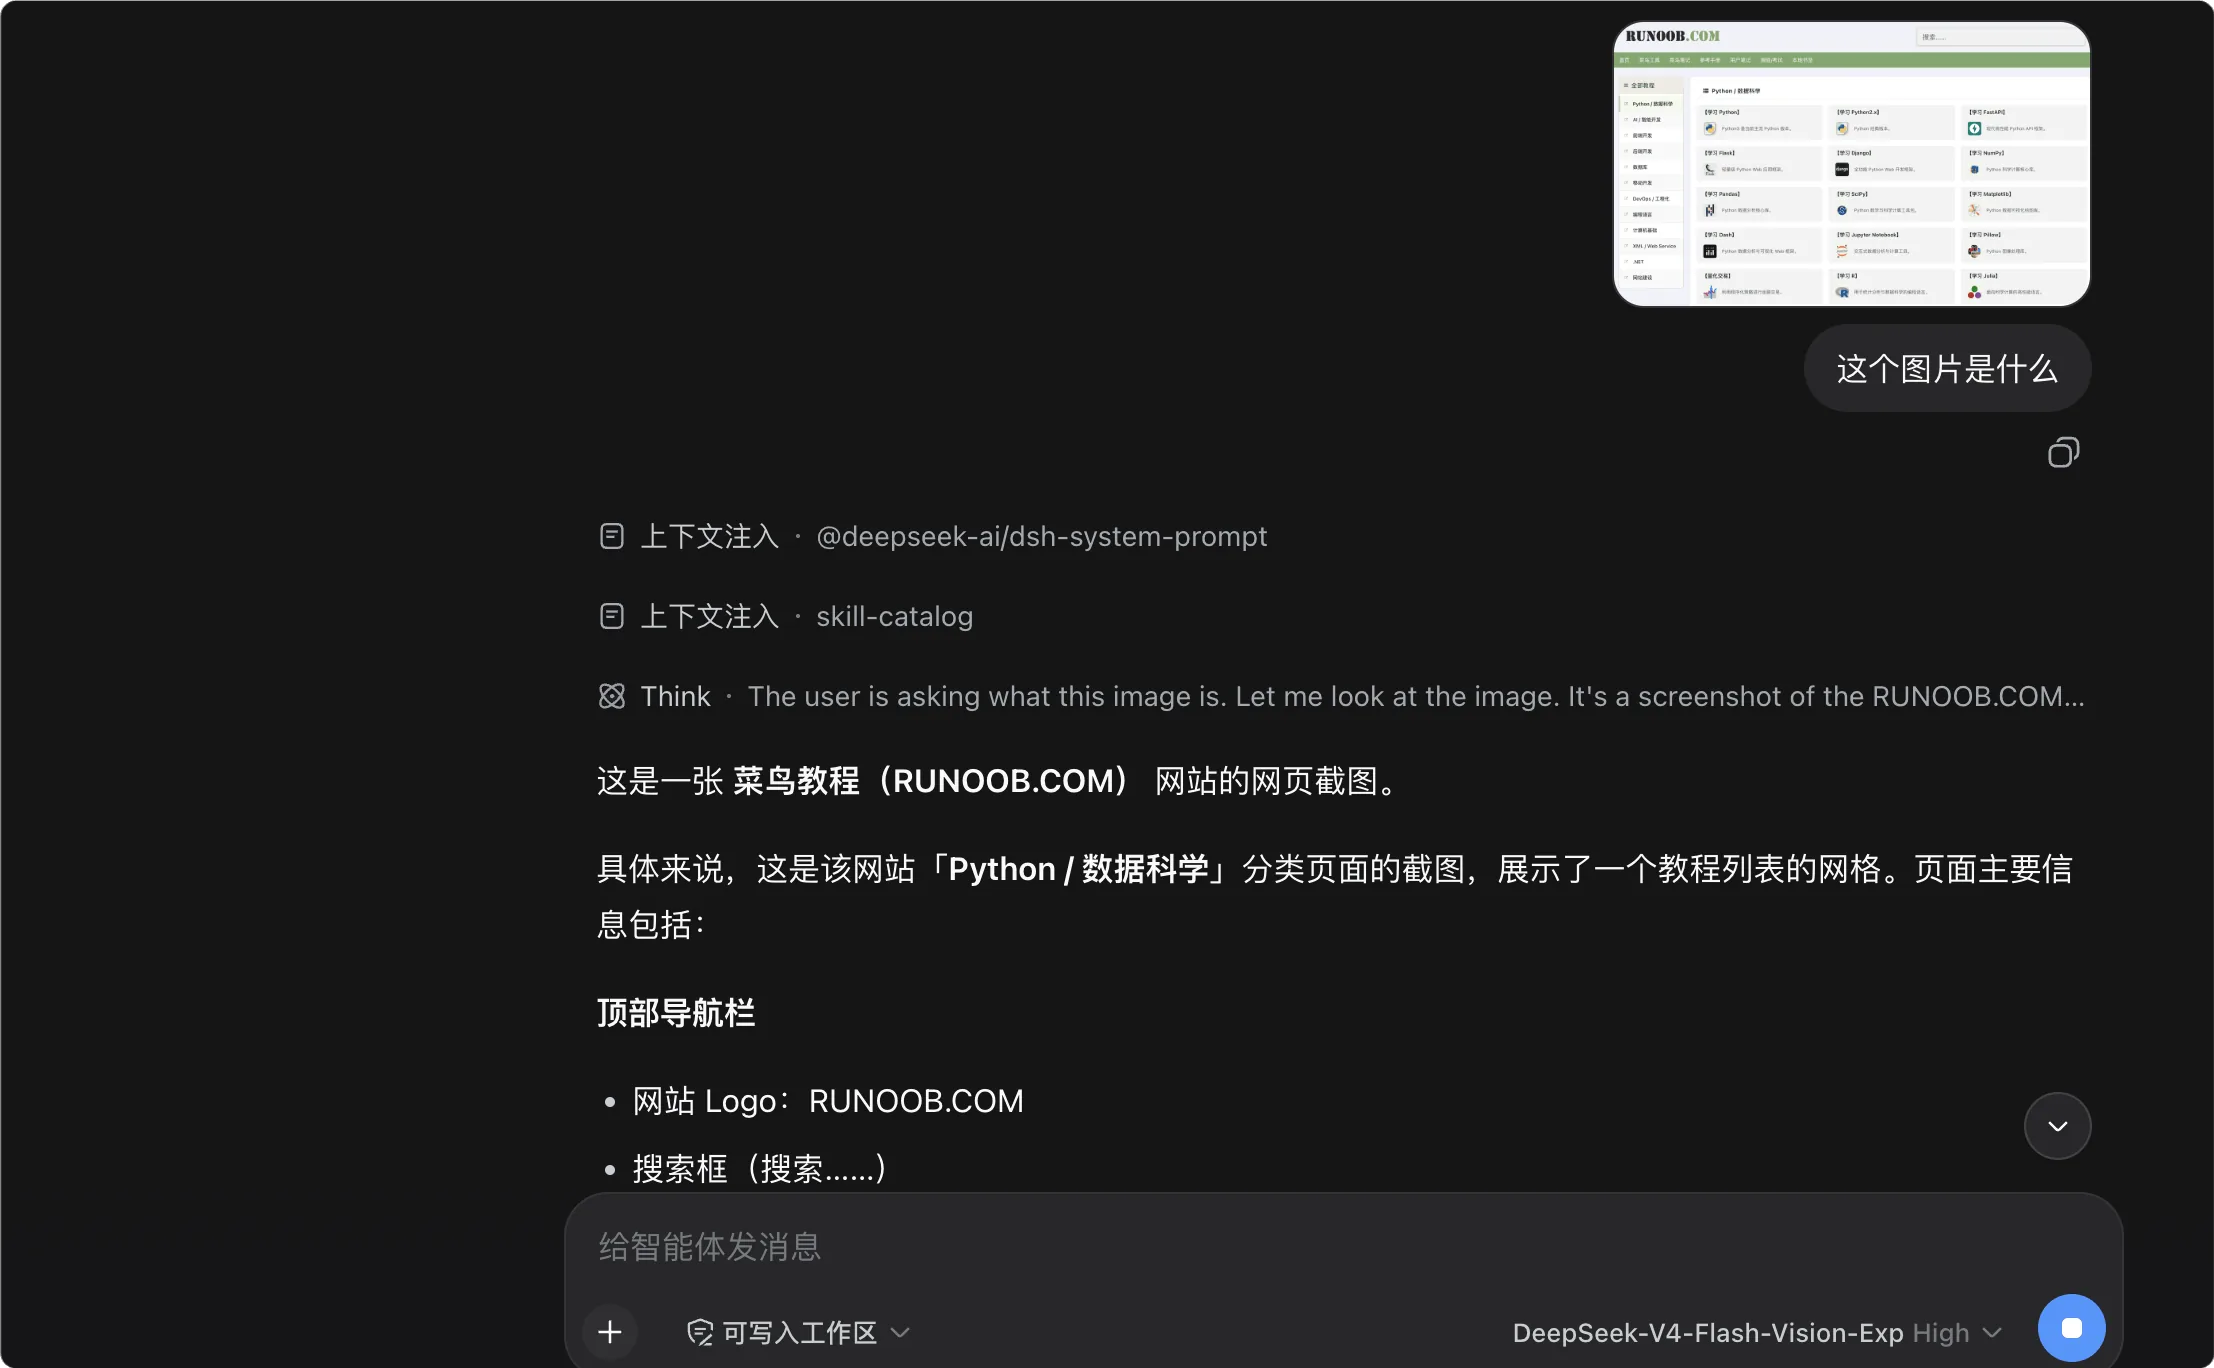
Wechseln Sie zum Vision-Modell, dann können wir Bilder oder PPT-Dateien direkt in das Dokument ziehen, damit es sich den Inhalt der Bilder ansieht ( Testbild herunterladen):
Was ist multimodal
Um Multimodalität zu verstehen, müssen wir zunächst das Wort „Modalität“ verstehen. Modalität bezeichnet verschiedene Formen der Informationsdarstellung: Text ist eine Modalität, und Bilder, Audio und Video sind ebenfalls jeweils unterschiedliche Modalitäten.
| Modalität | Häufige Formen | Entsprechende KI-Fähigkeiten |
|---|---|---|
| Text | Artikel, Code, Gespräche | Großes Sprachmodell (LLM) |
| image | Fotos, Screenshots, Design-Mockups, Diagramme | Modell für visuelles Verständnis |
| Audio | Sprache, Musik | Modelle zur Spracherkennung und -generierung |
| Video | Kurze Videos, Bildschirmaufnahmen, Überwachungsaufnahmen | Modell zum Videoverständnis |
Früher verarbeiteten große Sprachmodelle nur eine einzige Modalität – Text. Alles, was man ihnen sandte, musste zuerst in Text umgewandelt werden.
Multimodale Modelle können gleichzeitig Bilder und Text empfangen und sie einheitlich in Token-Sequenzen umwandeln, bevor sie gemeinsam verarbeitet werden.

Der entscheidende Punkt: Bilder werden vom Modell nicht „direkt gesehen“. Stattdessen schneidet ein Vision-Encoder sie zunächst in Patches und wandelt sie in Vektoren um, die dann mit Text-Tokens zu derselben Sequenz verkettet werden.
Bilder verbrauchen ebenfalls Tokens. Ein Bild belegt bis zu 384 Tokens – genau das ist die Quelle der später erwähnten multimodalen Abrechnungsregeln.
Für Agents bringt Multimodalität einen qualitativen Wandel, nicht nur eine Nice-to-have-Verbesserung.
| Vergleichspunkt | Nur-Text-Modell | Multimodales Modell |
|---|---|---|
| Eingabeform | Nur Text | Text und Bilder gemischt |
| Codefehler beheben | Erfordert, dass Benutzer Fehlermeldungen manuell in Text transkribieren | Fehler-Screenshots direkt senden |
| Das Design-Mockup reproduzieren | Visuelle Entwürfe können nicht referenziert werden | Seiten direkt aus Design-Mockups schreiben |
| Datencharts analysieren | Bilder innerhalb von Bildern können nicht gelesen werden | Das Bild ansehen und direkt Schlussfolgerungen ziehen |
V4-Flash-Vision-Exp: Multimodales Vision-Modell jetzt verfügbar
DeepSeek-V4-Flash-Vision-Exp ist ein experimentelles multimodales Modell zum Bildverständnis und jetzt auf der DeepSeek-API-Plattform verfügbar.
Benutzer können übermodel='deepseek-v4-flash-vision-exp'festlegen. Danach kann auf das Modell zugegriffen werden.
Seine Fähigkeitspositionierung lässt sich in einem Satz zusammenfassen: Textfähigkeiten ohne Kompromisse, visuelle Fähigkeiten mit einem großen Sprung.
Bei reinen Textfähigkeiten (Agent, Reasoning, Weltwissen usw.) ist es auf Augenhöhe mit der offiziellen DeepSeek-V4-Flash-Version.
Bei Agent-Benchmarks, die visuelles Verständnis erfordern, wurde ein bedeutender Sprung gegenüber DeepSeek-V4-Flash erzielt, und die multimodalen Agent-Fähigkeiten nähern sich jetzt Opus-4.8 an.
| Fähigkeitsdimension | DeepSeek-V4-Flash | DeepSeek-V4-Flash-Vision-Exp |
|---|---|---|
| Reine Text-Agent-Aufgaben | Release-Basis | Auf Augenhöhe mit der offiziellen Version |
| Reasoning und Weltwissen | Release-Basis | Auf Augenhöhe mit der offiziellen Version |
| Agent-Aufgaben zum visuellen Verständnis | Nicht unterstützt; multimodale Elemente werden bei der Auswertung ignoriert | Ein großer Sprung, nahe an Opus-4.8 |
| Modellpositionierung | Offizielle Version | Experimentelle Version |
Hinweis zur Evaluierungsmethodik: Für Textaufgaben des Code Agent in öffentlichen Benchmark-Sets werden DeepSeek-Serienmodelle mit dem DeepSeek Harness Minimalmodus als Framework getestet, mit max-Einstellung, temperature=1.0, topp=0.95.
In den Evaluierungen ApexBench und Agents' Last Exam ignoriert das Textmodell DeepSeek-V4-Flash die darin enthaltenen multimodalen Elemente.
Multimodale API – Schnellstart
Die multimodale API unterstützt drei Aufrufformate: Chat Completions, Messages und Responses, was die Integration mit verschiedenen Agent-Tools erleichtert.
Die drei Formate haben identische Fähigkeiten – wählen Sie einfach dasjenige, das dem Ihnen vertrauten Schnittstellenstil entspricht.
| Aufrufformat | Oberflächenstil | Für wen ist es gedacht? |
|---|---|---|
| Chat Completions | Klassische OpenAI-Chat-Schnittstelle | Entwickler, die bereits OpenAI-SDK-Code haben |
| Messages | Anthropic-Messages-Schnittstelle, base_url ist https://api.deepseek.com/anthropic | Entwickler, die bereits Code oder Toolchains im Anthropic-Stil haben |
| Responses | OpenAIs neue Responses-API | Entwickler, die das neue SDK verwenden und prägnante Eingabestrukturen bevorzugen |
Alle drei Formate unterstützen gemischte Bild-Text-Eingaben. Bilder können auf drei Arten übergeben werden: base64 inline, externe URL oder Files API.

| Übergabemethode | Request-Body-Größe | Ob ein Bildhosting-Dienst benötigt wird | Anwendbare Szenarien |
|---|---|---|---|
| base64 inline | groß | Nicht erforderlich | Lokale Bilder, einmalige kleine Bilder |
| Externe URL | gering | erfordert | Bilder, die bereits auf öffentlich zugänglichen Servern bereitgestellt sind |
| Files API | gering | Nicht erforderlich | Dasselbe Bild wird mehrfach verwendet, hochfrequente Batch-Aufgaben |
Methode 1: base64 inline
Nach der Kodierung eines lokalen Bildes als base64-Zeichenkette schreiben Sie es direkt als data URL in den Anfragekörper.
Beispiel
# Abhängigkeit: pip install openai
import base64
from openai import OpenAI
# DeepSeek-Endpunkt ist mit OpenAI SDK kompatibel, ändern Sie einfach base_url zum Umschalten
client = OpenAI(
api_key="sk-your-secret-key", # Erforderlich: durch eigenen DeepSeek-API-Schlüssel ersetzen
base_url="https://api.deepseek.com" # Erforderlich: Offizieller DeepSeek-Endpunkt
)
# Lokales Bild einlesen, in einen Base64-String kodieren
with open("example-logo.png", "rb") as f:
b64 = base64.b64encode(f.read()).decode("utf-8")
response = client.chat.completions.create(
model="deepseek-v4-flash-vision-exp", # Erforderlich: Multimodales Modell für visuelles Verständnis
messages=[
{
"role": "user",
"content": [
# Text und Bilder wechseln sich in der Array-Reihenfolge ab, und das Modell versteht sie in dieser Reihenfolge.
{"type": "text", "text": "Wie lautet der Text im Bild?"},
{
"type": "image_url",
# Base64 inline: data:image-Format;base64,kodierter Inhalt
"image_url": {"url": f"data:image/png;base64,{b64}"}
}
]
}
],
stream=False # Optional: ob die Ausgabe gestreamt werden soll, Standard: False
)
print(response.choices[0].message.content)
Ausgabe:
图片中的文字是 "EXAMPLE"。
Methode 2: Externe URL
Bilder werden auf öffentlich zugänglichen Servern bereitgestellt, und die Anfrage enthält nur einen URL-String, wodurch der Request-Body sehr klein bleibt.
Beispiel
curl https://api.deepseek.com/chat/completions \
-H "Content-Type: application/json" \
-H "Authorization: Bearer ${DEEPSEEK_API_KEY}" \
-d '{
"model": "deepseek-v4-flash-vision-exp",
"messages": [
{
"role": "user",
"content": [
{"type": "text", "text": "Fassen Sie den Trend dieses Diagramms in einem Absatz zusammen."},
{"type": "image_url", "image_url": {"url": "https://static.example.com/images/chart-demo.png"}}
]
}
]
}'
Die URL muss eine öffentliche Adresse sein, die von der Plattform aus erreichbar ist. Interne Netzwerkadressen und lokale Loopback-Adressen können nicht abgerufen werden.
Sowohl die base64- als auch die URL-Methode unterstützen das Hinzufügen eines optionalen detail-Felds in image_url zur Steuerung der Präzision der Bildauflösung.
| detail-Wert | Verhalten | Anwendbare Szenarien |
|---|---|---|
| low | Vor dem Parsen auf 512×512 skalieren, geringerer Token-Verbrauch | Nur ein grober Blick nötig: Bildtyp erkennen, Hauptmotiv finden |
| hoch | Entspricht dem Original | Details müssen klar erkennbar sein |
| original | Analyse unter Beibehaltung der Präzision des Originalbilds | Text lesen, kleine Symbole betrachten, Diagramme analysieren |
| auto | Derzeit entspricht es dem Original | Standardwert, Verhalten, wenn detail nicht übergeben wird |
Das Setzen von detail auf low beim Ausführen von Screenshot-Aufgaben in Stapeln ist der direkteste Weg, die multimodalen Kosten zu steuern.
Messages- und Responses-Format
Wer bereits Code für Anthropic oder im neuen OpenAI-Stil hat, kann nahezu nahtlos auf DeepSeek multimodal umsteigen.
Das Messages-Format verwendet Bild-Inhaltsblöcke, und Bilder werden über das Feld source übergeben.
Beispiel
# Der Endpunkt verwendet DeepSeeks Anthropic-kompatiblen Pfad /anthropic, und die Header-Felder stimmen ebenfalls mit Anthropic überein
curl https://api.deepseek.com/anthropic/v1/messages \
-H "Content-Type: application/json" \
-H "x-api-key: ${DEEPSEEK_API_KEY}" \
-d '{
"model": "deepseek-v4-flash-vision-exp",
"max_tokens": 1024,
"messages": [
{
"role": "user",
"content": [
{
"type": "image",
"source": {
"type": "url",
"url": "https://static.example.com/images/code-screenshot.png"
}
},
{"type": "text", "text": "Dieser Code meldet beim Ausführen einen Fehler; welche Zeile ist das Problem?"}
]
}
]
}'
Das Responses-Format verwendet ein Eingabe-Array, wobei input_text für Text und input_image für Bilder verwendet wird.
Beispiel
# Die Methode zur Client-Erstellung ist dieselbe wie im obigen base64-Beispiel.
response = client.responses.create(
model="deepseek-v4-flash-vision-exp", # Erforderlich: Multimodales Modell für visuelles Verständnis
input=[
{
"role": "user",
"content": [
# Verwenden Sie input_text für Text und input_image für Bilder
{"type": "input_text", "text": "Organisieren Sie die Tabelle im Screenshot in Markdown"},
{
"type": "input_image",
"image_url": "https://static.example.com/images/table.png"
}
]
}
]
)
# Verwenden Sie für das Responses-Format einfach output_text
print(response.output_text)
Files API: zuerst hochladen, dann referenzieren
Die Files API ist jetzt geöffnet, und diese API ist kostenlos.
Benutzer können Bilder zuerst auf die Plattform hochladen und dann in Anfragen über file_id referenzieren.
Dies hat zwei direkte Vorteile: Anfragen enthalten keine großen base64-Blöcke mehr, wodurch Anfragebandbreite gespart wird; dasselbe Bild muss nicht über mehrere Anfragen hinweg wiederholt hochgeladen werden.
Schritt 1: Laden Sie das Bild hoch und rufen Sie die file_id ab.
Beispiel
# Der Upload selbst ist kostenlos und verursacht keine Gebühren.
curl https://api.deepseek.com/files \
-H "Authorization: Bearer ${DEEPSEEK_API_KEY}" \
-F "purpose=user_data" \
-F "file=@example-chart.png"
Nach erfolgreichem Upload gibt die Plattform die Metadaten der Datei zurück.
Beispiel
"id": "file-api-qw3x8v2m6n",
"object": "file",
"filename": "example-chart.png",
"purpose": "user_data",
"bytes": 154320,
"created_at": 1787300000,
"expires_at": 1789900000
}
| Fields | Beschreibung |
|---|---|
| id | Datei-ID, beginnt mit file-api-, wird verwendet, um das Bild in späteren Anfragen zu referenzieren. |
| filename | Ursprünglicher Dateiname beim Hochladen |
| purpose | Dateizweck, aktuell wird nur user_data unterstützt |
| bytes | Dateigröße, in bytes |
| created_at | Upload-Zeit, Unix-Zeitstempel |
| expires_at | Ablaufzeit, optional, wird nur zurückgegeben, wenn beim Hochladen ein Gültigkeitszeitraum festgelegt wurde |
Beim Hochladen können Sie auch den Parameter expires_after verwenden, um einen Gültigkeitszeitraum anzugeben, der von 1 Stunde bis 30 Tage reicht. Wenn er nicht übergeben wird, bleibt die Datei dauerhaft gültig.
Schritt 2: Verweisen Sie mithilfe von file_id in der multimodalen Anfrage auf das Bild.
{
  "model": "deepseek-v4-flash-vision-exp",
  "messages": [
    {
      "role": "user",
      "content": [
        {"type": "text", "text": "这个图表的整体趋势是什么?"},
        {"type": "file", "file_id": "file-api-qw3x8v2m6n"}
      ]
    }
  ]
}
Wann sollte die Files API verwendet werden?
Wenn dasselbe Bild über mehrere Anfragen hinweg wiederverwendet werden muss (zum Beispiel Agent-Aufgaben, die in Batches auf demselben Satz Screenshots ausgeführt werden), spart einmaliges Hochladen und Referenzieren überall mehr Bandbreite und ist schneller, als jedes Mal base64 zu übergeben.
Der Datei-Block unterstützt außerdem file_data für direktes Inline-Base64 (schließt sich gegenseitig mit file_id aus, kann mit dem Feld filename kombiniert werden), geeignet für Szenarien, in denen Sie gelegentlich den Upload-Schritt überspringen möchten.
Wenn Sie eine file_id über den Anthropic-kompatiblen Messages-Endpunkt referenzieren, müssen Sie zusätzlich den Anfrage-Header anthropic-beta: files-api-2025-04-14 angeben.
Abrechnungshinweise und Anmerkungen
Multimodale Anfragen werden nach Token abgerechnet. Bilder werden in Token umgewandelt und fließen dann in die Abrechnung ein.
| Abrechnungsposten | Regeln |
|---|---|
| Bildabrechnung | Bilder werden in Token umgewandelt und nach Token abgerechnet |
| Maximum pro Bild | Bis zu 384 Token |
| Preise | Konsistent mit dem DeepSeek-V4-Flash-Modell |
| Files API | Kostenlos |
Bild-Token belegen Platz im Kontextfenster. Bei Aufgaben mit mehreren Bildern sollten Sie den Gesamtverbrauch beachten: 10 Bilder können bis zu 3840 Token belegen.
Bilder werden vor der Eingabe in das Modell automatisch skaliert: Bilder, die kleiner als etwa 384×384 sind, werden vergrößert, während größere Bilder auf ungefähr die entsprechende Gesamtpixelzahl von 800×800 verkleinert werden.
Daher hängt der Token-Verbrauch nur von den skalierten Abmessungen ab; ein Bild mit 2000×2000 und ein Bild mit 5000×5000 verbrauchen die gleiche Menge; bei Anfragen mit mehreren Bildern wird jedes Bild unabhängig nach derselben Regel berechnet.
base64 vergrößert den Request-Body deutlich. Bei großen Bildern oder häufigen Aufrufen sollten Sie stattdessen externe URLs oder die Files API in Betracht ziehen.
Multimodale Anfragen haben außerdem einige harte Limits. Bei Überschreitung wird direkt ein 400-Fehler zurückgegeben.
| Einschränkung | Regeln |
|---|---|
| Bildformat | JPEG, PNG, GIF, WebP; bestimmt durch den tatsächlichen Dateiinhalt, nicht durch die Dateiendung |
| Länge externer URLs | Nicht mehr als 8192 Zeichen, und das Bild muss innerhalb von 60 Sekunden herunterladbar sein |
| Request-Body-Größe | Nicht mehr als 48 MiB |
| Größe eines einzelnen Bildes | base64- und URL-Methode max. 32 MiB, Files API max. 64 MiB |
| Anzahl der Bilder pro Anfrage | Bis zu 600 Bilder |
| Maximale Bildseitenlänge | 8192 Pixel; wenn eine Anfrage 15 oder mehr Bilder enthält, sinkt der Wert auf 4096 Pixel |
| Bildposition | Kann nur in Benutzernachrichten platziert werden. Das Einfügen von Bildern in System- und Assistentennachrichten führt zu einem Fehler. |
V4-Flash-Vision-Exp ist ein experimentelles Modell. Funktionen und Service-Spezifikationen können sich mit Versionsiterationen ändern. Für kritische Produktionspipelines wird empfohlen, auch offizielle Modelle zu evaluieren.
Für vollständigere Nutzungshinweise lesen Sie bitte die offizielle API-Dokumentation:API-Leitfaden – Bildverständnis、API-Leitfaden – Dateien-API。
Zusammenfassung
V4-Flash-Vision-Exp bringt multimodale Fähigkeiten in DeepSeeks Agent-Ökosystem mit der Positionierung "Text ohne Kompromisse, Vision mit einem großen Sprung."
Für Entwickler sind die Einstiegskosten sehr niedrig: Ändern Sie einfach einen Modellnamen, und Agents in DeepSeek Harness können Screenshots, Design-Mockups und Diagramme verstehen.
Es wird empfohlen, zuerst die drei offiziellen Beispiele auszuprobieren, um ein Gefühl dafür zu bekommen, und dann Ihre eigenen Geschäftsbilder einzubringen und Ihre erste Agent-Aufgabe nach dem Motto "Bild ansehen und Arbeit erledigen" zum Laufen zu bringen.