Base de datos vectorial
En la era de la IA, la forma de los datos que manejamos ha cambiado radicalmente.
Las bases de datos tradicionales almacenan datos estructurados: números, cadenas, fechas.
Las aplicaciones de IA procesan semántica: el significado de un texto, el contenido de una imagen, el sentido de un audio. Esta información semántica se representa como vectores: una serie de números de punto flotante, por ejemplo [0.123, -0.456, 0.789, ...].
Una base de datos vectorial es una base de datos especializada en almacenar, indexar y consultar estos vectores. Sin ella, RAG (generación aumentada por recuperación) no es posible, la búsqueda semántica no se implementa y los sistemas de recomendación no pueden funcionar de manera eficiente.
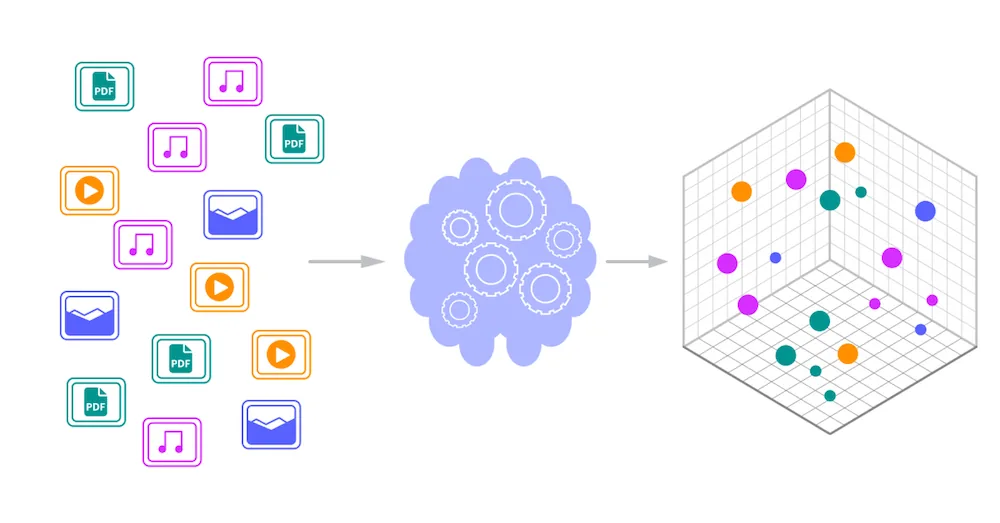
El valor central de una base de datos vectorial:Encontrar en milisegundos los primeros K resultados más similares al vector de consulta entre millones o incluso miles de millones de vectores。
Desafíos de la búsqueda por similitud vectorial
Solo entendiendo la naturaleza del problema se puede entender por qué se necesitan algoritmos especializados.
El problema de complejidad de la búsqueda por fuerza bruta
La idea más simple es la búsqueda por fuerza bruta: calcular la similitud entre el vector de consulta y cada vector de la base, ordenar y tomar los primeros K.
Ejemplo
# Demostración de búsqueda por fuerza bruta: simple pero ineficiente
# ============================================
import numpy as np
from typing import List, Tuple
def l2_distance(v1: np.ndarray, v2: np.ndarray) -> float:
"""Calcula la distancia euclidiana L2: cuanto menor, más similar"""
return np.sqrt(np.sum((v1 - v2) ** 2))
def brute_force_search(
query: np.ndarray,
vectors: List[np.ndarray],
top_k: int = 5
) -> List[Tuple[int, float]]:
"""
Búsqueda por fuerza bruta: calcula la distancia con todos los vectores, ordena y devuelve el Top K
Ventajas: simple y precisa, 100% de recuperación
Desventajas: extremadamente lenta con grandes volúmenes de datos
"""
# Calcula la distancia con cada vector
distances = []
for idx, vec in enumerate(vectors):
dist = l2_distance(query, vec)
distances.append((idx, dist))
# Ordena por distancia y toma los primeros K
distances.sort(key=lambda x: x[1])
return distances[:top_k]
# Genera 10000 vectores aleatorios de 128 dimensiones (simula la base de vectores)
np.random.seed(42)
vector_count = 10000
dimension = 128
vectors = [np.random.randn(dimension) for _ in range(vector_count)]
# Genera un vector de consulta
query_vector = np.random.randn(dimension)
# Ejecuta la búsqueda por fuerza bruta
print(f"Buscando Top 5 en {vector_count} vectores...")
results = brute_force_search(query_vector, vectors, top_k=5)
print("Resultado de la búsqueda:")
for idx, dist in results:
print(f" Vector {idx:4d}, distancia = {dist:.4f}")
# Salida similar a:
# Buscando Top 5 en 10000 vectores...
# Resultado de la búsqueda:
# Vector 8236, distancia = 13.3986
# Vector 8946, distancia = 13.5604
# Vector 9891, distancia = 13.5688
# Vector 5172, distancia = 13.5987
# Vector 5223, distancia = 13.6081
El problema de la búsqueda por fuerza bruta es evidente: cada consulta debe recorrer todos los vectores.
Si hay 1 millón de vectores, cada consulta requiere calcular 1 millón de distancias.
Si hay 1000 millones de vectores, cada consulta requiere calcular 1000 millones de distancias; esto es totalmente inaceptable en entornos de producción.
La "maldición de la dimensionalidad" en espacios de alta dimensión
Para colmo, los vectores suelen ser de alta dimensionalidad.
El text-embedding-3-small de OpenAI tiene 1536 dimensiones, y el large tiene 3072.
En espacios de alta dimensión, los métodos tradicionales de indexación espacial (como KD-Tree) caen drásticamente en eficiencia, incluso más lentos que la búsqueda por fuerza bruta.
| Escala de datos | Tiempo de búsqueda por fuerza bruta (estimado) | ¿Aceptable? |
|---|---|---|
| 10 000 | ~1 milisegundo | Aceptable |
| 1 000 000 | ~100 milisegundos | Un poco lento |
| 10 000 000 | ~1 segundo | Demasiado lento |
| 100 000 000 | ~10 segundos | Totalmente inaceptable |
| 1 000 000 000 | ~100 segundos | Inutilizable |
Por eso se necesitanalgoritmos de vecinos más cercanos aproximados (ANN): renunciar al 100% de precisión a cambio de una mejora de velocidad de 100 veces o incluso 1000 veces.
Algoritmo de vecinos más cercanos aproximados (ANN)
La idea central del algoritmo ANN:Construir una estructura de índice para que la consulta no tenga que recorrer todos los vectores。
Hay tres algoritmos principales: HNSW, IVF, PQ.
HNSW: grafo de mundo pequeño jerárquico
HNSW (Hierarchical Navigable Small World) es uno de los algoritmos más populares actualmente. Su inspiración proviene de la teoría de los seis grados de separación: cualquiera dos personas en el mundo pueden conectarse a través de, como máximo, 6 intermediarios.
HNSW utiliza un grafo de mundo pequeño jerárquico y disperso: desde los nodos dispersos de la capa superior realiza una localización gruesa rápida, desciende capa por capa hasta la capa inferior de datos completos para una búsqueda fina, y mediante saltos jerárquicos reduce drásticamente el número de cálculos de distancia, logrando una búsqueda de vecinos aproximados de alta velocidad y alta recuperación.
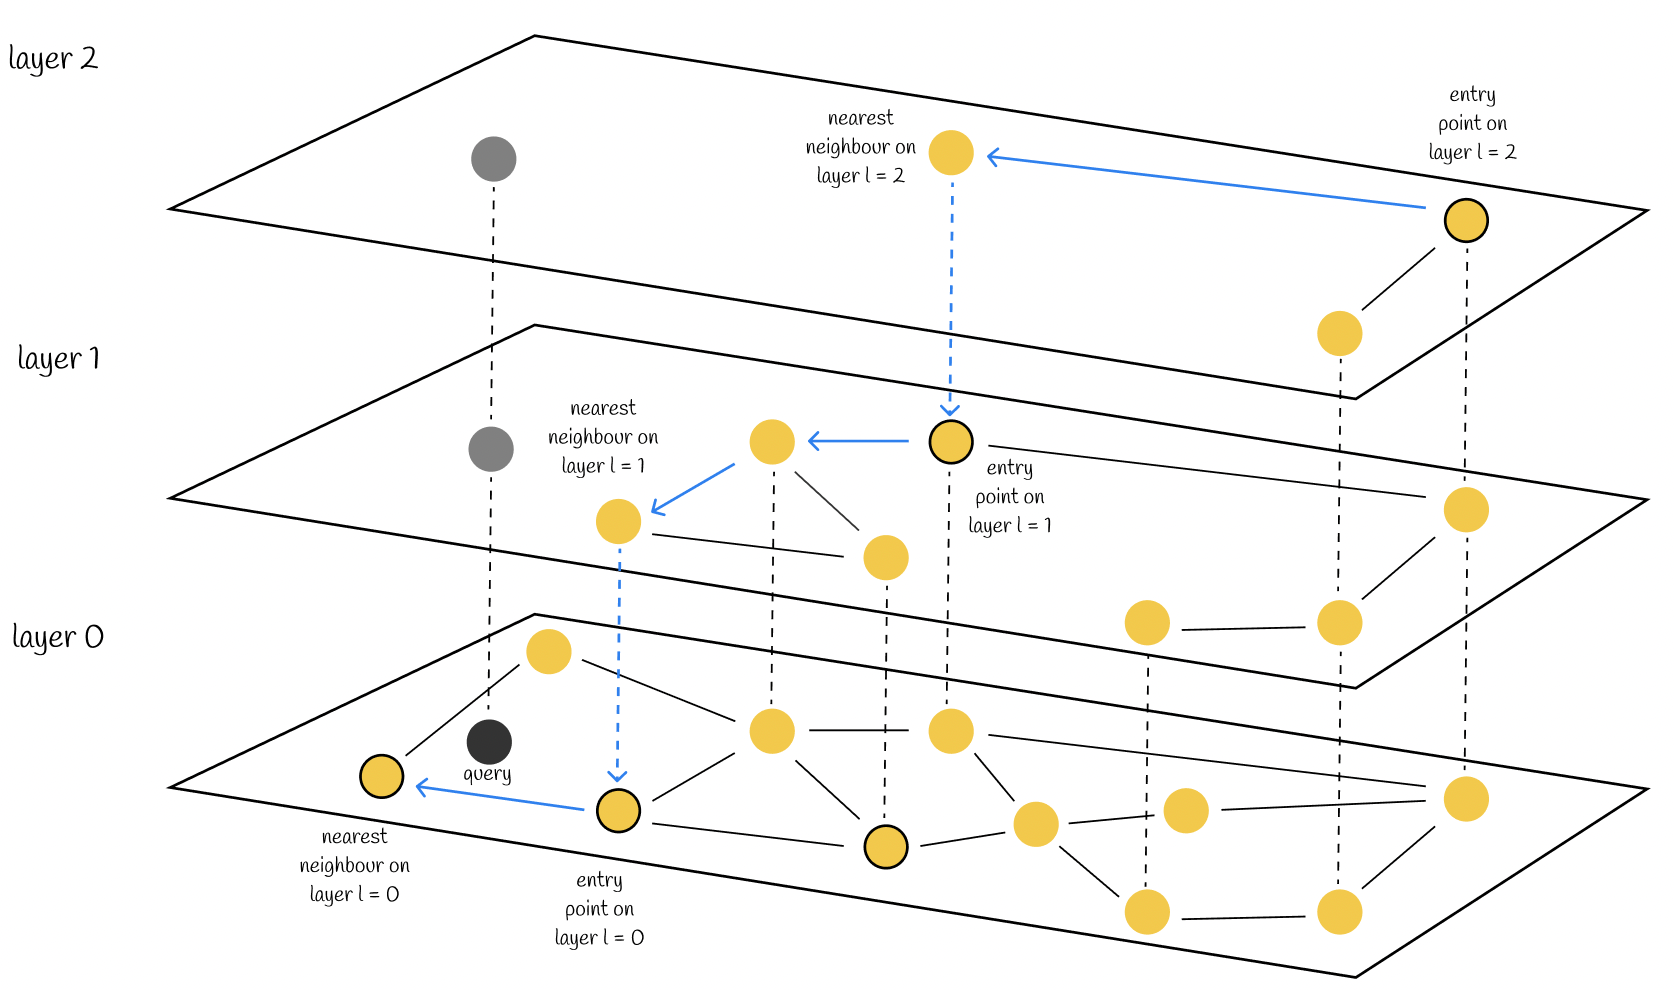
Estructura jerárquica:La capa inferior Layer0 almacena todos los vectores; cuanto mayor es el nivel, menos nodos hay, actuando como un canal de alta velocidad; el mismo vector se asocia verticalmente entre capas con líneas discontinuas.
Proceso de búsqueda (ruta de línea azul):
- Búsqueda gruesa desde la entrada de la capa superior, encuentra el punto más cercano al vector de consulta en esta capa.
- Desciende verticalmente a la capa media, vuelve a localizar de forma gruesa.
- Cae a Layer0, la capa completa, recorre finamente y produce el vecino más cercano.
Principio central:Las capas superiores reducen rápidamente el rango de búsqueda, la capa inferior hace coincidencia precisa, optimizando la búsqueda por fuerza bruta a complejidad logarítmica, con alta velocidad y alta recuperación; es el algoritmo principal de recuperación vectorial.
Ejemplo
# Demostración simplificada del principio de HNSW (no es una implementación de producción)
# ============================================
import numpy as np
import random
from typing import List, Dict, Set, Tuple
class SimpleHNSW:
"""Versión simplificada de HNSW, solo para demostrar el principio"""
def __init__(self, dim: int, max_level: int = 3, ef_construction: int = 5):
self.dim = dim
self.max_level = max_level # Número máximo de capas
self.ef_construction = ef_construction # Número de candidatos considerados al construir el grafo
self.levels: List[Dict[int, np.ndarray]] = [{} for _ in range(max_level)]
self.edges: List[Dict[int, Set[int]]] = [{} for _ in range(max_level)]
self.next_id = 0
self.enter_point = None # Punto de entrada (un punto de la capa superior)
def _random_level(self) -> int:
"""Selecciona un nivel al azar: cuanto más alto, menor probabilidad"""
level = 0
while random.random() < 0.5 and level < self.max_level - 1:
level += 1
return level
def _distance(self, v1: np.ndarray, v2: np.ndarray) -> float:
"""Distancia L2"""
return np.sqrt(np.sum((v1 - v2) ** 2))
def _search_layer(
self,
query: np.ndarray,
level: int,
entry: int,
ef: int
) -> List[Tuple[float, int]]:
"""Busca en una capa: comenzando desde entry, encuentra greedy los ef puntos más cercanos"""
if entry not in self.levels[level]:
return []
visited = set([entry])
candidates = [(self._distance(query, self.levels[level][entry]), entry)]
result = list(candidates)
while candidates:
# Toma el candidato más cercano actual
candidates.sort()
dist, current = candidates.pop(0)
# Recorre los vecinos
if current not in self.edges[level]:
continue
for neighbor in self.edges[level][current]:
if neighbor in visited:
continue
visited.add(neighbor)
neighbor_dist = self._distance(query, self.levels[level][neighbor])
# Añade al candidato y al conjunto de resultados
candidates.append((neighbor_dist, neighbor))
result.append((neighbor_dist, neighbor))
# Mantiene el tamaño del conjunto de resultados no mayor que ef
result.sort()
result = result[:ef]
return result
def add(self, vector: np.ndarray) -> int:
"""Agrega un vector"""
vec_id = self.next_id
self.next_id += 1
# Determina aleatoriamente en qué capas aparece este vector
max_level_for_vec = self._random_level()
# Almacena el vector en todas las capas (en implementaciones reales normalmente solo se almacena el vector completo en la capa inferior)
for level in range(max_level_for_vec + 1):
self.levels[level][vec_id] = vector
self.edges[level][vec_id] = set()
# Si es el primer punto, se establece como entrada
if self.enter_point is None:
self.enter_point = vec_id
return vec_id
# Busca desde la capa superior hacia abajo, encontrando la posición de inserción en cada capa
current_entry = self.enter_point
# Primero busca en capas superiores a max_level_for_vec, actualiza la entrada
for level in range(self.max_level - 1, max_level_for_vec, -1):
if current_entry in self.levels[level]:
layer_result = self._search_layer(vector, level, current_entry, 1)
if layer_result:
current_entry = layer_result[0][1]
# En max_level_for_vec y capas inferiores, establece conexiones
for level in range(max_level_for_vec, -1, -1):
# Busca en esta capa los ef_construction puntos más cercanos
layer_result = self._search_layer(vector, level, current_entry, self.ef_construction)
# Conecta con estos puntos (simplificado: conexión bidireccional)
for dist, neighbor_id in layer_result:
self.edges[level][vec_id].add(neighbor_id)
self.edges[level][neighbor_id].add(vec_id)
# Actualiza la entrada de la siguiente capa
if layer_result:
current_entry = layer_result[0][1]
# Actualiza la entrada de la capa superior
if max_level_for_vec > self._random_level(): # Juicio simplificado
self.enter_point = vec_id
return vec_id
def search(self, query: np.ndarray, top_k: int = 5, ef: int = 10) -> List[Tuple[int, float]]:
"""Busca los Top K vecinos más cercanos"""
if self.enter_point is None:
return []
current_entry = self.enter_point
# Desde el nivel superior hacia abajo, hasta el primer nivel
for level in range(self.max_level - 1, 0, -1):
if current_entry in self.levels[level]:
layer_result = self._search_layer(query, level, current_entry, 1)
if layer_result:
current_entry = layer_result[0][1]
# En el nivel inferior, busca ef puntos y luego devuelve el Top K
layer_result = self._search_layer(query, 0, current_entry, ef)
layer_result.sort()
return [(vec_id, dist) for dist, vec_id in layer_result[:top_k]]
# Prueba
np.random.seed(42)
dim = 128
hnsw = SimpleHNSW(dim=dim, max_level=3, ef_construction=5)
# Agregar 100 vectores
print("Construyendo índice HNSW (agregando 100 vectores)...")
for i in range(100):
vec = np.random.randn(dim)
hnsw.add(vec)
print(f"Construcción del índice completada, punto de entrada = {hnsw.enter_point}")
# Generar vector de consulta
query = np.random.randn(dim)
# Buscar
print("\n"Ejecutando búsqueda HNSW...")
results = hnsw.search(query, top_k=5, ef=10)
print("Resultados de la búsqueda:")
for vec_id, dist in results:
print(f" Vector {vec_id:3d}, distancia = {dist:.4f}")
# Salida aproximadamente:
# Construyendo índice HNSW (agregando 100 vectores)...
# Construcción del índice completada, punto de entrada = 54
#
# Ejecutando búsqueda HNSW...
# Resultados de la búsqueda:
# Vector 86, distancia = 13.7515
# Vector 30, distancia = 13.8651
# Vector 28, distancia = 14.0754
# Vector 56, distancia = 14.1106
# Vector 34, distancia = 14.2131
Ventajas de HNSW:
1. Búsqueda rápida: normalmente solo se necesitan visitar unos pocos nodos para encontrar los vecinos más cercanos.
-
2. Construcción rápida: se pueden añadir vectores de forma incremental, sin necesidad de reconstruir todo el índice.
-
3. Parámetros simples: principalmente se ajustan ef_construction (calidad del grafo) y ef (calidad de búsqueda).
IVF: índice de archivos invertidos
La idea de IVF (Inverted File) es "divide y vencerás".
Pasos:
-
1. Clustering: divide el espacio vectorial en K "cubos" (usando K-Means).
-
2. Indexación: cada vector se asigna al cubo más cercano.
-
3. Consulta: primero se encuentran los N cubos más cercanos al vector de consulta, y solo se busca en esos N cubos.
Ejemplo
# Demostración simplificada del principio de IVF
# ============================================
import numpy as np
from typing import List, Tuple
class SimpleIVF:
"""Versión simplificada de IVF, solo para demostrar el principio"""
def __init__(self, dim: int, nlist: int = 10):
self.dim = dim
self.nlist = nlist # Número de centros de clustering (número de cubos)
self.centroids: np.ndarray = None # Centros de clustering
self.inverted_lists: List[List[Tuple[int, np.ndarray]]] = [[] for _ in range(nlist)]
self.next_id = 0
def _l2_distance(self, v1: np.ndarray, v2: np.ndarray) -> float:
"""Distancia L2"""
return np.sqrt(np.sum((v1 - v2) ** 2))
def _find_nearest_centroid(self, vector: np.ndarray) -> int:
"""Encontrar el centro de clustering más cercano"""
distances = [self._l2_distance(vector, c) for c in self.centroids]
return int(np.argmin(distances))
def fit(self, vectors: List[np.ndarray]):
"""Inicializar los centros de clustering con K-Means (versión simplificada: elección aleatoria)"""
# Simplificado: elegir aleatoriamente nlist vectores como centros iniciales
# En una implementación real se debería usar la iteración de K-Means
indices = np.random.choice(len(vectors), self.nlist, replace=False)
self.centroids = np.array([vectors[i] for i in indices])
def add(self, vector: np.ndarray) -> int:
"""Agregar vector"""
vec_id = self.next_id
self.next_id += 1
# Encontrar el cubo más cercano
centroid_idx = self._find_nearest_centroid(vector)
# Ponerlo en este cubo
self.inverted_lists[centroid_idx].append((vec_id, vector))
return vec_id
def search(self, query: np.ndarray, top_k: int = 5, nprobe: int = 3) -> List[Tuple[int, float]]:
"""
Buscar Top K
nprobe: en cuántos cubos buscar (cuantos más, más preciso, pero más lento)
"""
# Encontrar los nprobe cubos más cercanos
centroid_distances = [
(self._l2_distance(query, c), i)
for i, c in enumerate(self.centroids)
]
centroid_distances.sort()
nearest_centroids = [i for dist, i in centroid_distances[:nprobe]]
# Buscar solo en estos nprobe cubos
candidates = []
for centroid_idx in nearest_centroids:
for vec_id, vec in self.inverted_lists[centroid_idx]:
dist = self._l2_distance(query, vec)
candidates.append((dist, vec_id))
# Ordenar y devolver el Top K
candidates.sort()
return [(vec_id, dist) for dist, vec_id in candidates[:top_k]]
# Prueba
np.random.seed(42)
dim = 128
# Generar 1000 vectores
vectors = [np.random.randn(dim) for _ in range(1000)]
# Construir índice IVF
ivf = SimpleIVF(dim=dim, nlist=20)
ivf.fit(vectors)
# Agregar vectores
for vec in vectors:
ivf.add(vec)
print(f"Índice IVF construido, número de cubos = {ivf.nlist}")
for i in range(ivf.nlist):
print(f" Cubo {i:2d}: {len(ivf.inverted_lists[i])} vectores")
# Consulta
query = np.random.randn(dim)
print("\n"Ejecutando búsqueda IVF (nprobe=3)...")
results = ivf.search(query, top_k=5, nprobe=3)
print("Resultados de la búsqueda:")
for vec_id, dist in results:
print(f" Vector {vec_id:3d}, distancia = {dist:.4f}")
# Salida aproximadamente:
# Índice IVF construido, número de cubos = 20
# Cubo 0: 63 vectores
# Cubo 1: 56 vectores
# ...
#
# Ejecutando búsqueda IVF (nprobe=3)...
# Resultados de la búsqueda:
# Vector 863, distancia = 13.5409
# Vector 189, distancia = 13.7083
# Vector 491, distancia = 13.8628
# Vector 264, distancia = 13.9812
# Vector 781, distancia = 14.0021
La ventaja de IVF es que ocupa poca memoria y se puede ajustar dinámicamente el parámetro nprobe en la consulta para equilibrar velocidad y precisión.
PQ: cuantificación por producto
PQ (Product Quantization) es un algoritmo de compresión.
Idea central:
-
1. Segmentación: dividir el vector de alta dimensionalidad en varios segmentos pequeños (subvectors).
-
2. Cuantización: agrupar cada segmento por separado y usar el ID del centro de clustering en lugar del vector original.
-
3. Búsqueda en tabla: al consultar, se utiliza la búsqueda en tabla para calcular rápidamente la distancia aproximada.
Por ejemplo, un vector de 128 dimensiones se divide en 8 segmentos de 16 dimensiones cada uno, y cada segmento se cuantifica con 256 centros; el resultado es que cada vector solo necesita 8 bytes de almacenamiento (antes necesitaba 128 * 4 = 512 bytes).
Combinación IVF-PQ
En entornos de producción, normalmente se combinan IVF y PQ:
IVF se encarga de "dividir en cubos" para reducir el alcance de búsqueda, y PQ se encarga de "comprimir" para reducir memoria y cálculo.
| Algoritmo | Velocidad | Precisión | Memoria | Escenarios de uso |
|---|---|---|---|---|
| Búsqueda por fuerza bruta | Lento | 100% | Alto | Datos pequeños, se necesita 100% de precisión |
| HNSW | Muy rápida | Alto | Medio | Consultas densas, se necesita baja latencia |
| IVF | Rápido | Medio | bajo | Datos a gran escala, se acepta una pequeña pérdida de precisión |
| IVF-PQ | Muy rápida | Medio | Muy baja | Datos a escala masiva, memoria limitada |
Medidas de similitud
Hay varias formas de calcular la "similitud", y es importante elegir la medida correcta.
Similitud coseno
La similitud del coseno mide el ángulo entre las direcciones de dos vectores, con un rango de valores [-1, 1].
Cuanto más cercano a 1, más similares; cuanto más cercano a -1, más opuestos.
Ejemplo
# Cálculo de la similitud del coseno
# ============================================
import numpy as np
def cosine_similarity(v1: np.ndarray, v2: np.ndarray) -> float:
"""
Similitud del coseno = (v1 · v2) / (|v1| * |v2|)
Rango de valores [-1, 1], cuanto más cercano a 1, más similar
"""
dot_product = np.dot(v1, v2)
norm1 = np.linalg.norm(v1)
norm2 = np.linalg.norm(v2)
return dot_product / (norm1 * norm2)
# Prueba
np.random.seed(42)
v1 = np.array([1, 2, 3, 4, 5])
v2 = np.array([2, 4, 6, 8, 10]) # Misma dirección
v3 = np.array([-1, -2, -3, -4, -5]) # Dirección opuesta
v4 = np.random.randn(5) # Aleatorio
print(f"v1 = {v1}")
print(f"v2 = {v2}")
print(f"v3 = {v3}")
print(f"v4 = {v4}")
print()
print(f"cosine(v1, v2) = {cosine_similarity(v1, v2):.4f} (misma dirección, debe ser 1.0)")
print(f"cosine(v1, v3) = {cosine_similarity(v1, v3):.4f} (dirección opuesta, debe ser -1.0)")
print(f"cosine(v1, v4) = {cosine_similarity(v1, v4):.4f}")
# Salida:
# v1 = [1 2 3 4 5]
# v2 = [ 2 4 6 8 10]
# v3 = [-1 -2 -3 -4 -5]
# v4 = [ 0.4967 -0.1383 0.6477 1.5230 -0.2342]
#
# cosine(v1, v2) = 1.0000 (misma dirección, debe ser 1.0)
# cosine(v1, v3) = -1.0000 (dirección opuesta, debe ser -1.0)
# cosine(v1, v4) = 0.2143
La característica de la similitud del coseno es que no le importa la longitud de los vectores, solo la dirección. Esto es muy común en los embeddings de texto, porque la "semántica" del texto no tiene relación con la longitud.
Distancia euclidiana L2
La distancia L2 es la distancia en línea recta entre dos puntos en el espacio; cuanto más pequeña, más similar.
Producto interno (Inner Product / Dot Product)
Producto interno = v1 · v2. Si los vectores están normalizados, el producto interno es igual a la similitud del coseno.
Guía de selección
| Medida | Rango de valores | Cuándo elegir | Casos de uso típicos |
|---|---|---|---|
| Similitud del coseno | [-1, 1] | Solo importa la dirección, no la longitud | Embeddings de texto, búsqueda semántica |
| Distancia L2 | [0, ∞) | La posición espacial es importante | Características de imagen, sistemas de recomendación |
| Producto interno | (-∞, ∞) | Vectores normalizados, o la longitud es significativa | Ciertos modelos de embedding específicos |
La mayoría de los modelos de embedding (como la serie text-embedding de OpenAI) generan vectores normalizados, en ese casosimilitud del coseno = producto interno, usar cualquiera es lo mismo.
Comparación de bases de datos vectoriales principales
Las bases de datos vectoriales se dividen en tres categorías: bibliotecas locales (FAISS), ligeras de código abierto (Chroma, Qdrant) y empresariales (Milvus, Pinecone, Weaviate).
FAISS: biblioteca local de Facebook
FAISS no es una base de datos completa, sino una biblioteca de C++ (con enlaces de Python).
Ejemplo
# Demostración de uso básico de FAISS
# ============================================
import numpy as np
# Nota: para ejecutar realmente, primero debe instalar FAISS
# pip install faiss-cpu (versión CPU)
# o
# pip install faiss-gpu (versión GPU)
# A continuación se muestra el uso típico de FAISS (ejemplo de código, no se ejecuta realmente)
def faiss_example():
"""Ejemplo de uso de FAISS"""
# 1. Preparar los datos
dimension = 128
nb = 10000 # Número de vectores en la base de datos
nq = 10 # Número de vectores de consulta
np.random.seed(42)
xb = np.random.random((nb, dimension)).astype('float32') # Base de datos
xq = np.random.random((nq, dimension)).astype('float32') # Consulta
# 2. Crear el índice (ejemplo IVF)
import faiss
nlist = 100 # Número de centros de clúster
quantizer = faiss.IndexFlatL2(dimension) # Cuantizador
index = faiss.IndexIVFFlat(quantizer, dimension, nlist, faiss.METRIC_L2)
# 3. Entrenar el índice
index.train(xb)
# 4. Agregar vectores
index.add(xb)
# 5. Establecer nprobe al buscar
index.nprobe = 10
# 6. Buscar los Top 5
k = 5
distances, indices = index.search(xq, k)
print("Resultados de la consulta (Top 5 de las primeras 2 consultas):")
for i in range(min(2, nq)):
print(f"Consulta {i}:")
for j in range(k):
print(f" Índice {indices[i][j]}, distancia {distances[i][j]:.4f}")
return index
# Ejemplo de índice HNSW
def faiss_hnsw_example():
"""Índice HNSW de FAISS"""
import faiss
dimension = 128
index = faiss.IndexHNSWFlat(dimension, 32) # 32 = parámetro M (número de conexiones por nodo)
index.hnsw.efConstruction = 40 # ef al construir el grafo
index.hnsw.efSearch = 16 # ef al buscar
# Agregar datos...
# index.add(xb)
return index
# Si tiene FAISS instalado, puede descomentar las líneas siguientes para ejecutar
# faiss_example()
print("Código de ejemplo de FAISS: este es el uso típico de FAISS.")
print("Pasos clave: crear índice → entrenar → agregar vectores → buscar.")
print()
print("Tipos de índice comunes de FAISS:")
print(" - IndexFlatL2: búsqueda exhaustiva (precisa pero lenta)")
print(" - IndexIVFFlat: búsqueda por buckets IVF")
print(" - IndexIVFPQ: compresión IVF + PQ")
print(" - IndexHNSWFlat: índice de grafo HNSW")
Características de FAISS:
-
1. Muy rápido: implementación en C++, optimizada al máximo.
-
2. Funciones completas: admite casi todos los algoritmos ANN principales.
-
3. Local: sin red, sin persistencia (debe guardar los archivos de índice usted mismo).
Escenarios aplicables: procesamiento por lotes offline, no quiere montar un servicio, la cantidad de datos no es especialmente grande.
Chroma: ligera y local primero
Chroma es una base de datos vectorial simple y fácil de usar, cuyo objetivo de diseño es "hacer que el desarrollo de aplicaciones de IA sea más rápido".
Ejemplo
# Demostración de uso básico de Chroma
# ============================================
# Instalación: pip install chromadb
def chroma_example():
"""Ejemplo de uso de Chroma"""
import chromadb
from chromadb.utils import embedding_functions
# 1. Inicializar el cliente (modo local, los datos se guardan en disco)
client = chromadb.PersistentClient(path="./ejemplo-chroma-db")
# 2. Crear u obtener una colección
collection = client.get_or_create_collection(
name="ejemplo_docs",
metadata={"description": "Colección de documentos del tutorial para novatos"}
)
# 3. Agregar documentos (Chroma maneja el embedding automáticamente)
# Puede usar OpenAI, Cohere, etc., o proporcionar sus propios vectores
documents = [
"Python es un lenguaje de programación interpretado, de alto nivel y de propósito general.",
"JavaScript es un lenguaje de programación ligero e interpretado.",
"Las bases de datos vectoriales se utilizan para almacenar y recuperar incrustaciones vectoriales.",
"RAG, o generación aumentada por recuperación, es una técnica que combina la recuperación y la generación.",
"HNSW es un algoritmo de vecinos más cercanos aproximados basado en un grafo de mundo pequeño jerárquico."
]
metadatas = [
{"category": "programming", "language": "Python"},
{"category": "programming", "language": "JavaScript"},
{"category": "database", "topic": "vector"},
{"category": "ai", "topic": "rag"},
{"category": "algorithm", "topic": "hnsw"}
]
ids = ["doc1", "doc2", "doc3", "doc4", "doc5"]
# Agregar (aquí se usan vectores simulados; en la práctica se debe usar un modelo de embedding)
import numpy as np
np.random.seed(42)
embeddings = [np.random.randn(128).tolist() for _ in range(5)]
collection.add(
documents=documents,
metadatas=metadatas,
ids=ids,
embeddings=embeddings # Si no se proporcionan, Chroma usa la función embed predeterminada
)
print(f"La colección tiene un total de {collection.count()} documentos")
# 4. Consulta
query_embedding = np.random.randn(128).tolist()
results = collection.query(
query_embeddings=[query_embedding],
n_results=3,
# Se puede agregar filtrado por metadatos
# where={"category": "ai"}
)
print("\n"Resultados de la consulta:")
for i in range(len(results['ids'][0])):
print(f"ID: {results['ids'][0][i]}")
print(f"Documento: {results['documents'])
print(f"Distancia: {results['distances'])
print("---")
return collection
# Si tiene Chroma instalado, puede descomentar las líneas siguientes para ejecutar
# chroma_example()
print("Código de ejemplo de Chroma: diseño simple, listo para usar.")
print()
print("Características de Chroma:")
print(" - Simple: API amigable, se aprende en minutos")
print(" - Local-first: puede persistir en disco o ejecutarse en memoria")
print(" - Embedding integrado: admite OpenAI, Cohere, Sentence-Transformers")
print(" - Admite filtrado por metadatos: puede filtrar junto con metadatos en la consulta")
Qdrant: código abierto de nivel de producción
Qdrant es una base de datos vectorial escrita en Rust, con buen rendimiento y funciones completas.
Ejemplo
# Demostración de uso básico de Qdrant
# ============================================
# Instalación: pip install qdrant-client
# Iniciar el servicio: docker run -p 6333:6333 qdrant/qdrant
def qdrant_example():
"""Ejemplo de uso de Qdrant"""
from qdrant_client import QdrantClient
from qdrant_client.models import Distance, VectorParams, PointStruct, Filter, FieldCondition, MatchValue
# 1. Conectar el cliente
client = QdrantClient(host="localhost", port=6333)
# 2. Crear una colección
client.recreate_collection(
collection_name="ejemplo_collection",
vectors_config=VectorParams(
size=128,
distance=Distance.COSINE # o L2, DOT
),
# Opcional: configurar parámetros del índice HNSW
# hnsw_config=HnswConfig(m=16, ef_construct=100)
)
# 3. Agregar puntos
import numpy as np
np.random.seed(42)
points = [
PointStruct(
id=i,
vector=np.random.randn(128).tolist(),
payload={
"text": f"Contenido del documento {i}",
"category": "tech" if i % 2 == 0 else "life",
"author": f"author_{i % 3}"
}
)
for i in range(100)
]
client.upsert(
collection_name="ejemplo_collection",
points=points
)
# 4. Consulta
query_vector = np.random.randn(128).tolist()
results = client.search(
collection_name="ejemplo_collection",
query_vector=query_vector,
limit=5,
# Se puede agregar filtrado
# query_filter=Filter(
# must=[
# FieldCondition(key="category", match=MatchValue(value="tech"))
# ]
# )
)
print("Resultados de la consulta:")
for result in results:
print(f"ID: {result.id}, puntuación: {result.score:.4f}")
print(f"Payload: {result.payload}")
print("---")
return client
# Si Qdrant está iniciado, puede descomentar las líneas siguientes para ejecutar
# qdrant_example()
print("Código de ejemplo de Qdrant: implementación en Rust, funciones completas.")
print()
print("Características de Qdrant:")
print(" - Buen rendimiento: Rust + HNSW")
print(" - Funciones completas: admite filtrado, agrupación, agregación y paginación")
print(" - Fácil implementación: inicio con un clic con Docker")
print(" - Admite fragmentación: puede escalar horizontalmente")
Tabla comparativa de bases de datos vectoriales principales
| Producto | Tipo | Implementación | Características | Escenarios aplicables |
|---|---|---|---|---|
| FAISS | Biblioteca local | Ninguno | Muy rápido, funciones completas, requiere mantenimiento propio | Procesamiento offline, no querer montar un servicio |
| Chroma | Ligero | Local/Servidor | Sencillo y fácil de usar, prioridad Python | Desarrollo de prototipos, proyectos pequeños |
| Qdrant | Código abierto | Docker/K8s | Buen rendimiento, funciones completas, Rust | Entornos de producción, mediana escala |
| Milvus | Código abierto | Distribuido | Nivel empresarial, las funciones más completas | Entornos de producción a gran escala |
| Weaviate | Código abierto | Docker/K8s | Modular, buen ecosistema | Necesidad de combinar funciones de forma flexible |
| Pinecone | Servicio en la nube | SaaS | Totalmente gestionado, escalado bajo demanda | Sin necesidad de operar, lanzamiento rápido |
Selección de modelos de embedding
La base de datos vectorial es solo la infraestructura; lo que realmente determina el resultado es el modelo de embedding.
Comparación de modelos de embedding principales
| Modelo | Dimensión | Características | Precio |
|---|---|---|---|
| OpenAI text-embedding-3-small | 1536 | Alta relación precio-rendimiento, buena calidad general | $0.00002 / 1K tokens |
| OpenAI text-embedding-3-large | 3072 | Calidad máxima, dimensión grande | $0.00013 / 1K tokens |
| Cohere Embed v3 | 1024 | Buen soporte multilingüe | $0.0001 / 1K tokens |
| bge-large-zh-v1.5 | 1024 | Buen resultado en chino, código abierto y gratuito | Gratuito |
| bge-m3 | 1024 | Multilingüe, multifuncional | Gratuito |
| gte-large | 1024 | Opción equilibrada, código abierto | Gratuito |
Compensación entre dimensiones y rendimiento
Cuanto mayor sea la dimensión, generalmente mejor será el resultado, pero:
-
1. Almacenamiento más caro: 3072 dimensiones ocupan el doble de espacio que 1536.
-
2. Cálculo más lento: la cantidad de cálculo de distancia es proporcional a la dimensión.
-
3. Índice más grande: los índices HNSW/IVF también serán más grandes.
Recomendación:Primero prueba con un modelo de dimensiones pequeñas; si no es suficiente, usa dimensiones más grandes.En la mayoría de los casos, 1536 dimensiones ya son suficientes.
Búsqueda híbrida (Hybrid Search)
La búsqueda puramente vectorial a veces no es suficiente, porque solo coincide con la "semántica", no con las "palabras clave".
Búsqueda híbrida = búsqueda vectorial + búsqueda por palabras clave, y luego se fusionan los resultados.
Búsqueda dispersa BM25
BM25 es un algoritmo clásico de la búsqueda tradicional que mide el grado de coincidencia de palabras clave.
Ejemplo
# Demostración de búsqueda por palabras clave BM25
# ============================================
import math
from typing import List, Dict, Set
class SimpleBM25:
"""Implementación simplificada de BM25"""
def __init__(self, k1: float = 1.5, b: float = 0.75):
self.k1 = k1
self.b = b
self.documents: List[List[str]] = []
self.doc_lengths: List[int] = []
self.avg_doc_length: float = 0
self.term_freqs: List[Dict[str, int]] = []
self.doc_freq: Dict[str, int] = {}
self.num_docs: int = 0
def _tokenize(self, text: str) -> List[str]:
"""Tokenización simple (por espacios y puntuación)"""
# Simplificación: convertir a minúsculas, dividir por caracteres no alfanuméricos
import re
return [t.lower() for t in re.findall(r'\w+', text)]
def fit(self, documents: List[str]):
"""Construcción del índice"""
self.documents = []
self.doc_lengths = []
self.term_freqs = []
self.doc_freq = {}
self.num_docs = len(documents)
for doc in documents:
tokens = self._tokenize(doc)
self.documents.append(tokens)
self.doc_lengths.append(len(tokens))
# Contar frecuencia de términos
tf: Dict[str, int] = {}
for token in tokens:
tf[token] = tf.get(token, 0) + 1
self.term_freqs.append(tf)
# Actualizar frecuencia de documentos
for token in tf.keys():
self.doc_freq[token] = self.doc_freq.get(token, 0) + 1
self.avg_doc_length = sum(self.doc_lengths) / self.num_docs
def score(self, query: str) -> List[float]:
"""Calcular la puntuación BM25 de cada documento"""
query_tokens = self._tokenize(query)
scores = [0.0] * self.num_docs
for token in query_tokens:
if token not in self.doc_freq:
continue
# Cálculo de IDF
df = self.doc_freq[token]
idf = math.log(1 + (self.num_docs - df + 0.5) / (df + 0.5))
# Calcular la puntuación para cada documento
for doc_idx in range(self.num_docs):
doc_len = self.doc_lengths[doc_idx]
tf = self.term_freqs[doc_idx].get(token, 0)
# Fórmula central de BM25
numerator = tf * (self.k1 + 1)
denominator = tf + self.k1 * (1 - self.b + self.b * doc_len / self.avg_doc_length)
scores[doc_idx] += idf * numerator / denominator
return scores
def search(self, query: str, top_k: int = 5) -> List[Dict]:
"""Búsqueda Top K"""
scores = self.score(query)
# Ordenar
results = [
{"doc_idx": i, "score": s}
for i, s in enumerate(scores)
]
results.sort(key=lambda x: x["score"], reverse=True)
return results[:top_k]
# Prueba
documents = [
"Python es un lenguaje de programación, fácil de aprender.",
"JavaScript se usa para desarrollo web, se puede usar tanto en frontend como en backend.",
"Las bases de datos vectoriales se usan para almacenar y recuperar embeddings vectoriales.",
"Existen muchos tipos de bases de datos, por ejemplo, bases de datos relacionales, bases de datos NoSQL.",
"HNSW es un algoritmo de búsqueda aproximada del vecino más cercano."
]
bm25 = SimpleBM25()
bm25.fit(documents)
# Buscar
query = "base de datos"
results = bm25.search(query, top_k=5)
print(f"Consulta:\"{query}\"")
print("Resultados de búsqueda BM25:")
for r in results:
print(f" Documento {r['doc_idx']}: {documents[r['doc_idx']]}")
print(f" Puntuación = {r['score']:.4f}")
# La salida es similar a:
# Consulta: "base de datos"
# Resultados de búsqueda BM25:
# Documento 2: Las bases de datos vectoriales se usan para almacenar y recuperar embeddings vectoriales.
# Puntuación = 0.7134
# Documento 3: Existen muchos tipos de bases de datos, por ejemplo, bases de datos relacionales, bases de datos NoSQL.
# Puntuación = 0.6148
# ...
RRF: fusión de rango recíproco
RRF (Reciprocal Rank Fusion) es un método simple y eficaz para fusionar múltiples resultados de búsqueda.
Fórmula: score = 1 / (k + rank), donde k normalmente es 60.
Ejemplo
# Demostración de fusión RRF
# ============================================
from typing import List, Dict, Any
def rrf_fuse(
result_lists: List[List[Any]],
k: int = 60
) -> Dict[Any, float]:
"""
Fusión RRF: para cada lista de resultados, usar 1/(k + rank) para puntuar y sumar
result_lists: múltiples listas de resultados ordenadas
"""
scores: Dict[Any, float] = {}
for results in result_lists:
for rank, item in enumerate(results):
score = 1.0 / (k + rank)
scores[item] = scores.get(item, 0) + score
return scores
# Ejemplo: resultados de búsqueda vectorial y resultados de búsqueda BM25
vector_results = ["doc3", "doc1", "doc4", "doc2", "doc5"] # La búsqueda vectorial considera doc3 el más relevante
bm25_results = ["doc2", "doc4", "doc3", "doc5", "doc1"] # BM25 considera doc2 el más relevante
# Fusión RRF
fused = rrf_fuse([vector_results, bm25_results])
# Ordenar
final_rank = sorted(fused.items(), key=lambda x: x[1], reverse=True)
print("Resultados de búsqueda vectorial:", vector_results)
print("Resultados de búsqueda BM25:", bm25_results)
print()
print("Ranking final después de la fusión RRF:")
for doc, score in final_rank:
print(f" {doc}: {score:.6f}")
# Salida:
# Resultados de búsqueda vectorial: ['doc3', 'doc1', 'doc4', 'doc2', 'doc5']
# Resultados de búsqueda BM25: ['doc2', 'doc4', 'doc3', 'doc5', 'doc1']
#
# Ranking final después de la fusión RRF:
# doc3: 0.032787
# doc2: 0.032787
# doc4: 0.032520
# doc1: 0.016393
# doc5: 0.016393
Ajuste de pesos de fusión
Además de RRF, también se puede usar fusión lineal ponderada:
final_score = α * vector_score + (1 - α) * bm25_score
α es el peso de la búsqueda vectorial, hay que ajustarlo según los datos reales.
Re-ranking (reordenamiento)
La búsqueda híbrida se puede mejorar aún más: primero recuperar un lote de candidatos y luego reordenar con un modelo más potente.
Principio de Cross-Encoder
Bi-Encoder (para recuperación): codifica por separado query y document, y compara con similitud.
Cross-Encoder (para reordenamiento): concatena query y document y los introduce en el modelo, que genera directamente una puntuación de relevancia.
Cross-Encoder es más preciso, pero más lento, por lo que es adecuado para reordenar solo los primeros 50-100 candidatos.
Ejemplo
# Demostración del flujo de re-ranking
# ============================================
def reranking_pipeline_example():
"""
Flujo de recuperación en dos etapas:
1. Recuperación gruesa: usar búsqueda vectorial para encontrar rápidamente Top 100
2. Ordenación fina: usar Cross-Encoder para reordenar los Top 100
"""
print("Flujo de recuperación en dos etapas:")
print()
print("Etapa 1: Recuperación gruesa (búsqueda vectorial)")
print(" - Objetivo: rápido, baja latencia")
print(" - Método: búsqueda vectorial HNSW/IVF")
print(" - Salida: Top 100 candidatos")
print()
print("Etapa 2: Ordenación fina (Cross-Encoder)")
print(" - Objetivo: preciso, alta calidad")
print(" - Método: puntuación por pares con Cross-Encoder")
print(" - Salida: Top 10 final")
print()
print("Configuración típica:")
print(" - Etapa de recuperación: HNSW efSearch = 128, recuperar 100")
print(" - Etapa de reordenamiento: usar bge-reranker o Cohere Rerank")
print()
print("¿Por qué no usar directamente Cross-Encoder para buscar en todo?")
print(" - Cross-Encoder es demasiado lento, no es realista buscar en 1 millón de documentos")
print(" - La búsqueda vectorial en 1 millón es rápida, y Cross-Encoder reordenar 100 también es rápido")
# Ejemplo de API de Cohere Rerank (pseudocódigo)
def cohere_rerank_example():
"""
Ejemplo de uso de la API de Cohere Rerank
"""
print("Uso típico de la API de Cohere Rerank:")
print()
print('''
import cohere
co = cohere.Client(api_key="your-api-key")
query = "¿Qué es una base de datos vectorial?"
documents = [
"Contenido del documento 1...",
"Contenido del documento 2...",
... # primeros 100 candidatos
]
results = co.rerank(
query=query,
documents=documents,
top_n=10,
model="rerank-english-v3.0"
)
for r in results:
print(r.index, r.relevance_score, documents[r.index])
''')
reranking_pipeline_example()
Compensación entre rendimiento y latencia
| Solución | Calidad | Velocidad | Costo | Escenario adecuado |
|---|---|---|---|---|
| Búsqueda puramente vectorial | Medio | Muy rápida | bajo | Para requisitos extremadamente altos de velocidad |
| Búsqueda híbrida | Media-alta | Rápido | Medio | Elección equilibrada |
| Vector + reordenamiento | Alto | Medio | Media-alta | Buscando calidad |
| Híbrido + reordenamiento | La más alta | Media-lenta | Alto | Prioridad a la calidad |
Optimización en entornos de producción
Del demo a producción, hay muchos detalles a tener en cuenta.
Estrategia de particionamiento de índices
Cuando el volumen de datos supera la capacidad de una sola máquina, es necesario fragmentar:
-
1. Fragmentación por ID: simple, pero al consultar hay que buscar en todos los fragmentos.
-
2. Fragmentación por agrupamiento de vectores: al consultar solo se buscan los fragmentos relevantes.
Filtrado de metadatos
En producción, casi siempre es necesario combinar el filtrado por metadatos.
Dos estrategias:
-
1. Prefiltrado: primero filtrar por metadatos y luego hacer la búsqueda vectorial.
-
2. Postfiltrado: primero hacer la búsqueda vectorial y luego filtrar por metadatos.
Principio de selección: si quedan muchos vectores después del filtrado, usar prefiltrado; si quedan pocos, usar postfiltrado.
Actualización incremental
La mayoría de las bases de datos vectoriales admiten agregación incremental, pero hay que tener en cuenta:
-
1. Agregación por lotes: agregar un lote a la vez, no uno por uno.
-
2. Reconstrucción de índices: algunos índices (como IVF) necesitan reentrenamiento periódico.
-
3. Gestión de versiones: conservar versiones antiguas del índice para poder revertir al actualizar.
Métricas de monitoreo
En producción se debe monitorear:
-
1. Latencia de consulta:P50、P95、P99。
-
2. Tasa de recuperación (Recall): revisar periódicamente la calidad de los resultados Top K.
-
3. Tamaño del índice: uso de memoria/disco.
-
4. QPS: consultas por segundo.