Base de données vectorielle
À l'ère de l'IA, la forme des données que nous traitons a subi des changements fondamentaux.
Les bases de données traditionnelles stockent des données structurées : nombres, chaînes de caractères, dates.
Les applications d'IA traitent la sémantique : le sens d'un texte, le contenu d'une image, le sens d'un extrait audio. Ces informations sémantiques sont représentées sous forme de vecteurs—une séquence de nombres à virgule flottante, par ex. [0.123, -0.456, 0.789, ...].
Une base de données vectorielle est une base de données spécialement conçue pour stocker, indexer et interroger ces vecteurs. Sans elle, le RAG (génération augmentée par récupération) ne peut pas fonctionner, la recherche sémantique ne peut pas être mise en œuvre et les systèmes de recommandation ne peuvent pas fonctionner efficacement.
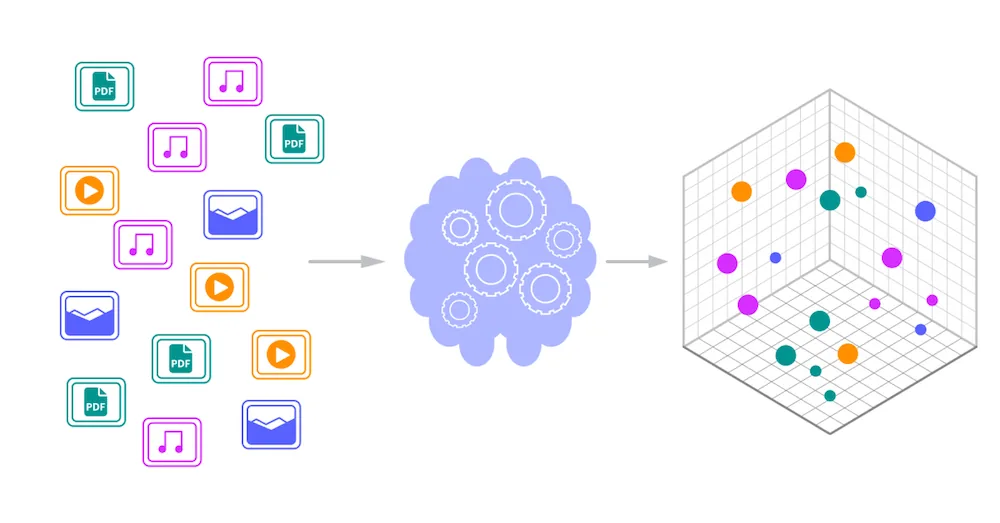
Valeur essentielle des bases de données vectorielles :Trouver les K résultats les plus similaires à un vecteur de requête en quelques millisecondes parmi des millions, voire des milliards, de vecteurs.。
Défis de la recherche de similarité vectorielle
Ce n'est qu'en comprenant la nature du problème que l'on peut comprendre pourquoi des algorithmes spécialisés sont nécessaires.
Problème de complexité de la recherche par force brute
L'approche la plus simple est la recherche par force brute : calculer la similarité entre le vecteur de requête et chaque vecteur de la base de données, trier, puis prendre les K meilleurs.
Exemple
# Démo de recherche par force brute : simple mais inefficace
# ============================================
import numpy as np
from typing import List, Tuple
def l2_distance(v1: np.ndarray, v2: np.ndarray) -> float:
"""Calcule la distance euclidienne L2 : plus elle est petite, plus les éléments sont similaires."""
return np.sqrt(np.sum((v1 - v2) ** 2))
def brute_force_search(
query: np.ndarray,
vectors: List[np.ndarray],
top_k: int = 5
) -> List[Tuple[int, float]]:
"""
Recherche par force brute : calculer les distances à tous les vecteurs, trier et renvoyer le Top K
Avantages : simple et précis, 100 % de rappel
Inconvénients : extrêmement lent avec de gros volumes de données
"""
# Calculer la distance à chaque vecteur
distances = []
for idx, vec in enumerate(vectors):
dist = l2_distance(query, vec)
distances.append((idx, dist))
# Trier par distance, prendre les K premiers
distances.sort(key=lambda x: x[1])
return distances[:top_k]
# Générer 10,000 vecteurs aléatoires 128-dimensionnels (simulation d'une base de données vectorielle)
np.random.seed(42)
vector_count = 10000
dimension = 128
vectors = [np.random.randn(dimension) for _ in range(vector_count)]
# Générer un vecteur de requête
query_vector = np.random.randn(dimension)
# Exécuter une recherche par force brute
print(f"Recherche des 5 meilleurs parmi {vector_count} vecteurs...")
results = brute_force_search(query_vector, vectors, top_k=5)
print("Résultats de la recherche :")
for idx, dist in results:
print(f" Vecteur {idx:4d}, distance = {dist:.4f}")
# La sortie ressemble à :
# Recherche des 5 meilleurs parmi 10,000 vecteurs...
# Résultats de la recherche :
# Vector 8236, distance = 13.3986
# Vector 8946, distance = 13.5604
# Vector 9891, distance = 13.5688
# Vector 5172, distance = 13.5987
# Vector 5223, distance = 13.6081
Le problème de la recherche par force brute est évident : chaque requête doit parcourir tous les vecteurs.
S'il y a 1 million de vecteurs, chaque requête nécessite de calculer 1 million de distances.
S'il y a 1 milliard de vecteurs, chaque requête nécessite 1 milliard de calculs—c'est totalement inacceptable en production.
La « malédiction de la dimensionnalité » dans les espaces de grande dimension
Pour ne rien arranger, les vecteurs sont généralement de grande dimension.
text-embedding-3-small d'OpenAI a 1536 dimensions, et large a 3072 dimensions.
Dans les espaces de grande dimension, les méthodes traditionnelles d'indexation spatiale (comme KD-Tree) connaissent une forte baisse d'efficacité, parfois même au point d'être plus lentes que la recherche par force brute.
| Taille des données | Temps de recherche par force brute (estimé) | Acceptable ? |
|---|---|---|
| 10 mille | ~1 milliseconde | Acceptable |
| 1 million | ~100 millisecondes | Un peu lent |
| 10 millions | ~1 seconde | Trop lent |
| 100 millions | ~10 secondes | Complètement inacceptable |
| 1 milliard | ~100 secondes | Inutilisable |
C'est pourquoi nous avons besoin desalgorithmes de recherche approximative des plus proches voisins (ANN): sacrifier 100% de précision pour une accélération de 100x voire 1000x.
Algorithmes de recherche approximative des plus proches voisins (ANN)
L'idée centrale des algorithmes ANN :Construire une structure d'index pour que les requêtes n'aient pas besoin de parcourir tous les vecteurs。
Il existe trois algorithmes principaux : HNSW, IVF et PQ.
HNSW : graphe hiérarchique navigable de petit monde
HNSW (graphe hiérarchique navigable de petit monde) est l'un des algorithmes les plus populaires aujourd'hui. Il s'inspire de la théorie des six degrés de séparation—deux personnes dans le monde peuvent être reliées par au plus 6 intermédiaires.
HNSW utilise un graphe de petit monde clairsemé multicouche. Il effectue rapidement une localisation grossière à partir des nœuds clairsemés de la couche supérieure, puis descend couche par couche jusqu'à la couche inférieure contenant toutes les données pour une recherche fine. En utilisant des sauts hiérarchiques, il réduit considérablement le nombre de calculs de distance, ce qui permet une recherche approximative des plus proches voisins rapide et à haut rappel.
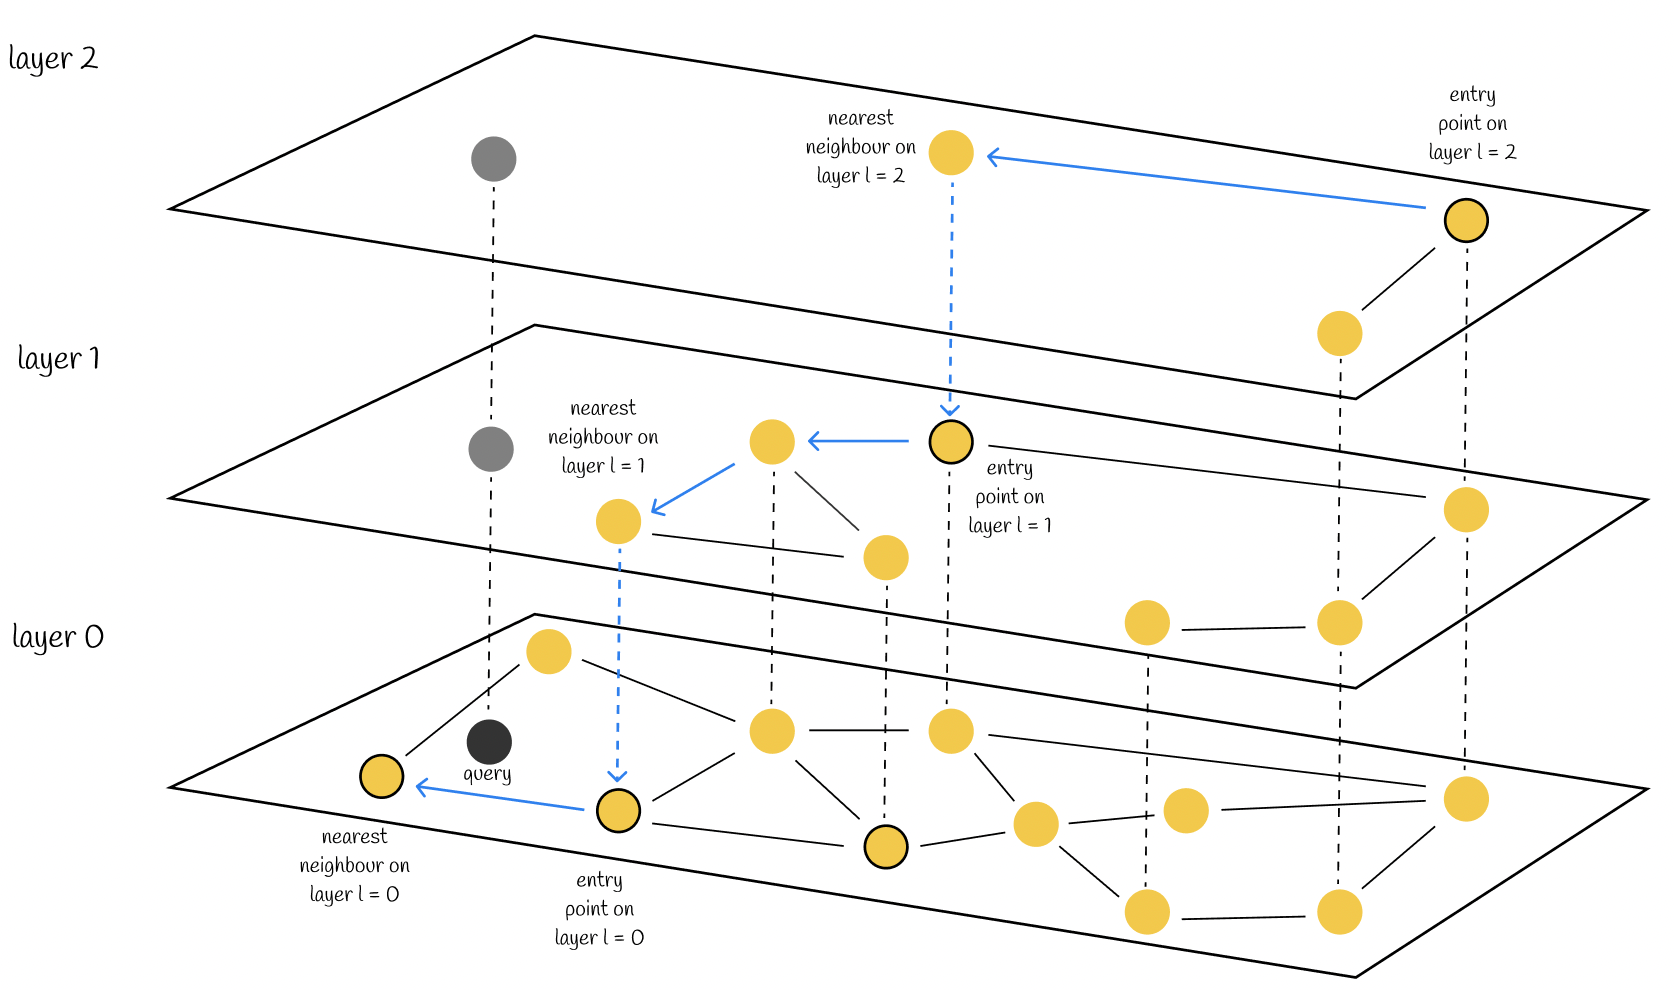
Structure hiérarchique :La couche inférieure, la couche 0, stocke tous les vecteurs ; plus la couche est élevée, moins il y a de nœuds, ce qui agit comme une voie rapide. Le même vecteur est lié verticalement entre les couches par des lignes en pointillés.
Processus de recherche (chemin en ligne bleue) :
- La recherche grossière commence à l'entrée de la couche supérieure, et trouve le point le plus proche du vecteur de requête dans cette couche.
- Descendre verticalement jusqu'à la couche intermédiaire et localiser grossièrement à nouveau.
- Redescendre à la couche 0, la couche de données complètes, pour un parcours affiné, et retourner le voisin le plus proche.
Principe fondamental :Les couches supérieures réduisent rapidement la portée de recherche, tandis que la couche inférieure fournit une correspondance précise. Il optimise la recherche exhaustive en complexité logarithmique, offrant une grande vitesse et un haut rappel, ce qui en fait un algorithme de recherche vectorielle courant.
Exemple
# Démo simplifiée des principes HNSW (pas une implémentation de production)
# ============================================
import numpy as np
import random
from typing import List, Dict, Set, Tuple
class SimpleHNSW:
"""HNSW simplifié, uniquement pour démontrer les principes"""
def __init__(self, dim: int, max_level: int = 3, ef_construction: int = 5):
self.dim = dim
self.max_level = max_level # Nombre maximum de couches
self.ef_construction = ef_construction # Nombre de candidats considérés lors de la construction du graphe
self.levels: List[Dict[int, np.ndarray]] = [{} for _ in range(max_level)]
self.edges: List[Dict[int, Set[int]]] = [{} for _ in range(max_level)]
self.next_id = 0
self.enter_point = None # Point d'entrée (un point à la couche supérieure)
def _random_level(self) -> int:
"""Sélectionner aléatoirement un niveau : plus le niveau est élevé, plus la probabilité est faible"""
level = 0
while random.random() < 0.5 and level < self.max_level - 1:
level += 1
return level
def _distance(self, v1: np.ndarray, v2: np.ndarray) -> float:
"""distance L2"""
return np.sqrt(np.sum((v1 - v2) ** 2))
def _search_layer(
self,
query: np.ndarray,
level: int,
entry: int,
ef: int
) -> List[Tuple[float, int]]:
"""Rechercher dans une couche : en partant de l'entrée, trouver gloutonnement les ef points les plus proches"""
if entry not in self.levels[level]:
return []
visited = set([entry])
candidates = [(self._distance(query, self.levels[level][entry]), entry)]
result = list(candidates)
while candidates:
# Retirer le candidat le plus proche actuel
candidates.sort()
dist, current = candidates.pop(0)
# Parcourir les voisins
if current not in self.edges[level]:
continue
for neighbor in self.edges[level][current]:
if neighbor in visited:
continue
visited.add(neighbor)
neighbor_dist = self._distance(query, self.levels[level][neighbor])
# Ajouter aux candidats et à l'ensemble de résultats
candidates.append((neighbor_dist, neighbor))
result.append((neighbor_dist, neighbor))
# Garder la taille de l'ensemble de résultats inférieure ou égale à ef
result.sort()
result = result[:ef]
return result
def add(self, vector: np.ndarray) -> int:
"""Ajouter un vecteur"""
vec_id = self.next_id
self.next_id += 1
# Déterminer aléatoirement dans quelles couches ce vecteur apparaît
max_level_for_vec = self._random_level()
# Stocker le vecteur dans toutes les couches (dans les implémentations réelles, le vecteur complet n'est généralement stocké que dans la couche inférieure)
for level in range(max_level_for_vec + 1):
self.levels[level][vec_id] = vector
self.edges[level][vec_id] = set()
# S'il s'agit du premier point, le définir comme point d'entrée
if self.enter_point is None:
self.enter_point = vec_id
return vec_id
# Rechercher depuis la couche supérieure vers le bas pour trouver la position d'insertion dans chaque couche
current_entry = self.enter_point
# D'abord rechercher dans les couches au-dessus de max_level_for_vec, en mettant à jour l'entrée
for level in range(self.max_level - 1, max_level_for_vec, -1):
if current_entry in self.levels[level]:
layer_result = self._search_layer(vector, level, current_entry, 1)
if layer_result:
current_entry = layer_result[0][1]
# Dans les couches jusqu'à max_level_for_vec, établir des connexions
for level in range(max_level_for_vec, -1, -1):
# Rechercher les points ef_construction les plus proches dans cette couche
layer_result = self._search_layer(vector, level, current_entry, self.ef_construction)
# Se connecter à ces points (simplifié : connexion bidirectionnelle)
for dist, neighbor_id in layer_result:
self.edges[level][vec_id].add(neighbor_id)
self.edges[level][neighbor_id].add(vec_id)
# Mettre à jour l'entrée pour la couche suivante
if layer_result:
current_entry = layer_result[0][1]
# Mettre à jour l'entrée de la couche supérieure
if max_level_for_vec > self._random_level(): # Vérification simplifiée
self.enter_point = vec_id
return vec_id
def search(self, query: np.ndarray, top_k: int = 5, ef: int = 10) -> List[Tuple[int, float]]:
"""Rechercher les K plus proches voisins"""
if self.enter_point is None:
return []
current_entry = self.enter_point
# Du niveau supérieur jusqu'au premier niveau
for level in range(self.max_level - 1, 0, -1):
if current_entry in self.levels[level]:
layer_result = self._search_layer(query, level, current_entry, 1)
if layer_result:
current_entry = layer_result[0][1]
# Rechercher les ef points au niveau inférieur, puis renvoyer Top K
layer_result = self._search_layer(query, 0, level, ef)
layer_result.sort()
return [(vec_id, dist) for dist, vec_id in layer_result[:top_k]]
# Test
np.random.seed(42)
dim = 128
hnsw = SimpleHNSW(dim=dim, max_level=3, ef_construction=5)
# Ajouter 100 vecteurs
print("Construction de l'index HNSW (ajout de 100 vecteurs)...")
for i in range(100):
vec = np.random.randn(dim)
hnsw.add(vec)
print(f"Construction de l'index terminée, point d'entrée = {hnsw.enter_point}")
# Générer le vecteur de requête
query = np.random.randn(dim)
# Recherche
print("\nExécution de la recherche HNSW...")
results = hnsw.search(query, top_k=5, ef=10)
print("Résultats de la recherche :")
for vec_id, dist in results:
print(f" Vecteur {vec_id:3d}, distance = {dist:.4f}")
# Sortie similaire à :
# Construction de l'index HNSW (ajout de 100 vecteurs)...
# Construction de l'index terminée, point d'entrée = 54
#
# Exécution de la recherche HNSW...
# Résultats de la recherche :
# Vector 86, distance = 13.7515
# Vector 30, distance = 13.8651
# Vector 28, distance = 14.0754
# Vector 56, distance = 14.1106
# Vector 34, distance = 14.2131
Avantages de HNSW :
1. Requête rapide: Généralement, seuls quelques nœuds doivent être visités pour trouver le voisin le plus proche.
-
2. Construction rapide: Les vecteurs peuvent être ajoutés de manière incrémentielle sans reconstruire tout l'index.
-
3. Paramètres simples: Ajustez principalement ef_construction (qualité du graphe) et ef (qualité de la recherche).
IVF : index de fichier inversé
L'idée de l'IVF (fichier inversé) est « diviser pour régner ».
Étapes:
-
1. Clustering: Diviser l'espace vectoriel en K « compartiments » (en utilisant le clustering K-Means).
-
2. Indexation: Chaque vecteur est affecté à son compartiment le plus proche.
-
3. Requête: Trouver d'abord les N compartiments les plus proches du vecteur de requête, puis effectuer la recherche uniquement dans ces N compartiments.
Exemple
# Démonstration simplifiée du principe IVF
# ============================================
import numpy as np
from typing import List, Tuple
class SimpleIVF:
"""IVF simplifié, uniquement pour démontrer le principe"""
def __init__(self, dim: int, nlist: int = 10):
self.dim = dim
self.nlist = nlist # Nombre de centres de cluster (nombre de compartiments)
self.centroids: np.ndarray = None # Centres de cluster
self.inverted_lists: List[List[Tuple[int, np.ndarray]]] = [[] for _ in range(nlist)]
self.next_id = 0
def _l2_distance(self, v1: np.ndarray, v2: np.ndarray) -> float:
"""distance L2"""
return np.sqrt(np.sum((v1 - v2) ** 2))
def _find_nearest_centroid(self, vector: np.ndarray) -> int:
"""Trouver le centre de cluster le plus proche"""
distances = [self._l2_distance(vector, c) for c in self.centroids]
return int(np.argmin(distances))
def fit(self, vectors: List[np.ndarray]):
"""Initialiser les centres de clusters avec K-Means (simplifié : sélection aléatoire)"""
# Simplifié : sélectionner aléatoirement nlist vecteurs comme centres initiaux
# Dans l'implémentation réelle, l'itération K-Means devrait être utilisée
indices = np.random.choice(len(vectors), self.nlist, replace=False)
self.centroids = np.array([vectors[i] for i in indices])
def add(self, vector: np.ndarray) -> int:
"""Ajouter un vecteur"""
vec_id = self.next_id
self.next_id += 1
# Trouver le compartiment le plus proche
centroid_idx = self._find_nearest_centroid(vector)
# Le placer dans ce compartiment
self.inverted_lists[centroid_idx].append((vec_id, vector))
return vec_id
def search(self, query: np.ndarray, top_k: int = 5, nprobe: int = 3) -> List[Tuple[int, float]]:
"""
Rechercher Top K
nprobe: combien de compartiments rechercher (plus il y en a, plus c'est précis, mais plus c'est lent)
"""
# Trouver les compartiments nprobe les plus proches
centroid_distances = [
(self._l2_distance(query, c), i)
for i, c in enumerate(self.centroids)
]
centroid_distances.sort()
nearest_centroids = [i for dist, i in centroid_distances[:nprobe]]
# Rechercher uniquement dans ces compartiments nprobe
candidates = []
for centroid_idx in nearest_centroids:
for vec_id, vec in self.inverted_lists[centroid_idx]:
dist = self._l2_distance(query, vec)
candidates.append((dist, vec_id))
# Trier et renvoyer le top K
candidates.sort()
return [(vec_id, dist) for dist, vec_id in candidates[:top_k]]
# Test
np.random.seed(42)
dim = 128
# Générer 1000 vecteurs
vectors = [np.random.randn(dim) for _ in range(1000)]
# Construire l'index IVF
ivf = SimpleIVF(dim=dim, nlist=20)
ivf.fit(vectors)
# Ajouter des vecteurs
for vec in vectors:
ivf.add(vec)
print(f"Construction de l'index IVF terminée, nombre de compartiments = {ivf.nlist}")
for i in range(ivf.nlist):
print(f" Compartiment {i:2d} : {len(ivf.inverted_lists[i])} vecteurs")
# Requête
query = np.random.randn(dim)
print("\nExécution de la recherche IVF (nprobe=3)...")
results = ivf.search(query, top_k=5, nprobe=3)
print("Résultats de la recherche :")
for vec_id, dist in results:
print(f" Vecteur {vec_id:3d}, distance = {dist:.4f}")
# Sortie similaire à :
# Construction de l'index IVF terminée, nombre de compartiments = 20
# Compartiment 0 : 63 vecteurs
# Compartiment 1 : 56 vecteurs
# ...
#
# Exécution de la recherche IVF (nprobe=3)...
# Résultats de la recherche :
# Vecteur 863, distance = 13.5409
# Vecteur 189, distance = 13.7083
# Vecteur 491, distance = 13.8628
# Vecteur 264, distance = 13.9812
# Vecteur 781, distance = 14.0021
L'avantage d'IVF est sa faible empreinte mémoire, et vous pouvez ajuster dynamiquement le paramètre nprobe au moment de la requête pour équilibrer vitesse et précision.
PQ : quantification produit
PQ (quantification produit) est un algorithme de compression.
Idée principale :
-
1. Découpage: Diviser le vecteur de grande dimension en plusieurs segments plus petits (sous-vecteurs).
-
2. Quantification: Regrouper chaque petit segment indépendamment, et remplacer le vecteur d'origine par l'ID du centre de cluster.
-
3. Recherche: Au moment de la requête, utiliser une table de recherche pour calculer rapidement des distances approximatives.
Par exemple, un vecteur de 128 dimensions est divisé en 8 segments de 16 dimensions chacun, et chaque segment est quantifié avec 256 centres. Par conséquent, chaque vecteur ne nécessite que 8 octets de stockage (à l'origine 128 * 4 = 512 octets).
Combinaison IVF-PQ
Dans les environnements de production, IVF et PQ sont généralement combinés :
IVF est responsable du « partitionnement » pour réduire l'étendue de la recherche, et PQ est responsable de la « compression » pour réduire la mémoire et le calcul.
| Algorithme | Vitesse | Précision | Mémoire | Scénarios applicables |
|---|---|---|---|---|
| Recherche exhaustive | Lent | 100% | Élevée | Petite taille de données, nécessite une précision de 100% |
| HNSW | Extrêmement rapide | Élevée | Moyenne | Intensif en requêtes, nécessite une faible latence |
| IVF | Rapide | Moyenne | Faible | Données à grande échelle, légère perte de précision acceptable |
| IVF-PQ | Très rapide | Moyenne | Extrêmement faible | Données à très grande échelle, mémoire limitée |
Métriques de similarité
Il existe de nombreuses façons de calculer la "similarité", et choisir la bonne métrique est important.
Similarité cosinus
La similarité cosinus mesure l'angle entre les directions de deux vecteurs, avec un intervalle de [-1, 1].
Plus la valeur est proche de 1, plus ils sont similaires ; plus elle est proche de -1, plus ils sont opposés.
Exemple
# Calcul de la similarité cosinus
# ============================================
import numpy as np
def cosine_similarity(v1: np.ndarray, v2: np.ndarray) -> float:
"""
Similarité cosinus = (v1 · v2) / (|v1| * |v2|)
Intervalle [-1, 1], plus la valeur est proche de 1, plus c'est similaire
"""
dot_product = np.dot(v1, v2)
norm1 = np.linalg.norm(v1)
norm2 = np.linalg.norm(v2)
return dot_product / (norm1 * norm2)
# Test
np.random.seed(42)
v1 = np.array([1, 2, 3, 4, 5])
v2 = np.array([2, 4, 6, 8, 10]) # Même direction
v3 = np.array([-1, -2, -3, -4, -5]) # Direction opposée
v4 = np.random.randn(5) # Aléatoire
print(f"v1 = {v1}")
print(f"v2 = {v2}")
print(f"v3 = {v3}")
print(f"v4 = {v4}")
print()
print(f"cosine(v1, v2) = {cosine_similarity(v1, v2):.4f} (même direction, devrait être 1.0)")
print(f"cosine(v1, v3) = {cosine_similarity(v1, v3):.4f} (direction opposée, devrait être -1.0)")
print(f"cosine(v1, v4) = {cosine_similarity(v1, v4):.4f}")
# Sortie :
# v1 = [1 2 3 4 5]
# v2 = [ 2 4 6 8 10]
# v3 = [-1 -2 -3 -4 -5]
# v4 = [ 0.4967 -0.1383 0.6477 1.5230 -0.2342]
#
# cosine(v1, v2) = 1.0000 (même direction, devrait être 1.0)
# cosine(v1, v3) = -1.0000 (direction opposée, devrait être -1.0)
# cosine(v1, v4) = 0.2143
La caractéristique de la similarité cosinus : elle ne se soucie pas de la longueur du vecteur, seulement de la direction. C'est courant dans les embeddings de texte, car la « sémantique » du texte n'a aucun rapport avec la longueur.
Distance euclidienne L2
La distance L2 est la distance en ligne droite entre deux points dans l'espace ; plus elle est petite, plus ils sont similaires.
Produit interne (produit scalaire)
Produit interne = v1 · v2. Si les vecteurs sont normalisés, le produit interne est égal à la similarité cosinus.
Guide de sélection
| Métrique | Plage de valeurs | Quand choisir | Cas d'utilisation typiques |
|---|---|---|---|
| Similarité cosinus | [-1, 1] | Ne se soucie que de la direction, pas de la longueur | Plongements de texte, recherche sémantique |
| Distance L2 | [0, ∞) | La position spatiale compte | Caractéristiques d'image, systèmes de recommandation |
| Produit scalaire | (-∞, ∞) | Les vecteurs sont normalisés, ou la longueur est significative | Certains modèles d'embedding spécifiques |
La plupart des modèles d'embedding (par exemple, la série text-embedding d'OpenAI) produisent des vecteurs normalisés ; dans ce cassimilarité cosinus = produit scalaire, donc peu importe lequel vous utilisez.
Comparaison des bases de données vectorielles les plus courantes
Les bases de données vectorielles se répartissent en trois catégories : les bibliothèques locales (FAISS), les solutions open source légères (Chroma, Qdrant) et les solutions de niveau entreprise (Milvus, Pinecone, Weaviate).
FAISS : une bibliothèque locale de Facebook
FAISS n'est pas une base de données complète, mais une bibliothèque C++ (avec des liaisons Python).
Exemple
# Démonstration d'utilisation de base de FAISS
# ============================================
import numpy as np
# Remarque : vous devez d'abord installer FAISS pour l'exécuter
# pip install faiss-cpu (version CPU)
# ou
# pip install faiss-gpu (version GPU)
# Ci-dessous un exemple typique d'utilisation de FAISS (exemple de code, non réellement exécuté)
def faiss_example():
"""Exemple d'utilisation de FAISS"""
# 1. Préparer les données
dimension = 128
nb = 10000 # Nombre de vecteurs de la base de données
nq = 10 # Nombre de vecteurs de requête
np.random.seed(42)
xb = np.random.random((nb, dimension)).astype('float32') # Base de données
xq = np.random.random((nq, dimension)).astype('float32') # Requête
# 2. Créer un index (exemple IVF)
import faiss
nlist = 100 # Nombre de centres de clusters
quantizer = faiss.IndexFlatL2(dimension) # Quantificateur
index = faiss.IndexIVFFlat(quantizer, dimension, nlist, faiss.METRIC_L2)
# 3. Entraîner l'index
index.train(xb)
# 4. Ajouter des vecteurs
index.add(xb)
# 5. Définir nprobe pour la recherche
index.nprobe = 10
# 6. Rechercher le Top 5
k = 5
distances, indices = index.search(xq, k)
print("Résultats des requêtes (Top 5 pour les 2 premières requêtes) :")
for i in range(min(2, nq)):
print(f"Requête {i} :")
for j in range(k):
print(f" Index {indices[i][j]}, distance {distances[i][j]:.4f}")
return index
# Exemple d'index HNSW
def faiss_hnsw_example():
"""Index HNSW FAISS"""
import faiss
dimension = 128
index = faiss.IndexHNSWFlat(dimension, 32) # 32 = paramètre M (nombre de connexions par nœud)
index.hnsw.efConstruction = 40 # ef pendant la construction du graphe
index.hnsw.efSearch = 16 # ef pendant la recherche
# Ajouter des données...
# index.add(xb)
return index
# Si FAISS est installé, vous pouvez décommenter les lignes ci-dessous pour exécuter
# faiss_example()
print("Exemple de code FAISS : Ceci est une utilisation typique de FAISS.")
print("Étapes clés : créer l'index → entraîner → ajouter des vecteurs → rechercher.")
print()
print("Types d'index FAISS courants :")
print(" - IndexFlatL2 : recherche par force brute (précise mais lente)")
print(" - IndexIVFFlat : recherche IVF par compartiments")
print(" - IndexIVFPQ : IVF + compression PQ")
print(" - IndexHNSWFlat : index de graphe HNSW")
Fonctionnalités de FAISS :
-
1. Extrêmement rapide: implémentation C++, optimisée à l'extrême.
-
2. Riche en fonctionnalités: prend en charge presque tous les principaux algorithmes ANN.
-
3. Local: pas de réseau, pas de persistance (vous devez sauvegarder vous-même le fichier d'index).
Scénarios applicables : traitement par lots hors ligne, ne pas vouloir mettre en place un service, volume de données relativement faible.
Chroma : léger et local-first
Chroma est une base de données vectorielle simple et facile à utiliser, conçue pour "rendre le développement d'applications d'IA plus rapide."
Exemple
# Démonstration d'utilisation de base de Chroma
# ============================================
# Installation : pip install chromadb
def chroma_example():
"""Exemple d'utilisation de Chroma"""
import chromadb
from chromadb.utils import embedding_functions
# 1. Initialiser le client (mode local, données enregistrées sur disque)
client = chromadb.PersistentClient(path="./example-chroma-db")
# 2. Créer ou obtenir une collection
collection = client.get_or_create_collection(
name="example_docs",
metadata={"description": "Exemple de collection de documents de tutoriel"}
)
# 3. Ajouter des documents (Chroma gère automatiquement l'embedding)
# Vous pouvez utiliser OpenAI, Cohere, etc., ou fournir vos propres vecteurs
documents = [
"Python est un langage de programmation interprété, de haut niveau et polyvalent.",
"JavaScript est un langage de programmation léger et interprété.",
"Les bases de données vectorielles sont utilisées pour stocker et récupérer des embeddings vectoriels.",
"RAG, ou génération augmentée par récupération, est une technique qui combine la récupération avec la génération.",
"HNSW est un algorithme de plus proches voisins approximatif basé sur un graphe hiérarchique de type petit monde."
]
metadatas = [
{"catégorie": "programmation", "langage": "Python"},
{"catégorie": "programmation", "langage": "JavaScript"},
{"catégorie": "base de données", "sujet": "vecteur"},
{"catégorie": "ia", "sujet": "rag"},
{"catégorie": "algorithme", "sujet": "hnsw"}
]
ids = ["doc1", "doc2", "doc3", "doc4", "doc5"]
# Ajouter (en utilisant ici des vecteurs factices ; en pratique, utilisez un modèle d'embedding)
import numpy as np
np.random.seed(42)
embeddings = [np.random.randn(128).tolist() for _ in range(5)]
collection.add(
documents=documents,
metadatas=metadatas,
ids=ids,
embeddings=embeddings # Si elle n'est pas fournie, Chroma utilise la fonction d'embedding par défaut
)
print(f"Il y a {collection.count()} documents dans la collection")
# 4. Requête
query_embedding = np.random.randn(128).tolist()
results = collection.query(
query_embeddings=[query_embedding],
n_results=3,
# Le filtrage des métadonnées peut être ajouté
# where={"category": "ai"}
)
print("\nRésultats de la requête :")
for i in range(len(results['ids'][0])):
print(f"ID: {results['ids'][0][i]}")
print(f"Document: {results['documents'])
print(f"Distance : {results['distances'])
print("---")
return collection
# Si Chroma est installé, vous pouvez décommenter les lignes ci-dessous pour exécuter
# chroma_example()
print("Exemple de code Chroma : conception simple, fonctionne immédiatement.")
print()
print("Fonctionnalités de Chroma :")
print(" - Simple : API conviviale, prise en main en quelques minutes")
print(" - Local-first : peut persister sur disque ou s'exécuter en mémoire")
print(" - Embeddings intégrés : prend en charge OpenAI, Cohere, Sentence-Transformers")
print(" - Prend en charge le filtrage des métadonnées : peut filtrer par métadonnées lors des requêtes")
Qdrant : Open Source de niveau production
Qdrant est une base de données vectorielle écrite en Rust, avec de bonnes performances et des fonctionnalités complètes.
Exemple
# Démo d'utilisation de base de Qdrant
# ============================================
# Installation : pip install qdrant-client
# Démarrer le service : docker run -p 6333:6333 qdrant/qdrant
def qdrant_example():
"""Exemple d'utilisation de Qdrant"""
from qdrant_client import QdrantClient
from qdrant_client.models import Distance, VectorParams, PointStruct, Filter, FieldCondition, MatchValue
# 1. Connecter le client
client = QdrantClient(host="localhost", port=6333)
# 2. Créer la collection
client.recreate_collection(
collection_name="example_collection",
vectors_config=VectorParams(
size=128,
distance=Distance.COSINE # ou L2, DOT
),
# Optionnel : configurer les paramètres de l'index HNSW
# hnsw_config=HnswConfig(m=16, ef_construct=100)
)
# 3. Ajouter des points
import numpy as np
np.random.seed(42)
points = [
PointStruct(
id=i,
vector=np.random.randn(128).tolist(),
payload={
"text": f"Contenu du document {i}",
"category": "tech" if i % 2 == 0 else "life",
"author": f"author_{i % 3}"
}
)
for i in range(100)
]
client.upsert(
collection_name="example_collection",
points=points
)
# 4. Requête
query_vector = np.random.randn(128).tolist()
results = client.search(
collection_name="example_collection",
query_vector=query_vector,
limit=5,
# Le filtrage peut être ajouté
# query_filter=Filter(
# must=[
# FieldCondition(key="category", match=MatchValue(value="tech"))
# ]
# )
)
print("Résultats de la requête :")
for result in results:
print(f"ID : {result.id}, Score : {result.score:.4f}")
print(f"Charge utile : {result.payload}")
print("---")
return client
# Si Qdrant est en cours d'exécution, vous pouvez décommenter les lignes ci-dessous pour exécuter
# qdrant_example()
print("Exemple de code Qdrant : implémentation Rust, fonctionnalités complètes.")
print()
print("Fonctionnalités de Qdrant :")
print(" - Bonnes performances : Rust + HNSW")
print(" - Fonctionnalités complètes : prend en charge le filtrage, le regroupement, l'agrégation, la pagination")
print(" - Déploiement facile : démarrage en un clic avec Docker")
print(" - Prend en charge le sharding : peut évoluer horizontalement")
Tableau comparatif des bases de données vectorielles courantes
| Produit | Type | Déploiement | Fonctionnalités | Cas d'utilisation |
|---|---|---|---|---|
| FAISS | Bibliothèque locale | Aucune | Extrêmement rapide, complet en fonctionnalités, nécessite une maintenance autonome | Traitement hors ligne, vous ne voulez pas mettre en place un service |
| Chroma | Léger | Local/Serveur | Simple et facile à utiliser, priorité à Python | Prototypage, petits projets |
| Qdrant | Open source | Docker/K8s | Bonnes performances, fonctionnalités complètes, Rust | Environnement de production, échelle moyenne |
| Milvus | Open source | Distribué | De niveau entreprise, fonctionnalités les plus complètes | Environnement de production à grande échelle |
| Weaviate | Open source | Docker/K8s | Modulaire, bon écosystème | Besoin d'une composition flexible des fonctionnalités |
| Pinecone | Service cloud | SaaS | Entièrement géré, mise à l'échelle à la demande | Pas d'exploitation à gérer, lancement rapide |
Sélection du modèle d'embedding
Les bases de données vectorielles ne sont que de l'infrastructure ; ce qui détermine vraiment les résultats, c'est le modèle d'embedding.
Comparaison des principaux modèles d'embedding
| Modèle | Dimensions | Fonctionnalités | Prix |
|---|---|---|---|
| OpenAI text-embedding-3-small | 1536 | Rapport coût-performance élevé, bonne qualité globale | $0.00002 / 1K tokens |
| OpenAI text-embedding-3-large | 3072 | Qualité maximale, dimensions élevées | $0.00013 / 1K tokens |
| Cohere Embed v3 | 1024 | Bon support multilingue | $0.0001 / 1K tokens |
| bge-large-zh-v1.5 | 1024 | Adapté au chinois, open source et gratuit | Gratuit |
| bge-m3 | 1024 | Multilingue, multifonctionnel | Gratuit |
| gte-large | 1024 | Choix équilibré, open source | Gratuit |
Compromis entre dimensions et performances
Plus les dimensions sont élevées, meilleurs sont généralement les résultats, mais :
-
1. Le stockage est plus coûteux: 3072 dimensions occupent deux fois plus d'espace que 1536 dimensions.
-
2. Le calcul est plus lent: Le coût du calcul de distance est proportionnel à la dimensionnalité.
-
3. Index plus grand: Les index HNSW/IVF seront également plus grands.
Recommandation :Testez d'abord avec un modèle de faible dimension ; si cela ne suffit pas, passez à une dimension supérieure.. Dans la plupart des scénarios, 1536 dimensions suffisent déjà.
Recherche hybride
La recherche vectorielle pure n'est parfois pas suffisante, car elle ne correspond qu'à la "sémantique", pas aux "mots-clés".
Recherche hybride = recherche vectorielle + recherche par mots-clés, puis fusionner les résultats.
Récupération creuse BM25
BM25 est un algorithme classique de la recherche traditionnelle, qui mesure le degré de correspondance des mots-clés.
Exemple
# Démo de recherche par mots-clés BM25
# ============================================
import math
from typing import List, Dict, Set
class SimpleBM25:
"""Implémentation simplifiée de BM25"""
def __init__(self, k1: float = 1.5, b: float = 0.75):
self.k1 = k1
self.b = b
self.documents: List[List[str]] = []
self.doc_lengths: List[int] = []
self.avg_doc_length: float = 0
self.term_freqs: List[Dict[str, int]] = []
self.doc_freq: Dict[str, int] = {}
self.num_docs: int = 0
def _tokenize(self, text: str) -> List[str]:
"""Tokenisation simple (par espaces et ponctuation)"""
# Simplifié : convertir en minuscules, séparer par des caractères non alphanumériques
import re
return [t.lower() for t in re.findall(r'\w+', text)]
def fit(self, documents: List[str]):
"""Construire l'index"""
self.documents = []
self.doc_lengths = []
self.term_freqs = []
self.doc_freq = {}
self.num_docs = len⟦⟧documents(documents)
for doc in documents:
tokens = self._tokenize(doc)
self.documents.append(tokens)
self.doc_lengths.append(len(tokens))
# Compter la fréquence des termes
tf: Dict[str, int] = {}
for token in tokens:
tf[token] = tf.get(token, 0) + 1
self.term_freqs.append(tf)
# Mettre à jour la fréquence des documents
for token in tf.keys():
self.doc_freq[token] = self.doc_freq.get(token, 0) + 1
self.avg_doc_length = sum(self.doc_lengths) / self.num_docs
def score(self, query: str) -> List[float]:
"""Calculer le score BM25 pour chaque document"""
query_tokens = self._tokenize(query)
scores = [0.0] * self.num_docs
for token in query_tokens:
if token not in self.doc_freq:
continue
# Calcul de l'IDF
df = self.doc_freq[token]
idf = math.log(1 + (self.num_docs - df + 0.5) / (df + 0.5))
# Calculer le score pour chaque document
for doc_idx in range(self.num_docs):
doc_len = self.doc_lengths[doc_idx]
tf = self.term_freqs[doc_idx].get(token, 0)
# Formule de base BM25
numerator = tf * (self.k1 + 1)
denominator = tf + self.k1 * (1 - self.b + self.b * doc_len / self.avg_doc_length)
scores[doc_idx] += idf * numerator / denominator
return scores
def search(self, query: str, top_k: int = 5) -> List[Dict]:
"""Rechercher Top K"""
scores = self.score(query)
# Trier
results = [
{"doc_idx": i, "score": s}
for i, s in enumerate(scores)
]
results.sort(key=lambda x: x["score"], reverse=True)
return results[:top_k]
# Test
documents = [
"Python est un langage de programmation, facile à apprendre.",
"JavaScript est utilisé pour le développement web, utilisable à la fois sur le frontend et le backend.",
"Les bases de données vectorielles sont utilisées pour stocker et récupérer des embeddings vectoriels.",
"Il existe de nombreux types de bases de données, comme les bases de données relationnelles et les bases de données NoSQL.",
"HNSW est un algorithme de recherche approximative des plus proches voisins."
]
bm25 = SimpleBM25()
bm25.fit(documents)
# Recherche
query = "database"
results = bm25.search(query, top_k=5)
print(f"Requête :\"{query}"\"")
print("Résultats de recherche BM25 :")
for r in results:
print(f" Document {r['doc_idx']}: {documents[r['doc_idx']]}")
print(f" Score = {r['score']:.4f}")
# Sortie similaire à :
# Requête : "database"
# Résultats de recherche BM25 :
# Document 2 : Les bases de données vectorielles sont utilisées pour stocker et récupérer des plongements vectoriels.
# Score = 0.7134
# Document 3 : Il existe de nombreux types de bases de données, comme les bases de données relationnelles et les bases de données NoSQL.
# Score = 0.6148
# ...
RRF : fusion des rangs réciproques
RRF (fusion des rangs réciproques) est une méthode simple et efficace pour fusionner plusieurs résultats de recherche.
Formule : score = 1 / (k + rank), où k vaut généralement 60.
Exemple
# Démo de fusion RRF
# ============================================
from typing import List, Dict, Any
def rrf_fuse(
result_lists: List[List[Any]],
k: int = 60
) -> Dict[Any, float]:
"""
Fusion RRF : pour chaque liste de résultats, ajouter les scores en utilisant 1/(k + rank)
result_lists: plusieurs listes de résultats triées
"""
scores: Dict[Any, float] = {}
for results in result_lists:
for rank, item in enumerate(results):
score = 1.0 / (k + rank)
scores[item] = scores.get(item, 0) + score
return scores
# Exemple : résultats de recherche vectorielle et résultats de recherche BM25
vector_results = ["doc3", "doc1", "doc4", "doc2", "doc5"] # La recherche vectorielle considère doc3 comme le plus pertinent
bm25_results = ["doc2", "doc4", "doc3", "doc5", "doc1"] # BM25 considère doc2 comme le plus pertinent
# Fusion RRF
fused = rrf_fuse([vector_results, bm25_results])
# Trier
final_rank = sorted(fused.items(), key=lambda x: x[1], reverse=True)
print("Résultats de la recherche vectorielle :", vector_results)
print("Résultats de la recherche BM25 :", bm25_results)
print()
print("Classement final après fusion RRF :")
for doc, score in final_rank:
print(f" {doc}: {score:.6f}")
# Sortie :
# Résultats de recherche vectorielle : ['doc3', 'doc1', 'doc4', 'doc2', 'doc5']
# Résultats de recherche BM25 : ['doc2', 'doc4', 'doc3', 'doc5', 'doc1']
#
# Classement final après fusion RRF :
# doc3: 0.032787
# doc2: 0.032787
# doc4: 0.032520
# doc1: 0.016393
# doc5: 0.016393
Réglage des poids de fusion
En plus de RRF, on peut également utiliser une fusion linéaire pondérée :
final_score = α * vector_score + (1 - α) * bm25_score
α est le poids pour la recherche vectorielle, qui doit être ajusté en fonction des données réelles.
Réordonnancement
La recherche hybride peut être encore améliorée : d'abord récupérer un lot de candidats, puis reclasser avec un modèle plus puissant.
Principes du Cross-Encoder
Bi-Encoder (pour la récupération) : encoder la requête et le document séparément, puis comparer par similarité.
Cross-Encoder (pour le reranking) : concaténer la requête et le document comme entrée du modèle, puis produire directement un score de pertinence.
Cross-Encoder est plus précis mais plus lent, il est donc adapté pour reranker uniquement les 50 à 100 meilleurs candidats.
Exemple
# Démo du processus de reranking
# ============================================
def reranking_pipeline_example():
"""
Processus de récupération en deux étapes :
1. Récupération grossière : utiliser la recherche vectorielle pour trouver rapidement le Top 100
2. Classement fin : utiliser Cross-Encoder pour reranker le Top 100
"""
print("Processus de récupération en deux étapes :")
print()
print("Étape 1 : récupération grossière (recherche vectorielle)")
print(" - Objectif : rapide, faible latence")
print(" - Méthode : recherche vectorielle HNSW/IVF")
print(" - Sortie : Top 100 candidats")
print()
print("Étape 2 : classement fin (Cross-Encoder)")
print(" - Objectif : précis, haute qualité")
print(" - Méthode : scoring par paires Cross-Encoder")
print(" - Sortie : Top 10 final")
print()
print("Configuration typique :")
print(" - Étape de récupération : HNSW efSearch = 128, rappel 100")
print(" - Étape de reclassement : utiliser bge-reranker ou Cohere Rerank")
print()
print("Pourquoi ne pas utiliser directement un Cross-Encoder pour tout rechercher ?")
print(" - Le Cross-Encoder est trop lent ; rechercher 1 million de documents n'est pas réaliste")
print(" - La recherche vectorielle sur 1 million est rapide, et le reclassement par Cross-Encoder sur 100 est également rapide")
# Exemple d'utilisation de l'API Cohere Rerank (pseudo-code)
def cohere_rerank_example():
"""
Exemple d'utilisation de l'API Cohere Rerank
"""
print("Utilisation typique de l'API Cohere Rerank :")
print()
print('''
import cohere
co = cohere.Client(api_key="votre-clé-api")
query = "Qu'est-ce qu'une base de données vectorielle ?"
documents = [
"Contenu du document 1...",
"Contenu du document 2...",
... # 100 meilleurs candidats
]
results = co.rerank(
query=query,
documents=documents,
top_n=10,
model="rerank-english-v3.0"
)
for r in results:
print(r.index, r.relevance_score, documents[r.index])
''')
reranking_pipeline_example()
Compromis entre performance et latence
| Approche | Qualité | Vitesse | Coût | Scénario d'application |
|---|---|---|---|---|
| Recherche vectorielle pure | Moyenne | Extrêmement rapide | Faible | Pour des exigences de vitesse extrêmement élevées |
| Recherche hybride | Moyenne-élevée | Rapide | Moyenne | Choix équilibré |
| Vecteur + réordonnancement | Élevée | Moyenne | Moyenne-élevée | Recherche de la qualité |
| Hybride + réordonnancement | Maximale | Moyen-lent | Élevée | Qualité avant tout |
Optimisation de l'environnement de production
De la démo à la production, il y a de nombreux détails à prendre en compte.
Stratégies de sharding d'index
Lorsque le volume de données dépasse la capacité d'une seule machine, le partitionnement est nécessaire :
-
1. Partitionner par ID: simple, mais les requêtes doivent rechercher dans toutes les partitions.
-
2. Partitionner par clustering vectoriel: ne rechercher que quelques partitions pertinentes lors des requêtes.
Filtrage des métadonnées
Dans les environnements de production, le filtrage des métadonnées est presque toujours combiné.
Deux stratégies :
-
1. Pré-filtrage: filtrer d'abord par métadonnées, puis effectuer une recherche vectorielle.
-
2. Post-filtrage: effectuer d'abord une recherche vectorielle, puis filtrer par métadonnées.
Principe de sélection : si de nombreux vecteurs restent après filtrage, utiliser le pré-filtrage ; si peu restent, utiliser le post-filtrage.
Mises à jour incrémentielles
La plupart des bases de données vectorielles prennent en charge l'ajout incrémentiel, mais il faut noter :
-
1. Ajout par lots: ajoutez par lots, pas un par un.
-
2. Reconstruction d'index: Certains index (par ex., IVF) nécessitent un réentraînement périodique.
-
3. Gestion des versions: Conservez les anciennes versions d'index afin de pouvoir revenir en arrière lors des mises à jour.
Métriques de surveillance
Les environnements de production doivent surveiller :
-
1. Latence des requêtes:P50、P95、P99。
-
2. Taux de rappel: Vérifiez régulièrement la qualité des résultats Top K.
-
3. Taille de l'index: Utilisation de la mémoire/du disque.
-
4. QPSRequêtes par seconde.