Векторная база данных
В эпоху ИИ форма данных, которые мы обрабатываем, претерпела фундаментальные изменения.
Традиционные базы данных хранят структурированные данные: числа, строки, даты.
ИИ-приложения обрабатывают семантику: смысл фрагмента текста, содержание изображения, смысл голосового фрагмента. Эта семантическая информация представлена в виде векторов — последовательности чисел с плавающей точкой, например, [0.123, -0.456, 0.789, ...].
Векторная база данных — это база данных, специально предназначенная для хранения, индексирования и запросов к этим векторам. Без неё RAG (Retrieval-Augmented Generation) не может работать, семантический поиск невозможно реализовать, а рекомендательные системы не могут эффективно функционировать.
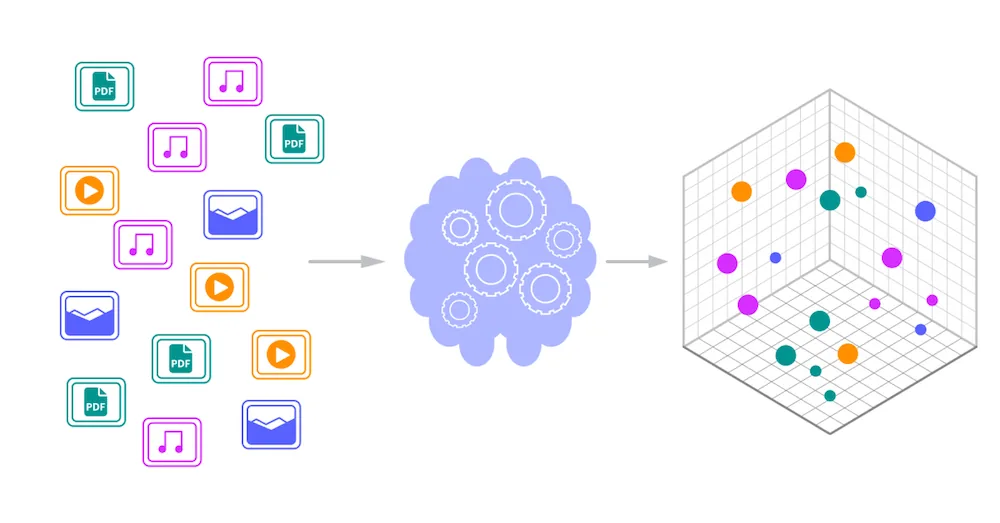
Ключевая ценность векторных баз данных:Находить top K результатов, наиболее похожих на вектор запроса, за миллисекунды среди миллионов или даже миллиардов векторов.。
Сложности векторного поиска сходства
Только понимая природу проблемы, можно понять, почему необходимы специализированные алгоритмы.
Проблема сложности полного перебора
Простейший подход — полный перебор: вычислить сходство между вектором запроса и каждым вектором в базе данных, отсортировать и взять top K.
Пример
# Демонстрация поиска полным перебором: просто, но неэффективно
# ============================================
import numpy as np
from typing import List, Tuple
def l2_distance(v1: np.ndarray, v2: np.ndarray) -> float:
"""Вычисляет евклидово расстояние L2: чем меньше, тем выше сходство."""
return np.sqrt(np.sum((v1 - v2) ** 2))
def brute_force_search(
query: np.ndarray,
vectors: List[np.ndarray],
top_k: int = 5
) -> List[Tuple[int, float]]:
"""
Поиск полным перебором: вычислить расстояния до всех векторов, отсортировать и вернуть Top K
Преимущества: простота и точность, 100% полнота
Недостатки: крайне медленно при больших объёмах данных
"""
# Вычислить расстояние до каждого вектора
distances = []
for idx, vec in enumerate(vectors):
dist = l2_distance(query, vec)
distances.append((idx, dist))
# Отсортировать по расстоянию, взять K лучших
distances.sort(key=lambda x: x[1])
return distances[:top_k]
# Сгенерировать 10,000 случайных 128-мерных векторов (имитация векторной базы данных)
np.random.seed(42)
vector_count = 10000
dimension = 128
vectors = [np.random.randn(dimension) for _ in range(vector_count)]
# Сгенерировать вектор запроса
query_vector = np.random.randn(dimension)
# Выполнить поиск полным перебором
print(f"Поиск топ-5 среди {vector_count} векторов...")
results = brute_force_search(query_vector, vectors, top_k=5)
print("Результаты поиска:")
for idx, dist in results:
print(f" Вектор {idx:4d}, расстояние = {dist:.4f}")
# Вывод выглядит так:
# Поиск топ-5 среди 10,000 векторов...
# Результаты поиска:
# Вектор 8236, расстояние = 13.3986
# Вектор 8946, расстояние = 13.5604
# Вектор 9891, расстояние = 13.5688
# Вектор 5172, расстояние = 13.5987
# Вектор 5223, расстояние = 13.6081
Проблема полного перебора очевидна: каждый запрос должен пройти через все векторы.
Если имеется 1 миллион векторов, каждый запрос требует вычисления 1 миллиона расстояний.
Если имеется 1 миллиард векторов, каждый запрос требует 1 миллиарда вычислений — это совершенно неприемлемо в продакшене.
«Проклятие размерности» в высокоразмерном пространстве
Что ещё хуже, векторы обычно высокоразмерны.
text-embedding-3-small от OpenAI имеет размерность 1536, а large — 3072.
В высокоразмерных пространствах традиционные методы пространственной индексации (например, KD-Tree) испытывают резкое падение эффективности, иногда даже работают медленнее полного перебора.
| Размер данных | Время поиска полным перебором (оценка) | Приемлемо? |
|---|---|---|
| 10 тысяч | ~1 миллисекунда | Приемлемо |
| 1 миллион | ~100 миллисекунд | Немного медленно |
| 10 миллионов | ~1 секунда | Слишком медленно |
| 100 миллионов | ~10 секунд | Совершенно неприемлемо |
| 1 миллиард | ~100 секунд | Непригодно |
Вот почему нам нужныалгоритмы приближённого поиска ближайших соседей (ANN): жертвуя 100% точностью ради 100x или даже 1000x ускорения.
Алгоритмы приближённого поиска ближайших соседей (ANN)
Основная идея алгоритмов ANN:Построить индексную структуру так, чтобы запросам не нужно было перебирать все векторы。
Существуют три основных алгоритма: HNSW, IVF и PQ.
HNSW: иерархический навигируемый граф малого мира
HNSW (Hierarchical Navigable Small World) — один из самых популярных алгоритмов на сегодня. Он вдохновлён теорией шести рукопожатий — любые два человека в мире могут быть связаны не более чем через 6 посредников.
HNSW использует многослойный разреженный граф малого мира. Он быстро выполняет грубую локализацию по разреженным узлам верхнего слоя, затем слой за слоем спускается к нижнему слою с полными данными для точного поиска. Благодаря иерархическим переходам он значительно сокращает количество вычислений расстояний, обеспечивая быстрый приближённый поиск ближайших соседей с высокой полнотой.
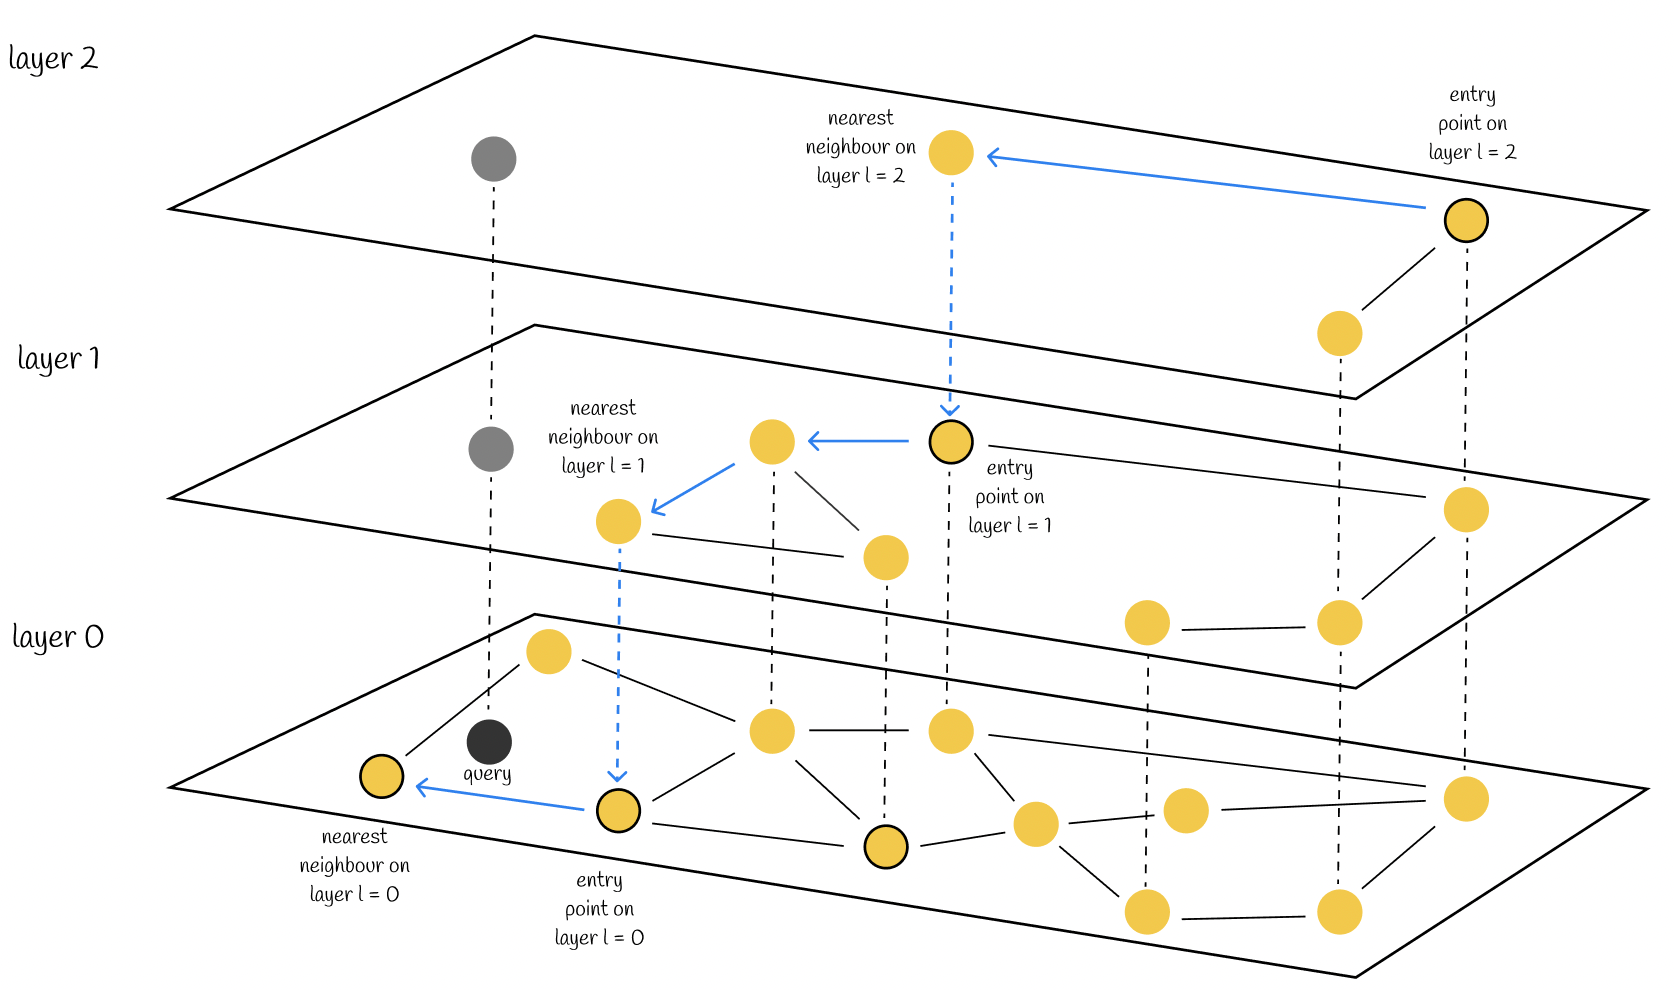
Иерархическая структура:Нижний слой, Слой 0, хранит все векторы; чем выше слой, тем меньше узлов, что служит быстрым маршрутом. Один и тот же вектор вертикально связан между слоями пунктирными линиями.
Процесс поиска (путь синей линии):
- Грубый поиск начинается с точки входа верхнего слоя и находит точку, ближайшую к вектору запроса в этом слое.
- Вертикально спускаемся к среднему слою и снова выполняем грубую локализацию.
- Спускаемся на Слой 0, слой полных данных, для точного обхода и выводим ближайшего соседа.
Основной принцип:Верхние слои быстро сужают область поиска, а нижний слой обеспечивает точное сопоставление. Это оптимизирует поиск полным перебором до логарифмической сложности, обеспечивая высокую скорость и высокую полноту, что делает его широко распространённым алгоритмом векторного поиска.
Пример
# Упрощённая демонстрация принципов HNSW (не реализация для продакшена)
# ============================================
import numpy as np
import random
from typing import List, Dict, Set, Tuple
class SimpleHNSW:
"""Упрощённый HNSW, только для демонстрации принципов"""
def __init__(self, dim: int, max_level: int = 3, ef_construction: int = 5):
self.dim = dim
self.max_level = max_level # Максимальное количество слоёв
self.ef_construction = ef_construction # Количество кандидатов, рассматриваемых при построении графа
self.levels: List[Dict[int, np.ndarray]] = [{} for _ in range(max_level)]
self.edges: List[Dict[int, Set[int]]] = [{} for _ in range(max_level)]
self.next_id = 0
self.enter_point = None # Точка входа (точка на верхнем слое)
def _random_level(self) -> int:
"""Случайно выбрать уровень: чем выше уровень, тем ниже вероятность"""
level = 0
while random.random() < 0.5 and level < self.max_level - 1:
level += 1
return level
def _distance(self, v1: np.ndarray, v2: np.ndarray) -> float:
"""расстояние L2"""
return np.sqrt(np.sum((v1 - v2) ** 2))
def _search_layer(
self,
query: np.ndarray,
level: int,
entry: int,
ef: int
) -> List[Tuple[float, int]]:
"""Поиск в слое: начиная с entry, жадно найти ef ближайших точек"""
if entry not in self.levels[level]:
return []
visited = set([entry])
candidates = [(self._distance(query, self.levels[level][entry]), entry)]
result = list(candidates)
while candidates:
# Извлечь текущего ближайшего кандидата
candidates.sort()
dist, current = candidates.pop(0)
# Обойти соседей
if current not in self.edges[level]:
continue
for neighbor in self.edges[level][current]:
if neighbor in visited:
continue
visited.add(neighbor)
neighbor_dist = self._distance(query, self.levels[level][neighbor])
# Добавить в candidates и набор результатов
candidates.append((neighbor_dist, neighbor))
result.append((neighbor_dist, neighbor))
# Поддерживать размер набора результатов не больше ef
result.sort()
result = result[:ef]
return result
def add(self, vector: np.ndarray) -> int:
"""Добавить вектор"""
vec_id = self.next_id
self.next_id += 1
# Случайным образом определить, в каких слоях появляется этот вектор
max_level_for_vec = self._random_level()
# Сохранить вектор во всех слоях (в реальных реализациях полный вектор обычно хранится только на нижнем слое)
for level in range(max_level_for_vec + 1):
self.levels[level][vec_id] = vector
self.edges[level][vec_id] = set()
# Если это первая точка, установить её как точку входа
if self.enter_point is None:
self.enter_point = vec_id
return vec_id
# Поиск от верхнего слоя вниз для определения позиции вставки в каждом слое
current_entry = self.enter_point
# Сначала поиск в слоях выше max_level_for_vec, обновляя entry
for level in range(self.max_level - 1, max_level_for_vec, -1):
if current_entry in self.levels[level]:
layer_result = self._search_layer(vector, level, current_entry, 1)
if layer_result:
current_entry = layer_result[0][1]
# В слоях до max_level_for_vec установить соединения
for level in range(max_level_for_vec, -1, -1):
# Поиск ближайших точек ef_construction в этом слое
layer_result = self._search_layer(vector, level, current_entry, self.ef_construction)
# Подключиться к этим точкам (упрощённо: двунаправленное соединение)
for dist, neighbor_id in layer_result:
self.edges[level][vec_id].add(neighbor_id)
self.edges[level][neighbor_id].add(vec_id)
# Обновить запись для следующего слоя
if layer_result:
current_entry = layer_result[0][1]
# Обновить запись верхнего слоя
if max_level_for_vec > self._random_level(): # Упрощённая проверка
self.enter_point = vec_id
return vec_id
def search(self, query: np.ndarray, top_k: int = 5, ef: int = 10) -> List[Tuple[int, float]]:
"""Поиск Top K ближайших соседей"""
if self.enter_point is None:
return []
current_entry = self.enter_point
# От верхнего уровня вниз до первого уровня
for level in range(self.max_level - 1, 0, -1):
if current_entry in self.levels[level]:
layer_result = self._search_layer(query, level, current_entry, 1)
if layer_result:
current_entry = layer_result[0][1]
# Поиск ef точек на нижнем уровне, затем вернуть Top K
layer_result = self._search_layer(query, 0, current_entry, ef)
layer_result.sort()
return [(vec_id, dist) for dist, vec_id in layer_result[:top_k]]
#
np.random.seed(42)
dim = 128
hnsw = SimpleHNSW(dim=dim, max_level=3, ef_construction=5)
# Добавить 100 векторов
print("Создание индекса HNSW (добавление 100 векторов)...")
for i in range(100):
vec = np.random.randn(dim)
hnsw.add(vec)
print(f"Построение индекса завершено, точка входа = {hnsw.enter_point}")
# Сгенерировать вектор запроса
query = np.random.randn(dim)
# Поиск
print("\nВыполняется поиск HNSW...")
results = hnsw.search(query, top_k=5, ef=10)
print("Результаты поиска:")
for vec_id, dist in results:
print(f" Вектор {vec_id:3d}, расстояние = {dist:.4f}")
# Вывод примерно такой:
# Построение индекса HNSW (добавление 100 векторов)...
# Построение индекса завершено, точка входа = 54
#
# Выполнение поиска HNSW...
# Результаты поиска:
# Вектор 86, расстояние = 13.7515
# Вектор 30, расстояние = 13.8651
# Вектор 28, расстояние = 14.0754
# Вектор 56, расстояние = 14.1106
# Вектор 34, расстояние = 14.2131
Преимущества HNSW:
1. Быстрый запрос: Обычно нужно посетить всего несколько узлов, чтобы найти ближайшего соседа.
-
2. Быстрое построение: Векторы можно добавлять постепенно, без перестроения всего индекса.
-
3. Простые параметры: В основном настраивайте ef_construction (качество графа) и ef (качество поиска).
IVF: Инвертированный файловый индекс
Идея IVF (инвертированного файла) заключается в "разделяй и властвуй".
Шаги:
-
1. Кластеризация: Разделите векторное пространство на K "корзин" (используя кластеризацию K-Means).
-
2. Индексирование: Каждый вектор назначается ближайшей корзине.
-
3. Запрос: Сначала найдите N корзин, ближайших к вектору запроса, затем ищите только в этих N корзинах.
Пример
# Упрощённая демонстрация принципа IVF
# ============================================
import numpy as np
from typing import List, Tuple
class SimpleIVF:
"""Упрощённый IVF, только для демонстрации принципа"""
def __init__(self, dim: int, nlist: int = 10):
self.dim = dim
self.nlist = nlist # Количество центров кластеров (количество корзин)
self.centroids: np.ndarray = None # Центры кластеров
self.inverted_lists: List[List[Tuple[int, np.ndarray]]] = [[] for _ in range(nlist)]
self.next_id = 0
def _l2_distance(self, v1: np.ndarray, v2: np.ndarray) -> float:
"""расстояние L2"""
return np.sqrt(np.sum((v1 - v2) ** 2))
def _find_nearest_centroid(self, vector: np.ndarray) -> int:
"""Найти ближайший центр кластера"""
distances = [self._l2_distance(vector, c) for c in self.centroids]
return int(np.argmin(distances))
def fit(self, vectors: List[np.ndarray]):
"""Инициализировать центры кластеров с помощью K-Means (упрощённо: случайный выбор)"""
# Упрощённо: случайным образом выбрать nlist векторов в качестве начальных центров
# В реальной реализации следует использовать итерацию K-Means
indices = np.random.choice(len(vectors), self.nlist, replace=False)
self.centroids = np.array([vectors[i] for i in indices])
def add(self, vector: np.ndarray) -> int:
"""Добавить вектор"""
vec_id = self.next_id
self.next_id += 1
# Найти ближайший бакет
centroid_idx = self._find_nearest_centroid(vector)
# Поместить его в этот бакет
self.inverted_lists[centroid_idx].append((vec_id, vector))
return vec_id
def search(self, query: np.ndarray, top_k: int = 5, nprobe: int = 3) -> List[Tuple[int, float]]:
"""
Поиск Top K
nprobe: сколько бакетов искать (больше — точнее, но медленнее)
"""
# Найти ближайшие nprobe корзины
centroid_distances = [
(self._l2_distance(query, c), i)
for i, c in enumerate(self.centroids)
]
centroid_distances.sort()
nearest_centroids = [i for dist, i in centroid_distances[:nprobe]]
# Искать только в этих nprobe корзинах
candidates = []
for centroid_idx in nearest_centroids:
for vec_id, vec in self.inverted_lists[centroid_idx]:
dist = self._l2_distance(query, vec)
candidates.append((dist, vec_id))
# Отсортировать и вернуть топ K
candidates.sort()
return [(vec_id, dist) for dist, vec_id in candidates[:top_k]]
#
np.random.seed(42)
dim = 128
# Сгенерировать 1000 векторов
vectors = [np.random.randn(dim) for _ in range(1000)]
# Построить индекс IVF
ivf = SimpleIVF(dim=dim, nlist=20)
ivf.fit(vectors)
# Добавить векторы
for vec in vectors:
ivf.add(vec)
print(f"Построение IVF индекса завершено, количество бакетов = {ivf.nlist}")
for i in range(ivf.nlist):
print(f" Корзина {i:2d}: {len(ivf.inverted_lists[i])} векторов")
# Запрос
query = np.random.randn(dim)
print("\nВыполняется поиск IVF (nprobe=3)...")
results = ivf.search(query, top_k=5, nprobe=3)
print("Результаты поиска:")
for vec_id, dist in results:
print(f" Вектор {vec_id:3d}, расстояние = {dist:.4f}")
# Вывод примерно такой:
# Построение IVF-индекса завершено, количество корзин = 20
# Корзина 0: 63 вектора
# Корзина 1: 56 векторов
# ...
#
# Выполняется поиск IVF (nprobe=3)...
# Результаты поиска:
# Вектор 863, расстояние = 13.5409
# Вектор 189, расстояние = 13.7083
# Вектор 491, расстояние = 13.8628
# Вектор 264, расстояние = 13.9812
# Вектор 781, расстояние = 14.0021
Преимущество IVF — небольшой объем занимаемой памяти, и можно динамически настраивать параметр nprobe во время запроса, чтобы балансировать скорость и точность.
PQ: квантование произведений
PQ (квантование произведений) — это алгоритм сжатия.
Основная идея:
-
1. Разбиение: разбить многомерный вектор на несколько меньших сегментов (субвекторов).
-
2. Квантование: кластеризовать каждый небольшой сегмент независимо и заменить исходный вектор на ID центра кластера.
-
3. Поиск: во время запроса используйте таблицу поиска для быстрого вычисления приблизительных расстояний.
Например, 128-мерный вектор разбивается на 8 сегментов по 16 измерений каждый, и каждый сегмент квантуется с помощью 256 центров. В результате каждому вектору требуется всего 8 bytes памяти (изначально 128 * 4 = 512 bytes).
Комбинация IVF-PQ
В производственных средах IVF и PQ обычно комбинируются:
IVF отвечает за «группировку» для сокращения области поиска, а PQ отвечает за «сжатие» для сокращения памяти и вычислений.
| Алгоритм | Скорость | Точность | Память | Применимые сценарии |
|---|---|---|---|---|
| Поиск полным перебором | Медленная | 100% | Высокая | Малый объём данных, требуется 100% точность |
| HNSW | Чрезвычайно быстрый | Высокая | Средняя | Интенсивные запросы, требуется низкая задержка |
| IVF | Высокая | Средняя | Низкая | Крупномасштабные данные, допустима небольшая потеря точности |
| IVF-PQ | Очень быстро | Средняя | Крайне низкий | Сверхбольшие данные, ограниченная память |
Метрики сходства
Существует много способов вычисления "сходства", и выбор правильной метрики важен.
Косинусное сходство
Косинусное сходство измеряет угол между направлениями двух векторов, диапазон значений — [-1, 1].
Чем ближе значение к 1, тем более похожи; чем ближе к -1, тем более противоположны.
Пример
# Вычисление косинусного сходства
# ============================================
import numpy as np
def cosine_similarity(v1: np.ndarray, v2: np.ndarray) -> float:
"""
Косинусное сходство = (v1 · v2) / (|v1| * |v2|)
Диапазон [-1, 1], чем ближе к 1, тем больше сходство
"""
dot_product = np.dot(v1, v2)
norm1 = np.linalg.norm(v1)
norm2 = np.linalg.norm(v2)
return dot_product / (norm1 * norm2)
#
np.random.seed(42)
v1 = np.array([1, 2, 3, 4, 5])
v2 = np.array([2, 4, 6, 8, 10]) # Одинаковое направление
v3 = np.array([-1, -2, -3, -4, -5]) # Противоположное направление
v4 = np.random.randn(5) # Случайные значения
print(f"v1 = {v1}")
print(f"v2 = {v2}")
print(f"v3 = {v3}")
print(f"v4 = {v4}")
print()
print(f"cosine(v1, v2) = {cosine_similarity(v1, v2):.4f} (одинаковое направление, должно быть 1.0)")
print(f"cosine(v1, v3) = {cosine_similarity(v1, v3):.4f} (противоположное направление, должно быть -1.0)")
print(f"cosine(v1, v4) = {cosine_similarity(v1, v4):.4f}")
# Вывод:
# v1 = [1 2 3 4 5]
# v2 = [ 2 4 6 8 10]
# v3 = [-1 -2 -3 -4 -5]
# v4 = [ 0.4967 -0.1383 0.6477 1.5230 -0.2342]
#
# cosine(v1, v2) = 1.0000 (одинаковое направление, должно быть 1.0)
# cosine(v1, v3) = -1.0000 (противоположное направление, должно быть -1.0)
# cosine(v1, v4) = 0.2143
Особенность косинусного сходства: оно не учитывает длину вектора, а только направление. Это часто встречается в текстовых эмбеддингах, потому что "семантика" текста не связана с длиной.
Евклидово расстояние L2
Расстояние L2 — это расстояние по прямой между двумя точками в пространстве; чем оно меньше, тем более похожи.
Внутреннее произведение (скалярное произведение)
Внутреннее произведение = v1 · v2. Если векторы нормализованы, внутреннее произведение равно косинусному сходству.
Руководство по выбору
| Метрика | Диапазон значений | Когда выбирать | Типичные случаи использования |
|---|---|---|---|
| Косинусное сходство | [-1, 1] | Учитывает только направление, а не длину | Текстовые эмбеддинги, семантический поиск |
| Расстояние L2 | [0, ∞) | Пространственное положение имеет значение | Признаки изображений, рекомендательные системы |
| Скалярное произведение | (-∞, ∞) | Векторы нормализованы, или длина имеет значение | Некоторые конкретные модели эмбеддингов |
Большинство моделей эмбеддингов (например, серия text-embedding от OpenAI) выдают нормализованные векторы; в этом случаекосинусное сходство = скалярное произведение, поэтому не имеет значения, какое из них использовать.
Сравнение популярных векторных баз данных
Векторные базы данных делятся на три категории: локальные библиотеки (FAISS), легковесные open-source (Chroma, Qdrant) и корпоративного уровня (Milvus, Pinecone, Weaviate).
FAISS: локальная библиотека от Facebook
FAISS — не полноценная база данных, а библиотека на C++ (с привязками для Python).
Пример
# Демонстрация базового использования FAISS
# ============================================
import numpy as np
# Примечание: для запуска сначала нужно установить FAISS
# pip install faiss-cpu (версия для CPU)
# или
# pip install faiss-gpu (версия для GPU)
# Ниже приведён типичный пример использования FAISS (пример кода, фактически не выполняется)
def faiss_example():
"""Пример использования FAISS"""
# 1. Подготовка данных
dimension = 128
nb = 10000 # Количество векторов в базе данных
nq = 10 # Количество векторов запросов
np.random.seed(42)
xb = np.random.random((nb, dimension)).astype('float32') # База данных
xq = np.random.random((nq, dimension)).astype('float32') # Запрос
# 2. Создание индекса (пример IVF)
import faiss
nlist = 100 # Количество центров кластеров
quantizer = faiss.IndexFlatL2(dimension) # Квантователь
index = faiss.IndexIVFFlat(quantizer, dimension, nlist, faiss.METRIC_L2)
# 3. Обучение индекса
index.train(xb)
# 4. Добавить векторы
index.add(xb)
# 5. Установить nprobe для поиска
index.nprobe = 10
# 6. Поиск топ-5
k = 5
distances, indices = index.search(xq, k)
print("Результаты запросов (топ-5 для первых 2 запросов):")
for i in range(min(2, nq)):
print(f"Запрос {i}:")
for j in range(k):
print(f" Индекс {indices[i][j]}, расстояние {distances[i][j]:.4f}")
return index
# Пример индекса HNSW
def faiss_hnsw_example():
"""Индекс FAISS HNSW"""
import faiss
dimension = 128
index = faiss.IndexHNSWFlat(dimension, 32) # 32 = параметр M (количество соединений на узел)
index.hnsw.efConstruction = 40 # ef во время построения графа
index.hnsw.efSearch = 16 # ef во время поиска
# Добавить данные...
# index.add(xb)
return index
# Если FAISS установлен, можно раскомментировать строки ниже для запуска
# faiss_example()
print("Пример кода FAISS: это типичное использование FAISS.")
print("Ключевые шаги: создать индекс → обучить → добавить векторы → поиск.")
print()
print("Основные типы индексов FAISS:")
print(" - IndexFlatL2: полный перебор (точный, но медленный)")
print(" - IndexIVFFlat: поиск по корзинам IVF")
print(" - IndexIVFPQ: IVF + сжатие PQ")
print(" - IndexHNSWFlat: графовый индекс HNSW")
Возможности FAISS:
-
1. Чрезвычайно быстрый: реализация на C++, оптимизирована до предела.
-
2. Полнофункциональный: поддерживает почти все основные алгоритмы ANN.
-
3. Локальный: без сети, без персистентности (файл индекса нужно сохранять самостоятельно).
Применимые сценарии: офлайн-пакетная обработка, нежелание разворачивать сервис, относительно небольшой объём данных.
Chroma: лёгкий и Local-First
Chroma — простая и удобная в использовании векторная база данных, созданная, чтобы "ускорить разработку AI-приложений".
Пример
# Демонстрация базового использования Chroma
# ============================================
# Установка: pip install chromadb
def chroma_example():
"""Пример использования Chroma"""
import chromadb
from chromadb.utils import embedding_functions
# 1. Инициализация клиента (локальный режим, данные сохраняются на диск)
client = chromadb.PersistentClient(path="./example-chroma-db")
# 2. Создание или получение коллекции
collection = client.get_or_create_collection(
name="example_docs",
metadata={"description": "Пример коллекции учебных документов"}
)
# 3. Добавление документов (Chroma автоматически обрабатывает встраивание)
# Вы можете использовать OpenAI, Cohere и т. д. или предоставить собственные векторы
документы = [
"Python — интерпретируемый высокоуровневый язык программирования общего назначения.",
"JavaScript — это легковесный интерпретируемый язык программирования.",
"Векторные базы данных используются для хранения и поиска векторных эмбеддингов.",
"RAG, или Retrieval-Augmented Generation, — это техника, объединяющая поиск с генерацией.",
"HNSW — это алгоритм приближенного поиска ближайших соседей, основанный на иерархическом графе малого мира."
]
metadatas = [
{"категория": "программирование", "язык": "Python"},
{"категория": "программирование", "язык": "JavaScript"},
{"категория": "база данных", "тема": "вектор"},
{"категория": "ИИ", "тема": "rag"},
{"категория": "алгоритм", "тема": "hnsw"}
]
ids = ["doc1", "doc2", "doc3", "doc4", "doc5"]
# Добавить (здесь используются фиктивные векторы; на практике используйте модель эмбеддингов)
import numpy as np
np.random.seed(42)
embeddings = [np.random.randn(128).tolist() for _ in range(5)]
collection.add(
documents=documents,
metadatas=metadatas,
ids=ids,
embeddings=embeddings # Если не указано, Chroma использует функцию встраивания по умолчанию
)
print(f"В коллекции {collection.count()} документов")
# 4. Запрос
query_embedding = np.random.randn(128).tolist()
results = collection.query(
query_embeddings=[query_embedding],
n_results=3,
# Можно добавить фильтрацию по метаданным
# where={"category": "ai"}
)
print("\nРезультаты запроса:")
for i in range(len(results['ids'][0])):
print(f"ID: {results['ids'][0][i]}")
print(f"Документ: {results['documents'])
print(f"Расстояние: {results['distances'])
print("---")
return collection
# Если Chroma установлена, вы можете раскомментировать строки ниже, чтобы запустить
# chroma_example()
print("Пример кода Chroma: простой дизайн, работает из коробки.")
print()
print("Возможности Chroma:")
print(" - Простота: дружелюбный API, начать работу за минуты")
print(" - Приоритет локальной работы: может сохраняться на диск или работать в памяти")
print(" - Встроенные эмбеддинги: поддерживает OpenAI, Cohere, Sentence-Transformers")
print(" - Поддержка фильтрации по метаданным: можно фильтровать по метаданным во время запросов")
Qdrant: открытый исходный код промышленного уровня
Qdrant — это векторная база данных, написанная на Rust, с хорошей производительностью и полным набором функций.
Пример
# Демонстрация базового использования Qdrant
# ============================================
# Установка: pip install qdrant-client
# Запуск сервиса: docker run -p 6333:6333 qdrant/qdrant
def qdrant_example():
"""Пример использования Qdrant"""
from qdrant_client import QdrantClient
from qdrant_client.models import Distance, VectorParams, PointStruct, Filter, FieldCondition, MatchValue
# 1. Подключение клиента
client = QdrantClient(host="localhost", port=6333)
# 2. Создание коллекции
client.recreate_collection(
collection_name="example_collection",
vectors_config=VectorParams(
size=128,
distance=Distance.COSINE # или L2, DOT
),
# Необязательно: настроить параметры индекса HNSW
# hnsw_config=HnswConfig(m=16, ef_construct=100)
)
# 3. Добавить точки
import numpy as np
np.random.seed(42)
points = [
PointStruct(
id=i,
vector=np.random.randn(128).tolist(),
payload={
"text": f"Содержимое документа {i}",
"category": "tech" if i % 2 == 0 else "life",
"author": f"author_{i % 3}"
}
)
for i in range(100)
]
client.upsert(
collection_name="example_collection",
points=points
)
# 4. Запрос
query_vector = np.random.randn(128).tolist()
results = client.search(
collection_name="example_collection",
query_vector=query_vector,
limit=5,
# Фильтрация может быть добавлена
# query_filter=Filter(
# must=[
# FieldCondition(key="category", match=MatchValue(value="tech"))
# ]
# )
)
print("Результаты запроса:")
for result in results:
print(f"ID: {result.id}, Оценка: {result.score:.4f}")
print(f"Полезная нагрузка: {result.payload}")
print("---")
return client
# Если Qdrant запущен, вы можете раскомментировать строки ниже, чтобы запустить
# qdrant_example()
print("Пример кода Qdrant: реализация на Rust, комплексные возможности.")
print()
print("Возможности Qdrant:")
print(" - Хорошая производительность: Rust + HNSW")
print(" - Полный набор возможностей: поддерживает фильтрацию, группировку, агрегацию, пагинацию")
print(" - Простое развертывание: запуск в один клик с Docker")
print(" - Поддержка шардирования: можно масштабировать горизонтально")
Сравнительная таблица популярных векторных баз данных
| Продукт | Type | Развёртывание | Особенности | Сценарии использования |
|---|---|---|---|---|
| FAISS | Локальная библиотека | Отсутствует | Чрезвычайно быстрый, полнофункциональный, требует самостоятельного обслуживания | Офлайн-обработка, не хотите настраивать сервис |
| Chroma | Легковесный | Локальный/Серверный | Простой и удобный в использовании, ориентирован на Python | Прототипирование, небольшие проекты |
| Qdrant | Открытый исходный код | Docker/K8s | Хорошая производительность, полный набор функций, Rust | Продакшен-среда, средний масштаб |
| Milvus | Открытый исходный код | Распределённый | Корпоративного уровня, наиболее полный набор функций | Крупномасштабная производственная среда |
| Weaviate | Открытый исходный код | Docker/K8s | Модульность, хорошая экосистема | Нужна гибкая комбинация возможностей |
| Pinecone | Облачный сервис | SaaS | Полностью управляемый, масштабирование по требованию | Не хотите заниматься эксплуатацией — быстрый запуск |
Выбор модели эмбеддингов
Векторные базы данных — это всего лишь инфраструктура; результат по-настоящему определяет модель эмбеддингов.
Сравнение основных моделей эмбеддингов
| Модель | Размерность | Особенности | Цена |
|---|---|---|---|
| OpenAI text-embedding-3-small | 1536 | Высокое соотношение цена/качество, хорошее общее качество | $0.00002 / 1K токенов |
| OpenAI text-embedding-3-large | 3072 | Наивысшее качество, высокая размерность | $0.00013 / 1K токенов |
| Cohere Embed v3 | 1024 | Хорошая поддержка многоязычности | $0.0001 / 1K токенов |
| bge-large-zh-v1.5 | 1024 | Хорошо подходит для китайского, открытый исходный код и бесплатно | Бесплатно |
| bge-m3 | 1024 | Многоязычный, многофункциональный | Бесплатно |
| gte-large | 1024 | Сбалансированный выбор, открытый исходный код | Бесплатно |
Компромисс между размерностью и производительностью
Чем выше размерность, тем обычно лучше результаты, но:
-
1. Хранение обходится дороже: 3072 размерности занимают в два раза больше места, чем 1536 размерностей.
-
2. Вычисления медленнее: Стоимость вычисления расстояния пропорциональна размерности.
-
3. Больший индекс: Индексы HNSW/IVF также будут больше.
Рекомендация:Сначала протестируйте низкоразмерную модель; если её недостаточно, перейдите к более высокой размерности.. В большинстве сценариев 1536 размерностей уже достаточно.
Гибридный поиск
Чистый векторный поиск иногда недостаточно хорош, потому что он сопоставляет только «семантику», а не «ключевые слова».
Гибридный поиск = векторный поиск + поиск по ключевым словам, затем объединение результатов.
Разреженный поиск BM25
BM25 — классический алгоритм в традиционном поиске, измеряющий степень совпадения ключевых слов.
Пример
# Демонстрация поиска по ключевым словам BM25
# ============================================
import math
from typing import List, Dict, Set
class SimpleBM25:
"""Упрощённая реализация BM25"""
def __init__(self, k1: float = 1.5, b: float = 0.75):
self.k1 = k1
self.b = b
self.documents: List[List[str]] = []
self.doc_lengths: List[int] = []
self.avg_doc_length: float = 0
self.term_freqs: List[Dict[str, int]] = []
self.doc_freq: Dict[str, int] = {}
self.num_docs: int = 0
def _tokenize(self, text: str) -> List[str]:
"""Простая токенизация (по пробелам и знакам пунктуации)"""
# Упрощённо: преобразовать в нижний регистр, разделить по символам, не являющимся буквенно-цифровыми
import re
return [t.lower() for t in re.findall(r'\w+', text)]
def fit(self, documents: List[str]):
"""Построить индекс"""
self.documents = []
self.doc_lengths = []
self.term_freqs = []
self.doc_freq = {}
self.num_docs = len(documents)
for doc in documents:
tokens = self._tokenize(doc)
self.documents.append(tokens)
self.doc_lengths.append(len(tokens))
# Подсчитать частоту терминов
tf: Dict[str, int] = {}
for token in tokens:
tf[token] = tf.get(token, 0) + 1
self.term_freqs.append(tf)
# Обновить частоту документов
for token in tf.keys():
self.doc_freq[token] = self.doc_freq.get(token, 0) + 1
self.avg_doc_length = sum(self.doc_lengths) / self.num_docs
def score(self, query: str) -> List[float]:
"""Вычислить оценку BM25 для каждого документа"""
query_tokens = self._tokenize(query)
scores = [0.0] * self.num_docs
for token in query_tokens:
if token not in self.doc_freq:
continue
# Вычисление IDF
df = self.doc_freq[token]
idf = math.log(1 + (self.num_docs - df + 0.5) / (df + 0.5))
# Вычислить оценку для каждого документа
for doc_idx in range(self.num_docs):
doc_len = self.doc_lengths[doc_idx]
tf = self.term_freqs[doc_idx].get(token, 0)
# Основная формула BM25
numerator = tf * (self.k1 + 1)
denominator = tf + self.k1 * (1 - self.b + self.b * doc_len / self.avg_doc_length)
scores[doc_idx] += idf * numerator / denominator
return scores
def search(self, query: str, top_k: int = 5) -> List[Dict]:
"""Поиск Top K"""
scores = self.score(query)
# Сортировка
results = [
{"doc_idx": i, "score": s}
for i, s in enumerate(scores)
]
results.sort(key=lambda x: x["score"], reverse=True)
return results[:top_k]
#
документы = [
"Python — это язык программирования, который легко изучить.",
"JavaScript используется для веб-разработки, его можно использовать как на фронтенде, так и на бэкенде.",
"Векторные базы данных используются для хранения и поиска векторных эмбеддингов.",
"Существует много типов баз данных, например реляционные базы данных и NoSQL-базы данных.",
"HNSW — это алгоритм приближённого поиска ближайших соседей."
]
bm25 = SimpleBM25()
bm25.fit(documents)
# Поиск
query = "база данных"
results = bm25.search(query, top_k=5)
print(f"Запрос:\"{query}\"")
print("Результаты поиска BM25:")
for r in results:
print(f" Документ {r['doc_idx']}: {documents[r['doc_idx']]}")
print(f" Оценка = {r['score']:.4f}")
# Вывод примерно такой:
# Запрос: "database"
# Результаты поиска BM25:
# Документ 2: Векторные базы данных используются для хранения и извлечения векторных эмбеддингов.
# Оценка = 0.7134
# Документ 3: Существует много типов баз данных, таких как реляционные базы данных и базы данных NoSQL.
# Оценка = 0.6148
# ...
RRF: Reciprocal Rank Fusion
RRF (Reciprocal Rank Fusion) — простой и эффективный метод объединения нескольких результатов поиска.
Формула: score = 1 / (k + rank), где k обычно равно 60.
Пример
# Демонстрация RRF-слияния
# ============================================
from typing import List, Dict, Any
def rrf_fuse(
result_lists: List[List[Any]],
k: int = 60
) -> Dict[Any, float]:
"""
RRF-слияние: для каждого списка результатов добавьте оценки, используя 1/(k + rank)
result_lists: несколько отсортированных списков результатов
"""
scores: Dict[Any, float] = {}
for results in result_lists:
for rank, item in enumerate(results):
score = 1.0 / (k + rank)
scores[item] = scores.get(item, 0) + score
return scores
# Пример: результаты векторного поиска и результаты поиска BM25
vector_results = ["doc3", "doc1", "doc4", "doc2", "doc5"] # Векторный поиск считает doc3 наиболее релевантным
bm25_results = ["doc2", "doc4", "doc3", "doc5", "doc1"] # BM25 считает doc2 наиболее релевантным
# Слияние RRF
fused = rrf_fuse([vector_results, bm25_results])
# Сортировка
final_rank = sorted(fused.items(), key=lambda x: x[1], reverse=True)
print("Результаты векторного поиска:", vector_results)
print("Результаты поиска BM25:", bm25_results)
print()
print("Итоговый рейтинг после слияния RRF:")
for doc, score in final_rank:
print(f" {doc}: {score:.6f}")
# Вывод:
# Результаты векторного поиска: ['doc3', 'doc1', 'doc4', 'doc2', 'doc5']
# Результаты поиска BM25: ['doc2', 'doc4', 'doc3', 'doc5', 'doc1']
#
# Итоговый рейтинг после RRF-слияния:
# doc3: 0.032787
# doc2: 0.032787
# doc4: 0.032520
# doc1: 0.016393
# doc5: 0.016393
Настройка весов слияния
Помимо RRF, также можно использовать взвешенное линейное слияние:
final_score = α * vector_score + (1 - α) * bm25_score
α — это вес для векторного поиска, который необходимо настраивать на основе фактических данных.
Повторное ранжирование
Гибридный поиск можно дополнительно улучшить: сначала получить набор кандидатов, затем выполнить повторное ранжирование с помощью более мощной модели.
Принципы Cross-Encoder
Bi-Encoder (для поиска): кодирует запрос и документ по отдельности, сравнивает по сходству.
Cross-Encoder (для повторного ранжирования): объединяет запрос и документ как входные данные модели и напрямую выдаёт оценку релевантности.
Cross-Encoder точнее, но медленнее, поэтому подходит для повторного ранжирования только Топ-50–100 кандидатов.
Пример
# Демонстрация процесса повторного ранжирования
# ============================================
def reranking_pipeline_example():
"""
Двухэтапный процесс поиска:
1. Грубый поиск: используйте векторный поиск, чтобы быстро найти Топ-100
2. Точное ранжирование: используйте Cross-Encoder для повторного ранжирования Топ-100
"""
print("Двухэтапный процесс поиска:")
print()
print("Этап 1: Грубый поиск (векторный поиск)")
print(" - Цель: высокая скорость, низкая задержка")
print(" - Метод: векторный поиск HNSW/IVF")
print(" - Результат: Top 100 кандидатов")
print()
print("Этап 2: Точное ранжирование (Cross-Encoder)")
print(" - Цель: точность, высокое качество")
print(" - Метод: попарное оценивание Cross-Encoder")
print(" - Результат: итоговый Top 10")
print()
print("Типичная конфигурация:")
print(" - Этап поиска: HNSW efSearch = 128, recall 100")
print(" - Этап переранжирования: используйте bge-reranker или Cohere Rerank")
print()
print("Почему бы напрямую не использовать Cross-Encoder для поиска всего?")
print(" - Cross-Encoder слишком медленный; поиск по 1 миллиону документов нереалистичен")
print(" - Векторный поиск по 1 миллиону выполняется быстро, и переранжирование Cross-Encoder по 100 тоже быстро")
# Пример использования Cohere Rerank API (псевдокод)
def cohere_rerank_example():
"""
Пример использования Cohere Rerank API
"""
print("Типичное использование Cohere Rerank API:")
print()
print('''
import cohere
co = cohere.Client(api_key="your-api-key")
query = "Что такое векторная база данных?"
documents = [
"Содержимое документа 1...",
"Содержимое документа 2...",
... # топ-100 кандидатов
]
results = co.rerank(
query=query,
documents=documents,
top_n=10,
model="rerank-english-v3.0"
)
for r in results:
print(r.index, r.relevance_score, documents[r.index])
''')
reranking_pipeline_example()
Компромисс между производительностью и задержкой
| Подход | Качество | Скорость | Стоимость | Сценарий применения |
|---|---|---|---|---|
| Чистый векторный поиск | Средняя | Чрезвычайно быстрый | Низкая | Для чрезвычайно высоких требований к скорости |
| Гибридный поиск | Средне-высокая | Высокая | Средняя | Сбалансированный выбор |
| Вектор + переранжирование | Высокая | Средняя | Средне-высокая | В погоне за качеством |
| Гибридный поиск + переранжирование | Наивысшая | Средне-медленная | Высокая | Качество прежде всего |
Оптимизация продакшен-среды
От демо до продакшена — есть много деталей, на которые стоит обратить внимание.
Стратегии шардирования индекса
Когда объём данных превышает возможности одной машины, требуется шардирование:
-
1. Шардирование по ID: Просто, но при запросах нужно искать по всем шардам.
-
2. Шардирование по кластеризации векторов: При запросах нужно искать только в нескольких релевантных шардах.
Фильтрация по метаданным
В производственных средах фильтрация по метаданным почти всегда используется в сочетании.
Две стратегии:
-
1. Предфильтрация: Сначала фильтрация по метаданным, затем выполняется векторный поиск.
-
2. Постфильтрация: Сначала выполняется векторный поиск, затем фильтрация по метаданным.
Принцип выбора: если после фильтрации остаётся много векторов, используйте предфильтрацию; если остаётся мало — постфильтрацию.
Инкрементальные обновления
Большинство векторных баз данных поддерживают инкрементальное добавление, но учтите:
-
1. Пакетное добавление: Добавляйте пакетами, а не по одному.
-
2. Перестроение индекса: Некоторые индексы (например, IVF) требуют периодического переобучения.
-
3. Управление версиями: Сохраняйте старые версии индекса, чтобы иметь возможность откатиться при обновлениях.
Метрики мониторинга
В производственных средах следует отслеживать:
-
1. Задержка запросов:P50、P95、P99。
-
2. Полнота (Recall): Регулярно проверяйте качество результатов Top K.
-
3. Размер индекса: Использование памяти/диска.
-
4. QPSКоличество запросов в секунду.