ベクトルデータベース
AI時代において、私たちが扱うデータの形態は根本的に変化しました。
従来のデータベースが格納していたのは構造化データです:数値、文字列、日付。
AIアプリケーションが処理するのはセマンティクス(意味)です:テキストの意味、画像の内容、音声の意味。これらの意味情報はベクトル——浮動小数点の列、例えば [0.123, -0.456, 0.789, ...] として表現されます。
ベクトルデータベースとは、これらのベクトルを保存・インデックス化・検索することに特化したデータベースです。これがなければ、RAG(検索拡張生成)はできず、セマンティック検索も実現できず、レコメンドシステムも効率的に動作しません。
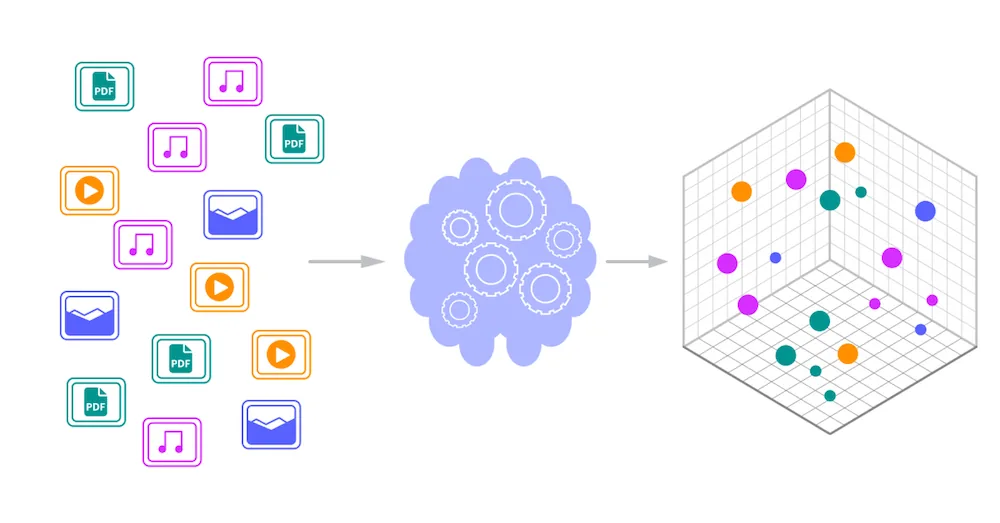
ベクトルデータベースの核心的価値:100万規模から10億規模のベクトルの中から、クエリベクトルに最も類似した上位K件の結果をミリ秒単位で見つけ出す。
ベクトル類似度検索の課題
問題の本質を理解して初めて、なぜ専用のアルゴリズムが必要なのかを理解できます。
力任せ検索の複雑性の問題
最も単純な考え方は力任せ検索です:クエリベクトルとライブラリ内の全ベクトルとの類似度を計算し、ソートして上位K件を取得します。
例
# 力任せ検索のデモ:単純だが非効率
# ============================================
import numpy as np
from typing import List, Tuple
def l2_distance(v1: np.ndarray, v2: np.ndarray) -> float:
"""L2ユークリッド距離を計算:小さいほど類似"""
return np.sqrt(np.sum((v1 - v2) ** 2))
def brute_force_search(
query: np.ndarray,
vectors: List[np.ndarray],
top_k: int = 5
) -> List[Tuple[int, float]]:
"""
力任せ検索:全ベクトルとの距離を計算し、ソートしてTop Kを返す
利点:単純で正確、100%リコール
欠点:データ量が多いと非常に遅い
"""
# 各ベクトルとの距離を計算
distances = []
for idx, vec in enumerate(vectors):
dist = l2_distance(query, vec)
distances.append((idx, dist))
# 距離でソートして上位K個を取得
distances.sort(key=lambda x: x[1])
return distances[:top_k]
# 10000個の128次元ランダムベクトルを生成(ベクトルライブラリを模擬)
np.random.seed(42)
vector_count = 10000
dimension = 128
vectors = [np.random.randn(dimension) for _ in range(vector_count)]
# クエリベクトルを生成
query_vector = np.random.randn(dimension)
# 力任せ検索を実行
print(f"{vector_count} 個のベクトルから Top 5 を検索中...")
results = brute_force_search(query_vector, vectors, top_k=5)
print("検索結果:")
for idx, dist in results:
print(f" ベクトル {idx:4d}, 距離 = {dist:.4f}")
# 出力例:
# 10000 個のベクトルから Top 5 を検索中...
# 検索結果:
# ベクトル 8236, 距離 = 13.3986
# ベクトル 8946, 距離 = 13.5604
# ベクトル 9891, 距離 = 13.5688
# ベクトル 5172, 距離 = 13.5987
# ベクトル 5223, 距離 = 13.6081
力任せ検索の問題は明らかです:毎回のクエリですべてのベクトルを走査する必要があります。
100万個のベクトルがあれば、毎回のクエリで100万回の距離計算が必要です。
10億個のベクトルがあれば、毎回10億回の計算が必要になります——これは本番環境では全く受け入れられません。
高次元空間の「次元の呪い」
さらに悪いことに、ベクトルは通常高次元です。
OpenAI の text-embedding-3-small は1536次元、large は3072次元です。
高次元空間では、従来の空間インデックス手法(例:KD-Tree)の効率が急激に低下し、力任せ検索よりも遅くなることさえあります。
| データ規模 | 力任せ検索の所要時間(推定) | 受け入れられるか? |
|---|---|---|
| 1万 | ~1ミリ秒 | 受け入れ可能 |
| 100万 | ~100ミリ秒 | やや遅い |
| 1000万 | ~1秒 | 遅すぎる |
| 1億 | ~10秒 | 全く受け入れられない |
| 10億 | ~100秒 | 使用不可 |
これが必要な理由は近似最近傍(ANN)アルゴリズム:100%の正確さを犠牲にして、100倍、いや1000倍の速度向上を得る。
近似最近傍(ANN)アルゴリズム
ANN アルゴリズムの核となる考え方:インデックス構造を構築し、クエリ時にすべてのベクトルを走査しなくて済むようにする。
主要なアルゴリズムは3つあります:HNSW、IVF、PQ。
HNSW:階層的スモールワールドグラフ
HNSW(Hierarchical Navigable Small World)は現在最も人気のあるアルゴリズムの1つで、その着想は六次の隔たり理論——世界の任意の2人は、最大6人の中継人を介せばつながることができる——に由来しています。
HNSWは多層の疎なスモールワールドグラフを用いて、最上層の疎なノードから高速に大まかな位置を特定し、層を下るごとに最下層の全量データ層へ到達して精密に検索します。階層的なジャンプで距離計算回数を大幅に減らし、高速かつ高リコールな近似最近傍検索を実現します。
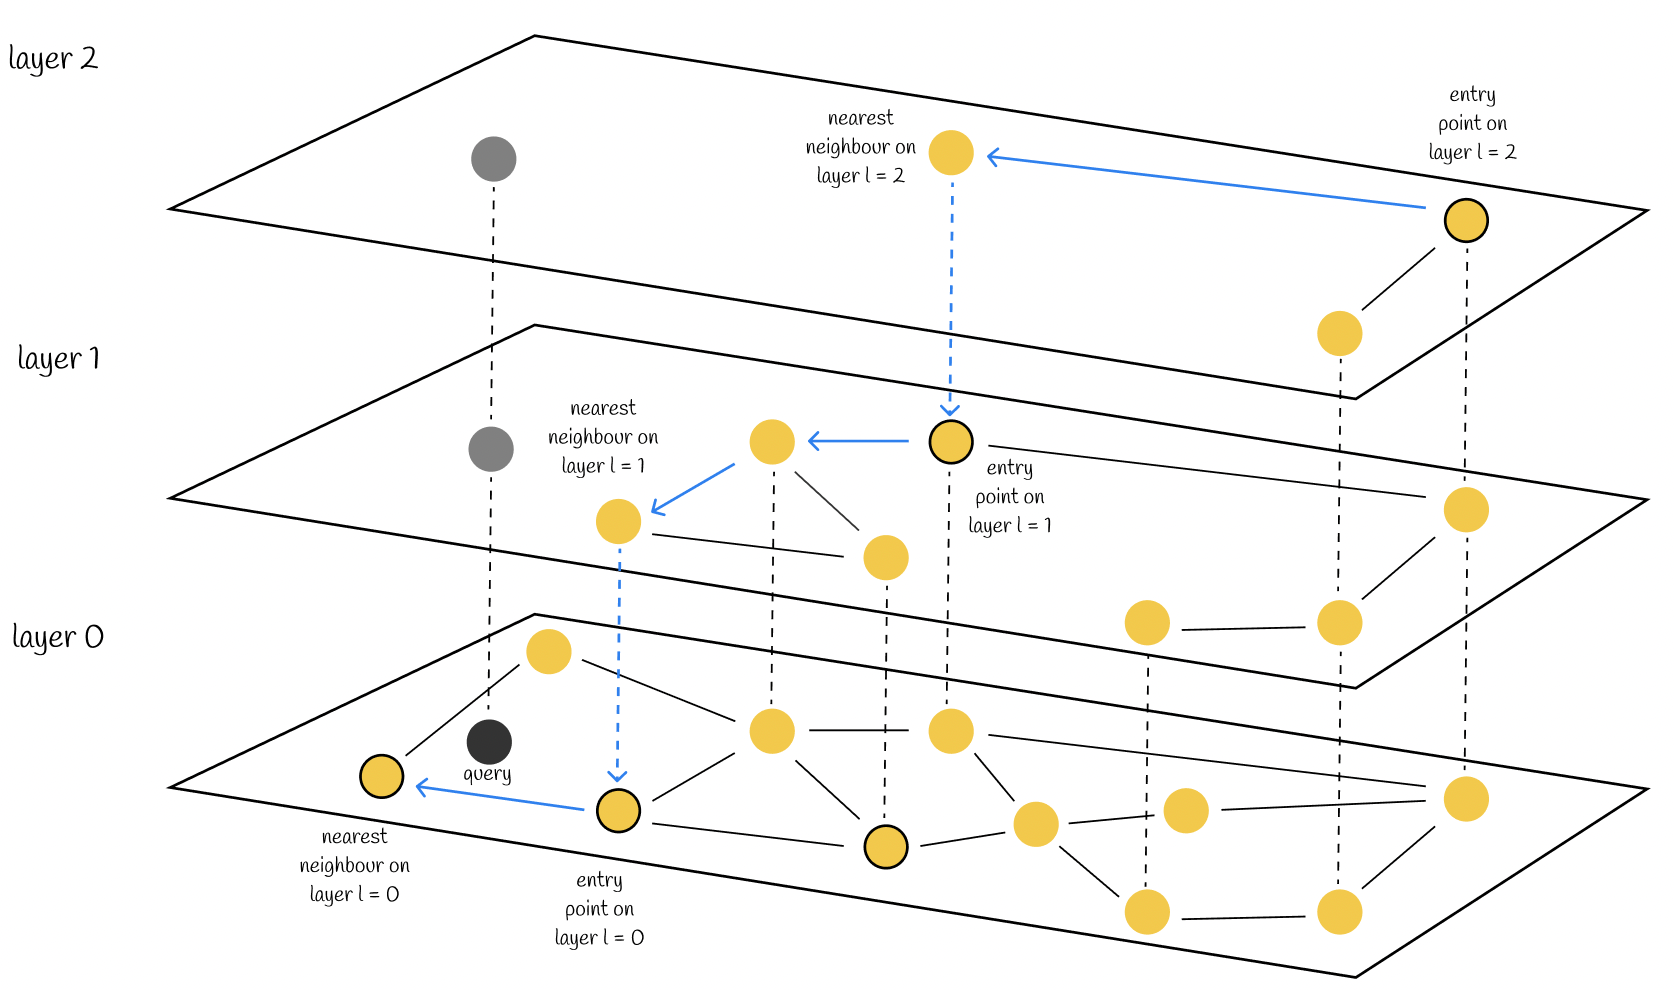
階層構造:最下層のLayer0には全ベクトルを格納;層が上がるほどノードは少なくなり、高速チャネルとして機能します。同じベクトルは層をまたいで点線で垂直に関連付けられます。
検索フロー(青線のパス):
- 最上層の入口から大まかに検索し、その層でクエリベクトルに最も近い点を見つけます。
- 垂直に中間層へ落下し、再度おおまかに位置を特定します。
- Layer0の全量層に落ちて精密に走査し、最近傍を出力します。
核心原理:上位層で検索範囲を素早く絞り込み、下位層で精密にマッチングすることで、力任せ検索を対数複雑度に最適化し、速度が速くリコールも高い、主流のベクトル検索アルゴリズムです。
例
# HNSW 原理の簡易デモ(本番実装ではない)
# ============================================
import numpy as np
import random
from typing import List, Dict, Set, Tuple
class SimpleHNSW:
"""簡易版 HNSW。原理のデモのみを目的とする"""
def __init__(self, dim: int, max_level: int = 3, ef_construction: int = 5):
self.dim = dim
self.max_level = max_level # 最大層数
self.ef_construction = ef_construction # グラフ構築時に考慮する候補数
self.levels: List[Dict[int, np.ndarray]] = [{} for _ in range(max_level)]
self.edges: List[Dict[int, Set[int]]] = [{} for _ in range(max_level)]
self.next_id = 0
self.enter_point = None # 入口点(最上層のどこかの点)
def _random_level(self) -> int:
"""層をランダムに選択:上がるほど確率は小さくなる"""
level = 0
while random.random() < 0.5 and level < self.max_level - 1:
level += 1
return level
def _distance(self, v1: np.ndarray, v2: np.ndarray) -> float:
"""L2 距離"""
return np.sqrt(np.sum((v1 - v2) ** 2))
def _search_layer(
self,
query: np.ndarray,
level: int,
entry: int,
ef: int
) -> List[Tuple[float, int]]:
"""特定の層での検索:entry から始めて、貪欲に ef 個の最近点を見つける"""
if entry not in self.levels[level]:
return []
visited = set([entry])
candidates = [(self._distance(query, self.levels[level][entry]), entry)]
result = list(candidates)
while candidates:
# 現在最も近い候補を取り出す
candidates.sort()
dist, current = candidates.pop(0)
# 近傍を走査
if current not in self.edges[level]:
continue
for neighbor in self.edges[level][current]:
if neighbor in visited:
continue
visited.add(neighbor)
neighbor_dist = self._distance(query, self.levels[level][neighbor])
# 候補と結果セットに追加
candidates.append((neighbor_dist, neighbor))
result.append((neighbor_dist, neighbor))
# 結果セットのサイズを ef 以内に保つ
result.sort()
result = result[:ef]
return result
def add(self, vector: np.ndarray) -> int:
"""ベクトルを追加する"""
vec_id = self.next_id
self.next_id += 1
# このベクトルがどの層に現れるかをランダムに決定
max_level_for_vec = self._random_level()
# すべての層にベクトルを格納(実際の実装では通常、最下層にのみ完全なベクトルを格納)
for level in range(max_level_for_vec + 1):
self.levels[level][vec_id] = vector
self.edges[level][vec_id] = set()
# 最初の点であれば、入口に設定
if self.enter_point is None:
self.enter_point = vec_id
return vec_id
# 最上層から下に向かって検索し、各層の挿入位置を見つける
current_entry = self.enter_point
# まず max_level_for_vec より上の層で検索し、入口を更新
for level in range(self.max_level - 1, max_level_for_vec, -1):
if current_entry in self.levels[level]:
layer_result = self._search_layer(vector, level, current_entry, 1)
if layer_result:
current_entry = layer_result[0][1]
# max_level_for_vec 以下の層で接続を確立
for level in range(max_level_for_vec, -1, -1):
# この層で最も近い ef_construction 個の点を検索
layer_result = self._search_layer(vector, level, current_entry, self.ef_construction)
# これらの点に接続(簡略化:双方向接続)
for dist, neighbor_id in layer_result:
self.edges[level][vec_id].add(neighbor_id)
self.edges[level][neighbor_id].add(vec_id)
# 次の層の入口を更新
if layer_result:
current_entry = layer_result[0][1]
# 最上層の入口を更新
if max_level_for_vec > self._random_level(): # 簡略化した判断
self.enter_point = vec_id
return vec_id
def search(self, query: np.ndarray, top_k: int = 5, ef: int = 10) -> List[Tuple[int, float]]:
"""最近傍 Top K を検索"""
if self.enter_point is None:
return []
current_entry = self.enter_point
# 最上位層から下へ、最初の層まで
for level in range(self.max_level - 1, 0, -1):
if current_entry in self.levels[level]:
layer_result = self._search_layer(query, level, current_entry, 1)
if layer_result:
current_entry = layer_result[0][1]
# 最下層で ef 個のポイントを検索し、Top K を返す
layer_result = self._search_layer(query, 0, current_entry, ef)
layer_result.sort()
return [(vec_id, dist) for dist, vec_id in layer_result[:top_k]]
# テスト
np.random.seed(42)
dim = 128
hnsw = SimpleHNSW(dim=dim, max_level=3, ef_construction=5)
# 100 個のベクトルを追加
print("HNSW インデックスを構築中(100 個のベクトルを追加)...")
for i in range(100):
vec = np.random.randn(dim)
hnsw.add(vec)
print(f"インデックスの構築が完了しました。入口点 = {hnsw.enter_point}")
# クエリベクトルを生成
query = np.random.randn(dim)
# 検索
print("\nHNSW 検索を実行中...")
results = hnsw.search(query, top_k=5, ef=10)
print("検索結果:")
for vec_id, dist in results:
print(f" ベクトル {vec_id:3d}, 距離 = {dist:.4f}")
# 出力例:
# HNSW インデックスを構築中(100 個のベクトルを追加)...
# インデックスの構築が完了しました。エントリポイント = 54
#
# HNSW 検索を実行中...
# 検索結果:
# ベクトル 86, 距離 = 13.7515
# ベクトル 30, 距離 = 13.8651
# ベクトル 28, 距離 = 14.0754
# ベクトル 56, 距離 = 14.1106
# ベクトル 34, 距離 = 14.2131
HNSW の利点:
1. 検索が高速:通常、少数のノードを訪問するだけで最近傍を見つけられます。
-
2. 構築が高速:ベクトルをインクリメンタルに追加でき、インデックス全体を再構築する必要がありません。
-
3. パラメータがシンプル:主に ef_construction(グラフの品質)と ef(検索品質)を調整します。
IVF:転置ファイルインデックス
IVF(Inverted File)の考え方は「分割して統治する」(divide and conquer)です。
手順:
-
1. クラスタリング:ベクトル空間を K 個の「バケット」に分割します(K-Means クラスタリングを使用)。
-
2. インデックス:各ベクトルを最も近いバケットに割り当てます。
-
3. クエリ:まずクエリベクトルに最も近い N 個のバケットを見つけ、その N 個のバケット内でのみ検索します。
例
# IVF の原理の簡易デモ
# ============================================
import numpy as np
from typing import List, Tuple
class SimpleIVF:
"""簡易版 IVF。原理のデモのみを目的とします"""
def __init__(self, dim: int, nlist: int = 10):
self.dim = dim
self.nlist = nlist # クラスタ中心の数(バケットの数)
self.centroids: np.ndarray = None # クラスタ中心
self.inverted_lists: List[List[Tuple[int, np.ndarray]]] = [[] for _ in range(nlist)]
self.next_id = 0
def _l2_distance(self, v1: np.ndarray, v2: np.ndarray) -> float:
"""L2 距離"""
return np.sqrt(np.sum((v1 - v2) ** 2))
def _find_nearest_centroid(self, vector: np.ndarray) -> int:
"""最も近いクラスタ中心を見つける"""
distances = [self._l2_distance(vector, c) for c in self.centroids]
return int(np.argmin(distances))
def fit(self, vectors: List[np.ndarray]):
"""K-Means でクラスタ中心を初期化(簡易版:ランダムに選択)"""
# 簡略化:nlist 個のベクトルをランダムに初期中心として選択
# 実際の実装では K-Means の反復を使用すべき
indices = np.random.choice(len(vectors), self.nlist, replace=False)
self.centroids = np.array([vectors[i] for i in indices])
def add(self, vector: np.ndarray) -> int:
"""ベクトルを追加"""
vec_id = self.next_id
self.next_id += 1
# 最も近いバケットを見つける
centroid_idx = self._find_nearest_centroid(vector)
# このバケットに入れる
self.inverted_lists[centroid_idx].append((vec_id, vector))
return vec_id
def search(self, query: np.ndarray, top_k: int = 5, nprobe: int = 3) -> List[Tuple[int, float]]:
"""
Top K を検索
nprobe: いくつのバケットを検索するか(多いほど正確ですが、遅くなります)
"""
# 最も近い nprobe 個のバケットを見つける
centroid_distances = [
(self._l2_distance(query, c), i)
for i, c in enumerate(self.centroids)
]
centroid_distances.sort()
nearest_centroids = [i for dist, i in centroid_distances[:nprobe]]
# この nprobe 個のバケット内でのみ検索
candidates = []
for centroid_idx in nearest_centroids:
for vec_id, vec in self.inverted_lists[centroid_idx]:
dist = self._l2_distance(query, vec)
candidates.append((dist, vec_id))
# ソートして Top K を返す
candidates.sort()
return [(vec_id, dist) for dist, vec_id in candidates[:top_k]]
# テスト
np.random.seed(42)
dim = 128
# 1000 個のベクトルを生成
vectors = [np.random.randn(dim) for _ in range(1000)]
# IVF インデックスを構築
ivf = SimpleIVF(dim=dim, nlist=20)
ivf.fit(vectors)
# ベクトルを追加
for vec in vectors:
ivf.add(vec)
print(f"IVF インデックスの構築が完了しました。バケット数 = {ivf.nlist}")
for i in range(ivf.nlist):
print(f" バケット {i:2d}: {len(ivf.inverted_lists[i])} 個のベクトル")
# クエリ
query = np.random.randn(dim)
print("\nIVF 検索を実行中(nprobe=3)...")
results = ivf.search(query, top_k=5, nprobe=3)
print("検索結果:")
for vec_id, dist in results:
print(f" ベクトル {vec_id:3d}, 距離 = {dist:.4f}")
# 出力例:
# IVF インデックスの構築が完了しました。バケット数 = 20
# バケット 0: 63 個のベクトル
# バケット 1: 56 個のベクトル
# ...
#
# IVF 検索を実行中(nprobe=3)...
# 検索結果:
# ベクトル 863, 距離 = 13.5409
# ベクトル 189, 距離 = 13.7083
# ベクトル 491, 距離 = 13.8628
# ベクトル 264, 距離 = 13.9812
# ベクトル 781, 距離 = 14.0021
IVF の利点はメモリ使用量が少ないことで、クエリ時の nprobe パラメータを動的に調整して速度と精度のバランスを取れます。
PQ:積量子化
PQ(Product Quantization)は圧縮アルゴリズムです。
核心的な考え方:
-
1. 分割:高次元ベクトルを複数の小さなセグメント(subvectors)に分割します。
-
2. 量子化:各セグメントを個別にクラスタリングし、クラスタ中心の ID で元のベクトルを置き換えます。
-
3. テーブル参照:クエリ時にテーブル参照法を使って近似距離を高速に計算します。
例えば 128 次元ベクトルを 8 セグメントに分割し、各セグメント 16 次元、各セグメントを 256 個の中心で量子化すると、各ベクトルはわずか 8 バイトで格納できます(元は 128 * 4 = 512 バイト必要でした)。
IVF-PQ の組み合わせ
本番環境では通常、IVF と PQ を組み合わせて使用します:
IVF は「バケット分割」で検索範囲を減らし、PQ は「圧縮」でメモリと計算量を減らします。
| アルゴリズム | 速度 | 精度 | メモリ | 適用シナリオ |
|---|---|---|---|---|
| ブルートフォース検索 | 慢 | 100% | 高 | データ量が少なく、100% の正確さが必要 |
| HNSW | 非常に高速 | 高 | 中 | クエリが集中し、低レイテンシが必要 |
| IVF | 快 | 中 | 低 | 大規模データで、わずかな精度の低下を許容できる |
| IVF-PQ | 非常に高速 | 中 | 極めて低い | 超大規模データ、メモリ制約がある |
類似度の指標
「類似」を計算する方法は複数あり、正しい尺度を選ぶことが重要です。
コサイン類似度
コサイン類似度は 2 つのベクトル方向のなす角を測定し、値の範囲は [-1, 1] です。
値が 1 に近いほど類似し、-1 に近いほど反対になります。
例
# コサイン類似度の計算
# ============================================
import numpy as np
def cosine_similarity(v1: np.ndarray, v2: np.ndarray) -> float:
"""
コサイン類似度 = (v1 · v2) / (|v1| * |v2|)
値の範囲は [-1, 1]、1 に近いほど類似
"""
dot_product = np.dot(v1, v2)
norm1 = np.linalg.norm(v1)
norm2 = np.linalg.norm(v2)
return dot_product / (norm1 * norm2)
# テスト
np.random.seed(42)
v1 = np.array([1, 2, 3, 4, 5])
v2 = np.array([2, 4, 6, 8, 10]) # 同じ方向
v3 = np.array([-1, -2, -3, -4, -5]) # 反対方向
v4 = np.random.randn(5) # ランダム
print(f"v1 = {v1}")
print(f"v2 = {v2}")
print(f"v3 = {v3}")
print(f"v4 = {v4}")
print()
print(f"cosine(v1, v2) = {cosine_similarity(v1, v2):.4f} (同じ方向、1.0 になるはず)")
print(f"cosine(v1, v3) = {cosine_similarity(v1, v3):.4f} (反対方向、-1.0 になるはず)")
print(f"cosine(v1, v4) = {cosine_similarity(v1, v4):.4f}")
# 出力:
# v1 = [1 2 3 4 5]
# v2 = [ 2 4 6 8 10]
# v3 = [-1 -2 -3 -4 -5]
# v4 = [ 0.4967 -0.1383 0.6477 1.5230 -0.2342]
#
# cosine(v1, v2) = 1.0000 (同じ方向、1.0 になるはず)
# cosine(v1, v3) = -1.0000 (反対方向、-1.0 になるはず)
# cosine(v1, v4) = 0.2143
コサイン類似度の特徴:ベクトルの長さは気にせず、方向のみに注目します。これはテキスト埋め込みでよく使われます。テキストの「意味」は長さと無関係だからです。
L2 ユークリッド距離
L2 距離は空間内の 2 点間の直線距離で、小さいほど類似しています。
内積(Inner Product / Dot Product)
内積 = v1 · v2。ベクトルがすべて正規化されていれば、内積はコサイン類似度と等しくなります。
選択ガイド
| 尺度 | 値の範囲 | いつ選ぶか | 典型的な使用例 |
|---|---|---|---|
| コサイン類似度 | [-1, 1] | 方向のみを気にし、長さは気にしない | テキスト埋め込み、セマンティック検索 |
| L2 距離 | [0, ∞) | 空間的な位置が重要 | 画像特徴、レコメンドシステム |
| 内積 | (-∞, ∞) | ベクトルが正規化されている、または長さに意味がある | 特定の埋め込みモデル |
多くの埋め込みモデル(OpenAI の text-embedding シリーズなど)が出力するベクトルは正規化されており、この場合コサイン類似度 = 内積、どちらを使っても同じです。
主要ベクトルデータベースの比較
ベクトルデータベースは3種類に分けられます:ローカルライブラリ(FAISS)、軽量オープンソース(Chroma、Qdrant)、エンタープライズ級(Milvus、Pinecone、Weaviate)。
FAISS:Facebook 製のローカルライブラリ
FAISSは完全なデータベースではなく、C++ライブラリ(Pythonバインディングあり)です。
例
# FAISS基本的な使用デモ
# ============================================
import numpy as np
# 注意:実際に実行するにはFAISSのインストールが必要です
# pip install faiss-cpu (CPUバージョン)
# または
# pip install faiss-gpu (GPUバージョン)
# 以下はFAISSの典型的な使い方です(コード例、実際には実行しません)
def faiss_example():
"""FAISSの使用例"""
# 1. データの準備
dimension = 128
nb = 10000 # データベースのベクトル数
nq = 10 # クエリのベクトル数
np.random.seed(42)
xb = np.random.random((nb, dimension)).astype('float32') # データベース
xq = np.random.random((nq, dimension)).astype('float32') # クエリ
# 2. インデックス作成(IVFの例)
import faiss
nlist = 100 # クラスタ中心数
quantizer = faiss.IndexFlatL2(dimension) # 量子化器
index = faiss.IndexIVFFlat(quantizer, dimension, nlist, faiss.METRIC_L2)
# 3. インデックスのトレーニング
index.train(xb)
# 4. ベクトルの追加
index.add(xb)
# 5. 検索時のnprobeの設定
index.nprobe = 10
# 6. Top 5の検索
k = 5
distances, indices = index.search(xq, k)
print("検索結果(最初の2つのクエリのTop 5):")
for i in range(min(2, nq)):
print(f"クエリ {i}:")
for j in range(k):
print(f" インデックス {indices[i][j]}, 距離 {distances[i][j]:.4f}")
return index
# HNSWインデックスの例
def faiss_hnsw_example():
"""FAISS HNSWインデックス"""
import faiss
dimension = 128
index = faiss.IndexHNSWFlat(dimension, 32) # 32 = Mパラメータ(各ノードの接続数)
index.hnsw.efConstruction = 40 # グラフ構築時のef
index.hnsw.efSearch = 16 # 検索時のef
# データの追加...
# index.add(xb)
return index
# FAISSがインストールされている場合は、下のコメントを外して実行できます
# faiss_example()
print(FAISSサンプルコード:これはFAISSの典型的な使い方です。)
print("重要な手順:インデックス作成 → トレーニング → ベクトル追加 → 検索。")
print()
print("FAISSでよく使われるインデックスタイプ:")
print(" - IndexFlatL2: 力任せ探索(正確だが遅い)")
print(" - IndexIVFFlat: IVFバケット分割探索")
print(" - IndexIVFPQ: IVF + PQ圧縮")
print(" - IndexHNSWFlat: HNSWグラフインデックス")
FAISSの特徴:
-
1. 非常に高速:C++実装で、極限まで最適化されています。
-
2. 機能が充実:ほぼすべての主要なANNアルゴリズムをサポート。
-
3. ローカル:ネットワーク不要、永続化なし(インデックスファイルを自分で保存する必要があります)。
適用シーン:オフラインのバッチ処理、サービスを構築したくない、データ量がそれほど大きくない。
Chroma:軽量でローカル優先
Chromaはシンプルで使いやすいベクトルデータベースで、設計目標は「AIアプリ開発をより速くすること」です。
例
# Chromaの基本的な使用デモ
# ============================================
# インストール:pip install chromadb
def chroma_example():
"""Chromaの使用例"""
import chromadb
from chromadb.utils import embedding_functions
# 1. クライアントの初期化(ローカルモード、データはディスクに保存)
client = chromadb.PersistentClient(path="./サンプル-chroma-db")
# 2. コレクションの作成または取得
collection = client.get_or_create_collection(
name="サンプル_docs",
metadata={"description": "菜鳥教程(サンプル)ドキュメントコレクション"}
)
# 3. ドキュメントの追加(Chromaがembeddingを自動処理)
# OpenAI、Cohereなどを使用でき、自分でベクトルを提供することもできます
documents = [
Pythonはインタプリタ型の高水準で汎用のなプログラミング言語です。,
"JavaScriptは軽量でインタプリタ型のプログラミング言語です。",
"ベクトルデータベースはベクトル埋め込みの保存と検索に使用されます。",
"RAG、すなわち検索拡張生成は、検索と生成を組み合わせた技術です。",
"HNSWは階層型スモールワールドグラフによる近似最近傍アルゴリズムです。"
]
metadatas = [
{"category": "programming", "language": "Python"},
{"category": "programming", "language": "JavaScript"},
{"category": "database", "topic": "vector"},
{"category": "ai", "topic": "rag"},
{"category": "algorithm", "topic": "hnsw"}
]
ids = ["doc1", "doc2", "doc3", "doc4", "doc5"]
# 追加(ここでは模擬ベクトルを使用、実際は埋め込みモデルを使うべき)
import numpy as np
np.random.seed(42)
embeddings = [np.random.randn(128).tolist() for _ in range(5)]
collection.add(
documents=documents,
metadatas=metadatas,
ids=ids,
embeddings=embeddings # 渡さない場合は、Chromaはデフォルトのembed関数を使用します
)
print(f"コレクションには {collection.count()} 個のドキュメントがあります")
# 4. クエリ
query_embedding = np.random.randn(128).tolist()
results = collection.query(
query_embeddings=[query_embedding],
n_results=3,
# メタデータフィルタを追加できます
# where={"category": "ai"}
)
print("\n検索結果:")
for i in range(len(results['ids'][0])):
print(f"ID: {results['ids'][0][i]}")
print(f"ドキュメント: {results['documents'])
print(f"距離: {results['distances'])
print("---")
return collection
# Chromaがインストールされている場合は、下のコメントを外して実行できます
# chroma_example()
print("Chromaサンプルコード:設計がシンプルで、そのまま使えます。")
print()
print("Chromaの特徴:")
print(" - シンプル:APIが使いやすく、数分で使い始められる")
print(" - ローカルファースト:ディスクに永続化でき、メモリ上でも動作可能")
print(" - 組み込みembedding:OpenAI、Cohere、Sentence-Transformersをサポート")
print(" - メタデータフィルタリング対応:クエリ時にメタデータを組み合わせて絞り込み可能")
Qdrant:本番グレードのオープンソース
QdrantはRustで書かれたベクトルデータベースで、性能が良く、機能も充実しています。
例
# Qdrantの基本的な使用デモ
# ============================================
# インストール:pip install qdrant-client
# サービスの起動:docker run -p 6333:6333 qdrant/qdrant
def qdrant_example():
"""Qdrantの使用例"""
from qdrant_client import QdrantClient
from qdrant_client.models import Distance, VectorParams, PointStruct, Filter, FieldCondition, MatchValue
# 1. クライアントへの接続
client = QdrantClient(host="localhost", port=6333)
# 2. コレクションの作成
client.recreate_collection(
collection_name="サンプル_collection",
vectors_config=VectorParams(
size=128,
distance=Distance.COSINE # または L2, DOT
),
# 任意:HNSWインデックスパラメータを設定
# hnsw_config=HnswConfig(m=16, ef_construct=100)
)
# 3. ポイントの追加
import numpy as np
np.random.seed(42)
points = [
PointStruct(
id=i,
vector=np.random.randn(128).tolist(),
payload={
"text": f"ドキュメント {i} の内容",
"category": "tech" if i % 2 == 0 else "life",
"author": f"author_{i % 3}"
}
)
for i in range(100)
]
client.upsert(
collection_name="サンプル_collection",
points=points
)
# 4. クエリ
query_vector = np.random.randn(128).tolist()
results = client.search(
collection_name="サンプル_collection",
query_vector=query_vector,
limit=5,
# フィルタを追加できます
# query_filter=Filter(
# must=[
# FieldCondition(key="category", match=MatchValue(value="tech"))
# ]
# )
)
print("検索結果:")
for result in results:
print(f"ID: {result.id}, スコア: {result.score:.4f}")
print(f"Payload: {result.payload}")
print("---")
return client
# Qdrantを起動している場合は、下のコメントを外して実行できます
# qdrant_example()
print("Qdrantサンプルコード:Rust実装で、機能が充実しています。")
print()
print("Qdrantの特徴:")
print(" - 高性能:Rust + HNSW")
print(" - 機能充実:フィルタリング、グループ化、集計、ページネーションをサポート")
print(" - デプロイ容易:Dockerでワンクリック起動")
print(" - シャーディング対応:水平スケーリング可能")
主要ベクトルデータベース比較表
| 製品 | タイプ | デプロイ | 特徴 | 適用シーン |
|---|---|---|---|---|
| FAISS | ローカルライブラリ | 无 | 非常に高速、機能充実、自分でメンテナンスが必要 | オフライン処理、サービスを構築したくない |
| Chroma | 軽量級 | ローカル/サーバー | シンプルで使いやすい、Python優先 | プロトタイプ開発、小規模プロジェクト |
| Qdrant | オープンソース | Docker/K8s | 性能が良い、機能充実、Rust | 本番環境、中規模 |
| Milvus | オープンソース | 分散 | エンタープライズ級、最も機能が充実 | 大規模な本番環境 |
| Weaviate | オープンソース | Docker/K8s | モジュール化、エコシステムが良好 | 機能を柔軟に組み合わせる必要がある |
| Pinecone | クラウドサービス | SaaS | 完全マネージド、オンデマンドで拡張 | 運用したくない、すぐにリリースしたい |
埋め込みモデルの選択
ベクトルデータベースは単なるインフラであり、効果を本当に決めるのは埋め込みモデルです。
主要埋め込みモデルの比較
| モデル | 次元 | 特徴 | 価格 |
|---|---|---|---|
| OpenAI text-embedding-3-small | 1536 | コストパフォーマンスが高い、総合品質が良い | $0.00002 / 1K tokens |
| OpenAI text-embedding-3-large | 3072 | 品質が最高、次元が大きい | $0.00013 / 1K tokens |
| Cohere Embed v3 | 1024 | 多言語サポートが良い | $0.0001 / 1K tokens |
| bge-large-zh-v1.5 | 1024 | 中国語に効果的、オープンソースで無料 | 無料 |
| bge-m3 | 1024 | 多言語、多機能 | 無料 |
| gte-large | 1024 | バランスの取れた選択肢、オープンソース | 無料 |
次元数 vs パフォーマンスのトレードオフ
次元が高いほど、通常は効果が良くなりますが、ただし:
-
1. ストレージが高くなる:3072次元は1536次元の2倍の領域を占有します。
-
2. 計算が遅くなる:距離計算量は次元に比例します。
-
3. インデックスが大きくなる:HNSW/IVFインデックスもより大きくなります。
提案:まずは低次元モデルで効果をテストし、不十分なら高次元に上げる。多くのシナリオでは、1536次元で十分すぎるほど良い。
ハイブリッド検索(Hybrid Search)
純粋なベクトル検索は「意味」しかマッチせず、「キーワード」にはマッチしないため、不十分な場合があります。
ハイブリッド検索 = ベクトル検索 + キーワード検索、そして結果を融合する。
BM25 スパース検索
BM25は従来の検索における古典的なアルゴリズムで、キーワードの一致度を評価します。
例
# BM25 キーワード検索デモ
# ============================================
import math
from typing import List, Dict, Set
class SimpleBM25:
"""簡易版 BM25 実装"""
def __init__(self, k1: float = 1.5, b: float = 0.75):
self.k1 = k1
self.b = b
self.documents: List[List[str]] = []
self.doc_lengths: List[int] = []
self.avg_doc_length: float = 0
self.term_freqs: List[Dict[str, int]] = []
self.doc_freq: Dict[str, int] = {}
self.num_docs: int = 0
def _tokenize(self, text: str) -> List[str]:
"""簡易トークン化(スペースと句読点で分割)"""
# 簡略化:小文字に変換し、英数字以外で分割
import re
return [t.lower() for t in re.findall(r'\w+', text)]
def fit(self, documents: List[str]):
"""インデックスを構築"""
self.documents = []
self.doc_lengths = []
self.term_freqs = []
self.doc_freq = {}
self.num_docs = len(documents)
for doc in documents:
tokens = self._tokenize(doc)
self.documents.append(tokens)
self.doc_lengths.append(len(tokens))
# 語頻度を集計
tf: Dict[str, int] = {}
for token in tokens:
tf[token] = tf.get(token, 0) + 1
self.term_freqs.append(tf)
# 文書頻度を更新
for token in tf.keys():
self.doc_freq[token] = self.doc_freq.get(token, 0) + 1
self.avg_doc_length = sum(self.doc_lengths) / self.num_docs
def score(self, query: str) -> List[float]:
"""各ドキュメントのBM25スコアを計算"""
query_tokens = self._tokenize(query)
scores = [0.0] * self.num_docs
for token in query_tokens:
if token not in self.doc_freq:
continue
# IDF計算
df = self.doc_freq[token]
idf = math.log(1 + (self.num_docs - df + 0.5) / (df + 0.5))
# 各ドキュメントのスコアを計算
for doc_idx in range(self.num_docs):
doc_len = self.doc_lengths[doc_idx]
tf = self.term_freqs[doc_idx].get(token, 0)
# BM25の核心的な式
numerator = tf * (self.k1 + 1)
denominator = tf + self.k1 * (1 - self.b + self.b * doc_len / self.avg_doc_length)
scores[doc_idx] += idf * numerator / denominator
return scores
def search(self, query: str, top_k: int = 5) -> List[Dict]:
"""Top Kを検索"""
scores = self.score(query)
# ソート
results = [
{"doc_idx": i, "score": s}
for i, s in enumerate(scores)
]
results.sort(key=lambda x: x["score"], reverse=True)
return results[:top_k]
# テスト
documents = [
"Pythonはプログラミング言語で、簡単に学べます。",
"JavaScriptはWeb開発に使われ、フロントエンドとバックエンドの両方で使えます。",
"ベクトルデータベースはベクトル埋め込みの保存と検索に使われます。",
"データベースには多くの種類があります。例えば、リレーショナルデータベース、NoSQLデータベースなどです。",
"HNSWは近似最近傍探索アルゴリズムです。"
]
bm25 = SimpleBM25()
bm25.fit(documents)
# 検索
query = "データベース"
results = bm25.search(query, top_k=5)
print(f"クエリ:\"{query}\"")
print("BM25検索結果:")
for r in results:
print(f" ドキュメント {r['doc_idx']}: {documents[r['doc_idx']]}")
print(f" スコア = {r['score']:.4f}")
# 出力は次のようになります:
# クエリ:"データベース"
# BM25検索結果:
# ドキュメント 2: ベクトルデータベースはベクトル埋め込みの保存と検索に使われます。
# スコア = 0.7134
# ドキュメント 3: データベースには多くの種類があります。例えば、リレーショナルデータベース、NoSQLデータベースなどです。
# スコア = 0.6148
# ...
RRF:逆順位融合(Reciprocal Rank Fusion)
RRF(Reciprocal Rank Fusion)は、複数の検索結果を融合するシンプルで効果的な方法です。
式:score = 1 / (k + rank)、ここでkは通常60です。
例
# RRF融合デモ
# ============================================
from typing import List, Dict, Any
def rrf_fuse(
result_lists: List[List[Any]],
k: int = 60
) -> Dict[Any, float]:
"""
RRF融合:各結果リストについて、1/(k + rank) でスコアを付けて合算する。
result_lists: ソート済みの複数の結果リスト
"""
scores: Dict[Any, float] = {}
for results in result_lists:
for rank, item in enumerate(results):
score = 1.0 / (k + rank)
scores[item] = scores.get(item, 0) + score
return scores
# 例:ベクトル検索結果 と BM25検索結果
vector_results = ["doc3", "doc1", "doc4", "doc2", "doc5"] # ベクトル検索は doc3 が最も関連性が高いと見なす
bm25_results = ["doc2", "doc4", "doc3", "doc5", "doc1"] # BM25は doc2 が最も関連性が高いと見なす
# RRF融合
fused = rrf_fuse([vector_results, bm25_results])
# ソート
final_rank = sorted(fused.items(), key=lambda x: x[1], reverse=True)
print("ベクトル検索結果:", vector_results)
print("BM25検索結果:", bm25_results)
print()
print("RRF融合後の最終ランキング:")
for doc, score in final_rank:
print(f" {doc}: {score:.6f}")
# 出力:
# ベクトル検索結果: ['doc3', 'doc1', 'doc4', 'doc2', 'doc5']
# BM25検索結果: ['doc2', 'doc4', 'doc3', 'doc5', 'doc1']
#
# RRF融合後の最終ランキング:
# doc3: 0.032787
# doc2: 0.032787
# doc4: 0.032520
# doc1: 0.016393
# doc5: 0.016393
融合重みのチューニング
RRF以外にも、重み付き線形融合も使えます:
final_score = α * vector_score + (1 - α) * bm25_score
αはベクトル検索の重みであり、実際のデータに基づいて調整する必要があります。
Re-ranking(再ランク付け)
ハイブリッド検索はさらに改善できます。まず候補を一括でリコールし、より強力なモデルで再ランキングします。
Cross-Encoder の原理
Bi-Encoder(リコール用):queryとdocumentをそれぞれエンコードし、類似度で比較する。
Cross-Encoder(再ランキング用):queryとdocumentを連結してモデルに入力し、関連性スコアを直接出力する。
Cross-Encoderはより正確ですが遅いため、上位50〜100件の候補だけを再ランキングするのに適しています。
例
# Re-ranking プロセスのデモ
# ============================================
def reranking_pipeline_example():
"""
2段階検索プロセス:
1. 粗いリコール:ベクトル検索でTop 100を高速に見つける
2. 精密なランキング:Cross-EncoderでTop 100を再ランキングする
"""
print("2段階検索プロセス:")
print()
print("ステージ 1: 粗いリコール(ベクトル検索)")
print(" - 目標:高速、低遅延")
print(" - 方法:HNSW/IVFベクトル検索")
print(" - 出力:Top 100の候補")
print()
print("ステージ 2: 精密なランキング(Cross-Encoder)")
print(" - 目標:正確、高品質")
print(" - 方法:Cross-Encoderでペアごとにスコアリング")
print(" - 出力:最終Top 10")
print()
print(典型的な設定:)
print(" - リコール段階:HNSW efSearch = 128、100件をリコール")
print(" - 再ランキング段階:bge-reranker または Cohere Rerankを使用")
print()
print("なぜ最初からCross-Encoderですべてを検索しないのか?")
print(- Cross-Encoderは遅すぎて、100万件を検索するのは現実のではありません)
print(" - ベクトル検索で100万件は高速、Cross-Encoderで100件の再ランキングも高速")
# Cohere Rerank API の例(擬似コード)
def cohere_rerank_example():
"""
Cohere Rerank APIの使用例
"""
print(Cohere Rerank APIの典型的な使い方:)
print()
print('''
import cohere
co = cohere.Client(api_key="your-api-key")
query = "ベクトルデータベースとは何ですか?"
documents = [
"ドキュメント1の内容...",
"ドキュメント2の内容...",
... # 上位100件の候補
]
results = co.rerank(
query=query,
documents=documents,
top_n=10,
model="rerank-english-v3.0"
)
for r in results:
print(r.index, r.relevance_score, documents[r.index])
''')
reranking_pipeline_example()
パフォーマンスとレイテンシのトレードオフ
| 方式 | 品質 | 速度 | コスト | 適用シナリオ |
|---|---|---|---|---|
| 純ベクトル検索 | 中 | 極めて高速 | 低 | 速度要求が非常に高い場合 |
| ハイブリッド検索 | 中高 | 快 | 中 | バランスの取れた選択 |
| ベクトル + 再ランキング | 高 | 中 | 中高 | 品質重視 |
| ハイブリッド + 再ランキング | 最高 | 中〜低速 | 高 | 品質優先 |
本番環境での最適化
Demoから本番まで、注意すべき詳細がたくさんあります。
インデックスシャーディング戦略
データ量が単一マシンの容量を超えた場合は、シャーディングが必要です:
-
1. IDによるシャーディング:シンプルですが、クエリ時にはすべてのシャードを検索する必要があります。
-
2. ベクトルクラスタリングによるシャーディング:クエリ時に関連するいくつかのシャードだけを検索します。
メタデータフィルタリング
本番環境では、ほとんどの場合メタデータフィルタリングを組み合わせる必要があります。
2つの戦略:
-
1. プリフィルタ(事前フィルタリング):最初にメタデータでフィルタリングし、次にベクトル検索を実行します。
-
2. ポストフィルタ(事後フィルタリング):最初にベクトル検索を実行し、次にメタデータでフィルタリングします。
選択の原則:フィルタリング後に残るベクトルが多い場合はプリフィルタを使用し、残りが少ない場合はポストフィルタを使用します。
増分更新
多くのベクトルデータベースはインクリメンタル追加をサポートしていますが、注意点があります:
-
1. バッチ追加:一度にバッチで追加し、1件ずつ追加しないでください。
-
2. インデックス再構築:一部のインデックス(IVFなど)は定期的な再トレーニングが必要です。
-
3. バージョン管理:旧バージョンのインデックスを保持し、更新時にロールバックできます。
監視メトリクス
本番環境では以下を監視する必要があります:
-
1. クエリレイテンシ:P50、P95、P99。
-
2. リコール率:Top K結果の品質を定期的に確認します。
-
3. インデックスサイズ:メモリ/ディスク使用量。
-
4. QPS:1秒あたりのクエリ数。