In Zookeeper wird hauptsächlich auf das ZAB-Protokoll zurückgegriffen, um verteilte Datenkonsistenz zu erreichen.
Das ZAB-Protokoll ist in zwei Teile unterteilt:
- Nachrichten-Broadcast
- Crash-Recovery
Nachrichten-Broadcast
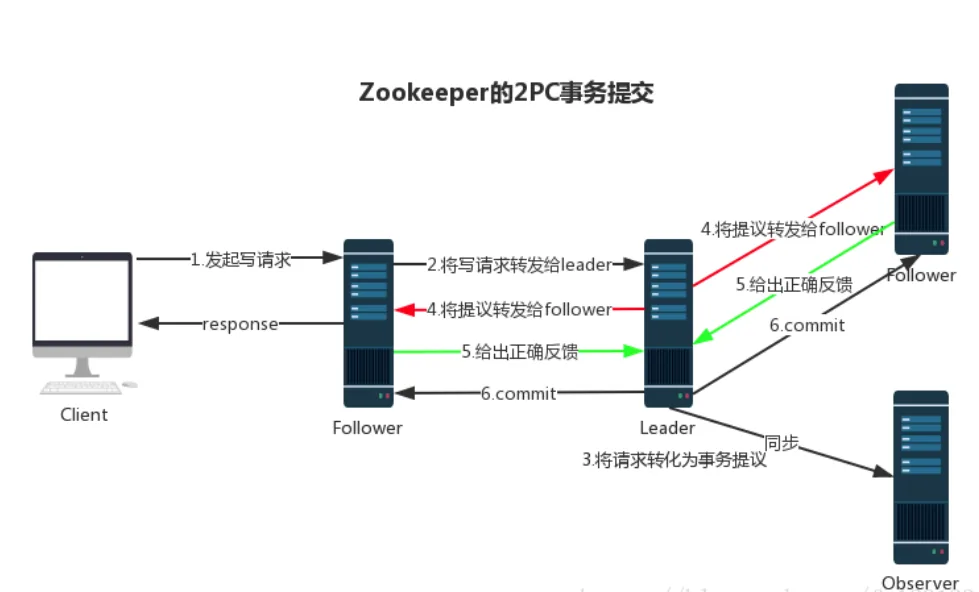
Zookeeper verwendet einen einzelnen Hauptprozess, den Leader, um alle Transaktionsanfragen von Clients zu empfangen und zu verarbeiten, und verwendet das atomare Broadcast-Protokoll des ZAB-Protokolls, um Transaktionsanfragen als Proposal-Vorschläge an alle Follower-Knoten zu senden. Wenn mehr als die Hälfte der Follower-Server im Cluster korrektes ACK-Feedback liefern, sendet der Leader erneut eine Commit-Nachricht an alle Follower-Server, um diesen Vorschlag zu committen. Dieser Prozess kann als 2PC-Transaktions-Commit abgekürzt werden. Der gesamte Prozess ist in der folgenden Abbildung dargestellt. Beachten Sie, dass Observer-Knoten nur für die Synchronisierung der Leader-Daten verantwortlich sind und nicht am 2PC-Datensynchronisierungsprozess teilnehmen.
Crash-Recovery
Unter normalen Umständen funktioniert der Nachrichten-Broadcast-Modus gut. Sobald jedoch der Leader-Server abstürzt oder der Leader-Server aufgrund von Netzwerkproblemen die Kommunikation mit mehr als der Hälfte der Follower verliert, gerät es in den Crash-Recovery-Modus, und ein neuer Leader-Server muss gewählt werden. Während dieses Prozesses können zwei potenzielle Gefahren für Dateninkonsistenzen auftreten, die durch die Eigenschaften des ZAB-Protokolls vermieden werden müssen.
- 1. Der Leader-Server stürzt unmittelbar nach dem Senden der Commit-Nachricht ab
- 2. Der Leader-Server stürzt unmittelbar ab, nachdem er gerade erst einen Proposal-Vorschlag vorgelegt hat
Der Wiederherstellungsmodus des ZAB-Protokolls verwendet die folgenden Strategien:
- 1. Den Knoten mit der größten zxid als neuen Leader wählen
- 2. Der neue Leader verarbeitet die nicht committeten Nachrichten im Transaktionsprotokoll.
Das nächste Kapitel erklärt den Leader-Wahlprozess im Detail.