PyTorch: Faltungsnetzwerk
PyTorch Convolutional Neural Network (CNN) ist eine Klasse von Deep-Learning-Modellen, die speziell dafür entwickelt wurde, Daten mit einer gitterartigen Topologie (wie Bilder) zu verarbeiten.
CNN ist eine Kerntechnologie für Aufgaben des Computer Vision (wie Bildklassifizierung, Objekterkennung und Segmentierung).
Das folgende Diagramm zeigt die Struktur und den Arbeitsablauf eines typischen Convolutional Neural Network (CNN), das für Bilderkennungsaufgaben verwendet wird.
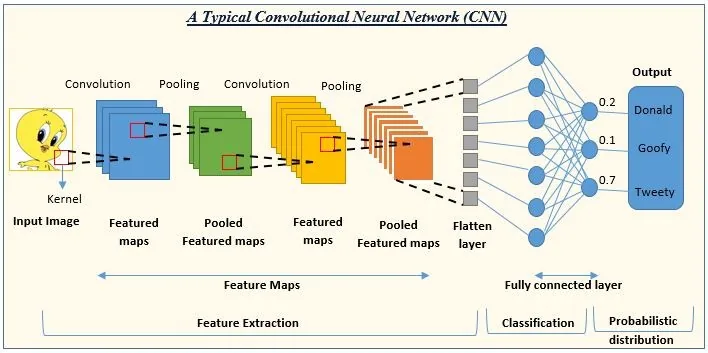
In der Abbildung gibt die CNN-Ausgabeschicht Wahrscheinlichkeiten für drei Klassen aus: Donald (0.2), Goofy (0.1) und Tweety (0.7), was anzeigt, dass das Netzwerk annimmt, dass das Eingabebild höchstwahrscheinlich Tweety ist.
Das Folgende ist eine kurze Beschreibung der einzelnen Teile:
-
Eingabebild: Die vom Netzwerk empfangenen Rohbilddaten.
-
Faltung: Ein Kernel gleitet über das Eingabebild, um Merkmale zu extrahieren und Feature-Maps zu erzeugen.
-
Pooling: Wird normalerweise nach der Faltungsschicht angewendet; Max-Pooling oder Average-Pooling reduziert die Größe der Feature-Maps, während wichtige Merkmale erhalten bleiben, und erzeugt gepoolte Feature-Maps.
-
Merkmalsextraktion: Die Kombination mehrerer Faltungs- und Pooling-Schichten extrahiert schrittweise hochrangige Merkmale aus dem Bild.
-
Flatten-Schicht: Wandelt die mehrdimensionalen Feature-Maps in einen eindimensionalen Vektor um, der in die vollständig verbundene Schicht eingegeben wird.
-
Vollständig verbundene Schicht: Ähnlich wie traditionelle Schichten neuronaler Netze bildet sie die extrahierten Merkmale auf Ausgabeklassen ab.
-
Klassifikation: Die Ausgabeschicht des Netzwerks führt die Klassifikation basierend auf der Ausgabe der vollständig verbundenen Schicht durch.
-
Wahrscheinlichkeitsverteilung: Die Ausgabeschicht gibt die Wahrscheinlichkeit für jede Klasse an und repräsentiert damit die Wahrscheinlichkeit, dass das Eingabebild zu jeder Klasse gehört.
Grundstruktur von Convolutional Neural Networks
1. Eingabeschicht
Es empfängt die Rohbilddaten. Ein Bild wird typischerweise als dreidimensionales Array dargestellt, wobei zwei Dimensionen die Breite und Höhe des Bildes repräsentieren und die dritte Dimension die Farbkanäle darstellt (zum Beispiel hat ein RGB-Bild drei Kanäle).
2. Faltungsschicht
Sie verwendet Faltungskerne, um lokale Merkmale wie Kanten und Texturen zu extrahieren.
Formel:
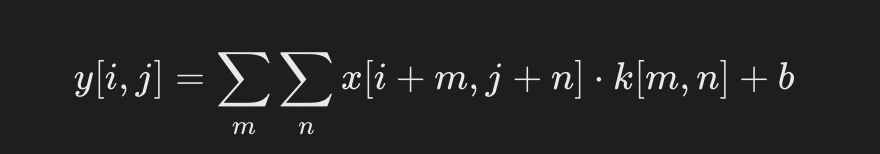
- x: Eingabebild.
- k: Faltungskern (Gewichtsmatrix).
- b: Bias.
Eine Gruppe lernbarer Filter (oder Faltungskerne) wird über Faltungsoperationen auf das Eingangsbild angewendet, um lokale Merkmale zu extrahieren.
Jeder Filter gleitet über das Eingangsbild und erzeugt eine Merkmalskarte, die die Aktivierung des Filters an verschiedenen Positionen repräsentiert.
Eine Faltungsschicht kann mehrere Filter haben; jeder Filter erzeugt eine Merkmalskarte, und alle Merkmalskarten bilden eine Menge von Merkmalskarten.
3. Aktivierungsfunktion
Eine nichtlineare Aktivierungsfunktion wie ReLU (Rectified Linear Unit) wird üblicherweise nach der Faltungsschicht angewendet, um Nichtlinearität einzuführen und es dem Netzwerk zu ermöglichen, komplexere Muster zu lernen.
Die ReLU-Funktion ist definiert als:f(x)=max(0,x), das heißt, wenn die Eingabe kleiner als 0 ist, wird 0 ausgegeben; andernfalls wird der Eingabewert ausgegeben.
4. Pooling-Schicht
- Sie wird verwendet, um die räumlichen Dimensionen von Merkmalskarten zu reduzieren, wodurch die Rechenkosten und die Anzahl der Parameter verringert werden, während die wichtigsten Merkmalsinformationen erhalten bleiben.
- Die häufigsten Pooling-Operationen sind Max-Pooling und Average-Pooling.
- Max-Pooling wählt den Maximalwert im Bereich aus, während Average-Pooling den Durchschnittswert im Bereich berechnet.
5. Normalisierungsschicht (optional)
- Zum Beispiel Local Response Normalization (LRN) oder Batch Normalization.
- Diese Schichten helfen, den Trainingsprozess zu beschleunigen und die Modellstabilität zu verbessern.
6. Vollständig verbundene Schicht
- Am Ende eines CNN werden die von früheren Schichten extrahierten Feature-Maps zu einem eindimensionalen Vektor abgeflacht und dann in die vollständig verbundene Schicht eingespeist.
- Jedes Neuron in der vollständig verbundenen Schicht ist mit allen Neuronen der vorherigen Schicht verbunden und kombiniert Merkmale für die endgültige Klassifizierung oder Regression.
7. Ausgabeschicht
Je nach Aufgabe kann die Ausgabeschicht unterschiedliche Formen annehmen.
Für Klassifizierungsaufgaben wird typischerweise die Softmax-Funktion verwendet, um die Ausgabe in eine Wahrscheinlichkeitsverteilung umzuwandeln, die die Wahrscheinlichkeit angibt, dass die Eingabe zu jeder Klasse gehört.
8. Verlustfunktion
Sie wird verwendet, um die Differenz zwischen den Vorhersagen des Modells und den wahren Labels zu messen.
Gängige Verlustfunktionen sind Kreuzentropieverlust für Multi-Klassen-Klassifizierungsaufgaben und der mittlere quadratische Fehler (MSE) für Regressionsaufgaben.
9. Optimierer
Er wird verwendet, um die Gewichte des Netzwerks basierend auf dem Gradienten der Verlustfunktion zu aktualisieren. Gängige Optimierer sind stochastischer Gradientenabstieg (SGD), Adam, RMSprop usw.
10. Regularisierung (optional)
Es umfasst Techniken wie Dropout und L1/L2-Regularisierung, um Overfitting des Modells zu verhindern.
Diese Schichten können gestapelt werden, um tiefere Netzwerkstrukturen zu bilden und die Lernfähigkeit des Modells zu verbessern.
Die Tiefe und Komplexität eines CNN können je nach den Anforderungen der Aufgabe angepasst werden.
PyTorch-Implementierung eines CNN-Beispiels
Das folgende Beispiel zeigt, wie man mit PyTorch ein einfaches CNN-Modell zur Ziffernklassifikation auf dem MNIST-Datensatz erstellt.
Hauptschritte:
- Datenladen und Vorverarbeitung: Verwenden Sie
torchvisionLaden und verarbeiten Sie die MNIST-Daten vor. - Modellkonstruktion: Definieren Sie Faltungsschichten, Pooling-Schichten und vollständig verbundene Schichten.
- Training: Trainieren Sie das Modell mit einer Verlustfunktion und einem Optimierer.
- Evaluierung: Berechnen Sie die Genauigkeit des Modells auf dem Testsatz.
- Visualisierung: Einige Testbeispiele und ihre Vorhersageergebnisse anzeigen.
1. Erforderliche Bibliotheken importieren
import torch
import torch.nn as nn
import torch.nn.functional as F
import torch.optim as optim
2. Daten laden
Verwenden Sie den von torchvision bereitgestellten MNIST-Datensatz, um die Daten zu laden und vorzuverarbeiten.
Beispiel
transforms.ToTensor(), # In Tensor umwandeln
transforms.Normalize((0.5,), (0.5,)) # Auf [-1, 1] normalisieren
])
# MNIST-Datensatz laden
train_dataset = datasets.MNIST(root='./data', train=True, transform=transform, download=True)
test_dataset = datasets.MNIST(root='./data', train=False, transform=transform, download=True)
train_loader = torch.utils.data.DataLoader(dataset=train_dataset, batch_size=64, shuffle=True)
test_loader = torch.utils.data.DataLoader(dataset=test_dataset, batch_size=64, shuffle=False)
3. CNN-Modell definieren
Verwenden Sienn.Module, um ein CNN zu erstellen.Beispiel
def __init__(self):
super(SimpleCNN, self).__init__()
# Faltungsschicht definieren: 1 Eingabekanal, 32 Ausgabekanäle, Kernel-Größe 3x3
self.conv1 = nn.Conv2d(1, 32, kernel_size=3, stride=1, padding=1)
# Faltungsschicht definieren: 32 Eingabekanäle, 64 Ausgabekanäle
self.conv2 = nn.Conv2d(32, 64, kernel_size=3, stride=1, padding=1)
# Vollständig verbundene Schicht definieren
self.fc1 = nn.Linear(64 * 7 * 7, 128) # Eingabegröße = Feature-Map-Größe * Anzahl der Kanäle
self.fc2 = nn.Linear(128, 10) # 10 Klassen
def forward(self, x):
x = F.relu(self.conv1(x)) # Erste Faltungsschicht + ReLU
x = F.max_pool2d(x, 2) # Max-Pooling
x = F.relu(self.conv2(x)) # Zweite Faltungsschicht + ReLU
x = F.max_pool2d(x, 2) # Max-Pooling
x = x.view(-1, 64 * 7 * 7) # Flatten-Operation
x = F.relu(self.fc1(x)) # Vollständig verbundene Schicht + ReLU
x = self.fc2(x) # Ausgabe der vollständig verbundenen Schicht
return x
# Modellinstanz erstellen
model = SimpleCNN()
4. Verlustfunktion und Optimierer definieren
Verwenden Sie Kreuzentropieverlust und einen Optimierer für stochastischen Gradientenabstieg.
criterion = nn.CrossEntropyLoss()  # 多分类交叉熵损失
optimizer = optim.SGD(model.parameters(), lr=0.01, momentum=0.9)  # 学习率和动量
5. Das Modell trainieren
Trainieren Sie das Modell über 5 Epochen und geben Sie den Trainingsverlust nach jeder Epoche aus.
Beispiel
model.train() # Auf Trainingsmodus setzen
for epoch in range(num_epochs):
total_loss = 0
for images, labels in train_loader:
# Vorwärtsdurchlauf
outputs = model(images)
loss = criterion(outputs, labels)
# Rückwärtsdurchlauf
optimizer.zero_grad()
loss.backward()
optimizer.step()
total_loss += loss.item()
print(f"Epoche [{epoch+1}/{num_epochs}], Verlust: {total_loss / len(train_loader):.4f}")
6. Das Modell testen
Bewerten Sie die Genauigkeit des Modells auf dem Testset.
Beispiel
correct = 0
total = 0
with torch.no_grad(): # Keine Gradientenberechnung während der Evaluierung nötig
for images, labels in test_loader:
outputs = model(images)
_, predicted = torch.max(outputs, 1) # Klassen vorhersagen
total += labels.size(0)
correct += (predicted == labels).sum().item()
accuracy = 100 * correct / total
print(f"Testgenauigkeit: {accuracy:.2f}%")
7. Vollständiger Code
Der vollständige Code sieht wie folgt aus:
Beispiel
import torch.nn as nn
import torch.nn.functional as F
import torch.optim as optim
from torchvision import datasets, transforms
# 1. Datenladen und Vorverarbeitung
transform = transforms.Compose([
transforms.ToTensor(), # In Tensor umwandeln
transforms.Normalize((0.5,), (0.5,)) # Auf [-1, 1] normalisieren
])
# MNIST-Datensatz laden
train_dataset = datasets.MNIST(root='./data', train=True, transform=transform, download=True)
test_dataset = datasets.MNIST(root='./data', train=False, transform=transform, download=True)
train_loader = torch.utils.data.DataLoader(dataset=train_dataset, batch_size=64, shuffle=True)
test_loader = torch.utils.data.DataLoader(dataset=test_dataset, batch_size=64, shuffle=False)
# 2. CNN-Modell definieren
class SimpleCNN(nn.Module):
def __init__(self):
super(SimpleCNN, self).__init__()
# Faltungsschichten definieren
self.conv1 = nn.Conv2d(1, 32, kernel_size=3, stride=1, padding=1) # 1 Eingangskanal, 32 Ausgangskanäle
self.conv2 = nn.Conv2d(32, 64, kernel_size=3, stride=1, padding=1) # 32 Eingangskanäle, 64 Ausgangskanäle
# Vollständig verbundene Schichten definieren
self.fc1 = nn.Linear(64 * 7 * 7, 128) # Abflachen und in vollständig verbundene Schicht einspeisen
self.fc2 = nn.Linear(128, 10) # 10 Klassen
def forward(self, x):
x = F.relu(self.conv1(x)) # Erste Faltung + ReLU
x = F.max_pool2d(x, 2) # Max-Pooling
x = F.relu(self.conv2(x)) # Zweite Faltung + ReLU
x = F.max_pool2d(x, 2) # Max-Pooling
x = x.view(-1, 64 * 7 * 7) # Abflachen
x = F.relu(self.fc1(x)) # Vollständig verbundene Schicht + ReLU
x = self.fc2(x) # Letzte Ausgabeschicht
return x
# Modellinstanz erstellen
model = SimpleCNN()
# 3. Verlustfunktion und Optimierer definieren
criterion = nn.CrossEntropyLoss() # Multi-Klassen-Cross-Entropy-Verlust
optimizer = optim.SGD(model.parameters(), lr=0.01, momentum=0.9)
# 4. Modelltraining
num_epochs = 5
model.train() # Modell in den Trainingsmodus versetzen
for epoch in range(num_epochs):
total_loss = 0
for images, labels in train_loader:
outputs = model(images) # Vorwärtsdurchlauf
loss = criterion(outputs, labels) # Verlust berechnen
optimizer.zero_grad() # Gradienten zurücksetzen
loss.backward() # Rückwärtsdurchlauf
optimizer.step() # Parameter aktualisieren
total_loss += loss.item()
print(f"Epoche [{epoch+1}/{num_epochs}], Verlust: {total_loss / len(train_loader):.4f}")
# 5. Modelltest
model.eval() # Modell in den Evaluierungsmodus versetzen
correct = 0
total = 0
with torch.no_grad(): # Gradientenberechnung deaktivieren
for images, labels in test_loader:
outputs = model(images)
_, predicted = torch.max(outputs, 1)
total += labels.size(0)
correct += (predicted == labels).sum().item()
accuracy = 100 * correct / total
print(f"Testgenauigkeit: {accuracy:.2f}%")
Erklärung der Ausführungsergebnisse
1. Ausgabe des Trainingsverlusts
Der Code gibt nach jeder Epoche einen durchschnittlichen Verlust aus, zum Beispiel:
Epoch [1/5], Loss: 0.2325
Epoch [2/5], Loss: 0.0526
Epoch [3/5], Loss: 0.0366
Epoch [4/5], Loss: 0.0273
Epoch [5/5], Loss: 0.0221
Erklärung:Der allmähliche Rückgang des Verlusts zeigt an, dass das Modell Schritt für Schritt konvergiert.
2. Genauigkeit auf dem Testset
Der Code gibt die endgültige Klassifizierungsgenauigkeit auf dem Testset aus, zum Beispiel:
Test Accuracy: 98.96%
Erklärung:Das Modell erreicht eine Klassifizierungsgenauigkeit von 98.96% auf dem MNIST-Testset, was ein gutes Ergebnis für ein einfaches CNN-Modell ist.
7. Ergebnisse visualisieren
Wir können einige Beispiele und ihre Vorhersageergebnisse in den Testdaten visualisieren.
Beispiel
import torch.nn as nn
import torch.nn.functional as F
import torch.optim as optim
from torchvision import datasets, transforms
import matplotlib.pyplot as plt
# 1. Datenladen und Vorverarbeitung
transform = transforms.Compose([
transforms.ToTensor(), # In Tensor umwandeln
transforms.Normalize((0.5,), (0.5,)) # Auf [-1, 1] normalisieren
])
# MNIST-Datensatz laden
train_dataset = datasets.MNIST(root='./data', train=True, transform=transform, download=True)
test_dataset = datasets.MNIST(root='./data', train=False, transform=transform, download=True)
train_loader = torch.utils.data.DataLoader(dataset=train_dataset, batch_size=64, shuffle=True)
test_loader = torch.utils.data.DataLoader(dataset=test_dataset, batch_size=64, shuffle=False)
# 2. CNN-Modell definieren
class SimpleCNN(nn.Module):
def __init__(self):
super(SimpleCNN, self).__init__()
# Faltungsschichten definieren
self.conv1 = nn.Conv2d(1, 32, kernel_size=3, stride=1, padding=1) # 1 Eingangskanal, 32 Ausgangskanäle
self.conv2 = nn.Conv2d(32, 64, kernel_size=3, stride=1, padding=1) # 32 Eingangskanäle, 64 Ausgangskanäle
# Vollständig verbundene Schichten definieren
self.fc1 = nn.Linear(64 * 7 * 7, 128) # Abflachen und in vollständig verbundene Schicht einspeisen
self.fc2 = nn.Linear(128, 10) # 10 Klassen
def forward(self, x):
x = F.relu(self.conv1(x)) # Erste Faltung + ReLU
x = F.max_pool2d(x, 2) # Max-Pooling
x = F.relu(self.conv2(x)) # Zweite Faltung + ReLU
x = F.max_pool2d(x, 2) # Max-Pooling
x = x.view(-1, 64 * 7 * 7) # Abflachen
x = F.relu(self.fc1(x)) # Vollständig verbundene Schicht + ReLU
x = self.fc2(x) # Letzte Ausgabeschicht
return x
# Modellinstanz erstellen
model = SimpleCNN()
# 3. Verlustfunktion und Optimierer definieren
criterion = nn.CrossEntropyLoss() # Multi-Klassen-Cross-Entropy-Verlust
optimizer = optim.SGD(model.parameters(), lr=0.01, momentum=0.9)
# 4. Modelltraining
num_epochs = 5
model.train() # Modell in den Trainingsmodus versetzen
for epoch in range(num_epochs):
total_loss = 0
for images, labels in train_loader:
outputs = model(images) # Vorwärtsdurchlauf
loss = criterion(outputs, labels) # Verlust berechnen
optimizer.zero_grad() # Gradienten zurücksetzen
loss.backward() # Rückwärtsdurchlauf
optimizer.step() # Parameter aktualisieren
total_loss += loss.item()
print(f"Epoche [{epoch+1}/{num_epochs}], Verlust: {total_loss / len(train_loader):.4f}")
# 5. Modelltest
model.eval() # Modell in den Evaluierungsmodus versetzen
correct = 0
total = 0
with torch.no_grad(): # Gradientenberechnung deaktivieren
for images, labels in test_loader:
outputs = model(images)
_, predicted = torch.max(outputs, 1)
total += labels.size(0)
correct += (predicted == labels).sum().item()
accuracy = 100 * correct / total
print(f"Testgenauigkeit: {accuracy:.2f}%")
# 6. Testergebnisse visualisieren
dataiter = iter(test_loader)
images, labels = next(dataiter)
outputs = model(images)
_, predictions = torch.max(outputs, 1)
fig, axes = plt.subplots(1, 6, figsize=(12, 4))
for i in range(6):
axes[i].imshow(images[i][0], cmap='gray')
axes[i].set_title(f"Label: {labels[i]}\nVorhersage: {predictions[i]}")
Achsen[i].Achse('off')
plt.show()
Die Visualisierungsergebnisse zeigen die tatsächlichen Labels und vorhergesagten Werte von 6 Testbeispielen, zum Beispiel:
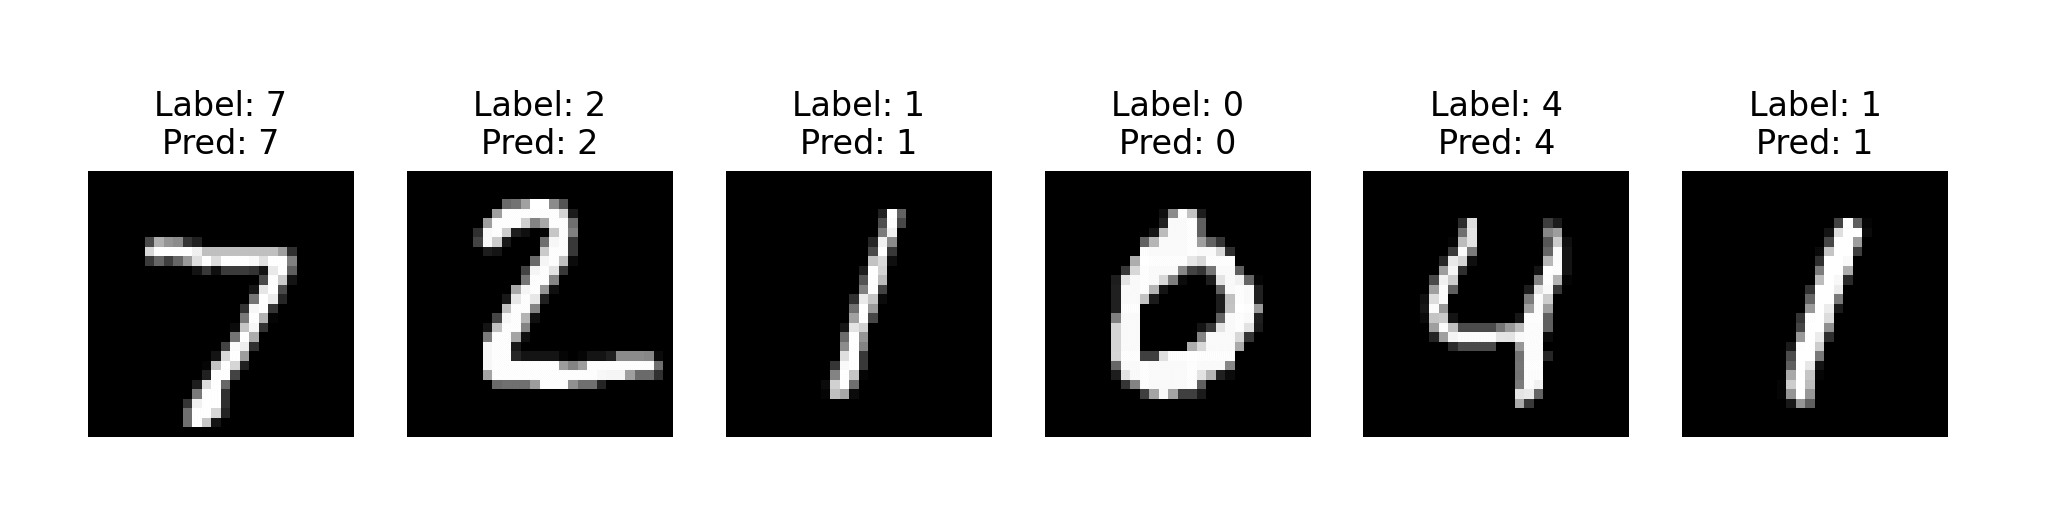
Die obere linke Ecke des Bildes ist die handschriftliche Ziffer.
Der Titelbereich zeigt den vorhergesagten Wert des Modells und das wahre Label.
Hinweis: Einige häufige Fehler
Beim Herunterladen des MNIST-Datensatzes schlägt der Download aufgrund eines Fehlers bei der SSL-Zertifikatsüberprüfung fehl.
Downloading http://yann.lecun.com/exdb/mnist/train-images-idx3-ubyte.gz
Failed to download (trying next):
<urlopen error [SSL: CERTIFICATE_VERIFY_FAILED] certificate verify failed: unable to get local issuer certificate (_ssl.c:1129)>
...
Lösungen
Öffnen Sie ein Terminal und führen Sie den folgenden Befehl aus, um das SSL-Zertifikat zu installieren/zu aktualisieren:
/Applications/Python\ 3.x/Install\ Certificates.command
Ersetzen Sie 3.x durch die Python-Version, die Sie tatsächlich installiert haben.
Nachdem Sie diesen Befehl ausgeführt haben, führen Sie Ihren Python-Code erneut aus, und er sollte den MNIST-Datensatz erfolgreich herunterladen können.
Weitere Erweiterungen