PyTorch-Grundlagen für neuronale Netze
Ein neuronales Netz ist ein Berechnungsmodell, das die Art und Weise nachahmt, wie das menschliche Gehirn Informationen verarbeitet. Es besteht aus vielen miteinander verbundenen Knoten (Neuronen), die in Schichten angeordnet sind.
Die Stärke neuronaler Netze liegt in ihrer Fähigkeit, automatisch komplexe Muster und Merkmale aus großen Datenmengen zu lernen, ohne die Notwendigkeit manuell entworfener Merkmalsextraktoren.
Mit der Entwicklung des Deep Learning sind neuronale Netzwerke zu einer Schlüsseltechnologie für die Lösung vieler komplexer Probleme geworden.
Neuron
Ein Neuron ist die Grundeinheit eines neuronalen Netzwerks. Es empfängt Eingangssignale, berechnet eine gewichtete Summe, addiert einen Bias und leitet das Ergebnis dann durch eine Aktivierungsfunktion, um eine Ausgabe zu erzeugen.
Die Gewichte und Bias-Werte eines Neurons sind die Parameter, die während des Lernprozesses des Netzwerks angepasst werden müssen.
Eingabe und Ausgabe:
- Eingabe: Die Eingabe ist der Ausgangspunkt des Netzwerks und kann Merkmalsdaten wie Bildpixelwerte oder Textwortvektoren sein.
- Ausgabe: Die Ausgabe ist der Endpunkt des Netzwerks und stellt das Vorhersageergebnis des Modells dar, wie z. B. das Klassenlabel in einer Klassifikationsaufgabe.
Ein Neuron empfängt mehrere Eingaben (z. B. x1, x2, ..., xn). Wenn die gewichtete Summe der Eingaben größer als der Aktivierungsschwellenwert (Aktivierungspotenzial) ist, erzeugt es eine binäre Ausgabe.
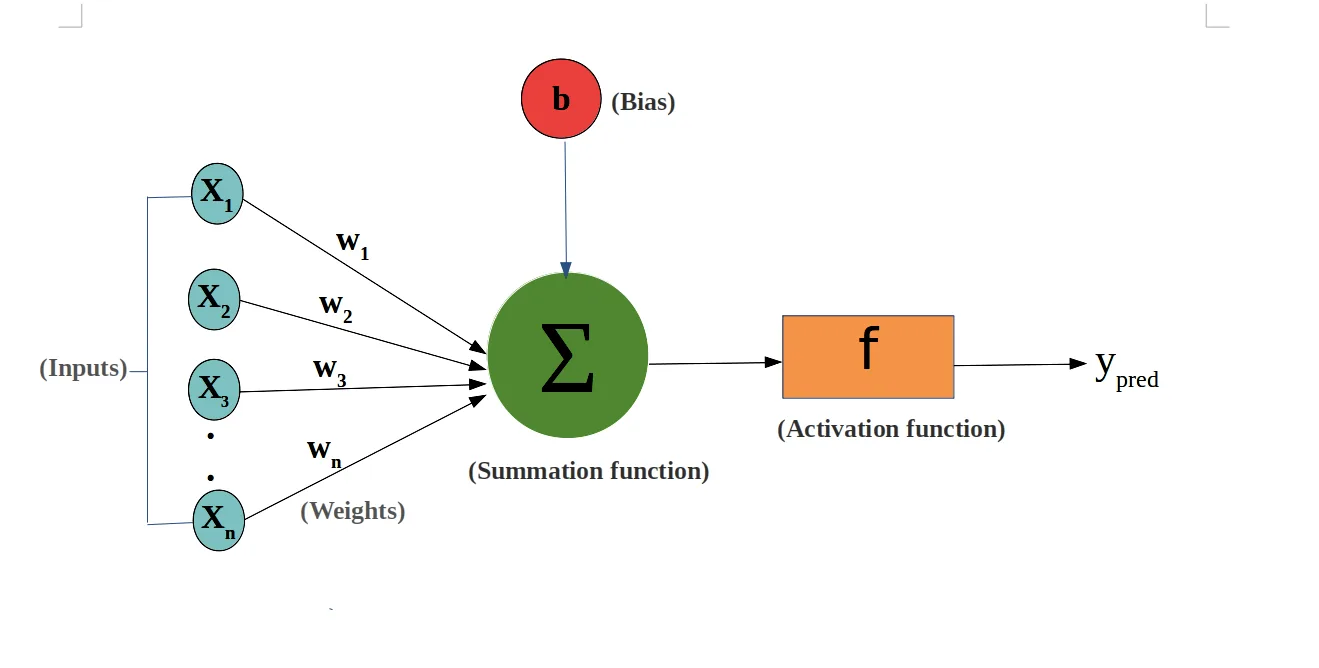
Die Ausgabe eines Neurons kann als die gewichtete Summe seiner Eingaben plus eines Bias betrachtet werden. Die mathematische Darstellung eines Neurons ist:
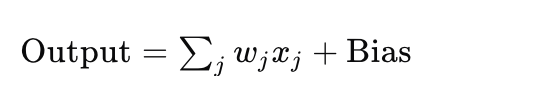
Hier,wjist das Gewicht,xjist die Eingabe, undBiasist der Bias-Term.
Ebene
Die Schichten zwischen der Eingabeschicht und der Ausgabeschicht werden als versteckte Schichten bezeichnet. Die Dichte und Art der Verbindungen zwischen den Schichten bilden die Netzwerkkonfiguration.
Ein neuronales Netzwerk besteht aus mehreren Schichten, darunter:
- Eingabeschicht: Empfängt Roheingabedaten.
- Verborgene Schicht: Verarbeitet die Eingabedaten; es kann mehrere verborgene Schichten geben.
- Ausgabeschicht: Erzeugt das endgültige Ausgabeergebnis.
Typische Architektur eines neuronalen Netzes:
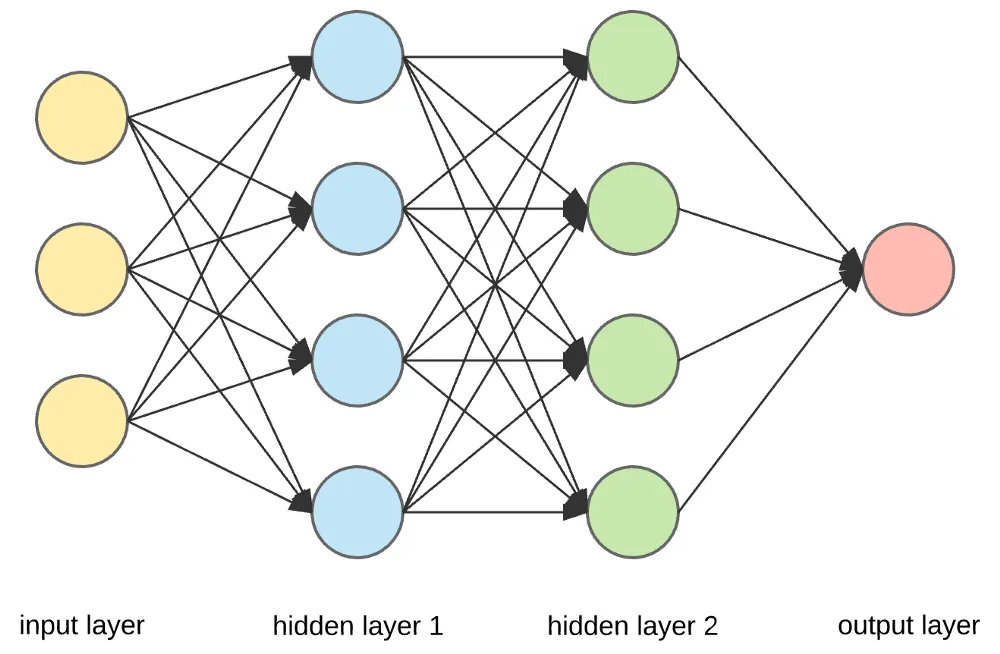
Demo-Diagramm:
Feedforward-Neuronales Netz (FNN)
Das Feedforward-Neuronale Netz (FNN) ist eine Grundeinheit in der Familie der neuronalen Netze.
Das Merkmal eines Feedforward-Neuronalen Netzes ist, dass Daten von der Eingabeschicht durch eine oder mehrere verborgene Schichten fließen und schließlich die Ausgabeschicht erreichen, ohne Schleifen oder Rückkopplungen während des gesamten Prozesses.
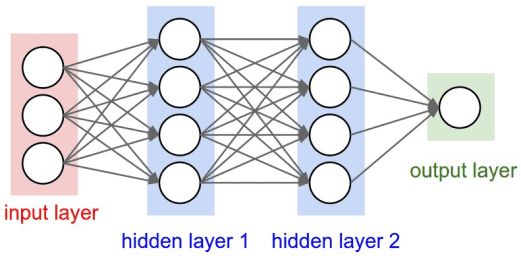
Grundstruktur eines Feedforward-Neuronalen Netzes:
-
Eingabeschicht:Der Eintrittspunkt, an dem Daten in das Netz gelangen. Jeder Knoten in der Eingabeschicht repräsentiert ein Eingabemerkmal.
Verborgene Schicht:Eine oder mehrere Schichten, die verwendet werden, um nichtlineare Merkmale der Daten zu erfassen. Jede verborgene Schicht besteht aus mehreren Neuronen, und jedes Neuron erhöht die Nichtlinearität durch eine Aktivierungsfunktion.
Ausgabeschicht:Gibt das Vorhersageergebnis des Netzes aus. Die Anzahl der Knoten hängt vom Problemtyp ab; beispielsweise entspricht die Anzahl der Ausgabeknoten in einem Klassifikationsproblem der Anzahl der Klassen.
Verbindungsgewichte und Bias:Die Eingaben zu jedem Neuron werden gewichtet und summiert, dann wird ein Bias addiert, und das Ergebnis wird durch eine Aktivierungsfunktion geleitet.
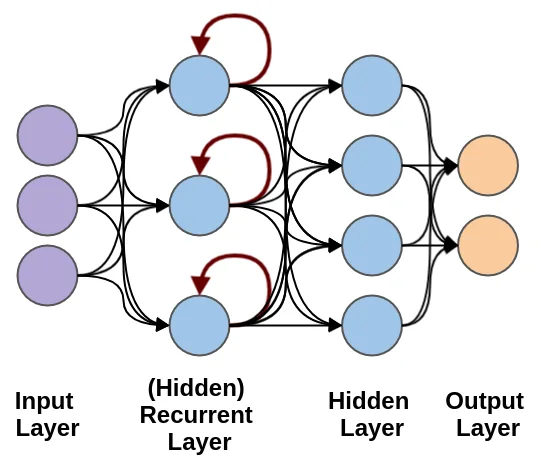
Rekurrentes neuronales Netz (RNN)
Ein rekurrentes neuronales Netz (RNN) ist eine Art von neuronalem Netz, das speziell für die Verarbeitung von Sequenzdaten entwickelt wurde und Abhängigkeiten in zeitlichen oder sequenziellen Informationen innerhalb der Eingabedaten erfassen kann.
Das besondere Merkmal von RNNs ist ihre "Gedächtnisfähigkeit" – sie können Informationen aus vorherigen Zeitschritten im verborgenen Zustand des Netzwerks speichern.
Rekurrente neuronale Netze werden verwendet, um Datenmuster zu verarbeiten, die sich im Laufe der Zeit ändern.
Im RNN wird dieselbe Schicht verwendet, um Eingabeparameter zu empfangen und Ausgabeparameter im angegebenen neuronalen Netz anzuzeigen.
PyTorch bietet leistungsstarke Werkzeuge zum Erstellen und Trainieren neuronaler Netze.
Neuronale Netze in PyTorch werden mithilfe destorch.nnModuls implementiert.
torch.nnDas Modul bietet verschiedene Netzwerkschichten (wie vollständig verbundene Schichten, Faltungsschichten usw.), Verlustfunktionen und Optimierer, was das Erstellen und Trainieren neuronaler Netze bequemer macht.
In PyTorch erfordert das Erstellen eines neuronalen Netzes normalerweise das Erben von der Klasse nn.Module.
nn.Module ist die Basisklasse für alle neuronalen Netzwerkmodule. Sie müssen die folgenden zwei Teile definieren:
__init__(): Definieren Sie die Netzwerkschichten.forward(): Definieren Sie den Vorwärtspropagationsprozess der Daten.
Einfaches vollständig verbundenes neuronales Netz:
Beispiel
import torch.nn as nn
# Definiere ein einfaches neuronales Netzmodell
class SimpleNN(nn.Module):
def __init__(self):
super(SimpleNN, self).__init__()
# Definiere eine vollständig verbundene Schicht von der Eingabeschicht zur versteckten Schicht
self.fc1 = nn.Linear(2, 2) # 2 Eingabemerkmale, 2 Ausgabemerkmale
# Definiere eine vollständig verbundene Schicht von der versteckten Schicht zur Ausgabeschicht
self.fc2 = nn.Linear(2, 1) # 2 Eingabemerkmale, 1 vorhergesagter Wert
def forward(self, x):
# Vorwärtspropagationsprozess
x = torch.relu(self.fc1(x)) # ReLU-Aktivierungsfunktion verwenden
x = self.fc2(x) # Ausgabeschicht
return x
# Modellinstanz erstellen
model = SimpleNN()
# Modell ausgeben
print(model)
Das Ausgabeergebnis ist wie folgt:
SimpleNN(
  (fc1): Linear(in_features=2, out_features=2, bias=True)
  (fc2): Linear(in_features=2, out_features=1, bias=True)
)
PyTorch bietet viele gängige Schichten für neuronale Netze. Hier sind einige gängige:
nn.Linear(in_features, out_features): Vollständig verbundene Schicht, Eingabein_featuresMerkmale, Ausgabeout_featuresMerkmale.nn.Conv2d(in_channels, out_channels, kernel_size): 2D-Faltungsschicht, verwendet für die Bildverarbeitung.nn.MaxPool2d(kernel_size): 2D-Max-Pooling-Schicht, verwendet zur Dimensionsreduktion.nn.ReLU(): ReLU-Aktivierungsfunktion, häufig in verborgenen Schichten verwendet.nn.Softmax(dim): Softmax-Aktivierungsfunktion, normalerweise in der Ausgabeschicht verwendet, geeignet für Multiklassen-Klassifikationsprobleme.
Aktivierungsfunktion
Aktivierungsfunktionen bestimmen, ob ein Neuron aktiviert werden soll. Sie sind nichtlineare Funktionen, die es neuronalen Netzwerken ermöglichen, zu lernen und komplexere Aufgaben auszuführen. Häufige Aktivierungsfunktionen sind:
- Sigmoid: Wird für binäre Klassifikationsprobleme verwendet, mit Ausgabewerten zwischen 0 und 1.
- Tanh: Ausgabewerte liegen zwischen -1 und 1, oft vor der Ausgabeschicht verwendet.
- ReLU (Rectified Linear Unit): Eine der derzeit beliebtesten Aktivierungsfunktionen, definiert als
f(x) = max(0, x), was hilft, das Problem des verschwindenden Gradienten zu lösen. - Softmax: Wird oft in der Ausgabeschicht für Multiklassen-Klassifikationsprobleme verwendet; wandelt Ausgaben in eine Wahrscheinlichkeitsverteilung um.
Beispiel
# ReLU-Aktivierung
output = F.relu(input_tensor)
# Sigmoid-Aktivierung
output = torch.sigmoid(input_tensor)
# Tanh-Aktivierung
output = torch.tanh(input_tensor)
Verlustfunktion
Die Verlustfunktion wird verwendet, um die Differenz zwischen den vorhergesagten Werten des Modells und den wahren Werten zu messen.
Zu den üblichen Verlustfunktionen gehören:
- Mittlerer quadratischer Fehler (MSELoss): Wird häufig für Regressionsprobleme verwendet; berechnet die quadrierte Differenz zwischen der Ausgabe und dem Zielwert.
- Kreuzentropieverlust (CrossEntropyLoss): Wird häufig für Klassifikationsprobleme verwendet; berechnet die Kreuzentropie zwischen der Ausgabe und den wahren Labels.
- BCEWithLogitsLoss: Für binäre Klassifikationsprobleme; kombiniert die Sigmoid-Aktivierung und den binären Kreuzentropieverlust.
Beispiel
criterion = nn.MSELoss()
# Kreuzentropieverlust
criterion = nn.CrossEntropyLoss()
# Binärer Kreuzentropie-Verlust
criterion = nn.BCEWithLogitsLoss()
Optimierer
Der Optimierer ist dafür verantwortlich, die Gewichte und Bias-Werte des Netzwerks während des Trainingsprozesses zu aktualisieren.
Zu den gängigen Optimierern gehören:
- SGD (Stochastic Gradient Descent)
- Adam (Adaptive Moment Estimation)
- RMSprop (Root Mean Square Propagation)
Beispiel
# SGD-Optimierer verwenden
optimizer = optim.SGD(model.parameters(), lr=0.01)
# Adam-Optimierer verwenden
optimizer = optim.Adam(model.parameters(), lr=0.001)
Trainingsprozess
Das Training eines neuronalen Netzwerks umfasst die folgenden Schritte:
- Daten vorbereiten: durch
DataLoaderdas Laden der Daten. - Verlustfunktion und Optimierer definieren。
- Vorwärtspropagation: Berechne die Ausgabe des Modells.
- Berechne den Verlust: Vergleiche mit dem Zielwert, um den Verlustwert zu erhalten.
- Backpropagation: durch
loss.backward()Berechnung der Gradienten. - Parameter aktualisieren: durch
optimizer.step()Aktualisierung der Modellparameter. - Wiederhole die obigen Schritte, bis die vorgegebene Anzahl an Trainingsepochen erreicht ist.
Beispiel
# Beispiel-Trainingsdaten
X = torch.randn(10, 2) # 10 Stichproben, jede mit 2 Merkmalen
Y = torch.randn(10, 1) # 10 Ziel-Labels
# Trainingsprozess
for epoch in range(100): # 100 Epochen trainieren
model.train() # Setze das Modell in den Trainingsmodus
optimizer.zero_grad() # Gradienten zurücksetzen
output = model(X) # Vorwärtspropagierung
loss = criterion(output, Y) # Verlust berechnen
loss.backward() # Backpropagation
optimizer.step() # Gewichte aktualisieren
if (epoch + 1) % 10 == 0: # Verlust alle 10 Epochen ausgeben
print(f'Epoch [{epoch + 1}/100], Loss: {loss.item():.4f}')
Testen und Evaluierung
Nach Abschluss des Trainings muss das Modell getestet und evaluiert werden.
Übliche Schritte umfassen:
- Verlust auf dem Testset berechnen: Leistung des Modells auf ungesehenen Daten bewerten.
- Genauigkeit berechnen: Bei Klassifikationsproblemen den Anteil korrekter Vorhersagen berechnen.
Beispiel
model.eval() # Modell in den Evaluierungsmodus versetzen
with torch.no_grad(): # Gradientenberechnung während der Evaluierung deaktivieren
output = model(X_test)
loss = criterion(output, Y_test)
print(f'Test Loss: {loss.item():.4f}')
Arten neuronaler Netze
- Feedforward-Neuronale Netze: Daten fließen in eine Richtung, von der Eingabeschicht zur Ausgabeschicht, ohne Rückkopplungsverbindungen.
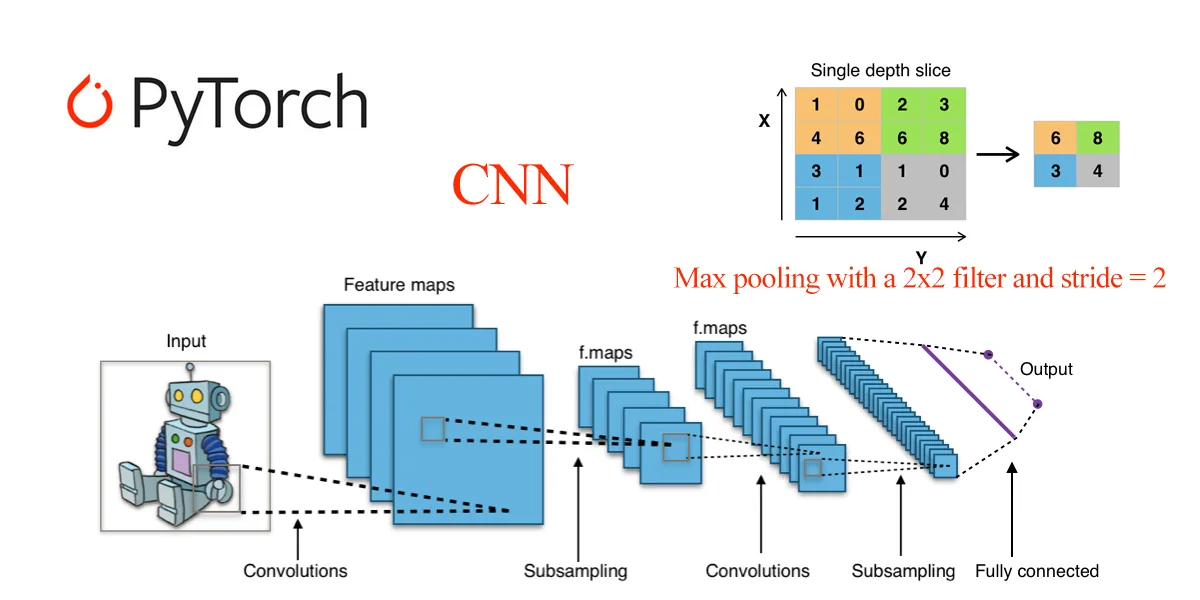
- Faltungsnetzwerke (CNNs): geeignet für die Bildverarbeitung, wobei Faltungsschichten verwendet werden, um räumliche Merkmale zu extrahieren.
- Rekurrente Neuronale Netze (RNNs): geeignet für sequenzielle Daten, wie Zeitreihenanalyse und Verarbeitung natürlicher Sprache, wobei Informationsrückkopplungsschleifen möglich sind.
- Long Short-Term Memory (LSTM): eine spezielle Art von RNN, die langfristige Abhängigkeiten lernen kann.
torch.nn Referenz
Die folgenden sind die in PyTorch am häufigsten verwendetentorch.nnFunktionen und Klassen:
Grundlagen der Modelldefinition
| Funktion | Beschreibung | Beispiel |
|---|---|---|
| nn.Module | Basisklasse für alle neuronalen Netzwerkmodule | class Net(nn.Module): ... |
| nn.Sequential | Sequenzieller Container, der Ebenen in Reihenfolge ausführt | nn.Sequential(conv, relu, pool) |
| nn.ModuleList | Speichert Submodule in einer Liste | self.layers = nn.ModuleList([...]) |
| nn.Parameter | Erzeugt einen lernbaren Parameter-Tensor | self.w = nn.Parameter(torch.randn(n)) |
Faltungsschichten
| Funktion | Beschreibung | Beispiel |
|---|---|---|
| nn.Conv1d | 1D-Faltung (Text, Audio) | nn.Conv1d(3, 64, 3) |
| nn.Conv2d | 2D-Faltung (Bild) | nn.Conv2d(3, 64, 3, padding=1) |
| nn.Conv3d | 3D-Faltung (Video) | nn.Conv3d(3, 64, 3) |
| nn.ConvTranspose2d | Transponierte Faltung (Decoder, Upsampling) | nn.ConvTranspose2d(64, 3, 2, stride=2) |
Pooling-Schichten
| Funktion | Beschreibung | Beispiel |
|---|---|---|
| nn.MaxPool2d | 2D-Max-Pooling | nn.MaxPool2d(2, 2) |
| nn.AvgPool2d | 2D-Average-Pooling | nn.AvgPool2d(2, 2) |
| nn.AdaptiveAvgPool2d | Adaptives Average-Pooling (feste Ausgabegröße) | nn.AdaptiveAvgPool2d((1, 1)) |
| nn.AdaptiveMaxPool2d | Adaptives Max-Pooling (feste Ausgabegröße) | nn.AdaptiveMaxPool2d((1, 1)) |
Lineare Schichten
| Funktion | Beschreibung | Beispiel |
|---|---|---|
| nn.Linear | Vollständig verbundene Schicht (lineare Transformation) | nn.Linear(128, 64) |
| nn.Bilinear | Bilineare Schicht | nn.Bilinear(128, 64, 32) |
| Funktion | Beschreibung | Beispiel |
| nn.ReLU | ReLU-Aktivierungsfunktion, f(x) = max(0, x) | nn.ReLU() |
| nn.GELU | Gaussian Error Linear Unit (Standard in Transformer) | nn.GELU() |
| nn.SiLU | Swish-Aktivierungsfunktion | nn.SiLU() |
| nn.Tanh | Hyperbolischer Tangens | nn.Tanh() |
| nn.Sigmoid | Sigmoid-Aktivierungsfunktion | nn.Sigmoid() |
| nn.Softmax | Softmax-Aktivierungsfunktion | nn.Softmax(dim=1) |
| nn.LogSoftmax | Log-Softmax (numerisch stabil) | nn.LogSoftmax(dim=1) |
| nn.LeakyReLU | LeakyReLU, erlaubt kleine Gradienten für negative Werte | nn.LeakyReLU(0.01) |
| nn.ELU | Exponentielle lineare Einheit | nn.ELU() |
Normalisierungsschichten
| Funktion | Beschreibung | Beispiel |
|---|---|---|
| nn.BatchNorm2d | 2D-Batch-Normalisierung (häufig in Faltungsnetzwerken verwendet) | nn.BatchNorm2d(64) |
| nn.LayerNorm | Layer-Normalisierung (häufig in Transformers verwendet) | nn.LayerNorm(512) |
| nn.GroupNorm | Gruppen-Normalisierung (häufig in ResNet usw. verwendet) | nn.GroupNorm(4, 64) |
| nn.InstanceNorm2d | Instanz-Normalisierung (häufig bei der Stilübertragung verwendet) | nn.InstanceNorm2d(64) |
Rekurrente Schichten
| Funktion | Beschreibung | Beispiel |
|---|---|---|
| nn.LSTM | LSTM-(Long Short-Term Memory)-Schicht | nn.LSTM(256, 512, 2) |
| nn.GRU | GRU-(Gated Recurrent Unit)-Schicht | nn.GRU(256, 512, 2) |
| nn.RNN | Einfache RNN-Schicht | nn.RNN(256, 512, 2) |
Transformer-Schichten
| Funktion | Beschreibung | Beispiel |
|---|---|---|
| nn.Transformer | Vollständiges Transformer-Modell | nn.Transformer(d_model=512, nhead=8) |
| nn.TransformerEncoder | Transformer-Encoder | nn.TransformerEncoder(layer, num_layers=6) |
| nn.TransformerDecoder | Transformer-Decoder | nn.TransformerDecoder(layer, num_layers=6) |
| nn.TransformerEncoderLayer | Transformer-Encoder-Schicht | nn.TransformerEncoderLayer(512, 8) |
| nn.MultiheadAttention | Multi-Head-Attention-Mechanismus | nn.MultiheadAttention(512, 8) |
Embedding-Schichten
| Funktion | Beschreibung | Beispiel |
|---|---|---|
| nn.Embedding | Embedding-Schicht (bildet Vokabular auf Vektoren ab) | nn.Embedding(10000, 256) |
| nn.EmbeddingBag | Embedding-Bag (aggregiert mehrere Embeddings) | nn.EmbeddingBag(10000, 256) |
Dropout-Schichten
| Funktion | Beschreibung | Beispiel |
|---|---|---|
| nn.Dropout | Zufälliges Dropout (verhindert Overfitting) | nn.Dropout(0.5) |
| nn.Dropout2d | 2D-Dropout (verwirft gesamte Feature-Maps) | nn.Dropout2d(0.5) |
Verlustfunktionen
| Funktion | Beschreibung | Beispiel |
|---|---|---|
| nn.CrossEntropyLoss | Kreuzentropie-Verlust (Mehrklassenklassifikation) | nn.CrossEntropyLoss() |
| nn.MSELoss | Mittlerer quadratischer Fehler (Regression) | nn.MSELoss() |
| nn.L1Loss | L1-Verlust (MAE) | nn.L1Loss() |
| nn.BCEWithLogitsLoss | Binäre Kreuzentropie mit Sigmoid | nn.BCEWithLogitsLoss() |
| nn.HuberLoss | Huber-Verlust (robuste Regression) | nn.HuberLoss() |
| nn.NLLLoss | Negative Log-Likelihood-Verlust | nn.NLLLoss() |
Funktionale Funktionen (nn.functional)
| Funktion | Beschreibung | Beispiel |
|---|---|---|
F.relu |
ReLU-Aktivierung | F.relu(x) |
F.gelu |
GELU-Aktivierung | F.gelu(x) |
F.sigmoid |
Sigmoid-Aktivierung | F.sigmoid(x) |
F.softmax |
Softmax-Aktivierung | F.softmax(x, dim=1) |
F.dropout |
Dropout-Operation | F.dropout(x, 0.5, training) |
F.conv2d |
2D-Faltung | F.conv2d(x, weight, bias) |
F.linear |
Lineare Transformation | F.linear(x, weight, bias) |
F.cross_entropy |
Cross-Entropy-Verlust | F.cross_entropy(logits, targets) |
F.mse_loss |
Verlust des mittleren quadratischen Fehlers | F.mse_loss(pred, target) |
F.interpolate |
Interpolation (Upsampling/Downsampling) | F.interpolate(x, scale_factor=2) |
F.embedding |
Embedding-Operation | F.embedding(indices, weight) |
Hilfsfunktionen (nn.init)
| Funktion | Beschreibung | Beispiel |
|---|---|---|
nn.init.xavier_uniform_ |
Xavier-Uniform-Initialisierung | nn.init.xavier_uniform_(module.weight) |
nn.init.xavier_normal_ |
Xavier-Normal-Initialisierung | nn.init.xavier_normal_(module.weight) |
nn.init.kaiming_uniform_ |
Kaiming-Uniform-Initialisierung (geeignet für ReLU) | nn.init.kaiming_uniform_(module.weight) |
nn.init.kaiming_normal_ |
Kaiming-Normal-Initialisierung (geeignet für ReLU) | nn.init.kaiming_normal_(module.weight) |
nn.init.zeros_ |
Nullinitialisierung | nn.init.zeros_(module.bias) |
nn.init.normal_ |
Normalinitialisierung | nn.init.normal_(module.weight, 0, 0.01) |
Hilfsfunktionen (nn.utils)
| Funktion | Beschreibung | Beispiel |
|---|---|---|
nn.utils.clip_grad_norm_ |
Gradienten-Norm-Clipping (verhindert Gradientenexplosion) | nn.utils.clip_grad_norm_(model.parameters(), 1.0) |
nn.utils.weight_norm |
Gewichtsnormalisierung | nn.utils.weight_norm(module, 'weight') |
nn.utils.spectral_norm |
Spektralnormalisierung (häufig in GANs verwendet) | nn.utils.spectral_norm(module, 'weight') |
nn.utils.rnn.pack_padded_sequence |
Sequenzen variabler Länge packen | pack_padded_sequence(x, lengths) |
nn.utils.rnn.pad_packed_sequence |
Sequenzen entpacken | pad_packed_sequence(packed) |