PyTorch: Lineare Regression
Die lineare Regression ist einer der grundlegendsten Algorithmen des maschinellen Lernens und wird verwendet, um einen kontinuierlichen Wert vorherzusagen. Sie ist eine einfache und gängige Methode der Regressionsanalyse, die darauf abzielt, die Ausgabe durch Anpassen einer linearen Funktion vorherzusagen.
Für ein einfaches lineares Regressionsproblem kann das Modell ausgedrückt werden als:
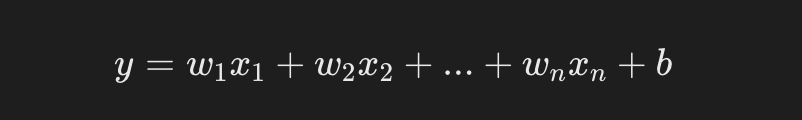
- y ist der vorhergesagte Wert (Zielwert).
- \(x_1\), \(x_2\), \(x_n\) sind Eingabemerkmale.
- \(w_1\), \(w_2\), \(w_n\) sind die zu lernenden Gewichte (Modellparameter).
- b ist der Bias-Term.
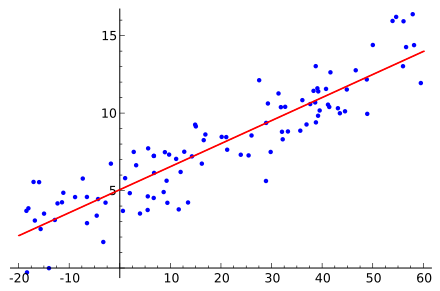
In PyTorch kann ein lineares Regressionsmodell implementiert werden, indem man vonnn.Moduleder Klasse erbt. Wir werden ein einfaches Beispiel verwenden, um detailliert zu erklären, wie man ein lineares Regressionsmodell mit PyTorch implementiert.
Datenvorbereitung
Zuerst bereiten wir einige fiktive Daten vor, um unser lineares Regressionsmodell zu trainieren. Hier können wir einen Datensatz mit einer einfachen linearen Beziehung generieren, bei dem jede Stichprobe zwei Merkmale \(x_1\), \(x_2\) hat.
Beispiel
import numpy as np
import matplotlib.pyplot as plt
# Zufallsstartwert, um konsistente Ergebnisse über Läufe hinweg zu gewährleisten
torch.manual_seed(42)
# Trainingsdaten generieren
X = torch.randn(100, 2) # 100 Beispiele, jeweils mit 2 Merkmalen
true_w = torch.tensor([2.0, 3.0]) # Wahre Gewichte annehmen
true_b = 4.0 # Bias-Term
Y = X @ true_w + true_b + torch.randn(100) * 0.1 # Etwas Rauschen hinzufügen
# Einige Daten ausgeben
print(X[:5])
print(Y[:5])
Die Ausgabe sieht wie folgt aus:
tensor([[ 1.9269,  1.4873],
        [ 0.9007, -2.1055],
        [ 0.6784, -1.2345],
        [-0.0431, -1.6047],
        [-0.7521,  1.6487]])
tensor([12.4460, -0.4663,  1.7666, -0.9357,  7.4781])
Dieser Code erzeugt einen linearen Datensatz mit Rauschen.
- Eingabe X ist eine 100x2-Matrix, jede Stichprobe hat zwei Merkmale.
- Ausgabe Y wird aus den wahren Gewichten und dem Bias erzeugt, mit etwas hinzugefügtem Zufallsrauschen.
- Verwendung
torch.manual_seed(42)sorgt für konsistente Ergebnisse über mehrere Durchläufe hinweg und erleichtert Debugging und Reproduktion.
Definieren des linearen Regressionsmodells
Wir können ein einfaches lineares Regressionsmodell durch Vererbung definierennn.ModuleIn PyTorch ist der Kern der linearen Regression dienn.Linear()Schicht, die automatisch die Initialisierung von Gewichten und Biases übernimmt.
Beispiel
# Lineares Regressionsmodell definieren
class LinearRegressionModel(nn.Module):
def __init__(self):
super(LinearRegressionModel, self).__init__()
# Eine lineare Schicht definieren, Eingabe sind 2 Merkmale, Ausgabe ist 1 Vorhersage
self.linear = nn.Linear(2, 1) # Eingabedimension 2, Ausgabedimension 1
def forward(self, x):
return self.linear(x) # Vorwärtspropagation, Vorhersageergebnis zurückgeben
# Modellinstanz erstellen
model = LinearRegressionModel()
Hier,nn.Linear(2, 1)stellt eine lineare Schicht dar, die 2 Eingabemerkmale und 1 Ausgabe hat.forwardDie Methode definiert, wie die Vorwärtspropagation durch diese Schicht ausgeführt wird.
Hinweis:
nn.Linearerstellt automatisch die Gewichtsmatrix und den Bias-Vektor, sie müssen nicht manuell definiert werden.
Verlustfunktion und Optimierer definieren
Die übliche Verlustfunktion für lineare Regression istMean Squared Error Loss (MSELoss), die verwendet wird, um die Differenz zwischen vorhergesagten und wahren Werten zu messen. PyTorch bietet eine gebrauchsfertige MSELoss-Funktion.
Wir werdenSGD (Stochastic Gradient Descent)oderAdamOptimierer verwenden, um die Verlustfunktion zu minimieren.
Beispiel
criterion = nn.MSELoss()
# Optimierer (unter Verwendung von SGD oder Adam)
optimizer = torch.optim.SGD(model.parameters(), lr=0.01) # Lernrate auf 0.01 gesetzt
# Du kannst auch den Adam-Optimizer verwenden
# optimizer = torch.optim.Adam(model.parameters(), lr=0.01)
| Komponente | Beschreibung |
|---|---|
MSELoss |
Berechne den mittleren quadratischen Fehler zwischen vorhergesagten und wahren Werten, Formel: \(\frac{1}{n}\sum(y_{pred} - y_{true})^2\) |
SGD |
Verwende stochastischen Gradientenabstieg, um Parameter zu aktualisieren; die Lernrate steuert die Schrittweite jeder Aktualisierung |
Adam |
Adaptiver Lernratenoptimierer, konvergiert normalerweise schneller |
Trainieren des Modells
Während des Trainings werden wir die folgenden Schritte ausführen:
- Verwende die Eingabedaten X für die Vorwärtspropagation, um Vorhersagen zu erhalten.
- Berechne den Verlust (Differenz zwischen vorhergesagten und tatsächlichen Werten).
- Verwende Backpropagation, um Gradienten zu berechnen.
- Aktualisiere die Modellparameter (Gewichte und Bias).
Wir trainieren das Modell für 1000 Epochen und geben den Verlust alle 100 Epochen aus.
Beispiel
num_epochs = 1000 # Trainiere für 1000 Epochen
for epoch in range(num_epochs):
model.train() # Modell in den Trainingsmodus versetzen
# Vorwärtspropagierung
predictions = model(X) # Modell gibt Vorhersagen aus
loss = criterion(predictions.squeeze(), Y) # Berechne den Verlust (Hinweis: predictions müssen auf 1D reduziert werden)
# Backpropagation
optimizer.zero_grad() # Vorherige Gradienten zurücksetzen
loss.backward() # Gradienten berechnen
optimizer.step() # Modellparameter aktualisieren
# Verlust ausgeben
if (epoch + 1) % 100 == 0:
print(f'Epoche [{epoch + 1}/1000], Verlust: {loss.item():.4f}')
predictions.squeeze(): Reduziere die Modellausgabe von einem 2D-Tensor auf 1D, weil der ZielwertYein eindimensionales Array ist.optimizer.zero_grad(): Vor jeder Backpropagation müssen Sie die vorherigen Gradienten zurücksetzen, sonst akkumulieren sich die Gradienten.loss.backward(): Berechnet automatisch die Gradienten aller trainierbaren Parameter.optimizer.step(): Aktualisiert die Gewichte und den Bias basierend auf den berechneten Gradienten.
Trainingsmodus vs. Evaluierungsmodus:Aufruf in der Trainingsschleife
model.train()ist notwendig. Obwohl dieses Beispiel weder Dropout noch BatchNorm verwendet, ist es wichtig, diese Gewohnheit für komplexe Modelle zu entwickeln.
Evaluierung des Modells
Nach dem Training können wir die Leistung des Modells bewerten, indem wir seine Gewichte und seinen Bias untersuchen. Wir können auch Vorhersagen für neue Daten treffen und sie mit den tatsächlichen Werten vergleichen.
Beispiel
print(f'Vorhergesagtes Gewicht: {model.linear.weight.data.numpy()}')
print(f'Vorhergesagter Bias: {model.linear.bias.data.numpy()}')
# Vorhersagen für neue Daten treffen
with torch.no_grad(): # Während der Evaluierung müssen keine Gradienten berechnet werden
predictions = model(X)
# Vorhersagen und tatsächliche Werte visualisieren
plt.scatter(X[:, 0], Y, color='blue', label='Tatsächliche Werte')
plt.scatter(X[:, 0], predictions, color='red', label='Vorhersagen')
plt.legend()
plt.show()
model.linear.weight.dataundmodel.linear.bias.data: Diese Attribute speichern die Gewichte und den Bias des Modells.torch.no_grad(): Im Evaluierungsmodus müssen keine Gradienten berechnet werden, was Speicher spart und die Inferenzgeschwindigkeit erhöht.
Vollständiger Beispielcode
Unten steht der vollständige Code für alle oben genannten Schritte, integriert und ausführbereit:
Beispiel
import torch.nn as nn
import matplotlib.pyplot as plt
# 1. Daten vorbereiten
torch.manual_seed(42)
X = torch.randn(100, 2) # 100 Stichproben, 2 Merkmale
true_w = torch.tensor([2.0, 3.0])
true_b = 4.0
Y = X @ true_w + true_b + torch.randn(100) * 0.1
# 2. Modell definieren
class LinearRegressionModel(nn.Module):
def __init__(self):
super().__init__()
self.linear = nn.Linear(2, 1)
def forward(self, x):
return self.linear(x)
model = LinearRegressionModel()
# 3. Verlustfunktion und Optimierer definieren
criterion = nn.MSELoss()
optimizer = torch.optim.SGD(model.parameters(), lr=0.01)
# 4. Modell trainieren
num_epochs = 1000
for epoch in range(num_epochs):
model.train()
predictions = model(X)
loss = criterion(predictions.squeeze(), Y)
optimizer.zero_grad()
loss.backward()
optimizer.step()
if (epoch + 1) % 100 == 0:
print(f'Epoche [{epoch + 1}/{num_epochs}], Verlust: {loss.item():.4f}')
# 5. Modell evaluieren
print(f'\nTrainierte Gewichte: {model.linear.weight.data.numpy()}')
print(f'Trainierter Bias: {model.linear.bias.data.numpy()}')
print(f'Wahre Gewichte: {true_w.numpy()}')
print(f'Wahrer Bias: {true_b}')
Analyse der Ausführungsergebnisse
Nach dem Ausführen des obigen Codes sehen Sie eine Ausgabe ähnlich der folgenden:
Epoch [100/1000], Loss: 0.0654
Epoch [200/1000], Loss: 0.0398
Epoch [300/1000], Loss: 0.0243
Epoch [400/1000], Loss: 0.0148
Epoch [500/1000], Loss: 0.0090
Epoch [600/1000], Loss: 0.0055
Epoch [700/1000], Loss: 0.0033
Epoch [800/1000], Loss: 0.0020
Epoch [900/1000], Loss: 0.0012
Epoch [1000/1000], Loss: 0.0008

训练后的权重: [[2.0016 2.9973]]
训练后的偏置: [4.0015]
真实权重: [2. 3.]
真实偏置: 4.0
Es ist zu erkennen, dass mit steigender Anzahl der Trainingsepochen der Verlustwert kontinuierlich abnimmt. Schließlich liegen die Gewichte und der Bias des Modells sehr nahe an den wahren Werten, was darauf hindeutet, dass das Modell die lineare Beziehung der Daten erfolgreich gelernt hat.
Erweiterung: Verwendung komplexerer Optimierer
Zusätzlich zu SGD bietet PyTorch viele weitere Optimierer. Unten finden Sie ein Beispiel mit dem Adam-Optimierer:
Beispiel
optimizer = torch.optim.Adam(model.parameters(), lr=0.01)
# Modell trainieren
for epoch in range(num_epochs):
model.train()
predictions = model(X)
loss = criterion(predictions.squeeze(), Y)
optimizer.zero_grad()
loss.backward()
optimizer.step()
if (epoch + 1) % 100 == 0:
print(f'Epoche [{epoch + 1}/{num_epochs}], Verlust: {loss.item():.4f}')
| Optimierer | Funktionen | Geeignete Szenarien |
|---|---|---|
| SGD | Einfach und unkompliziert, erfordert manuelle Anpassung der Lernrate | Große Datensätze, klassische Szenarien |
| Adam | Adaptive Lernrate, schnelle Konvergenz | Die meisten Szenarien, empfohlene Standardauswahl |
| RMSprop | Geeignet für rekurrente neuronale Netze | Sequenzmodelle wie RNN, LSTM |
Häufige Probleme
Problem 1: Verlustwert wird nicht kleiner
Wenn der Verlustwert während des Trainings nicht sinkt, kommen folgende mögliche Ursachen infrage:
- Lernrate zu klein, wodurch Parameter-Updates zu klein ausfallen.
- Lernrate zu groß, wodurch die optimale Lösung übersprungen wird.
- Probleme mit den Daten, z. B. wenn die Wertebereiche der Merkmale zu stark voneinander abweichen.
Lösung:
- Versuchen Sie, die Lernrate anzupassen (beginnen Sie mit 0.1, 0.01, 0.001).
- Standardisieren Sie die Eingabedaten.
- Prüfen Sie die Daten auf Ausreißer oder fehlende Werte.
Problem 2: Formabweichung der Vorhersage
Wenn bei der Berechnung des Verlusts ein Shape-Mismatch-Fehler auftritt, müssen Sie möglicherweisesqueeze()oderunsqueeze()Passen Sie die Tensorform an.
Beispiel
predictions = model(X)
print(f'Ausgabeform des Modells: {predictions.shape}') # Sollte [100, 1] sein
# Auf 1D reduzieren
predictions = predictions.squeeze()
print(f'Form nach Squeeze: {predictions.shape}') # Sollte sein
# Verlust berechnen
loss = criterion(predictions, Y)
Problem 3: Wie man die Modellgenauigkeit verbessert
- Erhöhen Sie die Anzahl der Trainings-Epochen.
- Passen Sie die Lernrate an.
- Verwenden Sie eine komplexere Modellstruktur (z. B. ein mehrschichtiges neuronales Netzwerk).
- Erhöhen Sie die Menge an Trainingsdaten.