Tiefendurchlauf und Zusammenhangskomponenten
Die Hauptidee der Tiefensuche besteht darin, zuerst einen unbesuchten Knoten als Startknoten zu nehmen und entlang der Kanten des aktuellen Knotens zu einem unbesuchten Knoten zu gehen. Wenn es keinen unbesuchten Knoten gibt, kehrt man zum vorherigen Knoten zurück und versucht weiter andere Knoten, bis alle Knoten besucht wurden.
Der Graph im folgenden Beispiel beginnt den Durchlauf bei 0, und die Reihenfolge ist in der rechten Abbildung dargestellt:
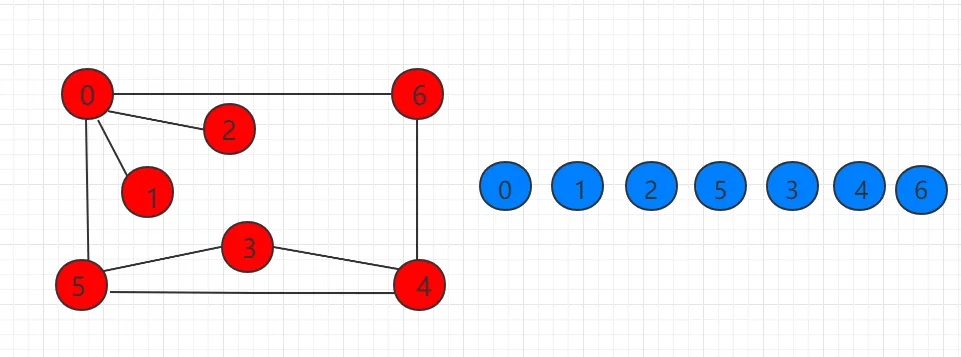
Ein maximaler zusammenhängender Teilgraph eines ungerichteten Graphen G wird als Zusammenhangskomponente (oder Zusammenhangszweig) von G bezeichnet. Ein zusammenhängender Graph hat nur eine einzige Zusammenhangskomponente, nämlich sich selbst; ein nicht zusammenhängender ungerichteter Graph hat mehrere Zusammenhangskomponenten. Zwischen Zusammenhangskomponenten gibt es keine Kanten. Die Tiefensuche kann verwendet werden, um Zusammenhangskomponenten zu finden.
Das Folgende verwendet das Finden von Zusammenhangskomponenten als Beispiel, um eine Tiefensuche eines Graphen zu implementieren, die dfs genannt wird. Im folgenden Codeausschnitt hält das visited-Array fest, ob ein Knoten während der dfs besucht wurde, ccount hält die Anzahl der Zusammenhangskomponenten fest, das id-Array stellt die jedem Knoten entsprechende Zusammenhangskomponenten-Bezeichnung dar, und zwei Knoten mit demselben id-Wert gehören zur selben Zusammenhangskomponente.
// Konstruktor, findet die Zusammenhangskomponenten eines ungewichteten Graphen
public Components(Graph graph){
// Initialisierung des Algorithmus
G = graph;
visited = new boolean[G.V()];
id = new int[G.V()];
ccount = 0;
for( int i = 0 ; i < G.V() ; i ++ ){
visited[i] = false;
id[i] = -1;
}
// Finde die Zusammenhangskomponenten des Graphen
for( int i = 0 ; i < G.V() ; i ++ )
if( !visited[i] ){
dfs(i);
ccount ++;
}
}
...
Die Tiefensuche in einem Graphen ist ein rekursiver Prozess; Implementierungscode:
// Tiefensuche im Graphen
void dfs( int v ){
visited[v] = true;
id[v] = ccount;
for( int i: G.adj(v) ){
if( !visited[i] )
dfs(i);
}
}
...
Java-Beispielcode
Quellcode-Paket-Download:Herunterladen
Code der Datei src/example/graph/Components.java:
import example.graph.read.Graph;
/**
* Tiefensuche
*/
public class Components {
Graph G; // Referenz auf den Graphen
private boolean[] visited; // Speichert, ob ein Knoten während der DFS besucht wurde
private int ccount; // Die Anzahl der Zusammenhangskomponenten aufzeichnen
private int[] id; // Das jedem Knoten entsprechende Zusammenhangskomponenten-Label
// Tiefensuche im Graphen
void dfs( int v ){
visited[v] = true;
id[v] = ccount;
for( int i: G.adj(v) ){
if( !visited[i] )
dfs(i);
}
}
// Konstruktor, findet die Zusammenhangskomponenten eines ungewichteten Graphen
public Components(Graph graph){
// Initialisierung des Algorithmus
G = graph;
visited = new boolean[G.V()];
id = new int[G.V()];
ccount = 0;
for( int i = 0 ; i < G.V() ; i ++ ){
visited[i] = false;
id[i] = -1;
}
// Finde die Zusammenhangskomponenten des Graphen
for( int i = 0 ; i < G.V() ; i ++ )
if( !visited[i] ){
dfs(i);
ccount ++;
}
}
// Die Anzahl der Zusammenhangskomponenten des Graphen zurückgeben
int count(){
return ccount;
}
// Abfragen, ob Knoten v und Knoten w verbunden sind
boolean isConnected( int v , int w ){
assert v >= 0 && v < G.V();
assert w >= 0 && w < G.V();
return id[v] == id[w];
}
}