Fortgeschrittene Graphalgorithmen
Im vorherigen Grundlagen-Tutorial haben wir bereits die grundlegenden Konzepte von Graphen, Darstellungsmethoden und grundlegende Algorithmen wie Breitensuche (BFS) und Tiefensuche (DFS) kennengelernt. Diese Algorithmen halfen uns, Probleme wie die Frage, ob zwei Punkte verbunden sind, und die Graphdurchquerung zu lösen.
Viele komplexe Probleme in der realen Welt, wie Freundesempfehlungen in sozialen Netzwerken, die Planung kürzester Wege in der Kartennavigation, die optimale Routenplanung in Logistik und Distribution und sogar die Rangfolge von Webseiten im Internet, erfordern jedoch leistungsfähigere und effizientere Algorithmen. Das sindFortgeschrittene GraphalgorithmenDie zu lösende Herausforderung.
Fortgeschrittene GraphalgorithmenSie sind wie ein professionelles Werkzeug, das entwickelt wurde, um bestimmte komplexe Probleme zu lösen:
- Netzwerkfluss: löst Probleme der Flussverteilung, wie Transport und Logistik
- Bipartites Graph-Matching: löst Matching-Probleme, wie Aufgabenverteilung und Heiratsvermittlung
- Stark zusammenhängende Komponenten: Analyse der Zusammenhangsstruktur von Graphen
- Topologische Sortierung: Lösen von Abhängigkeitsproblemen
Praxisbeispiel:
- Netzwerkfluss: wie Verkehrsflussoptimierung in städtischen Verkehrssystemen
- Bipartites Graph-Matching: wie Systeme zur Heiratsvermittlung
- Stark zusammenhängende Komponenten: wie die Analyse von Freundeskreisen in sozialen Netzwerken
- Topologische Sortierung: wie das Sortieren von Aufgabenabhängigkeiten
| Problemtypen | Allgemeine Algorithmen | Fortgeschrittene Graphalgorithmen |
|---|---|---|
| Flussoptimierung | Schwer zu modellieren und zu lösen | Netzwerkflussalgorithmen lösen gezielt |
| Matching-Problem | Brute-Force-Suche ist ineffizient | Bipartites Graph-Matching löst effizient |
| Konnektivitätsanalyse | Einfaches DFS/BFS liefert begrenzte Informationen | Stark zusammenhängende Komponenten ermöglichen eine eingehende Analyse |
| Sortierung von Abhängigkeiten | Schwierig, komplexe Abhängigkeiten zu handhaben | Topologische Sortierung löst dies perfekt |
Kürzeste-Wege-Problem und Dijkstras Algorithmus
Stellen Sie sich vor, Sie verwenden eine Karten-App, um eine Route von zu Hause zum Büro zu planen. Auf der Karte gibt es unzählige Wege, und jeder Weg hat eine unterschiedliche Fahrzeit (Gewicht). Ihr Ziel ist es, den Weg mit derkürzesten Gesamtfahrzeitzu finden, was das klassischeSingle-Source-Kürzeste-Wege-Problem。
Kernidee des Algorithmus
Dijkstras AlgorithmuslöstGraphen mit nichtnegativen GewichtenEin Greedy-Algorithmus für das Single-Source-Kürzeste-Wege-Problem. Seine Kernidee ist die eines vorsichtigen Entdeckers:
- Es verwaltet eine Menge von Knoten mit "bekannten kürzesten Distanzen."
- Wählen Sie jedes Mal aus der "unbekannten Region" einen Knoten aus:den aktuell dem Startpunkt am nächsten gelegenen Knoten, und bestätigen Sie seine kürzeste Distanz.
- Verwenden Sie dann diesen neu bestätigten Knoten, um die "geschätzte kürzeste Distanz" aller seiner Nachbarn zu aktualisieren.
- Wiederhole diesen Vorgang, bis die kürzesten Distanzen aller Knoten bestätigt sind.
Detaillierte Erklärung der Algorithmusschritte
Verwenden wir ein Flussdiagramm, um den Ausführungsprozess des Dijkstra-Algorithmus intuitiv zu verstehen:
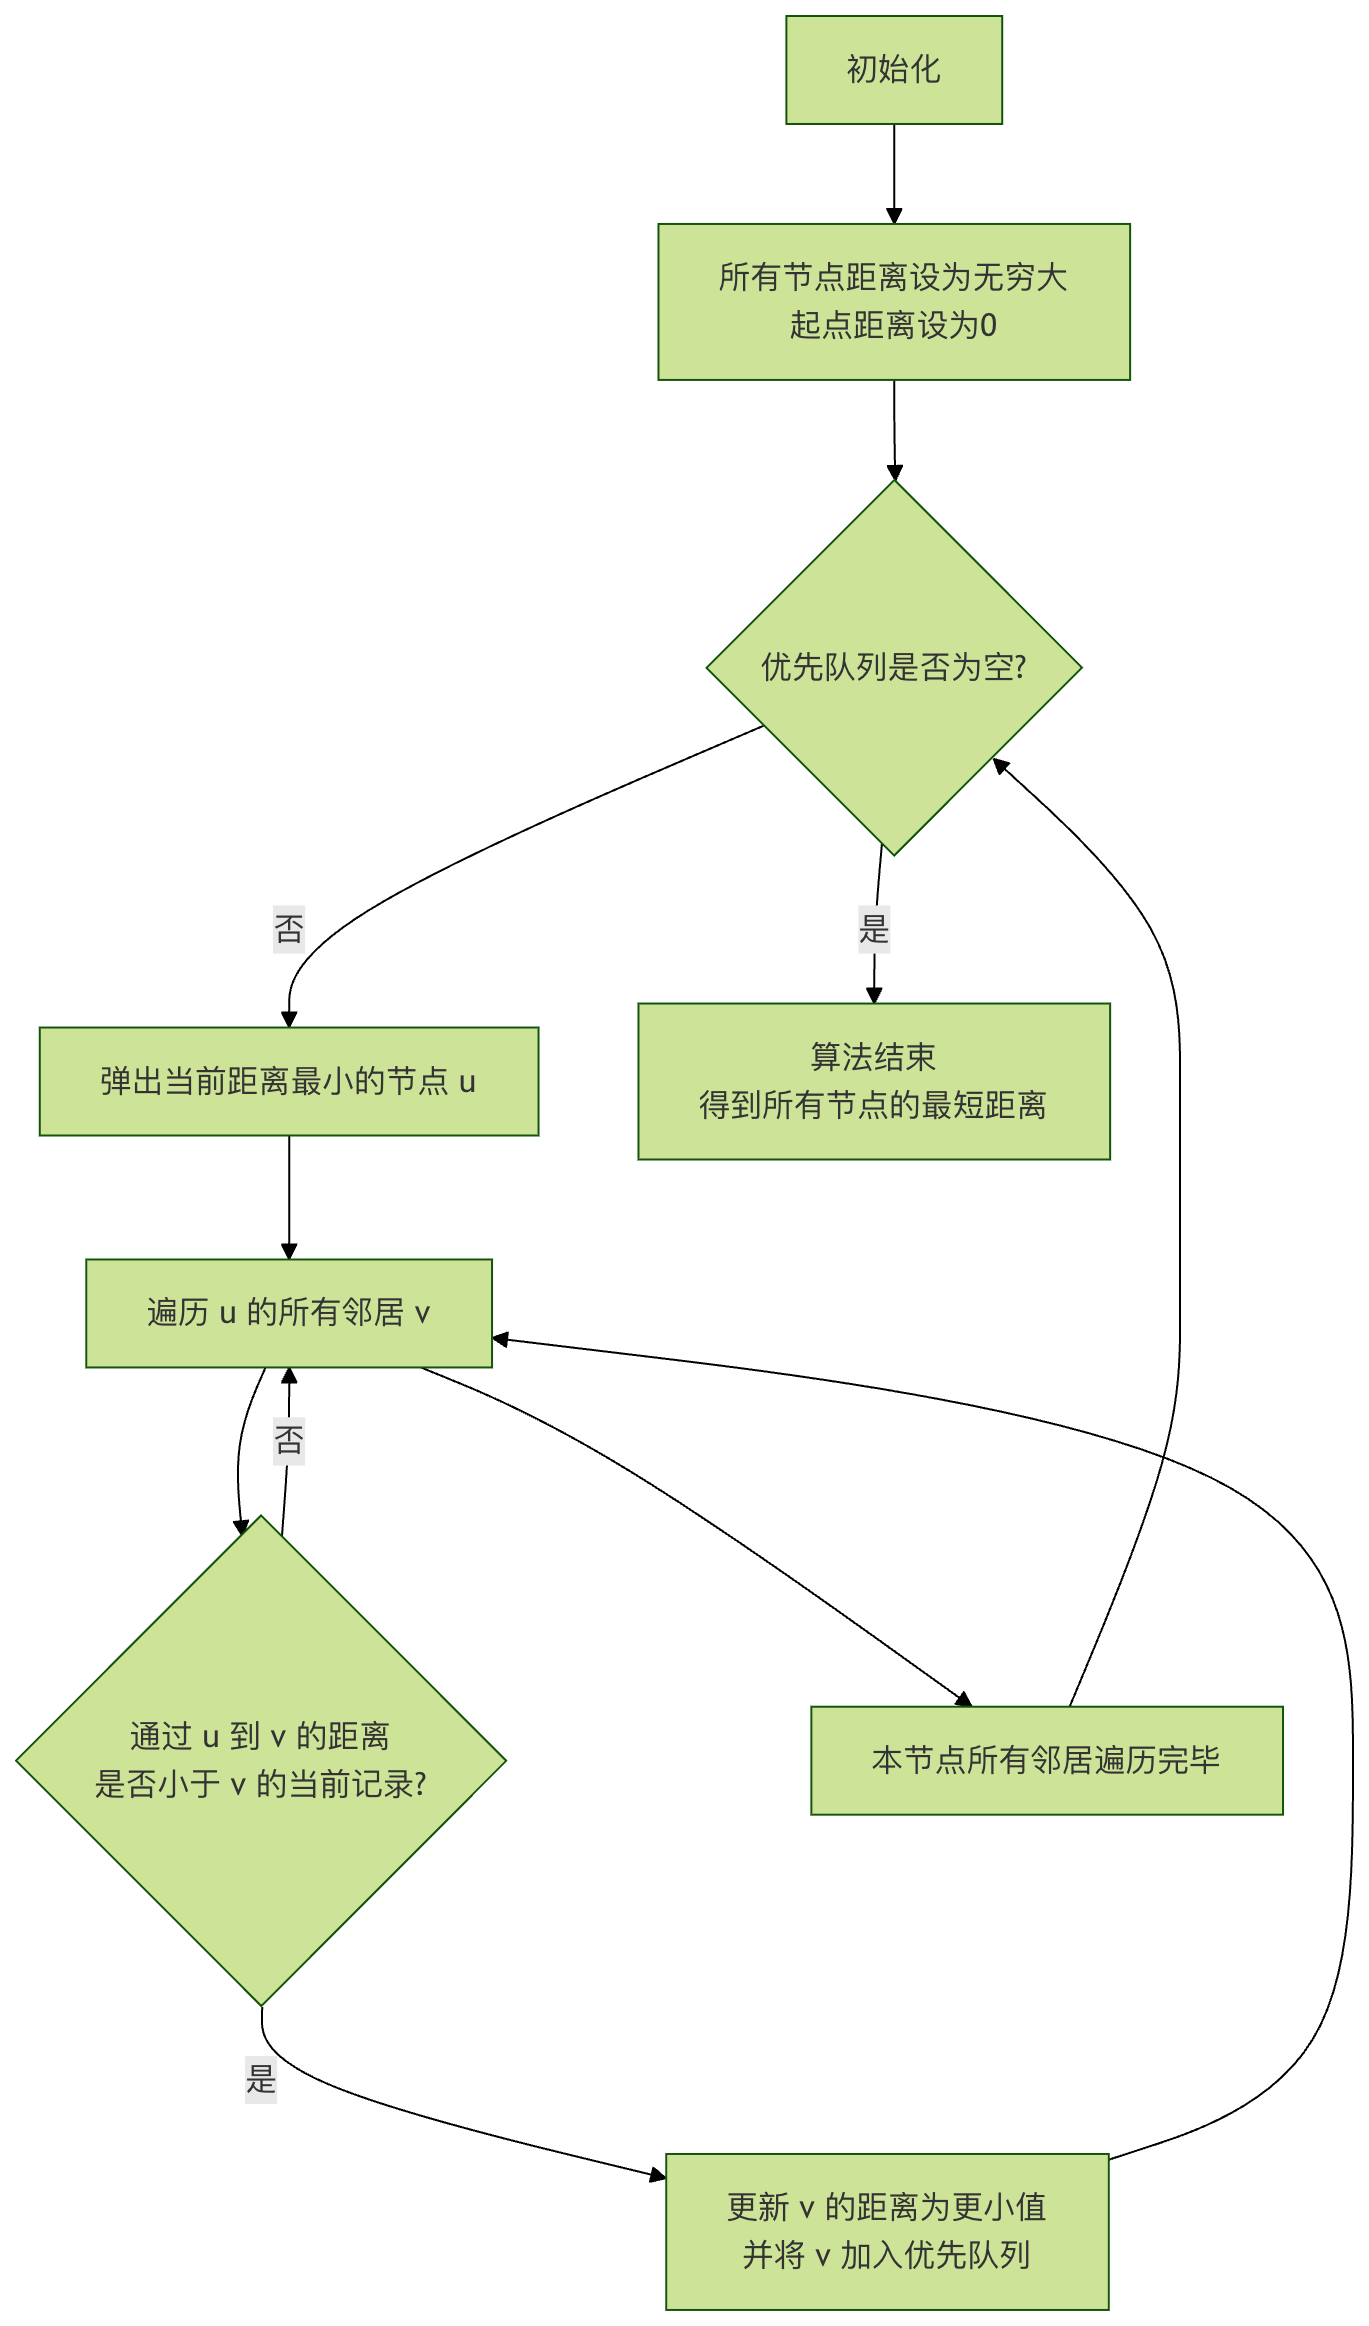
Erklärung des Flussdiagramms: Der Algorithmus beginnt mit der Initialisierung, entnimmt fortlaufend den noch nicht verarbeiteten Knoten, der dem Startpunkt am nächsten liegt, aus der Prioritätswarteschlange und nutzt ihn, um die Distanzschätzungen seiner Nachbarknoten zu relaxieren (zu aktualisieren), bis die Warteschlange leer ist; zu diesem Zeitpunkt sind alle kürzesten Wege bestimmt.
Code-Implementierung und Beispiele
Als Nächstes implementieren wir den Dijkstra-Algorithmus in Python. Wir werdenheapqdieses Modul für Prioritätswarteschlangen (Min-Heap), um effizient den Knoten mit der aktuell kleinsten Distanz zu erhalten.
Beispiel
def dijkstra(graph, start):
"""
Verwende den Dijkstra-Algorithmus, um die kürzesten Distanzen vom Startpunkt start zu allen anderen Knoten im Graphen zu berechnen.
Parameter:
graph: Adjazenzliste, dargestellt als Dictionary. Format: {node: [(neighbor1, weight1), (neighbor2, weight2), ...]}
start: Der Startknoten.
Rückgabe:
Ein Wörterbuch, das die kürzesten Entfernungen von allen Knoten zum Startpunkt enthält.
"""
# Initialisierung: Setze die kürzeste Entfernung aller Knoten auf Unendlich
shortest_distances = {node: float('inf') for node in graph}
shortest_distances[start] = 0 # Die Entfernung vom Startknoten zu sich selbst ist 0
# Verwende eine Prioritätswarteschlange (Min-Heap), die Elemente sind (aktuelle Entfernung, Knoten)
priority_queue = [(0, start)]
while priority_queue:
current_distance, current_node = heapq.heappop(priority_queue)
# Wenn die entnommene Entfernung größer als die gespeicherte Entfernung ist, handelt es sich um veraltete Daten; überspringen
if current_distance > shortest_distances[current_node]:
continue
# Alle Nachbarn des aktuellen Knotens durchlaufen
for neighbor, weight in graph[current_node]:
distance = current_distance + weight
# Wenn ein kürzerer Pfad gefunden wird, aktualisieren
if distance < shortest_distances[neighbor]:
shortest_distances[neighbor] = distance
heapq.heappush(priority_queue, (distance, neighbor))
return shortest_distances
# --- Testbeispiel ---
# Definiere einen gewichteten gerichteten Graphen (Knoten: [(Nachbar, Gewicht), ...])
test_graph = {
'A': [('B', 4), ('C', 2)],
'B': [('C', 1), ('D', 5)],
'C': [('B', 1), ('D', 8), ('E', 10)],
'D': [('E', 2)],
'E': []
}
start_node = 'A'
distances = dijkstra(test_graph, start_node)
print(f"Kürzeste Entfernungen vom Knoten {start_node} zu jedem Knoten:")
for node, dist in distances.items():
print(f" zum Knoten {node}: {dist}")
Code-Erklärung:
shortest_distancesEin Dictionary wird verwendet, um vom Startknoten zu jedem KnotenEndgültige Bestätigungdie kürzeste Entfernung mit einem Anfangswert von unendlich zu speichern.priority_queueEs ist ein Min-Heap, der es uns immer ermöglicht, den Knoten schnell zu entnehmen, der aktuell als dem Startknoten am nächsten geschätzt wird.- In der Hauptschleife,
heapq.heappopEntnehme den obersten Knoten des Heaps (den aktuell nächstgelegenen Knoten). if current_distance > ... : continueEs ist eine entscheidende Optimierung, das mögliche Vorhandensein mehrerer veralteter Versionen (Entfernungswerte) desselben Knotens im Heap zu behandeln.- Beim Durchlaufen der Nachbarn berechne
distance = current_distance + weight, dies ist die "neue Entfernung zum Nachbarn über den aktuellen Knoten." - Wenn die neue Entfernung kürzer ist, aktualisiere sie
shortest_distancesandSchiebe den Nachbarn und seine neue Entfernung in den Heapzur weiteren Verarbeitung.
Wenn Sie den obigen Code ausführen, erhalten Sie die folgende Ausgabe:
从节点 A 出发到各节点的最短距离:
  到节点 A: 0
  到节点 B: 3  # 路径: A -> C -> B
  到节点 C: 2  # 路径: A -> C
  到节点 D: 8  # 路径: A -> C -> B -> D
  到节点 E: 10 # 路径: A -> C -> B -> D -> E
Minimaler Spannbaum und Prim-Algorithmus
Betrachten Sie nun ein anderes Problem: Sie müssen ein Glasfasernetz für ein neu gebautes Wohngebiet verlegen, das alle Häuser verbindet, aber um Kosten zu sparen, möchten Sie, dass die Gesamtlänge der verwendeten Glasfaser möglichst kurz ist. Wie wählen Sie angesichts der Kosten (Gewicht) für das Verlegen von Glasfaser zwischen je zwei Häusern aus, welche Leitungen verlegt werden?
Dieses Problem erfordert, dass wir einenTeilgraphen finden, der alle Knoten verbindet, und dieser Teilgraph ist ein Baum (azyklisch), und das Gesamtgewicht aller seiner KantenDie Summe der Gewichte wird minimiert. Dieser Baum heißtMinimaler Spannbaum (MST)。
Idee des Prim-Algorithmus
Prim-AlgorithmusEr ist ein Greedy-Algorithmus zum Finden eines MST. Sein Ablauf ähnelt sehr dem "Wachsen eines Baumes":
- Beginnen Sie bei einem beliebigen Knoten und initialisieren Sie den Baum so, dass er nur diesen Knoten enthält.
- Wählen Sie unter allenKanten, die interne Knoten und externe Knoten des Baums verbinden, eineKante mit minimalem Gewichtaus.
- Fügen Sie diese Kante und den Knoten, den sie verbindet– den externen Knoten– zum Baum hinzu.
- Wiederholen Sie die Schritte 2 und 3, bis alle Knoten im Baum enthalten sind.
Code-Implementierung und Beispiele
Die Implementierung des Prim-Algorithmus ist der von Dijkstra sehr ähnlich; der Unterschied liegt in der Definition der Distanz.
Im Prim-Algorithmus ist das, was wir verwalten, die Distanz von jedem Knoten zumaktuellen Spannbaum, also die minimalen Verbindungskosten.
Beispiel
def prim_mst(graph):
"""
Verwende den Algorithmus von Prim, um das Gesamtgewicht des minimalen Spannbaums (MST) des Graphen zu berechnen.
Parameter:
graph: Adjazenzliste, dargestellt als Dictionary. Format: {node: [(neighbor1, weight1), (neighbor2, weight2), ...]}
Gehe davon aus, dass der Graph zusammenhängend ist.
Rückgabe:
Das Gesamtgewicht des minimalen Spannbaums.
"""
start_node = list(graph.keys())[0] # Beginne bei einem beliebigen Knoten; hier den ersten nehmen
visited = set([start_node]) # Menge der Knoten, die bereits zum MST hinzugefügt wurden
# Prioritätswarteschlange, die (Kantengewicht, Nachbarknoten) speichert
# Initialisierung: Füge alle Kanten des Startknotens zur Warteschlange hinzu
edges = [(weight, start_node, neighbor) for neighbor, weight in graph[start_node]]
heapq.heapify(edges)
total_weight = 0
while edges:
weight, from_node, to_node = heapq.heappop(edges)
if to_node not in visited:
visited.add(to_node) # Neuen Knoten zum MST hinzufügen
total_weight += weight # Gesamtgewicht des MST akkumulieren
print(f"Kante hinzufügen: {from_node} - {to_node}, Gewicht: {weight}") # Ausgewählte Kanten ausgeben
# Alle Kanten, die den neuen Knoten mit externen Knoten verbinden, zur Warteschlange hinzufügen
for neighbor, w in graph[to_node]:
if neighbor not in visited:
heapq.heappush(edges, (w, to_node, neighbor))
return total_weight
# --- Testbeispiel ---
# Definieren Sie einen ungerichteten gewichteten Graphen (jede Kante erscheint zweimal in der Adjazenzliste)
test_graph_undirected = {
'A': [('B', 4), ('C', 2)],
'B': [('A', 4), ('C', 1), ('D', 5)],
'C': [('A', 2), ('B', 1), ('D', 8), ('E', 10)],
'D': [('B', 5), ('C', 8), ('E', 2)],
'E': [('C', 10), ('D', 2)]
}
print("Der Prozess des Aufbaus des minimalen Spannbaums:")
mst_weight = prim_mst(test_graph_undirected)
print(f"\nDas Gesamtgewicht des minimalen Spannbaums beträgt: {mst_weight}")
Code-Erklärung:
visitedDie Menge speichert die Knoten, die bereits zum MST gehören.edgesist ein Min-Heap, der alleKanten speichert, die den Innen- und Außenbereich des MST überspannenKante (d. h. ein Endpunkt ist invisited, das andere Ende liegt nicht darin).- In der Hauptschleife wird immer die Kante mit dem kleinsten Gewicht aus dem Heap entnommen
(weight, from_node, to_node)。 - Wenn der mit dieser Kante verbundene Knoten
to_nodenoch nicht besucht wurde, dann ist sie eine gültige MST-Kante. Füge sie zum Ergebnis hinzu und aktualisierevisitedundtotal_weight。 - Füge den neuen Knoten hinzu
to_nodealle seine Kanten, die zu externen Knoten führen, werden für die nächste Auswahlrunde zum Heap hinzugefügt.
Führen Sie den obigen Code aus und Sie sehen den Aufbauprozess des MST:
构建最小生成树的过程:
添加边: A - C, 权重: 2
添加边: C - B, 权重: 1
添加边: A - B, 权重: 4  # 注意:这条边连接B和A,但B已在树中,所以会被下一行的if语句跳过,不会添加。
添加边: B - D, 权重: 5
添加边: D - E, 权重: 2

最小生成树的总权重为: 10
(Hinweis: In der tatsächlichen Ausgabe die Kante A - B, weilto_nodeB bereits vorhanden istvisited, daher wird sie nicht ausgeführtprintAnweisung. Der obige Kommentar dient der Erklärung.)Die endgültigen MST-Kanten sind A-C, C-B, B-D, D-E, und das Gesamtgewicht beträgt 2+1+5+2=10.
Topologische Sortierung: Umgang mit Aufgaben mit Abhängigkeiten
Wenn Sie eine Reihe von Aufgaben planen müssen und einige Aufgaben erst nach dem Abschluss anderer Aufgaben beginnen dürfen (z. B. muss das Anziehen von Socken vor dem Anziehen von Schuhen erfolgen), wie würden Sie eine sinnvolle Ausführungsreihenfolge bestimmen? Die Abhängigkeiten zwischen Aufgaben können durchGerichteter azyklischer Graph (DAG)dargestellt werden, und der Prozess zum Finden einer zulässigen linearen Ausführungsreihenfolge istTopologische Sortierung。
Kahn-Algorithmus (basierend auf Eingangsgrad)
Kahn-AlgorithmusEr ist einer der intuitivsten Algorithmen für die topologische Sortierung und basiert auf dem Eingangsgrad (der Anzahl der Kanten, die auf den Knoten zeigen).
- Finden Sie alle Knoten mit Eingangsgrad 0; sie sind Aufgaben, die sofort ausgeführt werden können (keine Voraussetzungsabhängigkeiten).
- Fügen Sie diese Knoten in eine Warteschlange ein und "entfernen" Sie sie aus dem Graphen (geben Sie sie im Sortierergebnis aus).
- Nach dem "Entfernen" eines Knotens aktualisieren Sie den Eingangsgrad aller seiner Nachbarn (um 1 verringern). Wenn der Eingangsgrad eines Nachbarn dadurch 0 wird, fügen Sie ihn zur Warteschlange hinzu.
- Wiederhole die Schritte 2 und 3, bis die Warteschlange leer ist.
- Wenn die Anzahl der ausgegebenen Knoten gleich der Gesamtzahl der Knoten im Graphen ist, ist die Sortierung erfolgreich; andernfalls bedeutet das, dass der Graph einen Zyklus enthält und nicht topologisch sortiert werden kann.
Code-Implementierung und Beispiele
Beispiel
def topological_sort_kahn(graph):
"""
Verwende Kahns Algorithmus zur topologischen Sortierung.
Parameter:
graph: Adjazenzliste als Dictionary dargestellt. Format: {node: [neighbor1, neighbor2, ...]}
Rückgabe:
Wenn eine topologische Sortierung existiert, gib eine Liste zurück (die sortierte Reihenfolge); andernfalls gib None zurück (ein Zyklus existiert).
"""
# 1. Berechne den Eingangsgrad aller Knoten
in_degree = {node: 0 for node in graph}
for node in graph:
for neighbor in graph[node]:
in_degree[neighbor] = in_degree.get(neighbor, 0) + 1
# 2. Initialisiere die queue und reihe alle Knoten mit Eingangsgrad 0 ein
queue = deque([node for node in in_degree if in_degree[node] == 0])
topo_order = []
# 3. Verarbeite die queue
while queue:
current_node = queue.popleft()
topo_order.append(current_node)
# "Entferne" den aktuellen Knoten und aktualisiere die Eingangsgrade seiner Nachbarn
for neighbor in graph.get(current_node, []):
in_degree[neighbor] -= 1
if in_degree[neighbor] == 0:
queue.append(neighbor)
# 4. Prüfe, ob alle Knoten sortiert wurden
if len(topo_order) == len(graph):
return topo_order
else:
return None # Ein Zyklus existiert im Graphen
# --- Testbeispiel ---
# Definiere einen gerichteten Graphen der Kursabhängigkeiten
# Zum Beispiel: Bevor du den Algorithmenkurs (Algo) belegst, musst du den Datenstrukturkurs (DS) belegen.
course_graph = {
Programmierung: [Datenstrukturen, Algorithmen],
Datenstrukturen: [Algorithmen, Datenbanken],
Algorithmen: [Maschinelles Lernen],
Datenbanken: [Systemdesign],
Mathematik: [Maschinelles Lernen],
Maschinelles Lernen: [],
Systemdesign: []
}
print("Kursabhängigkeitsgraph:")
for course, deps in course_graph.items():
print(f" {course} -> {deps}")
result = topological_sort_kahn(course_graph)
if result:
print(f"\nEine mögliche Reihenfolge zum Erlernen der Kurse (topologische Sortierung) ist:")
print(" -> ".join(result))
else:
print("\nDer Kursplan hat zirkuläre Abhängigkeiten und kann nicht sortiert werden!")
Zeilenweise Codeanalyse:
in_degreeEin Dictionary speichert den Eingangsgrad jedes Knotens. Durch das Durchlaufen der Adjazenzliste kannst du berechnen, wie viele Kanten auf jeden Knoten zeigen.- Warteschlange initialisieren
queue, füge alle Knoten mit "keinen Voraussetzungsaufgaben" (Eingangsgrad 0) zur Warteschlange hinzu. - Entnimm in der Hauptschleife Knoten aus der Warteschlange und füge sie der Ergebnisliste hinzu
topo_order, was dem Abschließen dieser Aufgabe entspricht. - Durchlaufe alle Nachfolgeraufgaben (Nachbarn) dieser Aufgabe und verringere ihren Eingangsgrad um 1. Wenn er auf 0 sinkt, bedeutet das, dass alle Voraussetzungsaufgaben dieser Aufgabe abgeschlossen sind, und sie kann zur Ausführung in die Warteschlange aufgenommen werden.
- Prüfe abschließend die Länge des Sortierungsergebnisses. Stimmt sie mit der Anzahl der Knoten im Graphen überein, ist die Sortierung erfolgreich; andernfalls bedeutet es, dass einige Knoten stets Voraussetzungsabhängigkeiten haben (Eingangsgrad ungleich 0), was bedeutet, dass ein Zyklus im Graphen vorliegt.
Führe den obigen Code aus, und du erhältst eine machbare Lernreihenfolge:
Course dependency graph:
  程序设计 -> ['数据结构', '算法']
  数据结构 -> ['算法', '数据库']
  算法 -> ['机器学习']
  数据库 -> ['系统设计']
  数学 -> ['机器学习']
  机器学习 -> []
  系统设计 -> []

A feasible course learning order (topological sort) is:
程序设计 -> 数学 -> 数据结构 -> 算法 -> 数据库 -> 机器学习 -> 系统设计
Hinweis: Das Ergebnis der topologischen Sortierung ist möglicherweise nicht eindeutig. Zum Beispiel sind sowohl Mathematik als auch Programmieren Startknoten mit Eingangsgrad 0, und jede von beiden kann zuerst kommen.
Algorithmusvergleich und Anwendungsszenarien
Damit du diese Algorithmen besser verstehen und auswählen kannst, fasst die folgende Tabelle ihre wichtigsten Merkmale zusammen:
| Algorithmen | Hauptzweck | Anwendbare Graphtypen | Kernidee | Zeitkomplexität (unter Verwendung einer Prioritätswarteschlange) | Typische Anwendungsszenarien |
|---|---|---|---|---|---|
| Dijkstra | Kürzeste Wege von einer Quelle | mit nicht-negativen Gewichtengerichteter/ungerichteter Graph | Greedy, wobei jedes Mal der Knoten expandiert wird, der dem Startknoten aktuell am nächsten ist | O((V+E) log V) | Kartennavigation, Netzwerkrouting |
| Prim | Minimaler Spannbaum (MST) | Gewichteter zusammenhängender ungerichteter Graph | Greedy, wobei jedes Mal der Knoten, der dem aktuellen Spannbaum am nächsten ist, in den Baum aufgenommen wird | O((V+E) log V) | Netzwerkverkabelung, Leiterplattendesign, Clusteranalyse |
| Kahn (topologische Sortierung) | Aufgabenplanung und Reihenfolge | Gerichteter azyklischer Graph (DAG) | Auf Basis des Eingangsgrads werden wiederholt Knoten ohne Voraussetzungsabhängigkeiten entfernt | O(V+E) | Kursplanung, Abhängigkeiten von Build-Systemen, Kompilierreihenfolge |
Übungsaufgaben
Nur zuzusehen ist nicht genug; du brauchst praktische Übung, um es wirklich zu beherrschen! Bitte versuche, die folgenden Übungen abzuschließen:
Übung 1: Dijkstra-Algorithmus korrigieren
Der folgende Code soll den Dijkstra-Algorithmus implementieren, weist aber mehrere Fehler auf. Bitte finde und behebe sie.
Beispiel
def wrong_dijkstra(graph, start):
dist = {node: float('inf') for node in graph}
dist[start] = 0
pq = [(0, start)]
while pq:
cur_dist, cur_node = pq.pop(0) # Hier könnte ein Problem vorliegen
for neighbor, weight in graph[cur_node]:
if cur_dist + weight < dist[neighbor]:
dist[neighbor] = cur_dist + weight
# Hier könnte etwas sein
return dist
Übung 2: Implementiere Kruskals Algorithmus
Prims Algorithmus ist eine Methode zum Finden eines MST; eine andere klassische Methode istKruskals Algorithmus. Die Idee ist:
- Sortiere alle Kanten im Graphen nach Gewicht vom kleinsten zum größten.
- Betrachte jede Kante der Reihe nach; wenn die beiden durch diese Kante verbundenen KnotenNicht in derselben Zusammenhangskomponente(d.h. das Hinzufügen erzeugt keinen Zyklus), dann füge sie dem Graphen hinzu.
- Wiederhole Schritt 2, bis der MST V-1 Kanten hat (V ist die Anzahl der Knoten).
Deine Aufgabe: Versuche, die Datenstruktur "Disjoint Set Union (DSU)" zu verwenden, um Kruskals Algorithmus zu implementieren, um effizient zu bestimmen, ob zwei Knoten verbunden sind.
Übung 3: Herausforderung mit echten Daten
Angenommen, du hast einefriendships.jsonDie Datei zeichnet Benutzer (dargestellt durch IDs) und ihre Freundschaftsbeziehungen in einem sozialen Netzwerk auf. Jede Beziehung hat ein "Intimität"-Gewicht.
[
  {"user_id": 1, "friend_id": 2, "closeness": 5},
  {"user_id": 1, "friend_id": 3, "closeness": 2},
  {"user_id": 2, "friend_id": 3, "closeness": 1},
  {"user_id": 2, "friend_id": 4, "closeness": 6},
  {"user_id": 3, "friend_id": 4, "closeness": 3},
  {"user_id": 4, "friend_id": 5, "closeness": 4}
]
Problem: Wenn das "Intimität"-Gewicht als Distanz betrachtet werden kann (je kleiner der Wert, desto enger die Beziehung), berechne bitte vom Benutzer1start, zu allen anderen Benutzern den "intimsten Pfad" (d. h. den Pfad mit der kleinsten Gewichtssumme). Welchen Algorithmus solltest du verwenden? Bitte schreibe Code, um es zu lösen.