Baumstruktur
Ein Baum ist einenicht-lineareDatenstruktur, die die verzweigte Hierarchie von Bäumen in der Natur simuliert. Im Gegensatz zu linearen Strukturen wie Arrays und verketteten Listen, bei denen die Elemente nacheinander angeordnet sind, gibt es unter den Datenelementen in einem Baum (genanntKnoten) eine klare hierarchische Eins-zu-viele-Beziehung zwischen ihnen.
BaumstrukturGenau wie ein echter Baum:
- Wurzelknoten: der Wurzelteil des Baums, der einzige Knoten ohne Elternknoten
- Kindknoten: Knoten, die von einem Knoten abzweigen
- Blattknoten: ein Knoten ohne Kinder, wie ein Blatt
- Pfad: der Weg von einem Knoten zu einem anderen Knoten
- Tiefe: die Pfadlänge vom Wurzelknoten zu diesem Knoten
- Höhe: die Pfadlänge von diesem Knoten zum am weitesten entfernten Blattknoten
Lebensanalogie:
- Stammbaum: Großeltern → Eltern → Kinder → Enkelkinder
- Organisationsstruktur: CEO → Direktor → Manager → Mitarbeiter
- Dateisystem: Wurzelverzeichnis → Unterverzeichnis → Datei
- Buchklassifikation: allgemeine Kategorie → Unterkategorie → spezifisches Buch
| Strukturtyp | Sucheffizienz | Einfügeeffizienz | Löscheffizienz | Reihenfolge |
|---|---|---|---|---|
| array | O(n) | O(n) | O(n) | Keine |
| Verkettete Liste | O(n) | O(1) | O(1) | Keine |
| Hash-Tabelle | O(1) | O(1) | O(1) | Keine |
| Binärer Suchbaum | O(log n) | O(log n) | O(log n) | Ja |
Grundbegriffe
Bevor wir tiefer eingehen, machen wir uns zunächst mit der grundlegenden Terminologie von Bäumen vertraut:
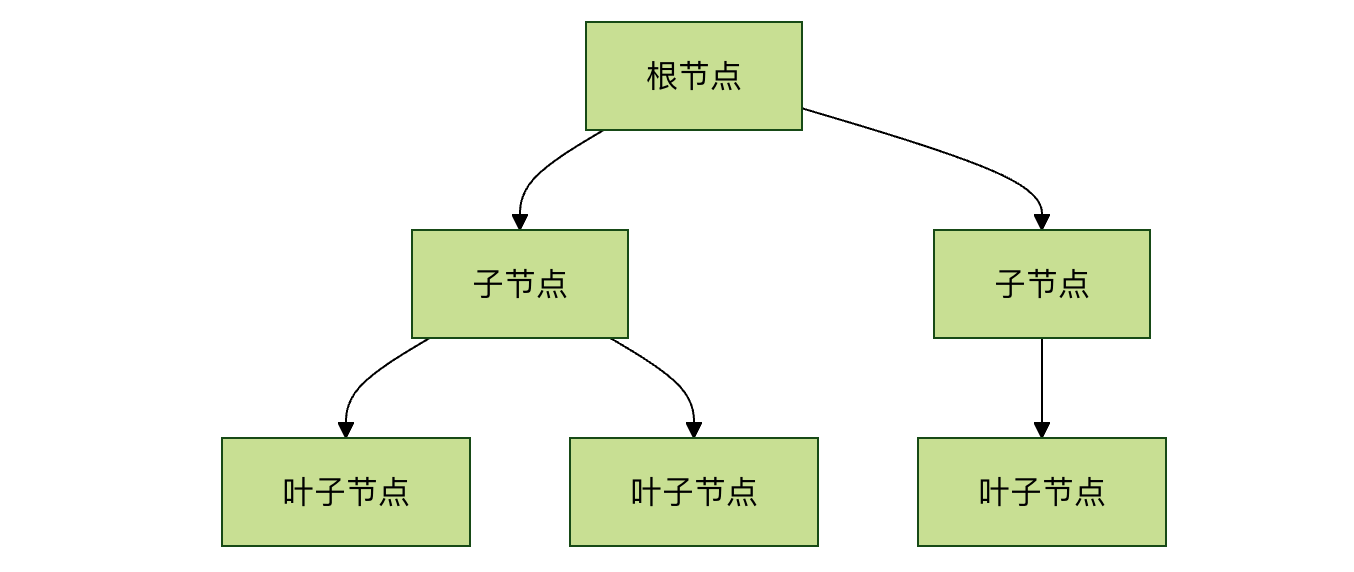
- Knoten: jedes Element in einem Baum. Er enthält die gespeicherten Daten und Verweise auf seine Kindknoten.
- Wurzelknoten: der Knoten an der Spitze des Baums, der Ausgangspunkt des gesamten Baums. Ein Baum hat genau einen Wurzelknoten.
- Elternknoten und Kindknoten (Eltern & Kind): Wenn ein Knoten A mit einem Knoten B unter ihm verbunden ist, dann ist A derElternknotenvon B, B ist derKindknotenvon A. Ein Elternknoten kann mehrere Kindknoten haben.
- Geschwisterknoten (Geschwister): Knoten, die denselben Elternknoten teilen, sind Geschwister.
- Blattknoten (Blatt): ein Knoten ohne Kindknoten, auch Endknoten genannt.
- Kante: die Linie, die zwei Knoten verbindet und die Beziehung zwischen ihnen darstellt.
- Pfad: die Abfolge von Knoten, die vom Wurzelknoten zu einem bestimmten Knoten durchlaufen werden.
- Höhe: auf dem längsten Pfad von einem Knoten zu seinem am weitesten entfernten BlattknotenAnzahl der Kanten. Die Höhe des Baums ist die Höhe des Wurzelknotens.
- Tiefe: auf dem Pfad vom Wurzelknoten zu einem bestimmten KnotenAnzahl der Kanten. Die Tiefe des Wurzelknotens ist 0.
- Ebene: Alle Knoten mit derselben Tiefe gehören zur selben Ebene. Der Wurzelknoten befindet sich auf Ebene 0.
Grundlegende Eigenschaften von Bäumen
- eindeutiger Pfad: Zwischen zwei beliebigen Knoten in einem Baum gibt es genau einen Pfad.
- N Knoten, N-1 Kanten: Ein Baum mit N Knoten hat insgesamt N-1 Kanten.
- azyklisch: In einem Baum gibt es keine Zyklen (d. h., wenn man von einem Knoten startet und den Kanten folgt, kann man nicht zu diesem Knoten zurückkehren).
Warum brauchen wir Bäume? — Vorteile und Anwendungen von Bäumen
Vielleicht fragen Sie sich: Wo wir doch Arrays und verkettete Listen haben, warum brauchen wir noch Bäume? Die Antwort liegt in der Effizienz.
- Array: schnelles Nachschlagen (über Index), aber langsames Einfügen und Löschen (erfordert das Verschieben vieler Elemente).
- Verkettete Liste: schnelles Einfügen und Löschen, aber langsames Nachschlagen (erfordert das Durchlaufen vom Anfang).
- Bäume (insbesondere binäre Suchbäume): Während sie Daten geordnet halten, können sie eine viel schnellere Suchgeschwindigkeit als verkettete Listen und effizientere Einfüge-/Löschoperationen als Arrays bieten.
Praktische Anwendungsszenarien:
- Dateisystem: Ordner und Dateien in Computern sind in Form eines Baumes organisiert.
- Datenbankindex: B-Baum und B+-Baum sind Kern-Datenstrukturen für effiziente Abfragen in Datenbanken.
- Organigramm: die hierarchische Verwaltung eines Unternehmens oder einer Abteilung.
- Entscheidungsbaum: Klassifikationsmodelle in der künstlichen Intelligenz und im maschinellen Lernen.
- HTML DOM: das Document Object Model einer Webseite ist ein Baum.
Binärbaum: das wichtigste Mitglied der Baumfamilie
Ein Binärbaum ist ein Baum, in dem jeder Knoten höchstens zwei Kindknoten hat. Diese beiden Kindknoten heißen üblicherweiselinker Kindknotenundrechter Kindknoten, er ist die Grundlage vieler leistungsfähiger Baumstrukturen (wie binäre Suchbäume, Heaps und AVL-Bäume).
Die Grundstruktur ist wie folgt:
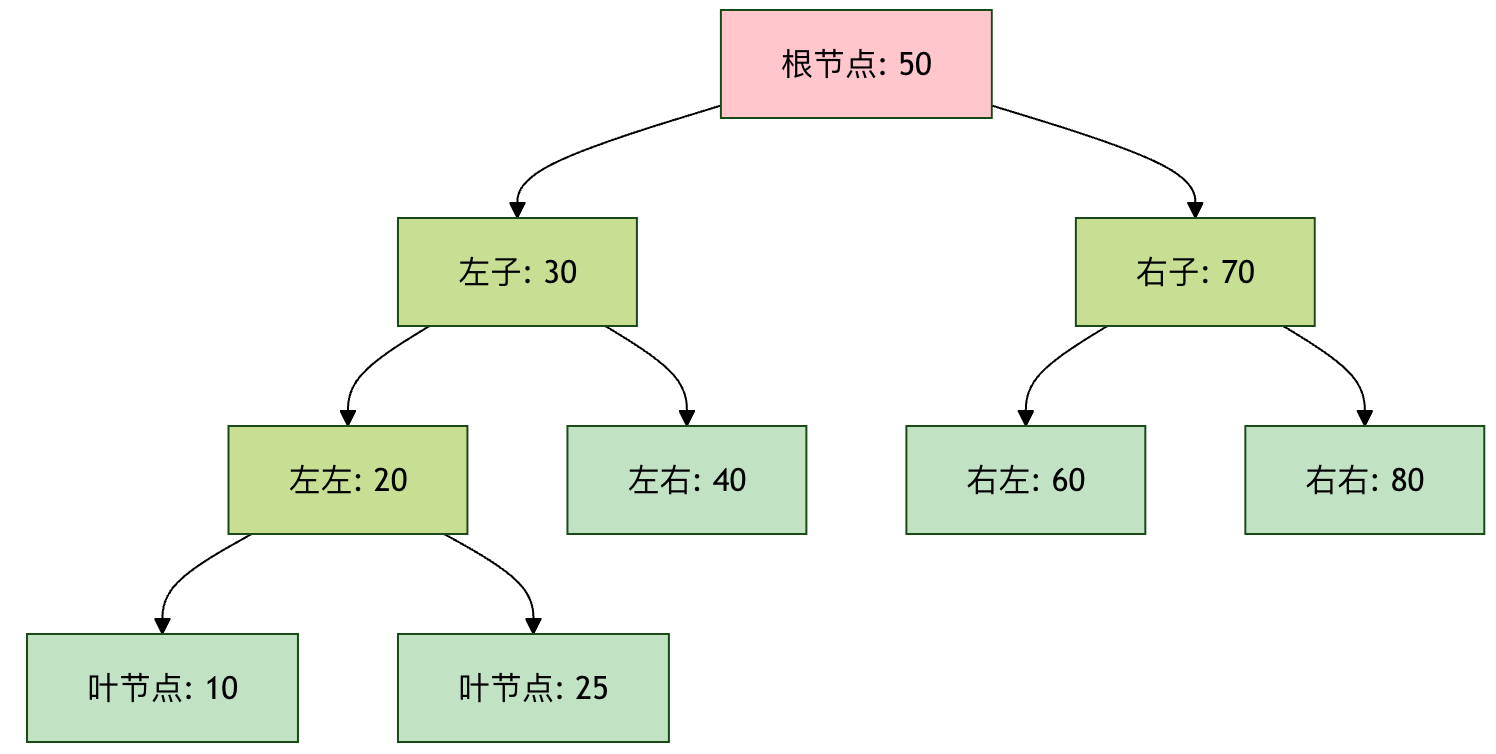
Grundbegriffe für Binärbäume
| Begriff | Definition | Alltagsanalogie |
|---|---|---|
| Knoten | die Grundeinheit, die Daten und Zeiger enthält | Eine Person in der Familie |
| Wurzelknoten | Der oberste Knoten eines Baums | Ein Vorfahre in der Familie |
| Elternknoten | Ein Knoten mit Kindknoten | Elternknoten |
| Kindknoten | der Knoten, auf den sein Elternknoten zeigt | children |
| Geschwisterknoten | Kindknoten desselben Elternknotens | Geschwisterknoten |
| Blattknoten | ein Knoten ohne Kinder | eine Person in der Familie ohne Kinder |
| depth | die Anzahl der Kanten von der Wurzel zu diesem Knoten | Anzahl der Generationen |
| height | die Anzahl der Kanten von diesem Knoten zum am weitesten entfernten Blattknoten | die Anzahl der Generationen, über die sich die Familie fortsetzt |
Binärbaumtyp
| Type | Funktionen | Zeitkomplexität | Anwendungsszenarien |
|---|---|---|---|
| gewöhnlicher Binärbaum | jeder Knoten hat höchstens 2 Kindknoten | O(n) | Ausdrucksbaum |
| vollständiger Binärbaum | jeder Knoten hat entweder 0 oder 2 Kindknoten | O(n) | Huffman-Kodierung |
| vollständiger Binärbaum | alle Ebenen außer der letzten sind voll | O(n) | Heap-Implementierung |
| Binärer Suchbaum | links < Wurzel < rechts | Durchschnittlich O(log n) | Suchen, Sortieren |
| balancierter Binärbaum | Der Höhenunterschied zwischen dem linken und dem rechten Teilbaum ist ≤ 1 | O(log n) | Datenbankindex |
| Rot-Schwarz-Baum | Farbiger balancierter Baum | O(log n) | Linux-Kernel |
Operationen auf binären Suchbäumen
| Aktion | Beschreibung | Zeitkomplexität |
|---|---|---|
| Suche | Knoten nach Wert suchen | durchschnittlich O(log n), im schlechtesten Fall O(n) |
| Einfügen | neuen Knoten einfügen | durchschnittlich O(log n), im schlechtesten Fall O(n) |
| Delete | Angegebenen Knoten löschen | durchschnittlich O(log n), im schlechtesten Fall O(n) |
| Traversierung | Alle Knoten besuchen | O(n) |
Traversierung eines Binärbaums
Traversierung bedeutet, jeden Knoten im Baum nach einer bestimmten Regel zu besuchen, wobei jeder Knoten nur einmal besucht wird. Dies ist die Grundlage baumbezogener Algorithmen. Es gibt hauptsächlich vier Möglichkeiten:
Preorder-Traversierung:Wurzel -> Links -> Rechts
- Zuerst wird der Wurzelknoten besucht, dann wird der linke Teilbaum rekursiv in Preorder-Reihenfolge durchlaufen und schließlich der rechte Teilbaum rekursiv in Preorder-Reihenfolge durchlaufen.
- Anwendung: Einen Baum kopieren, Präfixausdruck erhalten.
In-order-Traversierung:Links -> Wurzel -> Rechts
- Zuerst rekursiv den linken Teilbaum inorder durchlaufen, dann den Wurzelknoten besuchen und schließlich rekursiv den rechten Teilbaum inorder durchlaufen.
- Anwendung: inbinärem SuchbaumUnter ihnen wird die In-order-Traversierungaufsteigende ReihenfolgeOutput all values.
Post-order-Traversierung:Links -> Rechts -> Wurzel
- Zuerst rekursiv den linken Teilbaum postorder durchlaufen, dann rekursiv den rechten Teilbaum postorder durchlaufen und schließlich den Wurzelknoten besuchen.
- Anwendung: Einen Baum löschen, Verzeichnisgröße berechnen.
Level-order-Traversierung:Ebene für Ebene, von links nach rechts
- Ausgehend vom Wurzelknoten werden Knoten Ebene für Ebene besucht.
- Anwendung: Daten ebenenweise verarbeiten (z. B. Drucken eines Organigramms).Sie wird üblicherweise mithilfe einer Warteschlange (Queue) implementiert.。
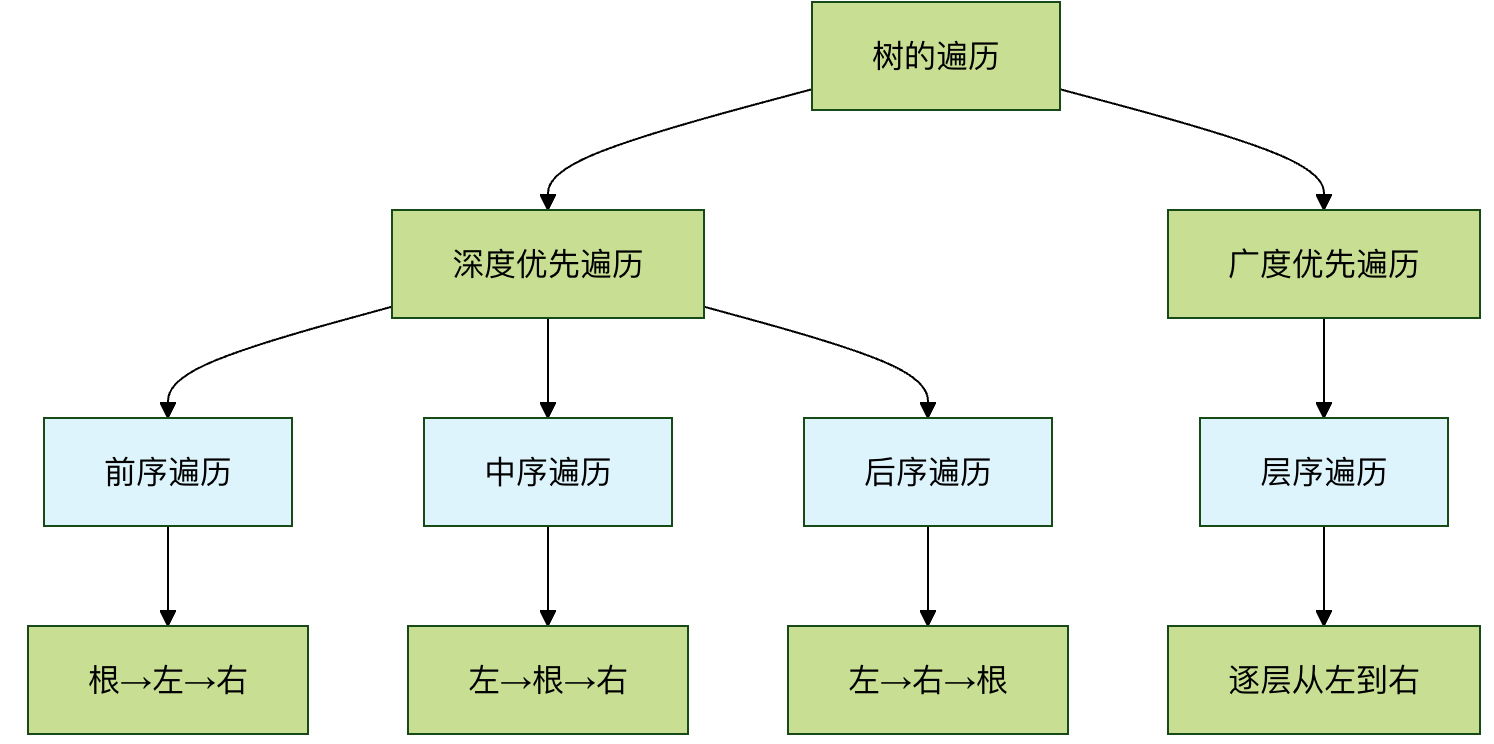
Beispiel: Für den untenstehenden Baum sind die Traversierungsergebnisse wie folgt:
        1
       / \
      2   3
     / \   \
    4   5   6
- Preorder:1, 2, 4, 5, 3, 6
- Inorder:4, 2, 5, 1, 3, 6
- Postorder:4, 5, 2, 6, 3, 1
- Ebenenreihenfolge:1, 2, 3, 4, 5, 6
Übung: Implementiere einen Binärbaum in Python
Genug der Theorie, lass uns etwas Code schreiben! Wir werden eine einfache Knotenklasse für Binärbäume implementieren und Einfüge- und Traversierungsoperationen vervollständigen.
Schritt 1: Definiere die Knotenklasse
Jeder Knoten muss Daten speichern und auf seinen linken und rechten Kindknoten verweisen.
Beispiel
"""Binärbaum-Knotenklasse"""
def __init__(self, value):
self.value = value # Im Knoten gespeicherte Daten
self.left = None # Zeigt auf den linken Kindknoten
self.right = None # Zeigt auf den rechten Kindknoten
def __str__(self):
"""Praktisch zum Ausgeben von Knoteninformationen"""
return f"Node({self.value})"
Schritt 2: Einen Beispielbaum erstellen
Lass uns den Baum manuell anhand des vorherigen Beispieldiagramms aufbauen.
Beispiel
root = TreeNode(1)
node2 = TreeNode(2)
node3 = TreeNode(3)
node4 = TreeNode(4)
node5 = TreeNode(5)
node6 = TreeNode(6)
# Verbindungen aufbauen (Verknüpfungen)
root.left = node2
root.right = node3
node2.left = node4
node2.right = node5
node3.right = node6
print(f"Wurzelknoten: {root}")
print(f"Linkes Kind des Wurzelknotens: {root.left}")
print(f"Rechtes Kind des Wurzelknotens: {root.right}")
Schritt 3: Traversierungsalgorithmen implementieren (rekursive Version)
Rekursion ist der intuitivste Weg, Baumtraversierung zu implementieren.
Beispiel
"""Preorder-Traversierung: Wurzel -> links -> rechts"""
if node is None:
return
print(node.value, end=' ') # 1. Wurzelknoten besuchen
preorder_traversal(node.left) # 2. Linken Teilbaum durchlaufen
preorder_traversal(node.right) # 3. Rechten Teilbaum durchlaufen
def inorder_traversal(node):
"""Inorder-Traversierung: links -> Wurzel -> rechts"""
if node is None:
return
inorder_traversal(node.left) # 1. Linken Teilbaum durchlaufen
print(node.value, end=' ') # 2. Wurzelknoten besuchen
inorder_traversal(node.right) # 3. Rechten Teilbaum durchlaufen
def postorder_traversal(node):
"""Postorder-Traversierung: links -> rechts -> Wurzel"""
if node is None:
return
postorder_traversal(node.left) # 1. Linken Teilbaum durchlaufen
postorder_traversal(node.right) # 2. Rechten Teilbaum durchlaufen
print(node.value, end=' ') # 3. Wurzelknoten besuchen
print("\n--- Traversierungsdemo ---")
print("Ergebnis der Preorder-Traversierung:", end=' ')
preorder_traversal(root) # Ausgabe: 1 2 4 5 3 6
print("\nErgebnis der Inorder-Traversierung:", end=' ')
inorder_traversal(root) # Ausgabe: 4 2 5 1 3 6
print("\nErgebnis der Postorder-Traversierung:", end=' ')
postorder_traversal(root) # Ausgabe: 4 5 2 6 3 1
Schritt 4: Level-Order-Traversierung implementieren (mithilfe einer Warteschlange)
Die Level-Order-Traversierung muss die "First-In-First-Out"-Eigenschaft einer Warteschlange nutzen.
Beispiel
def level_order_traversal(root):
"""Levelorder-Traversierung: Verwenden einer Warteschlange"""
if root is None:
return
queue = deque([root]) # Warteschlange initialisieren und Wurzelknoten einreihen
while queue:
current_node = queue.popleft() # 1. Knoten von links aus der Warteschlange entnehmen
print(current_node.value, end=' ') # 2. Diesen Knoten besuchen
# 3. Die Kindknoten dieses Knotens (falls vorhanden) der Reihe nach rechts an die Warteschlange anhängen
if current_node.left:
queue.append(current_node.left)
if current_node.right:
queue.append(current_node.right)
print("\nErgebnis der Levelorder-Traversierung:", end=' ')
level_order_traversal(root) # Output: 1 2 3 4 5 6
Übung und Herausforderung
Herzlichen Glückwunsch zum Abschluss der Grundlagen! Um Bäume wirklich zu beherrschen, ist praktische Übung unerlässlich.
Übung 1: Berechne die Höhe des Baums
Eine Funktion schreibentree_height(node), nimmt den Wurzelknoten eines Baums und gibt die Höhe des Baums zurück (die Höhe eines leeren Baums ist per Konvention -1 oder 0; in diesem Beispiel definieren wir sie als die Anzahl der Kanten).
Hinweis: Baumhöhe = 1 + max(Höhe des linken Teilbaums, Höhe des rechten Teilbaums). Dies ist ein klassisches rekursives Problem.
Übung 2: Suche nach einem Wert in einem Binärbaum
Eine Funktion schreibensearch_in_tree(node, target_value), suche in dem gegebenen Binärbaum nach einem Wert gleichtarget_valuedem Knoten. Wenn gefunden, gib zurückTrue, andernfalls zurückgebenFalse。
Hinweis: Jede Traversierungsmethode kann verwendet werden, und vergleiche den Wert jedes Knotens beim Besuch.
Herausforderung: Binärer Suchbaum (BST)
Dies ist eine klassische Variante des Binärbaums. In einem binären Suchbaum gilt für jeden Knoten:
- seinemlinken Teilbaumdie Werte aller Knoten in<Der Wert dieses Knotens.
- seinemrechten Teilbaumdie Werte aller Knoten in>Der Wert dieses Knotens.
Deine Herausforderung ist:
- Implementierung
insert_into_bst(root, value)Funktion, füge einen Wert an der richtigen Position in den binären Suchbaum ein. - Implementierung
search_in_bst(root, value)Funktion, die die Eigenschaften des BST für eine effiziente Suche nutzt (durchschnittliche Zeitkomplexität O(log N)).