Codex-Modellauswahl
Codex unterstützt mehrere Modelle. Die Eigenschaften jedes Modells zu verstehen, hilft Ihnen, das richtige für Ihr Szenario auszuwählen.
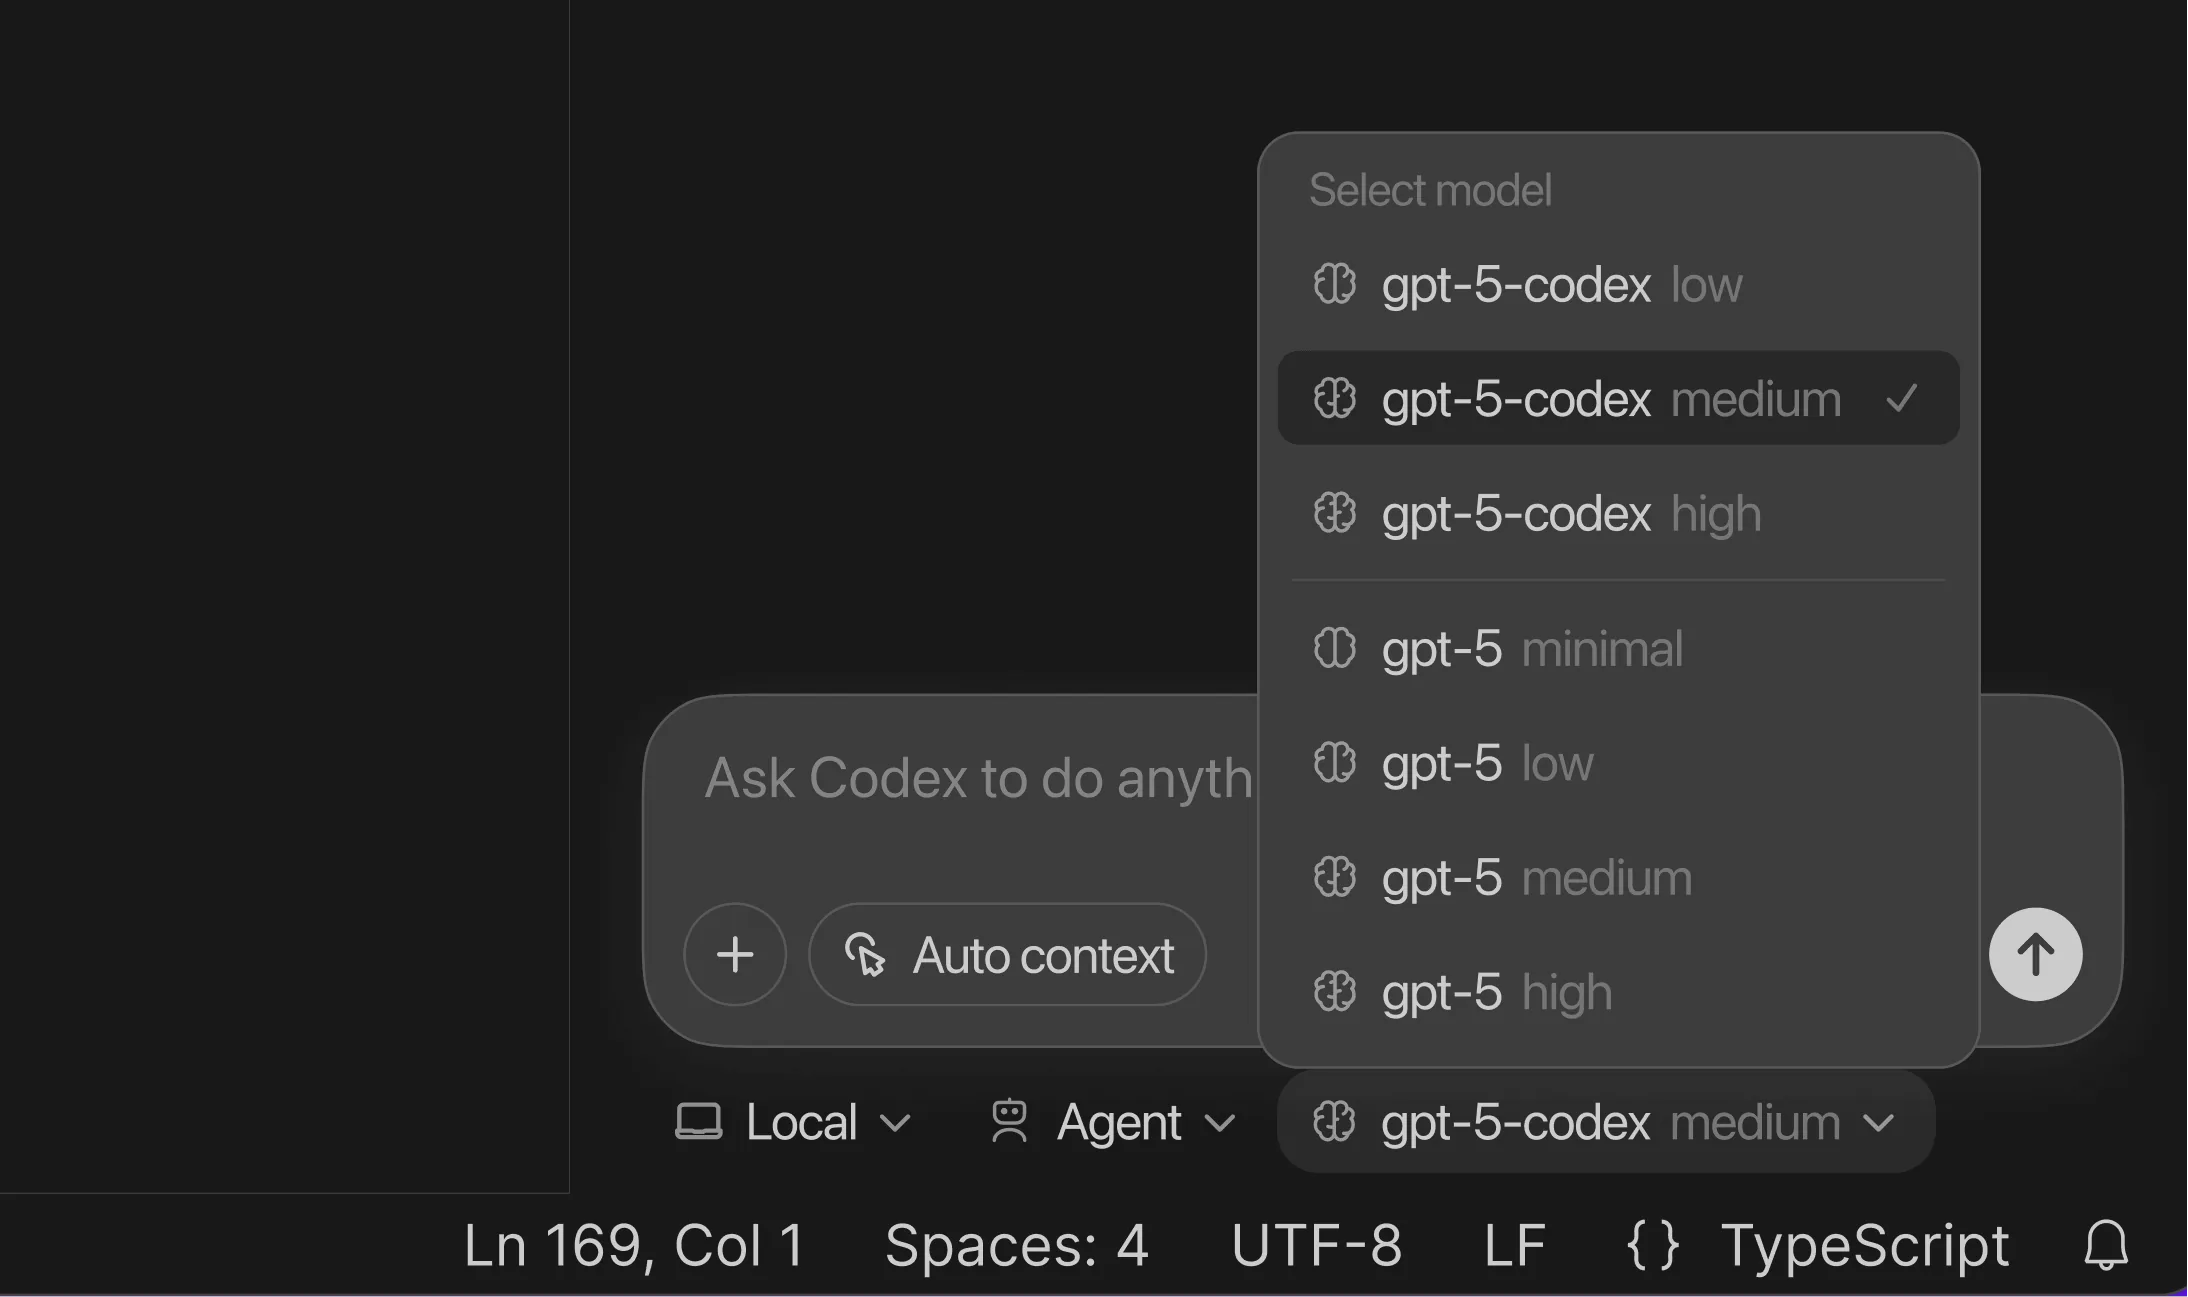
Bei der Desktop-Version kann unten rechts im Eingabefeld gewechselt werden
Die Codex CLI kann mit dem Befehl/modelgewechselt werden:
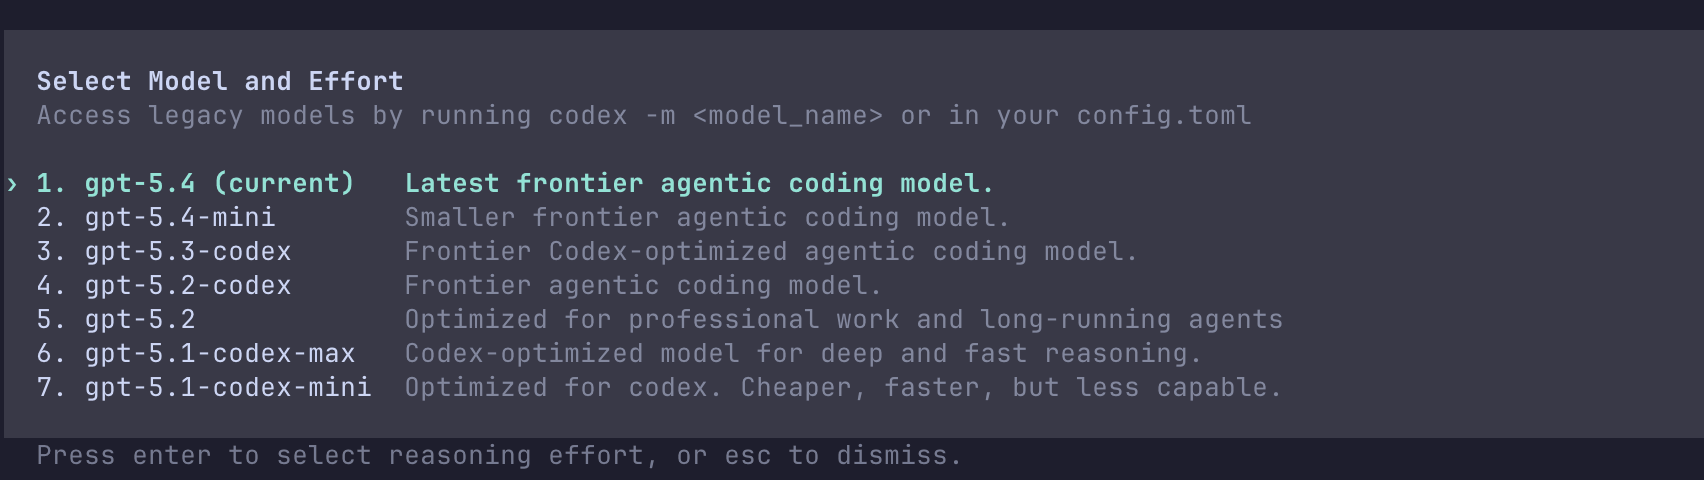
Verfügbare Modelle
Codex unterstützt derzeit die folgenden Modelle:
| Modell | Type | Funktionen | Anwendbare Szenarien |
|---|---|---|---|
| gpt-5.4 | Flaggschiff | Stärkste Leistungsfähigkeit, tiefgehende Schlussfolgerungen | Komplexe Aufgaben, Architekturdesign |
| gpt-5.4-mini | Leichtgewicht | Schnelle Reaktion, geringere Kosten | Einfache Aufgaben, schnelle Iteration |
| gpt-5.3-codex | Pro | Programmieroptimierung, Code-Spezialisierung | Code schreiben, Fehlerbehebung |
| gpt-5.3-codex-spark | Schnell | Ultraschnelle Antwort, hochfrequente Interaktion | Echtzeit-Zusammenarbeit, schnelle Fragen und Antworten |
Detaillierte Erklärung der Modellfunktionen
GPT-5.4
Flaggschiffmodell mit den stärksten Reasoning- und Kreativfähigkeiten.
| Funktionen | Beschreibung |
|---|---|
| Reasoning-Tiefe | Tiefgehende Analyse komplexer Probleme |
| Kontextverständnis | Verständnis der Struktur großer Codebasen |
| Mehrstufige Aufgaben | Umgang mit komplexen Workflows |
| Genauigkeit | Hohe Genauigkeit, weniger Nacharbeit |
Anwendbare Szenarien
- Architekturdesign und Refactoring
- Komplexe Fehleranalyse und Fehlerbehebung
- Koordinierte Entwicklung mehrerer Module
- Code-Review und Qualitätsanalyse
GPT-5.4-mini
Leichtgewichtiges Modell, schnelle Reaktion, geeignet für die tägliche Entwicklung.
| Funktionen | Beschreibung |
|---|---|
| Reaktionsgeschwindigkeit | Schneller als Flaggschiff-Modelle |
| Kosteneffizienz | Geringerer Token-Verbrauch |
| Tägliche Aufgaben | Geeignet für routinemäßige Entwicklungsabläufe |
Anwendbare Szenarien
- Einfache Funktionsimplementierung
- Codeformatierung und Refactoring
- Dokumentationserstellung
- Schnelle Fragen und Antworten
GPT-5.3-Codex
Ein Modell, das speziell für Programmieraufgaben optimiert wurde.
| Funktionen | Beschreibung |
|---|---|
| Code-Expertise | Speziell für Programmieraufgaben trainiert |
| Sprachabdeckung | Unterstützt mehrere Programmiersprachen |
| Codequalität | Hochwertig generierter Code |
Anwendbare Szenarien
- Code schreiben und generieren
- Fehlerbehebung und Debugging
- Code-Refactoring
- Testerstellung
GPT-5.3-Codex-Spark
Ultraschnelles Antwortmodell, geeignet für Szenarien mit hoher Interaktionsfrequenz.
| Funktionen | Beschreibung |
|---|---|
| Ultraschnelle Antwort | Schnellste Antwortgeschwindigkeit |
| Echtzeit-Zusammenarbeit | Geeignet für interaktive Entwicklung |
| Pro-exklusiv | Nur im Pro-Tarif verfügbar |
Anwendbare Szenarien
- Echtzeit-Code-Q&A
- Schnelle Prototypenvalidierung
- Hochfrequente iterative Entwicklung
Konfiguration der Reasoning-Intensität
Sie können den Reasoning-Aufwand des Modells anpassen, um Geschwindigkeit und Tiefe auszubalancieren.
Stufen der Reasoning-Intensität
| Stufe | Beschreibung | Funktionen |
|---|---|---|
minimal | Minimales Reasoning | Schnellste Antwort, geeignet für einfache Aufgaben |
low | Niedrige Reasoning-Intensität | Schnell, aber mit etwas Analyse |
medium | Mittleres Reasoning | Ausgewogene Geschwindigkeit und Tiefe (Standard) |
high | Hohe Reasoning-Intensität | Tiefe Analyse, geeignet für komplexe Aufgaben |
xhigh | Ultrahohes Reasoning | Stärkstes Reasoning, langsamste Antwort |
Reasoning-Intensität konfigurieren
Einstellungen für die Reasoning-Intensität
codex --reasoning-effort high
# Konfigurationsdatei
[mycode4 type="toml"]
model_reasoning_effort = "high"
# In Sitzung wechseln /model gpt-5.4 --reasoning-effort xhigh [/mycode4]
Reasoning-Zusammenfassung
Steuern Sie, wie detailliert Codex seinen Reasoning-Prozess anzeigt.
Zusammenfassungsmodus
| Mode | Beschreibung |
|---|---|
auto | Bestimmt automatisch den Detaillierungsgrad (Standard) |
concise | Kurze Zusammenfassung |
detailed | Detaillierter Denkprozess |
none | Keine Denkprozess-Zusammenfassung anzeigen |
Einstellungen für die Denkprozess-Zusammenfassung
model_reasoning_summary = "detailed"
Modellwechsel
Zwischen verschiedenen Modellen für unterschiedliche Szenarien wechseln.
Wechselmethode
Modell wechseln
/gpt-5.4
/model gpt-5.4-mini
/model gpt-5.3-codex
# Mit Reasoning-Stärke
/model gpt-5.4 --reasoning-effort high
# In-App-Umschaltung
Klicken Sie auf die Modellauswahl, um das Zielmodell auszuwählen
Vorschläge zum Szenariowechsel
| Szenarien | Empfohlenes Modell | Schlussfolgerungsstärke |
|---|---|---|
| Architekturdesign | gpt-5.4 | hoch/xhoch |
| Komplexes Refactoring | gpt-5.4 | hoch |
| Fehlerbehebung | gpt-5.3-codex | mittel |
| Tägliches Programmieren | gpt-5.4-mini | niedrig/mittel |
| Schnelle Fragen und Antworten | gpt-5.4-mini | minimal |
| Echtzeit-Zusammenarbeit | gpt-5.3-codex-spark | minimal |
Service-Tier
Die Wahl unterschiedlicher Service-Stufen beeinflusst die Antwortpriorität.
Optionen für Service-Stufen
| Stufe | Beschreibung |
|---|---|
flex | Elastischer Service, Antworten können etwas langsamer sein (Standard). |
fast | Prioritäts-Service, schnellere Antwort |
Einstellungen für Service-Stufen
service_tier = "fast"
Modelle & Tarife
Die Modellunterstützung variiert je nach Tarif:
| Plan | Verfügbare Modelle |
|---|---|
| Kostenlos | Basismodell |
| Plus | gpt-5.4, gpt-5.4-mini, gpt-5.3-codex |
| Pro | Alle Modelle + Spark + höhere Limits. |
| API-Schlüssel | Abrechnung pro Token, unterstützt gängige Modelle. |
Kostenüberlegungen
Vergleich des Tokenverbrauchs
| Modell | Relative Kosten |
|---|---|
| gpt-5.4 | Höchste |
| gpt-5.3-codex | Mittel-Hoch |
| gpt-5.4-mini | Relativ niedrig |
| gpt-5.3-codex-spark | Niedrig |
Vorschläge zur Kostenoptimierung
- Verwenden Sie mini- oder Spark-Modelle für einfache Aufgaben.
- Verwenden Sie mittleren Reasoning-Aufwand für die tägliche Entwicklung.
- Verwenden Sie das Flaggschiffmodell und hohen Reasoning-Aufwand nur für komplexe Aufgaben.
- Verwenden Sie /compact, um den Kontext zu komprimieren und den Tokenverbrauch zu reduzieren.
Best Practices
Prinzipien der Modellauswahl
- Wählen Sie ein Modell basierend auf der Aufgabenkomplexität
- Antwortgeschwindigkeit und Reasoning-Tiefe ausbalancieren
- Genauigkeit für komplexe Aufgaben priorisieren
- Antwortgeschwindigkeit für Interaktionen mit hoher Frequenz priorisieren
Konfigurationsvorschläge
Empfohlene Konfiguration
model = "gpt-5.4-mini"
model_reasoning_effort = "medium"
model_reasoning_summary = "auto"
# Temporärer Wechsel für komplexe Aufgaben
# /model gpt-5.4 --reasoning-effort high
FAQ
F: Welches Modell ist am besten zum Schreiben von Code geeignet?
gpt-5.3-codex ist für Programmieraufgaben optimiert und eignet sich für die meisten Szenarien beim Schreiben von Code.
F: Wie kann man Geschwindigkeit und Qualität ausbalancieren?
Für alltägliche Aufgaben verwenden Sie gpt-5.4-mini mit mittlerer Reasoning-Intensität; wechseln Sie bei komplexen Aufgaben zu gpt-5.4 mit hoher Reasoning-Intensität.
F: Was sind die Vorteile des Spark-Modells?
Das Spark-Modell reagiert am schnellsten, eignet sich für hochfrequente Interaktion und Echtzeit-Zusammenarbeit und ist nur im Pro-Plan verfügbar.
F: Wie wirkt sich die Reasoning-Intensität auf die Ergebnisse aus?
Höherer Reasoning-Aufwand bedeutet, dass Codex eine tiefere Analyse durchführt, aber die Antwortzeit länger ist.
Weitere Erweiterungen