Regulärer Ausdruck -Syntax
Ein regulärer Ausdruck ist ein leistungsstarkes Werkzeug zum Abgleichen und Bearbeiten von Text. Er besteht aus gewöhnlichen Zeichen und Sonderzeichen (genannt "Metazeichen") und wird verwendet, um die abzugleichenden Textmuster zu beschreiben.
Reguläre Ausdrücke können verwendet werden, um bestimmte Muster in Text zu suchen, zu ersetzen, zu extrahieren und zu validieren.
Zum Beispiel:
runoo+b, kann übereinstimmen mitexample、runooob、runoooooobusw.,+Das Zeichen gibt an, dass das vorhergehende Zeichen mindestens einmal vorkommen muss (1-mal oder öfter)。
runoo*b, kann übereinstimmen mitrunob、example、runoooooobusw.,*Das Zeichen gibt an, dass das vorhergehende Zeichen nicht vorkommen muss oder einmal oder mehrmals vorkommen kann (0-mal, 1-mal oder mehrmals)。
colou?rkann übereinstimmen mitcolorodercolour,?Das Fragezeichen gibt an, dass das vorhergehende Zeichen höchstens einmal vorkommen kann (0-mal oder 1-mal)。
Die Methode zum Aufbau regulärer Ausdrücke ist dieselbe wie beim Erstellen mathematischer Ausdrücke – durch die Kombination kleiner Ausdrücke mit verschiedenen Metazeichen und Operatoren können Sie größere Ausdrücke erstellen. Die Bestandteile eines regulären Ausdrucks können ein einzelnes Zeichen, eine Zeichenmenge, ein Zeichenbereich, eine Auswahl zwischen Zeichen oder eine beliebige Kombination all dieser Bestandteile sein.
Als Vorlage gleicht ein regulärer Ausdruck ein bestimmtes Zeichenmuster mit der durchsuchten Zeichenkette ab.
Gewöhnliche Zeichen
Gewöhnliche Zeichen umfassen alle druckbaren und nicht druckbaren Zeichen, die nicht ausdrücklich als Metazeichen festgelegt sind, einschließlich aller Groß- und Kleinbuchstaben, aller Ziffern, aller Satzzeichen und einiger anderer Symbole.
| Zeichen | Beschreibung | Beispiel |
|---|---|---|
| [ABC] | Entspricht[...]allen in .... aufgeführten Zeichen. Zum Beispiel,[aeiou]Entspricht allen Buchstaben e, o, u und a in der Zeichenkette "google example taobao". 
|
|
| [^ABC] | Entspricht allen Zeichen außer[...]allen Zeichen, die nicht zu den in .... aufgeführten gehören. Zum Beispiel,[^aeiou]Entspricht allen Zeichen in der Zeichenkette "google example taobao" außer den Buchstaben e, o, u und a. 
|
|
| [A-Z] | [A-Z] stellt einen Bereich dar und entspricht allen Großbuchstaben; [a-z] entspricht allen Kleinbuchstaben; [0-9] entspricht allen Ziffern. 
|
|
| . | Entspricht jedem einzelnen Zeichen außer Zeilenumbruchzeichen (\n, \r), äquivalent zu [^\n\r]. 
|
|
| [\s\S] | Entspricht allen Zeichen (einschließlich Zeilenumbruchzeichen).\sEntspricht allen Whitespace-Zeichen (einschließlich Zeilenumbrüchen),\SEntspricht allen Nicht-Whitespace-Zeichen (ohne Zeilenumbrüche); die Kombination der beiden kann jedes beliebige Zeichen abgleichen. 
|
|
| \w | Entspricht Buchstaben, Ziffern und Unterstrichen, äquivalent zu [A-Za-z0-9_]. 
|
|
| \d | Entspricht jeder arabischen Ziffer (0 bis 9), äquivalent zu[0-9]。 
|
Testwerkzeuge
Modifikatoren:
[0-9]+
Text abgleichen:
123abc456edf789
Nicht druckbare Zeichen
Nicht druckbare Zeichen können auch Bestandteile regulärer Ausdrücke sein. Die folgende Tabelle listet Escape-Sequenzen auf, die nicht druckbare Zeichen darstellen:
| Zeichen | Beschreibung |
|---|---|
| \cx | Entspricht einem durch x bezeichneten Steuerzeichen. Zum Beispiel entspricht \cM einem Control-M oder Wagenrücklauf. Der Wert von x muss A-Z oder a-z sein; andernfalls wird c als literales Zeichen 'c' behandelt. |
| \f | Entspricht einem Seitenvorschub, äquivalent zu \x0c und \cL. |
| \n | Entspricht einem Zeilenumbruchzeichen, äquivalent zu \x0a und \cJ. |
| \r | Entspricht einem Wagenrücklaufzeichen, äquivalent zu \x0d und \cM. |
| \s | Entspricht einem beliebigen Leerraumzeichen, einschließlich Leerzeichen, Tabulator, Seitenvorschub usw., äquivalent zu [ \f\n\r\t\v]. Beachten Sie, dass reguläre Unicode-Ausdrücke auch Vollbreiten-Leerzeichen abgleichen. |
| \S | Entspricht einem beliebigen Nicht-Leerraumzeichen, äquivalent zu [^ \f\n\r\t\v]. |
| \t | Entspricht einem Tabulatorzeichen, äquivalent zu \x09 und \cI. |
| \v | Entspricht einem vertikalen Tabulatorzeichen, äquivalent zu \x0b und \cK. |
Sonderzeichen
Die sogenannten Sonderzeichen sind Zeichen mit besonderer Bedeutung, wie das oben erwähnterunoo*bim*, was "beliebig viele Zeichen" bedeutet.*Wenn Sie die ... in einer Zeichenkette finden möchten*Symbol selbst, dann ist es notwendig,\es zu escapen, indem Sie einen Backslash davor setzenruno\*ob, das heißt,runo*ob。
stimmt mit der Zeichenkette\vor ihnen überein. Die folgende Tabelle listet die Sonderzeichen in regulären Ausdrücken auf:
| Sonderzeichen | Beschreibung |
|---|---|
| $ | Entspricht der Endposition der Eingabezeichenkette. Wenn die Multiline-Eigenschaft des RegExp-Objekts gesetzt ist, entspricht $ auch '\n' oder '\r'. Um das $-Zeichen selbst zu treffen, verwenden Sie \$. |
| ( ) | Markiert die Start- und Endpositionen eines Teilausdrucks. Der Teilausdruck kann für die spätere Verwendung erfasst werden. Um diese Zeichen zu treffen, verwenden Sie \( und \). |
| * | Entspricht dem vorhergehenden Teilausdruck null- oder mehrmals. Um das Zeichen * selbst zu matchen, verwenden Sie \*. |
| + | Entspricht dem vorhergehenden Teilausdruck ein- oder mehrmals. Um das Zeichen + selbst zu matchen, verwenden Sie \+. |
| . | Entspricht einem beliebigen einzelnen Zeichen außer dem Zeilenumbruchzeichen \n. Um . selbst zu matchen, verwenden Sie \. |
| [ | Kennzeichnet den Anfang eines Klammerausdrucks. Um [ zu matchen, verwenden Sie \[. |
| ? | Entspricht dem vorhergehenden Teilausdruck null- oder einmal, oder kennzeichnet einen nicht gierigen Quantifizierer. Um das Zeichen ? selbst zu matchen, verwenden Sie \?. |
| \ | Kennzeichnet das nächste Zeichen als Sonderzeichen, Literalzeichen, Rückverweis oder Oktal-Escape. Zum Beispiel entspricht 'n' dem Zeichen 'n'; '\n' entspricht einem Zeilenumbruch; '\\' entspricht "\"; '\(' entspricht "(". |
| ^ | Entspricht der Startposition der Eingabezeichenfolge. In einem Klammerausdruck gibt es an, dass der Zeichensatz innerhalb der Klammern nicht akzeptiert wird (Negation). Um das Zeichen ^ selbst zu matchen, verwenden Sie \^. |
| { | Kennzeichnet den Anfang eines Quantifizierer-Ausdrucks. Um { zu matchen, verwenden Sie \{. |
| | | Gibt eine Auswahl zwischen zwei Elementen an. Um | zu matchen, verwenden Sie \|. |
Quantifizierer
Quantifizierer geben an, wie oft eine bestimmte Komponente eines regulären Ausdrucks vorkommen muss, damit eine Übereinstimmung erfüllt ist. Es gibt insgesamt*、+、?、{n}、{n,}、{n,m}6 Typen.
| Zeichen | Beschreibung | Beispiel |
|---|---|---|
| * | Entspricht dem vorhergehenden Teilausdruck null- oder mehrmals. Zum Beispiel kannzo*übereinstimmen mit"z"und"zoo"。*äquivalent zu{0,}。 | Ausprobieren » |
| + | Entspricht dem vorhergehenden Teilausdruck ein- oder mehrmals. Zum Beispiel kannzo+übereinstimmen mit"zo"und"zoo", stimmt aber nicht mit"z"。+überein, äquivalent zu{1,}。 | Ausprobieren » |
| ? | Entspricht dem vorangehenden Teilausdruck null oder einmal. Zum Beispiel kanndo(es)?mit"do"und"does" übereinstimmen, stimmt aber nicht mit"dog"。?überein, äquivalent zu{0,1}。 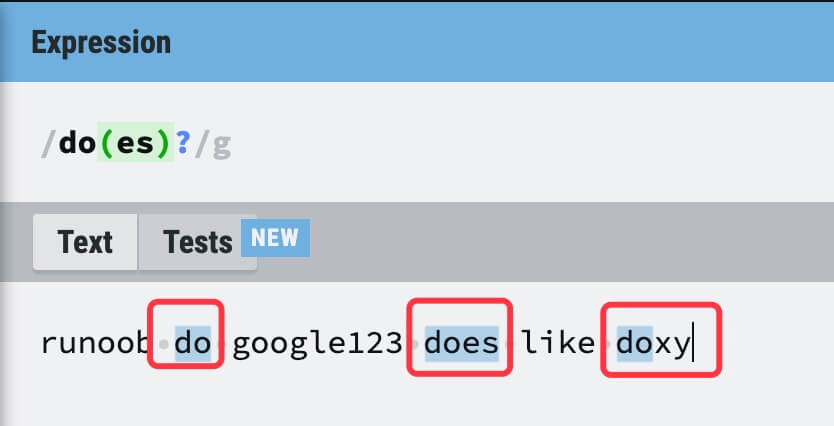 |
Ausprobieren » |
| {n} | n ist eine nichtnegative ganze Zahl und stimmt genau n-mal überein. Zum Beispiel kanno{2}nicht mit"Bob"dem o in ... übereinstimmen, kann aber mit"food"den beiden o's in ... übereinstimmen | Ausprobieren » |
| {n,} | n ist eine nichtnegative ganze Zahl und stimmt mindestens n-mal überein. Zum Beispiel kanno{2,}nicht mit"Bob"dem o in ... übereinstimmen, kann aber mit"foooood"allen o's in ... übereinstimmeno{1,}äquivalent zuo+,o{0,}äquivalent zuo*。 | Ausprobieren » |
| {n,m} | m und n sind beide nichtnegative ganze Zahlen, wobei n <= m. Stimmt mindestens n-mal und höchstens m-mal überein. Zum Beispiel wirdo{1,3}mit"fooooood"den ersten drei o's in ... übereinstimmeno{0,1}äquivalent zuo?. Hinweis: Zwischen dem Komma und den beiden Zahlen darf kein Leerzeichen stehen. | Ausprobieren » |
Der folgende reguläre Ausdruck stimmt mit einer positiven ganzen Zahl überein,[1-9]stellt sicher, dass die erste Ziffer nicht 0 ist,[0-9]*steht für eine beliebige Anzahl von Ziffern:
/[1-9][0-9]*/
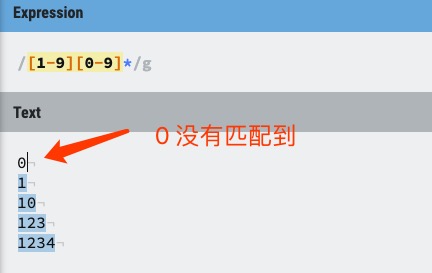
Bitte beachten Sie, dass der Quantifizierer nach dem Bereichsausdruck steht, sodass er auf den gesamten Bereichsausdruck angewendet wird, der in diesem Fall nur Ziffern von 0 bis 9 angibt (einschließlich 0 und 9).
Der +-Quantifizierer wird hier nicht verwendet, weil an der zweiten oder späteren Position nicht unbedingt eine Ziffer erforderlich ist. Auch das ?-Zeichen wird nicht verwendet, weil die Verwendung von ? die ganze Zahl auf nur zwei Ziffern beschränken würde.
Wenn Sie zweistellige Zahlen von 0 bis 99 abgleichen möchten, können Sie den folgenden Ausdruck verwenden, um mindestens eine Ziffer und höchstens zwei Ziffern anzugeben:
/[0-9]{1,2}/
Der obige Ausdruck hat einen Nachteil: Er kann nur Zahlen mit zwei Ziffern abgleichen, und er stimmt mit unerwarteten Werten wie 0 und 00 überein. Nach der Verbesserung lautet der Ausdruck zum Abgleichen positiver Ganzzahlen von 1 bis 99 wie folgt:
/[1-9][0-9]?/
oder
/[1-9][0-9]{0,1}/
*und+Quantifizierer sind gierig, weil sie so viel Text wie möglich abgleichen. Fügen Sie ein?dahinter hinzu, um nicht-gieriges oder minimales Matching zu erreichen.
Zum Beispiel könnten Sie ein HTML-Dokument durchsuchen, um den Inhalt innerhalb von h1-Tags zu finden. Der HTML-Code lautet wie folgt:
<h1>EXAMPLE-Example</h1>
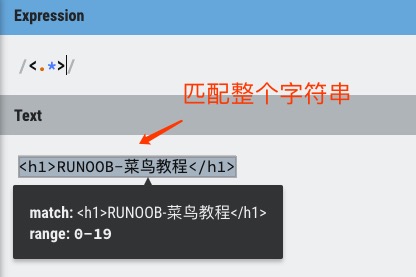
Gierig:Der folgende Ausdruck stimmt mit allem zwischen dem öffnenden Kleiner-als-Zeichen (<) und dem schließenden Größer-als-Zeichen (>) des h1-Tags überein:
/<.*>/
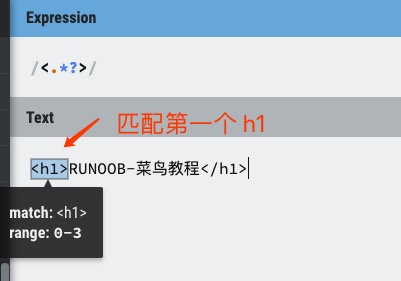
Nicht-gierig:Wenn Sie nur die öffnenden und schließenden h1-Tags abgleichen müssen, stimmt der folgende nicht-gierige Ausdruck nur mit <h1> überein:
/<.*?>/
Sie können auch den folgenden regulären Ausdruck verwenden, um h1-Tags abzugleichen:
/<\w+?>/
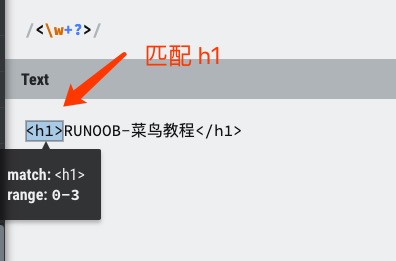
Durch das Platzieren von*、+oder?nach dem Quantifizierer?, ändert sich der Ausdruck von "gierig" zu "nicht-gierig" (minimales Matching).
Anker
Anker ermöglichen es Ihnen, einen regulären Ausdruck am Anfang oder Ende einer Zeile zu fixieren, und können auch die Grenzpositionen eines Wortes beschreiben.
^und$beziehen sich jeweils auf den Anfang und das Ende einer Zeichenkette.\bbeschreiben die Anfangs- oder Endgrenze eines Wortes,\Bsteht für eine Nicht-Wort-Grenze.
| Zeichen | Beschreibung | Beispiel |
|---|---|---|
| ^ | Entspricht dem Anfang der Eingabezeichenkette. Wenn die Multiline-Eigenschaft des RegExp-Objekts gesetzt ist, stimmt ^ auch mit Positionen nach \n oder \r überein. | Ausprobieren » |
| $ | Entspricht dem Ende der Eingabezeichenkette. Wenn die Multiline-Eigenschaft des RegExp-Objekts gesetzt ist, stimmt $ auch mit Positionen vor \n oder \r überein. | Ausprobieren » |
| \b | Entspricht einer Wortgrenze, d. h. der Position zwischen einem Wort und einem Leerzeichen. | Ausprobieren » |
| \B | Entspricht einer Nicht-Wortgrenze, d. h. einer Position, die nicht am Anfang oder Ende eines Wortes liegt. | Ausprobieren » |
Hinweis:Quantoren können nicht zusammen mit Ankern verwendet werden. Da es nicht mehr als eine Position unmittelbar vor oder nach einem Zeilenumbruch oder einer Wortgrenze geben kann, sind Ausdrücke wie^*nicht zulässig.
Um Text am Anfang einer Textzeile zu finden, verwenden Sie das^Zeichen am Anfang des regulären Ausdrucks. Achten Sie darauf, diese Verwendung nicht mit der Negationsverwendung innerhalb von Klammerausdrücken zu^verwechseln.
Um das Ende einer Textzeile zu finden, verwenden Sie das$Zeichen am Ende des regulären Ausdrucks.
Um Anker bei der Suche nach Abschnittsüberschriften zu verwenden, findet der folgende reguläre Ausdruck eine Abschnittsüberschrift, die nur zwei nachgestellte Ziffern enthält und am Anfang einer Zeile steht:
/^Chapter [1-9][0-9]{0,1}/
Eine echte Abschnittsüberschrift steht nicht nur am Anfang einer Zeile, sondern ist auch der einzige Text in dieser Zeile. Der folgende Ausdruck stellt durch Verankerung sowohl des Anfangs als auch des Endes der Zeile sicher, dass die angegebene Übereinstimmung nur mit Abschnittsüberschriften und nicht mit Querverweisen übereinstimmt:
/^Chapter [1-9][0-9]{0,1}$/
Wortgrenzen können den Übereinstimmungsbereich präzise steuern. Der folgende Ausdruck stimmt mit den ersten drei Zeichen des Wortes Chapter überein, da diese drei Zeichen nach einer Wortgrenze auftreten:
/\bCha/
\bDie Position ist sehr wichtig: Am Anfang einer Zeichenkette findet sie eine Übereinstimmung am Anfang eines Wortes; am Ende einer Zeichenkette findet sie eine Übereinstimmung am Ende eines Wortes. Zum Beispiel stimmt der folgende Ausdruck mit der Zeichenkette ter im Wort Chapter überein, da sie vor einer Wortgrenze auftritt:
/ter\b/
Der folgende Ausdruck stimmt mit der Zeichenkette apt in Chapter überein, aber nicht mit apt in aptitude:
/\Bapt/
Die Zeichenfolge apt tritt in dem Wort Chapter an einer Nicht-Wortgrenze auf, aber in dem Wort aptitude an einer Wortgrenze. Für den\BNicht-Wortgrenzen-Operator kann er nicht den Anfang oder das Ende eines Wortes treffen, daher stimmt der folgende Ausdruck nicht mit Cha in Chapter überein:
/\BCha/
Alternation
Verwenden Sie Klammern(), um alle Alternativen einzuschließen, und trennen Sie benachbarte Alternativen mit||.
()Kennzeichnet eine erfassende Gruppe,()die den übereinstimmenden Wert in jeder Gruppe speichert. Mehrere übereinstimmende Werte können über die Nummer n angezeigt werden (n ist eine Ziffer, die den Inhalt der n-ten erfassenden Gruppe darstellt).
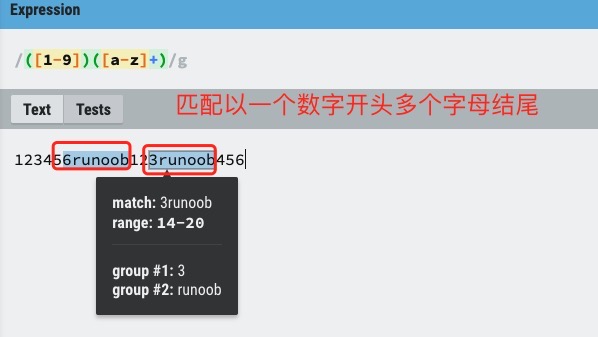
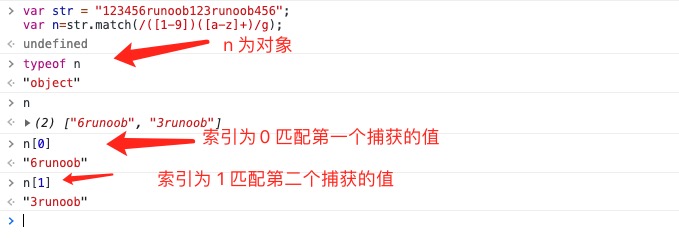
Die Verwendung von Klammern hat einen Seiteneffekt: Der zugehörige übereinstimmende Inhalt wird zwischengespeichert (erfasst). Wenn keine Erfassung benötigt wird, können Sie?:vor der ersten Alternative verwenden, um diesen Seiteneffekt zu beseitigen. In diesem Fall werden die Klammern nur zur Gruppierung verwendet und speichern keinen übereinstimmenden Inhalt.
Wobei?:eines der nicht-erfassenden Metazeichen ist und die anderen beiden nicht-erfassenden Metazeichen?=und?!sind: Ersteres ist ein positiver Lookahead, der mit der Suchzeichenfolge an jeder Position übereinstimmt, an der das reguläre Ausdrucksmuster innerhalb der Klammern zu passen beginnt; Letzteres ist ein negativer Lookahead, der mit der Suchzeichenfolge an jeder Position übereinstimmt, an der dieses reguläre Ausdrucksmuster nicht zu passen beginnt.
Verwendungsunterschiede von ?=, ?<=, ?!, ?<!
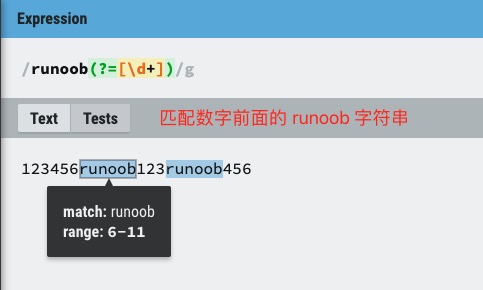
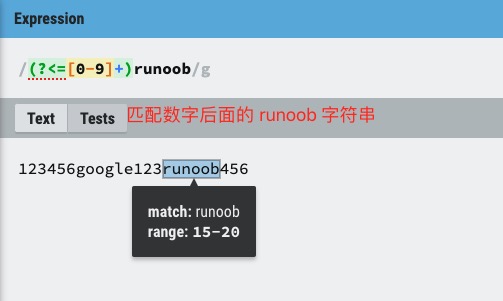
exp1(?=exp2): Finden Sie exp1 vor exp2 (positiver Lookahead).
(?<=exp2)exp1: Finden Sie exp1 nach exp2 (positiver Lookbehind).
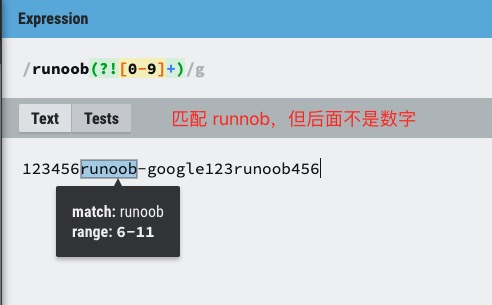
exp1(?!exp2): Finden Sie exp1, auf das exp2 nicht folgt (negativer Lookahead).
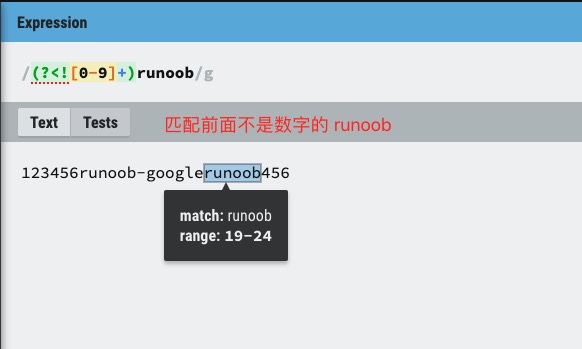
(?<!exp2)exp1: Finden Sie exp1, dem exp2 nicht vorausgeht (negativer Lookbehind).
Weitere Informationen finden Sie unter:Lookahead- und Lookbehind-Assertions in regulären Ausdrücken
Rückverweise
Das Setzen von Klammern um ein Muster eines regulären Ausdrucks oder einen Teil eines Musters bewirkt, dass die entsprechende Übereinstimmung in einem temporären Puffer gespeichert wird. Jede erfasste Teilübereinstimmung wird in der Reihenfolge gespeichert, in der sie von links nach rechts im Muster des regulären Ausdrucks erscheint. Puffernummern beginnen bei 1, und bis zu 99 erfasste Teilausdrücke können gespeichert werden. Auf jeden Puffer kann zugegriffen werden mit\nwobei n eine ein- oder zweistellige Dezimalzahl ist, die einen bestimmten Puffer identifiziert.
Sie können das nicht erfassende Metazeichen?:、?=oder?!verwenden, um die Erfassung umzuschreiben und dabei das Speichern der zugehörigen Übereinstimmung zu ignorieren.
Eine der einfachsten und nützlichsten Anwendungen von Rückverweisen ist das Finden zweier identischer benachbarter Wörter im Text. Nehmen Sie den folgenden Satz als Beispiel:
Is is the cost of of gasoline going up up?
Der obige Satz enthält mehrere wiederholte Wörter. Der folgende reguläre Ausdruck verwendet einen einzelnen Teilausdruck, um diese Duplikate zu lokalisieren:
Beispiel
Wiederholte Wörter finden:
var patt1 = /\b([a-z]+) \1\b/igm;
document.write(str.match(patt1));
Ausprobieren »
Der erfasste Ausdruck[a-z]+stimmt mit einem oder mehreren Buchstaben überein. Der zweite Teil des regulären Ausdrucks\1ist ein Rückverweis auf die erste Teilübereinstimmung (der in Klammern erfasste Inhalt), wobei gefordert wird, dass dasselbe Wort wie das erste Wort unmittelbar folgt.
Das Wortgrenzen-Metazeichen\bstellt sicher, dass nur ganze Wörter erkannt werden; andernfalls werden Formulierungen wie "is issued" oder "this is" nicht korrekt identifiziert.
Am Ende des Ausdrucks gibt dasg(global)-Flag an, dass der Ausdruck auf alle in der Eingabezeichenfolge gefundenen Übereinstimmungen angewendet wird;i(ignore case)-Flag gibt an, dass die Groß-/Kleinschreibung nicht beachtet wird;m(multiline)-Flag gibt an, dass potenzielle Übereinstimmungen auf beiden Seiten eines Zeilenumbruchs auftreten können.
Rückverweise können auch eine URI in ihre Bestandteile zerlegen. Angenommen, Sie möchten die folgende URI in Protokoll (ftp, http usw.), Domainadresse und Pfad zerlegen:
https://www.example.com:80/html/html-tutorial.html
Der folgende reguläre Ausdruck bietet diese Funktionalität:
Beispiel
Alle übereinstimmenden Daten ausgeben:
var patt1 = /(\w+):\/\/([^/:]+)(:\d*)?([^# ]*)/;
arr = str.match(patt1);
for (var i = 0; i < arr.length; i++) {
document.write(arr[i]);
document.write("<br>");
}
Ausprobieren »
str.match(patt1)Gibt ein Array mit 5 Elementen zurück: Index 0 entspricht der gesamten übereinstimmenden Zeichenfolge, die Indizes 1 bis 4 entsprechen den jeweiligen geklammerten Erfassungsgruppen usw.
- Der erste geklammerte Teilausdruck(\w+): erfasst den Protokollteil der Webadresse, wobei jedes Wort vor dem Doppelpunkt und zwei Vorwärtsschrägstrichen übereinstimmt. Ergebnis:https
- Der zweite Teilausdruck in Klammern([^/:]+): erfasst den Domain-Adressteil, wobei ein oder mehrere Zeichen übereinstimmen, die nicht : oder / sind. Ergebnis:www.example.com
- Der dritte Teilausdruck in Klammern(:\d*): erfasst die Portnummer (falls vorhanden), wobei null oder mehr Ziffern nach dem Doppelpunkt übereinstimmen. Ergebnis::80
- Der vierte Teilausdruck in Klammern([^# ]*): erfasst die Pfad- und Seiteninformationen, wobei eine beliebige Zeichenfolge übereinstimmt, die weder # noch Leerzeichen enthält. Ergebnis:/html/html-tutorial.html