- 1. Aufteilung der Netzwerkschichten
- 2. OSI-Sieben-Schichten-Netzwerkmodell
- 3. IP-Adresse
- 4. Subnetzmaske und Netzwerkaufteilung
- 5. ARP/RARP-Protokoll
- 6. Routing-Protokoll
- 7. TCP/IP-Protokoll
- 8. UDP-Protokoll
- 9. DNS-Protokoll
- 10. NAT-Protokoll
- 11. DHCP-Protokoll
- 12. HTTP-Protokoll
- 13. Ein Beispiel
Der Kerninhalt des Lernens von Computernetzwerken ist das Studium von Netzwerkprotokollen. Netzwerkprotokolle sind eine Sammlung von Regeln, Standards oder Konventionen, die für den Datenaustausch in Computernetzwerken festgelegt wurden. Da die Datenendgeräte verschiedener Benutzer unterschiedliche Zeichensätze verwenden können, muss die Kommunikation zwischen ihnen auf bestimmten Standards basieren. Eine anschauliche Analogie ist unsere Sprache. Unser großartiges Land hat ein weites Territorium und eine große Bevölkerung, mit sehr reichen lokalen Sprachen, und die Unterschiede zwischen Dialekten sind enorm. Ein Dialekt aus Region A kann für Menschen aus Region B völlig unverständlich sein, daher müssen wir einen Sprachstandard für die Kommunikation zwischen Menschen im ganzen Land festlegen; das ist die Rolle von Mandarin. Wenn wir uns ähnlich die Welt ansehen, ist die Standardsprache für die Kommunikation mit ausländischen Freunden Englisch, weshalb wir so hart Englisch lernen müssen.
Computernetzwerkprotokolle sind, wie unsere Sprachen, vielfältig. ARPA führte von 1977 bis 1979 ein Netzwerkprotokoll namens ARPANET ein, das weite Verbreitung fand. Der wichtigste Grund war, dass es das bekannte TCP/IP-Standardnetzwerkprotokoll einführte. Derzeit ist das TCP/IP-Protokoll zur "gemeinsamen Sprache" im Internet geworden. Die folgende Abbildung ist eine schematische Darstellung der Kommunikation zwischen verschiedenen Computergruppen unter Verwendung von TCP/IP.

1. Aufteilung der Netzwerkschichten
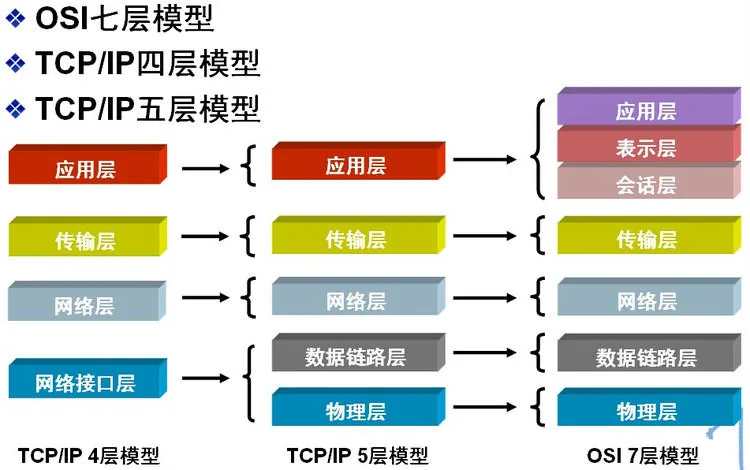
Um es von verschiedenen Computerherstellern hergestellten Computern zu ermöglichen, miteinander zu kommunizieren und dadurch Computernetzwerke über ein größeres Gebiet aufzubauen, schlug die International Organization for Standardization (ISO) 1978 das „Open System Interconnection Reference Model“ vor, nämlich das berühmte OSI/RM-Modell (Open System Interconnection/Reference Model). Es unterteilt die Kommunikationsprotokolle der Computernetzwerkarchitektur in sieben Schichten, von unten nach oben: Bitübertragungsschicht (Physical Layer/Physics Layer), Sicherungsschicht (Data Link Layer), Vermittlungsschicht (Network Layer), Transportschicht (Transport Layer), Sitzungsschicht (Session Layer), Darstellungsschicht (Presentation Layer), Anwendungsschicht (Application Layer). Die vierte Schicht erbringt Datenübertragungsdienste, und die oberen drei Schichten sind benutzerorientiert.
Neben dem standardmäßigen OSI-Sieben-Schichten-Modell gibt es auch übliche Einteilungen der Netzwerkschichten wie das TCP/IP-Vier-Schichten-Protokoll und das TCP/IP-Fünf-Schichten-Protokoll. Ihre Entsprechung ist in der folgenden Abbildung dargestellt:
2. OSI-Sieben-Schichten-Netzwerkmodell
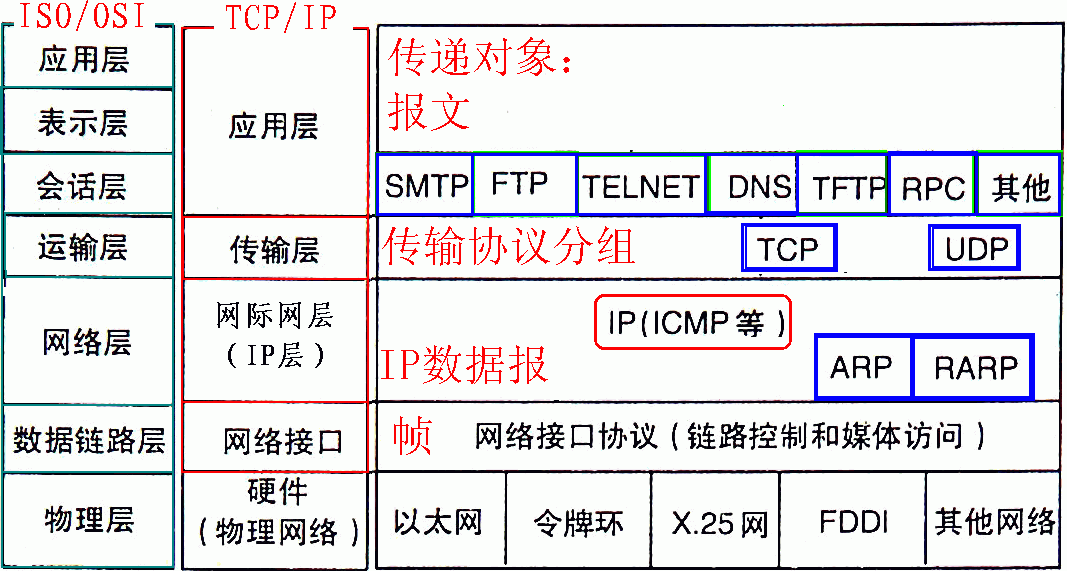
Das TCP/IP-Protokoll ist zweifellos das grundlegende Protokoll des Internets. Ohne es wäre ein Zugang zum Internet überhaupt nicht möglich, und jeder Vorgang mit Bezug zum Internet ist untrennbar mit dem TCP/IP-Protokoll verbunden. Ob es sich nun um das OSI-Sieben-Schichten-Modell oder das TCP/IP-Vier-Schichten- bzw. -Fünf-Schichten-Modell handelt, verfügt jede Schicht über ihr eigenes ausschließliches Protokoll, um ihre entsprechende Aufgabe zu erfüllen und mit den darüber- und darunterliegenden Schichten zu kommunizieren. Da das OSI-Sieben-Schichten-Modell die standardmäßige hierarchische Einteilung von Netzwerken ist, werden wir es am Beispiel des OSI-Sieben-Schichten-Modells von unten nach oben schichtweise vorstellen.
1) Bitübertragungsschicht
Aktivieren, Aufrechterhalten und Deaktivieren der mechanischen, elektrischen, funktionalen und prozeduralen Eigenschaften zwischen Kommunikationsendpunkten.Diese Schicht stellt den Protokollen höherer Schichten ein zuverlässiges physisches Medium für die Datenübertragung bereit. Einfach ausgedrückt stellt die Bitübertragungsschicht sicher, dass Rohdaten über verschiedene physische Medien übertragen werden können.Für die physikalische Schicht sollten Sie sich zwei wichtige Gerätenamen merken: Repeater (auch Verstärker genannt) und Hub.
2) Sicherungsschicht
Die Sicherungsschicht bietet Dienste für die Vermittlungsschicht auf der Grundlage der von der physikalischen Schicht bereitgestellten Dienste. Ihr grundlegendster Dienst besteht darin, Daten von der Vermittlungsschicht zuverlässig an die Vermittlungsschicht des Zielrechners an benachbarten Knoten zu übertragen. Um dieses Ziel zu erreichen, muss die Sicherungsschicht eine Reihe entsprechender Funktionen besitzen, hauptsächlich: wie Daten zu Datenblöcken zusammengefasst werden, die in der Sicherungsschicht Frames genannt werden; der Frame ist die Übertragungseinheit der Sicherungsschicht; wie die Übertragung von Frames auf physikalischen Kanälen gesteuert wird, einschließlich des Umgangs mit Übertragungsfehlern und der Anpassung der Senderate an den Empfänger; und wie die Verwaltung für den Aufbau, die Aufrechterhaltung und den Abbau von Datenverbindungswegen zwischen zwei Netzwerkentitäten bereitgestellt wird. Die Sicherungsschicht bietet zuverlässige Übertragung über unzuverlässige physikalische Medien. Zu ihren Funktionen gehören physikalische Adressierung, Datenframing, Flusssteuerung, Datenfehlererkennung, Neuübertragung usw.
Wichtige Wissenspunkte zur Sicherungsschicht:
1> Die Sicherungsschicht bietet zuverlässige Datenübertragung für die Vermittlungsschicht.
2> Die grundlegende Dateneinheit ist der Frame.
3> Hauptprotokoll: Ethernet-Protokoll.
4> Zwei wichtige Gerätenamen: Bridge und Switch.
3) Vermittlungsschicht
Der Zweck der Vermittlungsschicht besteht darin, eine transparente Datenübertragung zwischen zwei Endsystemen zu erreichen. Zu den spezifischen Funktionen gehören Adressierung und Routing, Verbindungsaufbau, -aufrechterhaltung und -abbau. Die von ihr bereitgestellten Dienste befreien die Transportschicht davon, die Datenübertragungs- und Vermittlungstechnologien im Netzwerk verstehen zu müssen. Wenn Sie sich die Vermittlungsschicht mit möglichst wenigen Worten merken möchten, lautet sie „Pfadauswahl, Routing und logische Adressierung.“
Die Netzwerkschicht umfasst viele Protokolle, darunter das wichtigste Protokoll, das zugleich das Kernprotokoll von TCP/IP ist – das IP-Protokoll. Das IP-Protokoll ist sehr einfach und bietet nur unzuverlässige, verbindungslose Übertragungsdienste. Die Hauptfunktionen des IP-Protokolls umfassen die verbindungslose Datagrammübertragung, das Datagramm-Routing und die Fehlerkontrolle. Protokolle, die zusammen mit dem IP-Protokoll verwendet werden, um seine Funktionen umzusetzen, umfassen das Address Resolution Protocol (ARP), das Reverse Address Resolution Protocol (RARP), das Internet Control Message Protocol (ICMP) und das Internet Group Management Protocol (IGMP). Wir werden die spezifischen Protokolle in den folgenden Abschnitten zusammenfassen. Die Kernpunkte zur Netzwerkschicht sind:
1> Die Netzwerkschicht ist für das Routing von Paketen zwischen Subnetzen verantwortlich. Darüber hinaus kann die Netzwerkschicht auch Funktionen wie Überlastkontrolle und Internetworking implementieren.
2> Die grundlegende Dateneinheit ist das IP-Datagramm.
3> Hauptsächlich enthaltene Protokolle:
IP-Protokoll (Internet Protocol);
ICMP-Protokoll (Internet Control Message Protocol);
ARP-Protokoll (Address Resolution Protocol);
RARP-Protokoll (Reverse Address Resolution Protocol).
4> Wichtiges Gerät: Router.
4) Transportschicht
Die erste Ende-zu-Ende-Schicht, also die Host-zu-Host-Schicht. Die Transportschicht ist dafür verantwortlich, Daten höherer Schichten zu segmentieren und eine Ende-zu-Ende-Übertragung bereitzustellen, die zuverlässig oder unzuverlässig sein kann. Darüber hinaus übernimmt die Transportschicht auch die Ende-zu-Ende-Fehlerkontrolle und die Flusskontrolle. Die Aufgabe der Transportschicht ist es, die Netzwerkressourcen entsprechend den Eigenschaften des Kommunikationssubnetzes bestmöglich zu nutzen, Funktionen zum Aufbau, zur Aufrechterhaltung und zum Abbau von Transportverbindungen zwischen den Sitzungsschichten zweier Endsysteme bereitzustellen und für die zuverlässige Ende-zu-Ende-Datenübertragung verantwortlich zu sein. Auf dieser Schicht wird die Protokolldateneinheit zur Informationsübertragung als Segment oder Nachricht bezeichnet. Die Netzwerkschicht liefert die von dem Quellknoten gesendeten Datenpakete nur anhand von Netzwerkadressen an den Zielknoten, während die Transportschicht dafür verantwortlich ist, Daten zuverlässig an die entsprechenden Ports zu liefern. Wichtige Punkte zur Transportschicht:
- 1> Die Transportschicht ist dafür verantwortlich, Daten höherer Schichten zu segmentieren und eine Ende-zu-Ende-Übertragung bereitzustellen, die zuverlässig oder unzuverlässig sein kann, sowie Ende-zu-Ende-Fehlerkontrolle und Flusskontrolle;
- 2> Enthaltene Hauptprotokolle: TCP-Protokoll (Transmission Control Protocol), UDP-Protokoll (User Datagram Protocol);
- 3> Wichtiges Gerät: Gateway.
5) Sitzungsschicht
Die Sitzungsschicht verwaltet Sitzungsprozesse zwischen Hosts, das heißt, sie ist für den Aufbau, die Verwaltung und die Beendigung von Sitzungen zwischen Prozessen verantwortlich. Die Sitzungsschicht verwendet außerdem in Daten eingefügte Kontrollpunkte, um die Datensynchronisation zu erreichen.
6) Darstellungsschicht
Die Darstellungsschicht transformiert Daten oder Informationen höherer Schichten, um sicherzustellen, dass Informationen aus der Anwendungsschicht eines Hosts von der Anwendung eines anderen Hosts verstanden werden können. Die Datenkonvertierung in der Darstellungsschicht umfasst Datenverschlüsselung, Komprimierung, Formatkonvertierung usw.
7) Anwendungsschicht
Bietet eine Schnittstelle für Betriebssysteme oder Netzwerkanwendungen, um auf Netzwerkdienste zuzugreifen.
Wichtige Punkte der Sitzungsschicht, Darstellungsschicht und Anwendungsschicht:
- 1> Die grundlegende Einheit der Datenübertragung ist die Nachricht;
- 2> Hauptsächlich enthaltene Protokolle: FTP (File Transfer Protocol), Telnet (Remote Login Protocol), DNS (Domain Name Resolution Protocol), SMTP (Mail Transfer Protocol), POP3-Protokoll (Post Office Protocol), HTTP-Protokoll (Hyper Text Transfer Protocol).
3. IP-Adresse
1) Netzwerkadresse
Eine IP-Adresse besteht aus einer Netzwerknummer (einschließlich der Subnetznummer) und einer Hostnummer. Die Hostnummer einer Netzwerkadresse besteht ausschließlich aus Nullen, und die Netzwerkadresse repräsentiert das gesamte Netzwerk.
2) Broadcast-Adresse
Die Broadcast-Adresse wird üblicherweise als direkte Broadcast-Adresse bezeichnet, um sie von der begrenzten Broadcast-Adresse zu unterscheiden.
Die Hostnummer einer Broadcast-Adresse ist genau entgegengesetzt zu der einer Netzwerkadresse. Bei einer Broadcast-Adresse besteht die Hostnummer ausschließlich aus Einsen. Wenn eine Nachricht an die Broadcast-Adresse eines Netzwerks gesendet wird, können alle Hosts in diesem Netzwerk die Broadcast-Nachricht empfangen.
3) Multicast-Adresse
Klasse-D-Adressen sind Multicast-Adressen.
Erinnern wir uns zunächst an die Adressen der Klassen A, B, C und D:
Adressen der Klasse A beginnen mit 0, wobei das erste Byte die Netzwerknummer ist. Der Adressbereich ist: 0.0.0.0~127.255.255.255; (geändert @2016.05.31)
Adressen der Klasse B beginnen mit 10, wobei die ersten beiden Bytes die Netzwerknummer sind. Der Adressbereich ist: 128.0.0.0~191.255.255.255;
Adressen der Klasse C beginnen mit 110, wobei die ersten drei Bytes die Netzwerknummer sind. Der Adressbereich ist: 192.0.0.0~223.255.255.255.
Adressen der Klasse D beginnen mit 1110, mit dem Adressbereich 224.0.0.0~239.255.255.255. Adressen der Klasse D werden als Multicast-Adressen verwendet (Eins-zu-viele-Kommunikation);
Adressen der Klasse E beginnen mit 1111, mit dem Adressbereich 240.0.0.0~255.255.255.255. Adressen der Klasse E sind reservierte Adressen für zukünftige Verwendung.
Hinweis: Nur bei den Klassen A, B und C wird zwischen Netzwerknummer und Hostnummer unterschieden. Adressen der Klasse D und der Klasse E werden nicht in Netzwerknummer und Hostnummer unterteilt.
4)255.255.255.255
Diese IP-Adresse bezieht sich auf die begrenzte Broadcast-Adresse. Der Unterschied zwischen der begrenzten Broadcast-Adresse und der allgemeinen Broadcast-Adresse (direkte Broadcast-Adresse) besteht darin, dass die begrenzte Broadcast-Adresse nur im lokalen Netzwerk verwendet werden kann und Router keine Pakete weiterleiten, die für die begrenzte Broadcast-Adresse bestimmt sind; die allgemeine Broadcast-Adresse kann sowohl lokal als auch über Netzsegmente hinweg gebroadcastet werden. Zum Beispiel: Nachdem Host 192.168.1.1/30 ein direktes Broadcast-Paket gesendet hat, kann ein anderes Netzsegment, 192.168.1.5/30, das Datagramm ebenfalls empfangen; wenn ein begrenztes Broadcast-Datagramm gesendet wird, kann es nicht empfangen werden.
Hinweis: Allgemeine Broadcast-Adressen (direkte Broadcast-Adressen) können einige Router passieren (natürlich nicht alle Router), während begrenzte Broadcast-Adressen keine Router passieren können.
5)0.0.0.0
Sie wird häufig verwendet, um die eigene IP-Adresse herauszufinden. Wenn beispielsweise in unseren RARP-, BOOTP- und DHCP-Protokollen eine festplattenlose Maschine mit unbekannter IP-Adresse ihre eigene IP-Adresse erfahren möchte, sendet sie ein IP-Anforderungspaket an einen Server im lokalen Bereich (genauer: den durch Router abgeschirmten Bereich) mit 255.255.255.255 als Zieladresse.
6) Loopback-Adresse
127.0.0.0/8 wird als Loopback-Adresse verwendet. Die Loopback-Adresse repräsentiert die Adresse des lokalen Rechners und wird häufig zum Testen des lokalen Rechners verwendet. Am häufigsten wird 127.0.0.1 verwendet.
7) Private Adressen der Klassen A, B und C
Private Adressen werden auch als dedizierte Adressen bezeichnet. Sie werden nicht global verwendet und haben nur lokale Bedeutung.
Private Adresse der Klasse A: 10.0.0.0/8, Bereich: 10.0.0.0~10.255.255.255
Private Adresse der Klasse B: 172.16.0.0/12, Bereich: 172.16.0.0~172.31.255.255
Private Adresse der Klasse C: 192.168.0.0/16, Bereich: 192.168.0.0~192.168.255.255
4. Subnetzmaske und Netzwerkaufteilung
Mit der stetigen Ausweitung der Internetanwendungen sind die Nachteile des ursprünglichen IPv4 allmählich zutage getreten: Die Netzwerknummer belegt zu viele Bits, während die Hostnummer zu wenige Bits hat. Daher werden die Hostadressen, die es bereitstellen kann, zunehmend knapp. Gegenwärtig wird, abgesehen von der Verwendung von NAT zur Zuweisung reservierter Adressen innerhalb eines Unternehmens, üblicherweise eine IP-Adresse einer höheren Klasse unterteilt, um mehrere Subnetze für Benutzergruppen unterschiedlicher Größe zu bilden.
Dies dient hauptsächlich dazu, IP-Adressen bei der Netzsegmentierung effektiv zu nutzen. Indem die höherwertigen Bits der Hostnummer als Subnetznummer verwendet werden, wird die Subnetzmaske von der üblichen Netzbit-Grenze aus erweitert oder komprimiert, um mehr Subnetze für eine bestimmte Adressklasse zu schaffen. Wenn jedoch mehr Subnetze erstellt werden, verringert sich die Anzahl der verfügbaren Hostadressen in jedem Subnetz im Vergleich zum Original.
Was ist eine Subnetzmaske?
Die Subnetzmaske wird verwendet, um anzugeben, ob zwei IP-Adressen zum selben Subnetz gehören. Sie ist ebenfalls eine 32-Bit-Binäradresse, bei der jedes Bit mit 1 ein Netzwerkbit und jedes Bit mit 0 ein Hostbit darstellt. Wie IP-Adressen wird sie auch in punktierter Dezimalschreibweise ausgedrückt. Wenn zwei IP-Adressen bei der bitweisen UND-Verknüpfung mit der Subnetzmaske dasselbe Ergebnis ergeben, zeigt dies an, dass sie zum selben Subnetz gehören.
Bei der Berechnung von Subnetzmasken müssen wir die reservierten Adressen in IP-Adressen beachten, nämlich die "0"-Adresse und die Broadcast-Adresse. Sie beziehen sich auf die IP-Adressen, wenn die Hostadresse oder Netzwerkadresse ganz "0" oder ganz "1" ist. Sie stellen die lokale Netzwerkadresse und die Broadcast-Adresse dar und können im Allgemeinen nicht in die Berechnung einbezogen werden.
Berechnung der Subnetzmaske:
Für eine IP-Adresse, die nicht weiter in Subnetze unterteilt werden muss, ist ihre Subnetzmaske sehr einfach und kann gemäß ihrer Definition geschrieben werden: Wenn beispielsweise eine Klasse-B-IP-Adresse 10.12.3.0 lautet und nicht weiter in Subnetze unterteilt werden muss, ist die Subnetzmaske 255.255.0.0. Wenn es eine Klasse-C-Adresse ist, ist ihre Subnetzmaske 255.255.255.0. Bei anderen gilt dasselbe Muster und wird nicht im Detail beschrieben. Im Folgenden konzentrieren wir uns auf eine IP-Adresse, bei der die höherwertigen Hostbits als die Netzwerknummer des unterteilten Subnetzes verwendet werden müssen und die verbleibenden Bits die Hostnummer jedes Subnetzes sind. Wie sollte in diesem Fall die Subnetzmaske für jedes Subnetz berechnet werden?
Im Folgenden werden häufige Interviewfragen zu Subnetzmasken und Netzwerkaufteilung zusammengefasst:
1) Berechnung anhand der Anzahl der Subnetze
Bevor die Subnetzmaske berechnet wird, müssen Sie zunächst die Anzahl der zu unterteilenden Subnetze und die erforderliche Anzahl von Hosts in jedem Subnetz bestimmen.
(1) Konvertieren Sie die Anzahl der Subnetze in eine Binärdarstellung;
Um beispielsweise die Klasse-B-IP-Adresse 168.195.0.0 in 27 Subnetze zu unterteilen: 27 = 11011;
(2) Ermitteln Sie die Anzahl der Bits in dieser Binärzahl, bezeichnet als N;
Diese Binärzahl hat fünf Bits, also ist N = 5.
(3) Ermitteln Sie die klassenbasierte Subnetzmaske dieser IP-Adresse und setzen Sie dann die führenden N Bits des Hostadressteils auf 1. Dies ergibt die Subnetzmaske zum Aufteilen dieser IP-Adresse in Subnetze.
Setzen Sie die ersten 5 Bits der Hostadresse der Subnetzmaske der Klasse-B-Adresse 255.255.0.0 auf 1, was 255.255.248.0 ergibt.
2) Berechnung anhand der Anzahl der Hosts
Zum Beispiel, um die Klasse-B-IP-Adresse 168.195.0.0 in mehrere Subnetze mit jeweils 700 Hosts aufzuteilen:
(1) Wandeln Sie die Anzahl der Hosts in die Binärdarstellung um;
700=1010111100
(2) Wenn die Anzahl der Hosts kleiner oder gleich 254 ist (Hinweis: Schließen Sie die beiden reservierten IP-Adressen aus), dann ermitteln Sie die Anzahl der Bits in der Binärdarstellung, bezeichnet als N; hier ist N definitiv < 8. Wenn sie größer als 254 ist, dann ist N > 8, was bedeutet, dass die Hostadresse mehr als 8 Bits belegen wird;
Diese Binärzahl hat zehn Bits, also ist N = 10;
(3) Verwenden Sie 255.255.255.255, um alle Hostadressbits dieser Klasse von IP-Adressen auf 1 zu setzen, und setzen Sie dann die N Bits von hinten nach vorn auf 0. Dies ergibt den Wert der Subnetzmaske.
Setzen Sie alle Hostadressbits der Subnetzmaske der Klasse-B-Adresse 255.255.0.0 auf 1, wodurch 255.255.255.255 entsteht; setzen Sie dann die letzten 10 Bits von hinten nach vorn auf 0, was Folgendes ergibt: 11111111.11111111.11111100.00000000, d. h. 255.255.252.0. Dies ist die Subnetzmaske für die Klasse-B-IP-Adresse 168.195.0.0, die in Subnetze mit jeweils 700 Hosts aufgeteilt werden soll.
3) Es gibt eine andere Art von Aufgabe, bei der Sie die Subnetzadressen basierend auf der Anzahl der Hosts in jedem Netzwerk planen unddie Subnetzmaske berechnen müssen. Dies kann ebenfalls nach den oben genannten Prinzipien berechnet werden.
Zum Beispiel, wenn ein Subnetz 10 Hosts hat, dann sind die für dieses Subnetz erforderlichen IP-Adressen:
10+1+1+1=13
Hinweis: Die erste hinzugefügte 1 bezieht sich auf die Gateway-Adresse, die benötigt wird, wenn dieses Netzwerk verbunden ist, und die nächsten beiden 1en beziehen sich auf dieNetzwerkadresse und Broadcast-Adresse.
Da 13 kleiner als 16 ist (16 entspricht 2 hoch 4), sind die Host-Bits 4 Bits. Und 256 - 16 = 240, also ist die Subnetzmaske 255.255.255.240.
Wenn ein Subnetz 14 Hosts hat, besteht ein häufiger Fehler vieler Leute darin, immer noch ein Subnetz mit einem Adressraum von 16 zuzuweisen und zu vergessen, eine Adresse für das Gateway zuzuweisen. Das ist falsch, denn 14 + 1 + 1 + 1 = 17, und 17 ist größer als 16. Daher können wir nur ein Subnetz mit einem Adressraum von 32 zuweisen (32 entspricht 2 hoch 5). In diesem Fall ist die Subnetzmaske: 255.255.255.224.
5. ARP/RARP-Protokoll
Das Address Resolution Protocol, nämlich ARP (Address Resolution Protocol), ist ein TCP/IP-Protokoll, das eine physische Adresse anhand einer IP-Adresse ermittelt.Wenn ein Host Informationen sendet, sendet er eine ARP-Anfrage mit der Ziel-IP-Adresse als Broadcast an alle Hosts im Netzwerk und empfängt Rückmeldungen, um die physische Adresse des Ziels zu bestimmen. Nach dem Empfang der Rückmeldung speichert er die IP-Adresse und die physische Adresse für eine bestimmte Zeit im lokalen ARP-Cache und fragt beim nächsten Mal direkt den ARP-Cache ab, um Ressourcen zu sparen. Das Address Resolution Protocol basiert auf gegenseitigem Vertrauen zwischen den Hosts im Netzwerk. Hosts im Netzwerk können autonom ARP-Antwortnachrichten senden. Wenn andere Hosts Antwortnachrichten empfangen, tragen sie diese in ihren lokalen ARP-Cache ein, ohne die Echtheit der Nachrichten zu prüfen. Infolgedessen kann ein Angreifer ein gefälschtes ARP-Antwortpaket an einen bestimmten Host senden, wodurch die von ihm gesendeten Informationen den vorgesehenen Host nicht erreichen oder den falschen Host erreichen, was ARP-Spoofing darstellt.Der ARP-Befehl kann verwendet werden, um die Zuordnung zwischen IP-Adressen und MAC-Adressen im lokalen ARP-Cache abzufragen, statische Zuordnungen hinzuzufügen oder zu löschen und so weiter.
Beispiel für den Arbeitsablauf von ARP:
Die IP-Adresse von Host A ist 192.168.1.1 und die MAC-Adresse ist 0A-11-22-33-44-01;
Die IP-Adresse von Host B ist 192.168.1.2 und die MAC-Adresse ist 0A-11-22-33-44-02;
Wenn Host A mit Host B kommunizieren möchte, kann das Address Resolution Protocol die IP-Adresse von Host B (192.168.1.2) in die MAC-Adresse von Host B auflösen. Der Ablauf ist wie folgt:
- (1) Gemäß der Routing-Tabelle auf Host A bestimmt IP, dass die zum Zugriff auf Host B verwendete Weiterleitungs-IP-Adresse 192.168.1.2 ist. Dann prüft Host A seinen lokalen ARP-Cache auf eine passende MAC-Adresse von Host B.
- (2) Wenn Host A keine Zuordnung im ARP-Cache findet, fragt er die Hardwareadresse von 192.168.1.2 an, indem er einen ARP-Anfrageframe an alle Hosts im lokalen Netzwerk sendet. Die IP-Adresse und die MAC-Adresse des Quellhosts A sind beide in der ARP-Anfrage enthalten. Jeder Host im lokalen Netzwerk empfängt die ARP-Anfrage und prüft, ob sie mit seiner eigenen IP-Adresse übereinstimmt. Wenn ein Host feststellt, dass die angeforderte IP-Adresse nicht mit seiner eigenen übereinstimmt, verwirft er die ARP-Anfrage.
- (3) Host B stellt fest, dass die IP-Adresse in der ARP-Anfrage mit seiner eigenen IP-Adresse übereinstimmt, und fügt die Zuordnung der IP-Adresse und der MAC-Adresse von Host A zu seinem lokalen ARP-Cache hinzu.
- (4) Host B sendet eine ARP-Antwortnachricht, die seine MAC-Adresse enthält, direkt an Host A zurück.
- (5) Wenn Host A die ARP-Antwortnachricht von Host B empfängt, aktualisiert er den ARP-Cache mit der Zuordnung von IP- und MAC-Adresse von Host B. Der lokale Cache hat eine Lebensdauer; nach Ablauf der Lebensdauer wird der obige Vorgang erneut wiederholt. Sobald die MAC-Adresse von Host B ermittelt ist, kann Host A eine IP-Kommunikation an Host B senden.
Das Reverse Address Resolution Protocol, nämlich RARP, hat eine entgegengesetzte Funktion zu der von ARP. Es wandelt die physische Adresse eines Hosts im lokalen Netzwerk in eine IP-Adresse um.
Zum Beispiel: Wenn ein Host im LAN nur seine physische Adresse kennt, aber nicht seine IP-Adresse, kann er über das RARP-Protokoll eine Broadcast-Anfrage senden, um nach seiner eigenen IP-Adresse zu fragen, und dann ist ein RARP-Server für die Antwort zuständig.
RARP-Protokollablauf:
- (1) Sende einen lokalen RARP-Broadcast an den Host. In diesem Broadcast-Paket gib die eigene MAC-Adresse an und bitte jeden RARP-Server, der diese Anfrage empfängt, eine IP-Adresse zuzuweisen;
- (2) Nach Erhalt der Anfrage prüft der RARP-Server im lokalen Netzsegment seine RARP-Liste, um die der MAC-Adresse entsprechende IP-Adresse zu finden;
- (3) Wenn sie existiert, sendet der RARP-Server ein Antwortpaket an den Quellhost und stellt diese IP-Adresse dem Peer-Host zur Verwendung bereit;
- (4) Wenn sie nicht existiert, antwortet der RARP-Server nicht auf diese Anfrage;
6. Routing-Protokoll
Zu den gängigen Routing-Protokollen gehören: RIP-Protokoll, OSPF-Protokoll.
RIPProtokoll: Die darunterliegende Ebene ist der Bellman-Ford-Algorithmus. Seine Routing-Metrik ist die Hop-Anzahl, und die maximale Hop-Anzahl ist 15. Wenn sie größer als 15 Hops ist, wird das Datenpaket verworfen.
OSPFProtokoll: Open Shortest Path First (OSPF). Die darunterliegende Ebene ist der Dijkstra-Algorithmus. Es ist ein Link-State-Routing-Protokoll. Seine Routing-Metriken sind Bandbreite und Verzögerung.
7. TCP/IP-Protokoll
Das TCP/IP-Protokoll ist das grundlegendste Protokoll des Internets und die Basis des internationalen verbundenen Netzwerks. Es besteht aus dem IP-Protokoll auf der Netzwerkschicht und dem TCP-Protokoll auf der Transportschicht. Laienhaft ausgedrückt: TCP ist dafür verantwortlich, Übertragungsprobleme zu erkennen. Sobald ein Problem auftritt, sendet es ein Signal mit der Anforderung einer Neuübertragung, bis alle Daten sicher und korrekt an das Ziel übertragen wurden. IP weist jedem vernetzten Gerät im Internet eine Adresse zu.
Die IP-Schicht empfängt Datenpakete von der darunterliegenden Schicht (Netzwerkschnittstellenschicht, z. B. Ethernet-Gerätetreiber) und sendet sie an die darüberliegende Schicht – TCP- oder UDP-Schicht; umgekehrt übermittelt die IP-Schicht auch Datenpakete, die von der TCP- oder UDP-Schicht empfangen wurden, an die darunterliegende Schicht. IP-Datagramme sind unzuverlässig, da IP nichts tut, um zu bestätigen, ob die Datenpakete in der richtigen Reihenfolge gesendet oder beschädigt wurden. IP-Datagramme enthalten die Adresse des Hosts, der sie gesendet hat (Quelladresse), und die Adresse des Hosts, der sie empfängt (Zieladresse).
TCP ist ein verbindungsorientiertes Kommunikationsprotokoll. Eine Verbindung wird durch einen Drei-Wege-Handshake hergestellt, und die Verbindung muss getrennt werden, wenn die Kommunikation abgeschlossen ist. Da TCP verbindungsorientiert ist, kann es nur für Ende-zu-Ende-Kommunikation verwendet werden. TCP bietet einen zuverlässigen Datenstromdienst und verwendet die Technik "positive Bestätigung mit Neuübertragung", um Übertragungszuverlässigkeit zu erreichen. TCP verwendet außerdem eine Methode namens "Schiebefenster" zur Flusskontrolle. Das sogenannte Fenster repräsentiert tatsächlich die Empfangsfähigkeit und dient dazu, die Sendegeschwindigkeit des Senders zu begrenzen.
Header-Format des TCP-Segments:

Drei-Wege-Handshake und Vier-Wege-Verbindungsabbau des TCP-Protokolls:
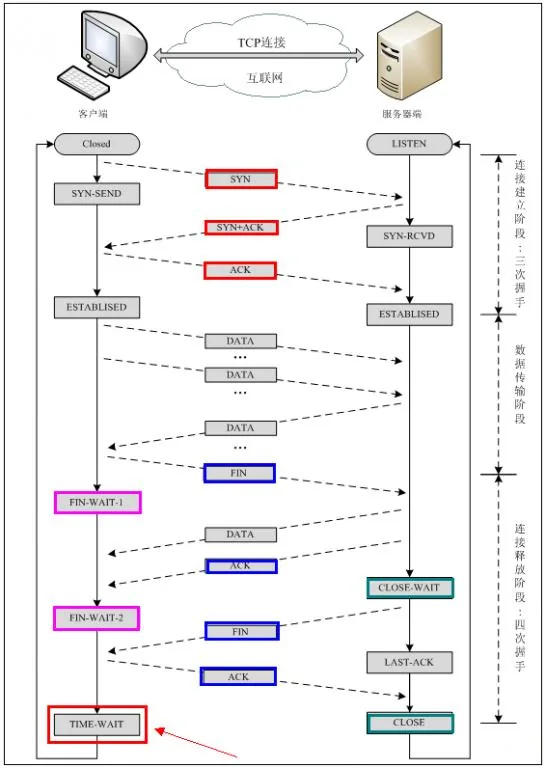
Hinweis: seq: "sequence" Sequenznummer;ack: "acknowledge" Bestätigungsnummer;SYN: "synchronize" Synchronisierungsanforderungsflag;;ACK: "acknowledge" Bestätigungsflag";FIN: "Finally" Beendigungsflag.
TCP-Verbindungsaufbauprozess:Zuerst sendet der Client ein Verbindungsanforderungssegment. Nachdem der Server die Verbindung empfangen hat, antwortet er mit einem ACK-Segment und weist Ressourcen für diese Verbindung zu. Nachdem der Client das ACK-Segment empfangen hat, sendet er ebenfalls ein ACK-Segment an den Server und weist Ressourcen zu. Auf diese Weise wird die TCP-Verbindung aufgebaut.
TCP-Verbindungsabbau:Angenommen, der Client initiiert eine Anfrage zum Beenden der Verbindung, d. h. er sendet ein FIN-Segment. Nachdem der Server das FIN-Segment empfangen hat, bedeutet das: „Ich (Client) habe keine weiteren Daten mehr an dich zu senden“, aber wenn du noch Daten hast, die nicht gesendet wurden, musst du nicht überstürzt das Socket schließen, sondern kannst weiter Daten senden. Also sendest du zuerst ACK und „sagst dem Client: Ich habe deine Anfrage erhalten, aber ich bin noch nicht bereit, bitte warte weiter auf meine Nachricht.“ Zu diesem Zeitpunkt geht der Client in den Zustand FIN_WAIT über und wartet weiter auf das FIN-Segment des Servers. Wenn der Server feststellt, dass die Daten vollständig gesendet wurden, sendet er ein FIN-Segment an den Client und „teilt dem Client mit: OK, ich habe hier die Daten fertig gesendet und bin bereit, die Verbindung zu schließen.“ Nachdem der Client das FIN-Segment empfangen hat, „weiß er, dass er die Verbindung schließen kann, aber er vertraut dem Netzwerk immer noch nicht und befürchtet, dass der Server möglicherweise nicht weiß, dass er schließen muss; deshalb geht er nach dem Senden von ACK in den Zustand TIME_WAIT über. Falls der Server das ACK nicht empfängt, kann er es erneut übertragen.“ Nachdem der Server das ACK empfangen hat, „weiß er, dass er die Verbindung trennen kann.“ Nachdem der Client 2MSL gewartet hat und immer noch keine Antwort erhält, beweist dies, dass der Server normal geschlossen wurde. Nun, der Client kann ebenfalls die Verbindung schließen. OK, auf diese Weise wird die TCP-Verbindung geschlossen!
Warum der Drei-Wege-Handshake?
Im Falle von nur zwei „Handshakes“: Angenommen, der Client möchte eine Verbindung mit dem Server aufbauen, aber weil das Verbindungsanforderungs-Datagramm unterwegs verloren geht, muss der Client es erneut senden. Zu diesem Zeitpunkt empfängt der Server nur eine Verbindungsanforderung, sodass er die Verbindung normal aufbauen kann. Manchmal sendet der Client die Anforderung jedoch nicht deshalb erneut, weil das Datagramm verloren gegangen ist, sondern weil die Daten während der Übertragung aufgrund hoher Netzwerkkonkurrenz an einem bestimmten Knoten blockiert werden können. In diesem Fall empfängt der Server nacheinander 2 Anforderungen und wartet weiter darauf, dass die beiden Client-Anforderungen Daten an ihn senden ... Das Problem liegt hier: Der Client hat tatsächlich nur eine Anforderung gestellt, aber der Server hat 2 Antworten. In extremen Fällen kann der Client die Anforderungsdaten mehrmals erneut senden, sodass der Server schließlich N-fach mehrere wartende Antworten aufbaut, was zu einer großen Ressourcenverschwendung führt! Daher ist ein „Drei-Wege-Handshake“ sehr notwendig!
Warum vier Wege zum Verbindungsabbau?
Stellen Sie sich vor, Sie sind jetzt der Client und möchten alle Verbindungen zum Server trennen. Was würden Sie tun? Zuerst stoppen Sie das Senden von Daten an den Server und warten auf die Antwort des Servers. Aber die Sache ist noch nicht vorbei. Obwohl Sie keine Daten mehr an den Server senden, hat er, da Sie zuvor bereits eine gleichberechtigte Verbindung aufgebaut haben, nun ebenfalls die Initiative, Daten an Sie zu senden; daher muss der Server auch das aktive Senden von Daten an Sie beenden und auf Ihre Bestätigung warten. Genau genommen stellt es die vollständige Ausführung eines Vertrags zwischen beiden Parteien sicher!
Protokolle, die TCP verwenden: FTP (File Transfer Protocol), Telnet (Remote Login Protocol), SMTP (Simple Mail Transfer Protocol), POP3 (im Gegensatz zu SMTP, wird zum Empfangen von E-Mails verwendet), HTTP-Protokoll usw.
8. UDP-Protokoll
UDP, das User Datagram Protocol, ist ein verbindungsloses Kommunikationsprotokoll. UDP-Daten enthalten Informationen zur Zielportnummer und zur Quellportnummer. Da die Kommunikation keine Verbindung erfordert, kann eine Broadcast-Übertragung erreicht werden.
UDP-Kommunikation erfordert keine Empfängerbestätigung. Sie ist eine unzuverlässige Übertragung, und Paketverlust kann auftreten. In praktischen Anwendungen müssen Programmierer sie durch Programmierung überprüfen.
UDP und TCP befinden sich auf derselben Schicht, aber UDP kümmert sich nicht um die Reihenfolge, Fehler oder Neuübertragung von Datenpaketen. Daher wird UDP nicht für verbindungsorientierte Dienste verwendet, die virtuelle Verbindungen nutzen. UDP wird hauptsächlich für auf Abfrage-Antwort ausgerichtete Dienste wie NFS verwendet. Im Vergleich zu FTP oder Telnet müssen diese Dienste eine geringere Informationsmenge austauschen.
Jede UDP-Nachricht wird in zwei Teile unterteilt: UDP-Header und UDP-Datenbereich. Der Header besteht aus vier 16-Bit-(2-Byte)-Feldern, die jeweils den Quellport, den Zielport, die Nachrichtenlänge und die Prüfsumme der Nachricht beschreiben. Der UDP-Header besteht aus 4 Domänen, die jeweils 2 Bytes belegen, wie folgt:
- (1) Quellportnummer;
- (2) Zielportnummer;
- (3) Datagrammlänge;
- (4) Prüfsumme.
Zu den Protokollen, die UDP verwenden, gehören: TFTP (Trivial File Transfer Protocol), SNMP (Simple Network Management Protocol), DNS (Protokoll zur Domänennamenauflösung), NFS, BOOTP.
TCP und UDP Der Unterschied zwischen TCP und UDP:TCP ist ein verbindungsorientierter, zuverlässiger Byte-Stream-Dienst; UDP ist ein verbindungsloser, unzuverlässiger Datagramm-Dienst.
9. DNS-Protokoll
DNS ist die Abkürzung für Domain Name System, das verwendet wird, um Computer und Netzwerkdienste zu benennen, die in einer Domänenhierarchie organisiert sind.Es kann einfach als Umwandlung von URL in IP-Adresse verstanden werden.Ein Domänenname besteht aus einer Zeichenkette von Wörtern oder Abkürzungen, die durch Punkte getrennt sind. Jeder Domänenname entspricht einer eindeutigen IP-Adresse. Im Internet gibt es eine Eins-zu-eins-Entsprechung zwischen Domänennamen und IP-Adressen. DNS ist der Server, der die Domänennamenauflösung durchführt. DNS-Namensgebung wird in TCP/IP-Netzwerken wie dem Internet verwendet, um Computer und Dienste anhand benutzerfreundlicher Namen zu finden.
10. NAT-Protokoll
NAT (Network Address Translation) ist eine Technologie für den Zugriff auf WANs. Es ist eine Konvertierungstechnologie, die private (reservierte) Adressen in legale IP-Adressen übersetzt. Sie wird in verschiedenen Arten von Internetzugangsverfahren und verschiedenen Arten von Netzwerken weit verbreitet eingesetzt. Der Grund ist einfach: NAT löst nicht nur perfekt das Problem unzureichender IP-Adressen, sondern vermeidet auch effektiv Angriffe von außerhalb des Netzwerks und verbirgt und schützt Computer innerhalb des Netzwerks.
11. DHCP-Protokoll
DHCP (Dynamic Host Configuration Protocol) ist ein Netzwerkprotokoll für lokale Netzwerke. Es arbeitet mit dem UDP-Protokoll und hat zwei Hauptzwecke: automatisch IP-Adressen an interne Netzwerke oder Netzwerkdienstanbieter zuzuweisen und als Mittel für Benutzer oder interne Netzwerkadministratoren zu dienen, um alle Computer zentral zu verwalten.
12. HTTP-Protokoll
HTTP (HyperText Transfer Protocol) ist das am weitesten verbreitete Netzwerkprotokoll im Internet. Alle WWW-Dateien müssen diesem Standard entsprechen. HTTP Welche Anfragen umfasst das Protokoll?
GET: Anfragen zum Lesen der durch die URL identifizierten Informationen.
POST: Fügt dem Server Informationen hinzu (z. B. Kommentare).
PUT: Speichert ein Dokument unter der angegebenen URL.
DELETE: Löscht die durch die angegebene URL identifizierte Ressource.
HTTP Darunter, POST und GET der Unterschied
- 1) GET dient zum Abrufen von Daten vom Server, während POST zum Senden von Daten an den Server dient.
- 2) GET hängt die Parameterdaten-Warteschlange an die URL an, auf die das Action-Attribut des übermittelten Formulars zeigt, wobei die Werte eins zu eins den einzelnen Feldern im Formular entsprechen und in der URL sichtbar sind.
- 3) GET überträgt eine kleine Datenmenge, nicht mehr als 2KB; POST überträgt eine größere Datenmenge, die standardmäßig allgemein als unbegrenzt gilt.
- 4) Gemäß der HTTP-Spezifikation wird GET für den Informationsabruf verwendet und sollte sicher und idempotent sein.
- I. Das sogenanntesicherebedeutet, dass die Operation verwendet wird, um Informationen zu erhalten, statt sie zu ändern. Mit anderen Worten: GET-Anfragen sollten im Allgemeinen keine Nebenwirkungen erzeugen. Das heißt, sie ruft lediglich Ressourceninformationen ab, wie eine Datenbankabfrage, und ändert oder ergänzt keine Daten und beeinflusst auch nicht den Zustand der Ressource.
- II. Idempotentbedeutet, dass mehrere Anfragen an dieselbe URL dasselbe Ergebnis zurückgeben sollten.
13. Ein Beispiel
Geben Sie im Browserhttp://www.baidu.com/ein; der gesamte danach ausgeführte Vorgang.
Nehmen wir nun an, wir geben http://www.baidu.com im Client-Browser ein, und baidu.com ist der Server, auf den zugegriffen werden soll. Im Folgenden folgt eine detaillierte Analyse der Reihe von Protokollvorgängen, die der Client ausführt, um auf den Server zuzugreifen:
- 1) Der Client-Browser löst die IP-Adresse von www.baidu.com über DNS in 220.181.27.48 auf und verwendet diese IP-Adresse, um den Pfad vom Client zum Server zu finden. Der Client-Browser initiiert eine HTTP-Sitzung zu 220.161.27.48, kapselt dann das Datenpaket über TCP und übergibt es an die Netzwerkschicht.
- 2) Auf der Transportschicht des Clients wird die HTTP-Sitzungsanfrage in Segmente aufgeteilt und Quell- und Zielports werden hinzugefügt. Beispielsweise verwendet der Server Port 80, um auf Client-Anfragen zu lauschen, während der Client zufällig einen Port wie 5000 auswählt, um mit dem Server zu kommunizieren, und der Server gibt die entsprechende Anfrage an den Port 5000 des Clients zurück. Dann wird die IP-Adresse in der IP-Schicht verwendet, um das Ziel zu finden.
- 3) Die Netzwerkschicht des Clients muss sich nicht um die Anwendungsschicht oder die Transportschicht kümmern. Ihre Hauptaufgabe besteht darin, durch Nachschlagen in der Routing-Tabelle zu bestimmen, wie der Server erreicht wird. Dabei werden möglicherweise mehrere Router durchlaufen. Dies sind alles Aufgaben, die von Routern erledigt werden, und sie werden nicht im Detail beschrieben. Sie entscheidet einfach durch Nachschlagen in der Routing-Tabelle, welchen Pfad sie wählt, um den Server zu erreichen.
- 4) Auf der Verbindungsschicht des Clients wird das Paket über die Verbindungsschicht an den Router gesendet. Die zur angegebenen IP-Adresse gehörende MAC-Adresse wird durch das Nachbarprotokoll ermittelt, und dann wird eine ARP-Anfrage gesendet, um die Zieladresse zu finden. Sobald eine Antwort empfangen wird, kann das über ARP-Anfrage/-Antwort ausgetauschte IP-Datenpaket nun übertragen werden, und dann wird das IP-Datenpaket an die Adresse des Servers gesendet.
Original-Link: http://www.cnblogs.com/maybe2030/p/4781555.html