- 1. Division des couches réseau
- 2. Modèle de réseau OSI en sept couches
- 3. Adresse IP
- 4. Masque de sous-réseau et division réseau
- 5. ARP/RARP
- 6. Routage
- 7. Protocole TCP/IP
- 8. Protocole UDP
- 9. Protocole DNS
- 10. Protocole NAT
- 11. Protocole DHCP
- 12. Protocole HTTP
- 13. Un exemple
Le contenu central de l'apprentissage des réseaux informatiques est l'étude des protocoles réseau. Les protocoles réseau sont un ensemble de règles, de normes ou de conventions établies pour l'échange de données dans les réseaux informatiques. Étant donné que les terminaux de données de différents utilisateurs peuvent utiliser des jeux de caractères différents, la communication entre eux doit être fondée sur certaines normes. Une analogie parlante est notre langue. Notre grand pays a un vaste territoire et une population nombreuse, avec des langues locales très riches, et les différences entre les dialectes sont énormes. Un dialecte de la région A peut être complètement inacceptable pour les gens de la région B, nous devons donc établir une norme linguistique pour la communication entre les personnes de tout le pays ; c'est le rôle du mandarin. De même, à l'échelle mondiale, la langue standard pour communiquer avec des amis étrangers est l'anglais, c'est pourquoi nous devons étudier l'anglais avec autant d'efforts.
Les protocoles de réseau informatique, comme nos langues, sont divers. ARPA a introduit un protocole réseau appelé ARPANET de 1977 à 1979, qui a été largement populaire. La raison la plus importante était qu'il introduisait le célèbre protocole réseau standard TCP/IP. Actuellement, le protocole TCP/IP est devenu le "langage commun" de l'Internet. La figure ci-dessous est un schéma de communication entre différents groupes d'ordinateurs utilisant TCP/IP.

1. Division des couches réseau
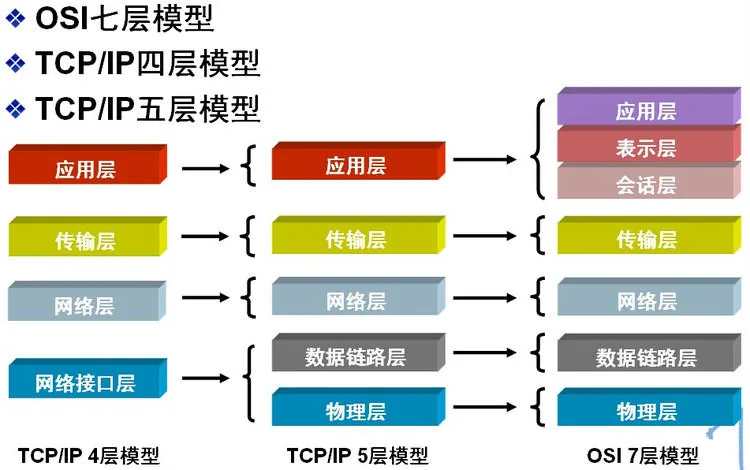
Afin de permettre aux ordinateurs produits par différents fabricants de communiquer entre eux, et ainsi d’établir des réseaux informatiques sur une zone plus étendue, l’Organisation internationale de normalisation (ISO) a proposé en 1978 le « modèle de référence pour l’interconnexion de systèmes ouverts », à savoir le célèbre modèle OSI/RM (Open System Interconnection/Reference Model). Il divise les protocoles de communication de l’architecture des réseaux informatiques en sept couches, du bas vers le haut : couche physique (Physics Layer), couche de liaison de données, couche réseau, couche de transport, couche de session, couche de présentation, couche d’application. La quatrième couche assure les services de transmission de données, et les trois couches supérieures sont orientées utilisateur.
Outre le modèle OSI standard en sept couches, les divisions courantes des couches réseau incluent également le protocole TCP/IP en quatre couches et le protocole TCP/IP en cinq couches. Leur correspondance est illustrée dans la figure ci-dessous :
2. Modèle de réseau OSI en sept couches
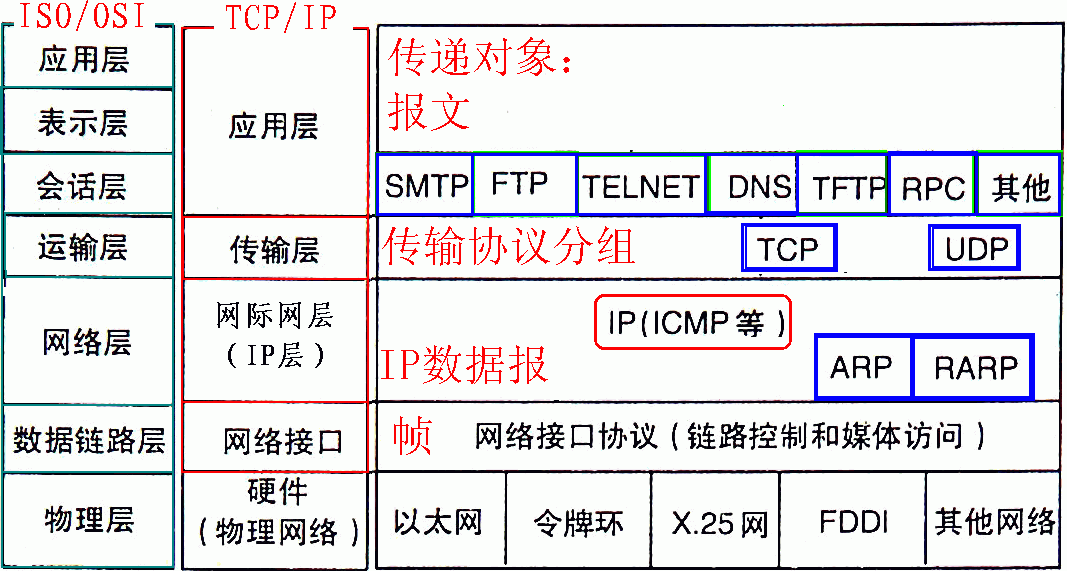
Le protocole TCP/IP est sans aucun doute le protocole fondamental d’Internet. Sans lui, il serait impossible d’accéder à Internet, et toute opération liée à Internet est indissociable du protocole TCP/IP. Qu’il s’agisse du modèle OSI en sept couches ou du modèle TCP/IP en quatre ou cinq couches, chaque couche possède son propre protocole exclusif pour accomplir le travail correspondant et communiquer avec les couches supérieures et inférieures. Comme le modèle OSI en sept couches est la division hiérarchique standard des réseaux, nous allons le présenter couche par couche, du bas vers le haut, en prenant comme exemple le modèle OSI en sept couches.
1) Couche physique
Activer, maintenir et désactiver les caractéristiques mécaniques, électriques, fonctionnelles et procédurales entre les points de communication.Cette couche fournit un support physique fiable pour transmettre des données aux protocoles des couches supérieures. En termes simples, la couche physique garantit que les données brutes peuvent être transmises sur divers supports physiques.Pour la couche physique, retenez deux noms d’appareils importants : répéteur (aussi appelé amplificateur) et concentrateur (hub).
2) Couche liaison de données
La couche liaison de données fournit des services à la couche réseau sur la base des services fournis par la couche physique. Son service le plus élémentaire consiste à transmettre de manière fiable les données de la couche réseau vers la couche réseau de la machine cible aux nœuds adjacents. Pour atteindre cet objectif, la liaison de données doit disposer d’une série de fonctions correspondantes, principalement : comment combiner les données en blocs de données, appelés trames dans la couche liaison de données ; la trame est l’unité de transmission de la couche liaison de données ; comment contrôler la transmission des trames sur les canaux physiques, y compris comment gérer les erreurs de transmission et comment ajuster le débit d’envoi pour s’adapter au récepteur ; et comment assurer la gestion de l’établissement, de la maintenance et de la libération des chemins de liaison de données entre deux entités réseau. La couche liaison de données assure une transmission fiable sur des supports physiques non fiables. Ses fonctions comprennent l’adressage des adresses physiques, la mise en trames des données, le contrôle de flux, la détection des erreurs de données, la retransmission, etc.
Points de connaissance importants sur la couche liaison de données :
1> La couche liaison de données fournit une transmission fiable des données à la couche réseau.
2> L’unité de données de base est la trame.
3> Protocole principal : protocole Ethernet.
4> Deux noms d’appareils importants : pont et commutateur.
3) Couche réseau
Le but de la couche réseau est de réaliser une transmission transparente des données entre deux systèmes d’extrémité. Ses fonctions spécifiques comprennent l’adressage et le routage, l’établissement, la maintenance et la terminaison des connexions. Les services qu’elle fournit dispensent la couche transport de devoir comprendre les technologies de transmission et de commutation des données dans le réseau. Si vous voulez retenir la couche réseau en aussi peu de mots que possible, c’est « sélection de chemin, routage et adressage logique ».
La couche réseau implique de nombreux protocoles, dont le plus important, qui est aussi le protocole central de TCP/IP — le protocole IP. Le protocole IP est très simple ; il ne fournit qu'un service de transmission non fiable et sans connexion. Les principales fonctions du protocole IP comprennent la transmission de datagrammes sans connexion, le routage des datagrammes et le contrôle des erreurs. Les protocoles utilisés conjointement avec le protocole IP pour mettre en œuvre ses fonctions comprennent le protocole de résolution d'adresses (ARP), le protocole de résolution d'adresses inverse (RARP), le protocole de messages de contrôle Internet (ICMP) et le protocole de gestion de groupes Internet (IGMP). Nous résumerons les protocoles spécifiques dans les sections suivantes. Les points clés concernant la couche réseau sont :
1> La couche réseau est responsable du routage des paquets entre les sous-réseaux. De plus, la couche réseau peut également mettre en œuvre des fonctions telles que le contrôle de congestion et l'interconnexion de réseaux.
2> L'unité de données de base est le datagramme IP.
3> Principaux protocoles inclus :
Protocole IP (protocole Internet) ;
Protocole ICMP (protocole de messages de contrôle Internet) ;
Protocole ARP (protocole de résolution d'adresses) ;
Protocole RARP (protocole de résolution d'adresses inverse).
4> Équipement important : routeur.
4) Couche transport
La première couche de bout en bout, c'est-à-dire la couche hôte à hôte. La couche transport est responsable de la segmentation des données des couches supérieures et de la fourniture d'une transmission de bout en bout, fiable ou non fiable. En outre, la couche transport gère également le contrôle des erreurs et le contrôle de flux de bout en bout. La tâche de la couche transport est d'utiliser au mieux les ressources du réseau en fonction des caractéristiques du sous-réseau de communication, de fournir des fonctions pour établir, maintenir et libérer des connexions de transport entre les couches session de deux systèmes d'extrémité, et d'être responsable de la transmission fiable des données de bout en bout. À cette couche, l'unité de données de protocole pour la transmission d'informations est appelée segment ou message. La couche réseau se contente de livrer les paquets de données envoyés par le nœud source au nœud de destination en fonction des adresses réseau, tandis que la couche transport est responsable de livrer de manière fiable les données aux ports correspondants. Points clés concernant la couche transport :
- 1> La couche transport est responsable de la segmentation des données des couches supérieures et de la fourniture d'une transmission de bout en bout, fiable ou non fiable, ainsi que du contrôle des erreurs et du contrôle de flux de bout en bout ;
- 2> Principaux protocoles inclus : protocole TCP (Transmission Control Protocol), protocole UDP (User Datagram Protocol) ;
- 3> Appareil important : passerelle.
5) Couche session
La couche session gère les processus de session entre les hôtes, c'est-à-dire qu'elle est responsable de l'établissement, de la gestion et de la terminaison des sessions entre les processus. La couche session utilise également des points de contrôle insérés dans les données pour assurer la synchronisation des données.
6) Couche présentation
La couche présentation transforme les données ou informations des couches supérieures afin de garantir que les informations provenant de la couche application d'un hôte puissent être comprises par l'application d'un autre hôte. La conversion des données dans la couche présentation comprend le chiffrement des données, la compression, la conversion de format, etc.
7) Couche application
Fournit une interface permettant aux systèmes d'exploitation ou aux applications réseau d'accéder aux services réseau.
Points clés de la couche session, de la couche présentation et de la couche application :
- 1> L'unité de base de la transmission de données est le message ;
- 2> Principaux protocoles inclus : FTP (File Transfer Protocol), Telnet (Remote Login Protocol), DNS (Domain Name Resolution Protocol), SMTP (Mail Transfer Protocol), protocole POP3 (Post Office Protocol), protocole HTTP (Hyper Text Transfer Protocol).
3. Adresse IP
1) Adresse réseau
Une adresse IP se compose d'un numéro de réseau (y compris le numéro de sous-réseau) et d'un numéro d'hôte. Le numéro d'hôte d'une adresse réseau est composé uniquement de 0, et l'adresse réseau représente l'ensemble du réseau.
2) Adresse de diffusion
L'adresse de diffusion est généralement appelée adresse de diffusion directe, afin de la distinguer de l'adresse de diffusion limitée.
Le numéro d'hôte d'une adresse de diffusion est exactement opposé à celui d'une adresse réseau. Dans une adresse de diffusion, le numéro d'hôte est composé uniquement de 1. Lorsqu'un message est envoyé à l'adresse de diffusion d'un réseau, tous les hôtes de ce réseau peuvent recevoir le message de diffusion.
3) Adresse de multidiffusion
Les adresses de classe D sont des adresses de multidiffusion.
Rappelons d'abord les adresses de classe A, B, C et D :
Les adresses de classe A commencent par 0, le premier octet étant le numéro de réseau. La plage d'adresses est : 0.0.0.0~127.255.255.255 ; (modifié @2016.05.31)
Les adresses de classe B commencent par 10, les deux premiers octets étant le numéro de réseau. La plage d'adresses est : 128.0.0.0~191.255.255.255 ;
Les adresses de classe C commencent par 110, les trois premiers octets étant le numéro de réseau. La plage d'adresses est : 192.0.0.0~223.255.255.255.
Les adresses de classe D commencent par 1110, avec la plage d'adresses 224.0.0.0~239.255.255.255. Les adresses de classe D sont utilisées comme adresses multicast (communication un-à-plusieurs) ;
Les adresses de classe E commencent par 1111, avec la plage d'adresses 240.0.0.0~255.255.255.255. Les adresses de classe E sont des adresses réservées pour une utilisation future.
Remarque : seules les classes A, B et C établissent une distinction entre le numéro de réseau et le numéro d'hôte. Les adresses de classe D et de classe E ne sont pas divisées en numéro de réseau et numéro d'hôte.
4)255.255.255.255
Cette adresse IP désigne l'adresse de diffusion limitée. La différence entre l'adresse de diffusion limitée et l'adresse de diffusion générale (adresse de diffusion directe) est que l'adresse de diffusion limitée ne peut être utilisée que sur le réseau local, et les routeurs ne transmettent pas les paquets destinés à l'adresse de diffusion limitée ; l'adresse de diffusion générale peut être diffusée à la fois localement et sur des segments réseau. Par exemple : après que l'hôte 192.168.1.1/30 envoie un paquet de diffusion directe, un autre segment réseau, 192.168.1.5/30, peut également recevoir le datagramme ; si un datagramme de diffusion limitée est envoyé, il ne peut pas être reçu.
Remarque : les adresses de diffusion générale (adresses de diffusion directe) peuvent traverser certains routeurs (bien sûr, pas tous les routeurs), tandis que les adresses de diffusion limitée ne peuvent pas traverser les routeurs.
5)0.0.0.0
Il est souvent utilisé pour trouver sa propre adresse IP. Par exemple, dans nos protocoles RARP, BOOTP et DHCP, si une machine sans disque dont l'adresse IP est inconnue veut connaître sa propre adresse IP, elle envoie un paquet de requête IP à un serveur de la portée locale (plus précisément, la portée isolée par les routeurs) avec 255.255.255.255 comme adresse de destination.
6) Adresse de bouclage
127.0.0.0/8 est utilisé comme adresse de bouclage. L'adresse de bouclage représente l'adresse de la machine locale et est souvent utilisée pour tester la machine locale. La plus couramment utilisée est 127.0.0.1.
7) Adresses privées de classe A, B et C
Les adresses privées sont aussi appelées adresses dédiées. Elles ne sont pas utilisées globalement et n'ont qu'une signification locale.
Adresse privée de classe A : 10.0.0.0/8, plage : 10.0.0.0~10.255.255.255
Adresse privée de classe B : 172.16.0.0/12, plage : 172.16.0.0~172.31.255.255
Adresse privée de classe C : 192.168.0.0/16, plage : 192.168.0.0~192.168.255.255
4. Masque de sous-réseau et division réseau
Avec l'expansion continue des applications Internet, les inconvénients de l'IPv4 d'origine se sont progressivement révélés : le numéro de réseau occupe trop de bits, tandis que le numéro d'hôte en a trop peu. Par conséquent, les adresses d'hôte qu'il peut fournir sont de plus en plus rares. Actuellement, outre l'utilisation de NAT pour attribuer des adresses réservées au sein d'une entreprise, une adresse IP de classe supérieure est généralement subdivisée pour former plusieurs sous-réseaux destinés à des groupes d'utilisateurs de tailles différentes.
Il s'agit principalement d'utiliser efficacement les adresses IP dans le cas d'une segmentation du réseau. En prenant les bits de poids fort du numéro d'hôte comme numéro de sous-réseau, le masque de sous-réseau est étendu ou compressé à partir de la limite habituelle des bits de réseau afin de créer davantage de sous-réseaux pour une certaine classe d'adresses. Toutefois, lorsqu'on crée davantage de sous-réseaux, le nombre d'adresses d'hôte disponibles sur chaque sous-réseau sera réduit par rapport à l'original.
Qu'est-ce qu'un masque de sous-réseau ?
Le masque de sous-réseau est utilisé pour indiquer si deux adresses IP appartiennent au même sous-réseau. C'est également une adresse binaire de 32 bits, dans laquelle chaque bit à 1 représente un bit de réseau, et chaque bit à 0 représente un bit d'hôte. Comme les adresses IP, il est également exprimé en notation décimale pointée. Si deux adresses IP donnent le même résultat lors de l'opération ET bit à bit avec le masque de sous-réseau, cela indique qu'elles appartiennent au même sous-réseau.
Lors du calcul des masques de sous-réseau, nous devons prêter attention aux adresses réservées dans les adresses IP, à savoir l'adresse « 0 » et l'adresse de diffusion. Elles désignent les adresses IP lorsque l'adresse d'hôte ou l'adresse réseau est entièrement composée de « 0 » ou de « 1 ». Elles représentent l'adresse du réseau local et l'adresse de diffusion, et ne peuvent généralement pas être incluses dans le calcul.
Calcul du masque de sous-réseau :
Pour une adresse IP qui n'a pas besoin d'être subdivisée en sous-réseaux, son masque de sous-réseau est très simple et peut être écrit selon sa définition : par exemple, si une adresse IP de classe B est 10.12.3.0 et n'a pas besoin d'être subdivisée en sous-réseaux, le masque de sous-réseau est 255.255.0.0. S'il s'agit d'une adresse de classe C, son masque de sous-réseau est 255.255.255.0. Les autres suivent le même schéma et ne seront pas décrits en détail. Ci-dessous, nous nous concentrerons sur une adresse IP où les bits d'hôte de poids fort doivent être utilisés comme numéro de réseau de sous-réseau subdivisé, et les bits restants sont le numéro d'hôte de chaque sous-réseau. Dans ce cas, comment calculer le masque de sous-réseau de chaque sous-réseau ?
Voici un résumé des questions d'entretien courantes sur les masques de sous-réseau et la division de réseau :
1) Calcul à l'aide du nombre de sous-réseaux
Avant de calculer le masque de sous-réseau, vous devez d'abord déterminer le nombre de sous-réseaux à diviser et le nombre d'hôtes requis dans chaque sous-réseau.
(1) Convertir le nombre de sous-réseaux en représentation binaire ;
Par exemple, pour diviser l'adresse IP de classe B 168.195.0.0 en 27 sous-réseaux : 27 = 11011 ;
(2) Obtenir le nombre de bits de ce nombre binaire, noté N ;
Ce nombre binaire est composé de cinq bits, donc N = 5.
(3) Obtenir le masque de sous-réseau classful de cette adresse IP, puis mettre à 1 les N premiers bits de la partie de l'adresse d'hôte. Cela donne le masque de sous-réseau permettant de diviser cette adresse IP en sous-réseaux.
Mettre à 1 les 5 premiers bits de l'adresse d'hôte du masque de sous-réseau de l'adresse de classe B 255.255.0.0, ce qui donne 255.255.248.0.
2) Calcul à l'aide du nombre d'hôtes
Par exemple, pour diviser l'adresse IP de classe B 168.195.0.0 en plusieurs sous-réseaux, chacun avec 700 hôtes :
(1) Convertir le nombre d'hôtes en représentation binaire ;
700=1010111100
(2) Si le nombre d'hôtes est inférieur ou égal à 254 (remarque : exclure les deux adresses IP réservées), obtenir le nombre de bits de la représentation binaire, noté N ; ici N est certainement < 8. S'il est supérieur à 254, alors N > 8, ce qui signifie que l'adresse d'hôte occupera plus de 8 bits ;
Ce nombre binaire est de dix bits, donc N = 10 ;
(3) Utiliser 255.255.255.255 pour mettre à 1 tous les bits d'adresse d'hôte de cette classe d'adresses IP, puis mettre les N bits à 0 de la fin vers le début. Cela donne la valeur du masque de sous-réseau.
Mettre à 1 tous les bits d'adresse d'hôte du masque de sous-réseau de l'adresse de classe B 255.255.0.0, obtenant 255.255.255.255 ; puis mettre les 10 derniers bits à 0 de la fin vers le début, soit : 11111111.11111111.11111100.00000000, c'est-à-dire 255.255.252.0. Il s'agit du masque de sous-réseau de l'adresse IP de classe B 168.195.0.0 destinée à être divisée en sous-réseaux avec 700 hôtes.
3) Il existe un autre type de question qui vous demande de planifier les adresses de sous-réseau en fonction du nombre d'hôtes dans chaque réseau, etde calculer le masque de sous-réseau. Cela peut également être calculé selon les principes ci-dessus.
Par exemple, si un sous-réseau a 10 hôtes, alors les adresses IP requises pour ce sous-réseau sont :
10+1+1+1=13
Remarque : le premier 1 ajouté fait référence à l'adresse de passerelle requise lorsque ce réseau est connecté, et les deux 1 suivants font référence à l'adresse réseau et à l'adresse de diffusion.
Parce que 13 est inférieur à 16 (16 est égal à 2 puissance 4), les bits d'hôte sont 4 bits. Et 256 - 16 = 240, donc le masque de sous-réseau est 255.255.255.240.
Si un sous-réseau a 14 hôtes, une erreur courante que beaucoup de gens commettent est d'allouer encore un sous-réseau avec un espace d'adressage de 16, en oubliant d'allouer une adresse pour la passerelle. C'est faux, car 14 + 1 + 1 + 1 = 17, et 17 est supérieur à 16. Par conséquent, nous ne pouvons allouer qu'un sous-réseau avec un espace d'adressage de 32 (32 est égal à 2 puissance 5). Dans ce cas, le masque de sous-réseau est : 255.255.255.224.
5. ARP/RARP
Le protocole de résolution d'adresses, à savoir ARP (Address Resolution Protocol), est un protocole TCP/IP qui obtient une adresse physique en fonction d'une adresse IP.Lorsqu'un hôte envoie des informations, il diffuse une requête ARP contenant l'adresse IP cible à tous les hôtes du réseau et reçoit des messages de retour pour déterminer l'adresse physique de la cible. Après avoir reçu le message de retour, il stocke l'adresse IP et l'adresse physique dans le cache ARP local pendant une certaine période, et interroge directement le cache ARP la prochaine fois afin d'économiser des ressources. Le protocole de résolution d'adresses est basé sur la confiance mutuelle entre les hôtes du réseau. Les hôtes du réseau peuvent envoyer de manière autonome des messages de réponse ARP. Lorsque d'autres hôtes reçoivent des messages de réponse, ils les enregistrent dans leur cache ARP local sans vérifier l'authenticité des messages. Par conséquent, un attaquant peut envoyer un paquet de réponse ARP falsifié à un certain hôte, ce qui fait que les informations qu'il envoie n'atteignent pas l'hôte prévu ou atteignent le mauvais hôte, constituant ainsi une usurpation ARP.La commande ARP peut être utilisée pour interroger la correspondance entre les adresses IP et les adresses MAC dans le cache ARP local, ajouter ou supprimer des correspondances statiques, etc.
Exemple de processus de fonctionnement d'ARP :
L'adresse IP de l'hôte A est 192.168.1.1, et son adresse MAC est 0A-11-22-33-44-01;
L'adresse IP de l'hôte B est 192.168.1.2, et son adresse MAC est 0A-11-22-33-44-02;
Lorsque l'hôte A veut communiquer avec l'hôte B, le protocole de résolution d'adresses peut résoudre l'adresse IP de l'hôte B (192.168.1.2) en l'adresse MAC de l'hôte B. Le processus est le suivant :
- (1) D'après la table de routage de l'hôte A, IP détermine que l'adresse IP de transfert utilisée pour accéder à l'hôte B est 192.168.1.2. Ensuite, l'hôte A vérifie dans son cache ARP local s'il existe une adresse MAC correspondante de l'hôte B.
- (2) Si l'hôte A ne trouve pas de mappage dans le cache ARP, il demandera l'adresse matérielle de 192.168.1.2, en diffusant ainsi une trame de requête ARP à tous les hôtes du réseau local. L'adresse IP et l'adresse MAC de l'hôte source A sont toutes deux incluses dans la requête ARP. Chaque hôte du réseau local reçoit la requête ARP et vérifie si elle correspond à sa propre adresse IP. Si un hôte constate que l'adresse IP demandée ne correspond pas à la sienne, il rejette la requête ARP.
- (3) L'hôte B détermine que l'adresse IP de la requête ARP correspond à sa propre adresse IP, et ajoute la correspondance entre l'adresse IP et l'adresse MAC de l'hôte A à son cache ARP local.
- (4) L'hôte B renvoie directement à l'hôte A un message de réponse ARP contenant son adresse MAC.
- (5) Lorsque l'hôte A reçoit le message de réponse ARP de l'hôte B, il met à jour le cache ARP avec la correspondance entre l'adresse IP et l'adresse MAC de l'hôte B. Le cache local a une durée de vie ; après l'expiration de la durée de vie, le processus ci-dessus est répété. Une fois l'adresse MAC de l'hôte B déterminée, l'hôte A peut envoyer une communication IP à l'hôte B.
Le protocole de résolution d'adresses inverse, à savoir RARP, a une fonction opposée à celle d'ARP. Il convertit l'adresse physique d'un hôte sur le réseau local en une adresse IP.
Par exemple, si un hôte du LAN ne connaît que son adresse physique mais pas son adresse IP, il peut envoyer une requête de diffusion via le protocole RARP pour demander sa propre adresse IP, puis un serveur RARP est chargé d'y répondre.
Déroulement du protocole RARP :
- (1) Envoyer une diffusion RARP locale à l'hôte. Dans ce paquet de diffusion, déclarer sa propre adresse MAC et demander à tout serveur RARP qui reçoit cette requête d'attribuer une adresse IP ;
- (2) Après réception de la requête, le serveur RARP du segment de réseau local vérifie sa liste RARP pour trouver l'adresse IP correspondant à l'adresse MAC ;
- (3) S'il existe, le serveur RARP envoie un paquet de réponse à l'hôte source et fournit cette adresse IP à l'hôte pair pour qu'il l'utilise ;
- (4) S'il n'existe pas, le serveur RARP ne répond pas à cette requête ;
6. Routage
Les protocoles de routage courants incluent : le protocole RIP, le protocole OSPF.
RIPProtocole: La couche sous-jacente est l'algorithme de Bellman-Ford. Sa métrique de routage est le nombre de sauts, et le nombre de sauts maximal est de 15. S'il est supérieur à 15 sauts, il rejettera le paquet de données.
OSPFProtocole: Open Shortest Path First (OSPF). La couche sous-jacente est l'algorithme de Dijkstra. Il s'agit d'un protocole de routage à état de liens. Ses métriques de routage sont la bande passante et le délai.
7. Protocole TCP/IP
Le protocole TCP/IP est le protocole le plus élémentaire d'Internet et la base du réseau interconnecté international. Il se compose du protocole IP au niveau réseau et du protocole TCP au niveau transport. En termes simples : TCP est chargé de détecter les problèmes de transmission. Dès qu'un problème survient, il envoie un signal demandant une retransmission jusqu'à ce que toutes les données soient transmises en toute sécurité et correctement à destination. IP attribue une adresse à chaque appareil en réseau sur Internet.
La couche IP reçoit les paquets de données de la couche inférieure (couche d'interface réseau, comme le pilote de périphérique Ethernet) et les envoie à la couche supérieure - la couche TCP ou UDP ; inversement, la couche IP transmet également les paquets de données reçus de la couche TCP ou UDP à la couche inférieure. Les datagrammes IP ne sont pas fiables, car IP ne fait rien pour confirmer si les paquets de données sont envoyés dans l'ordre ou endommagés. Les datagrammes IP contiennent l'adresse de l'hôte qui les a envoyés (adresse source) et l'adresse de l'hôte qui les reçoit (adresse de destination).
TCP est un protocole de communication orienté connexion. Une connexion est établie par une poignée de main en trois étapes, et la connexion doit être interrompue lorsque la communication est terminée. Comme TCP est orienté connexion, il ne peut être utilisé que pour une communication de bout en bout. TCP fournit un service de flux de données fiable et utilise la technique de "positive acknowledgment with retransmission" (accusé de réception positif avec retransmission) pour assurer la fiabilité de la transmission. TCP utilise également une méthode appelée "sliding window" (fenêtre glissante) pour le contrôle de flux. La fenêtre dite représente en fait la capacité de réception, utilisée pour limiter la vitesse d'envoi de l'émetteur.
Format d'en-tête de segment TCP :

Poignée de main en trois étapes et fermeture en quatre étapes du protocole TCP :
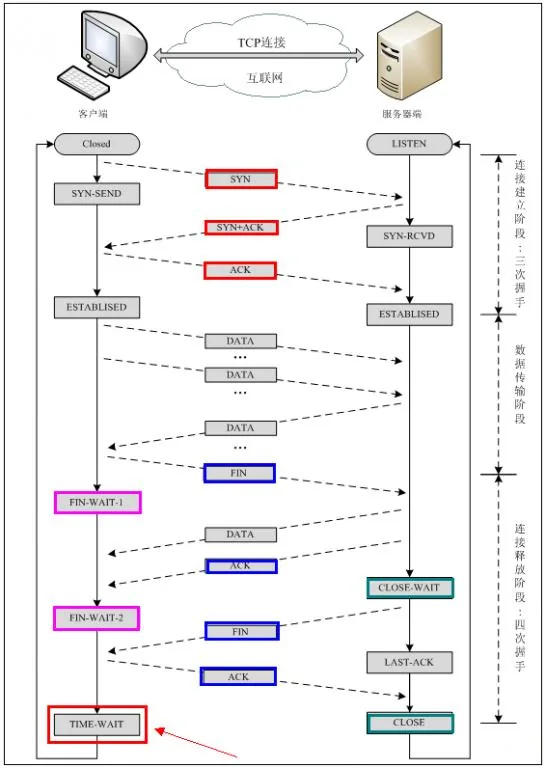
Remarque : seq: numéro de séquence "sequence" ;ack: numéro d'acquittement "acknowledge" ;SYN: indicateur de demande de synchronisation "synchronize" ;; ACK: "acknowledge" indicateur d'acquittement";FIN: "Finally" indicateur de terminaison.
Processus d'établissement d'une connexion TCP :Tout d'abord, le Client envoie un segment de demande de connexion. Après avoir reçu la connexion, le Serveur répond avec un segment ACK et alloue des ressources pour cette connexion. Après avoir reçu le segment ACK, le Client envoie également un segment ACK au Serveur et alloue des ressources. Ainsi, la connexion TCP est établie.
Processus de terminaison d'une connexion TCP :Supposons que le Client initie une demande de terminaison de connexion, c'est-à-dire envoie un segment FIN. Après que le Serveur a reçu le segment FIN, cela signifie « je (Client) n'ai plus de données à t'envoyer », mais si tu as encore des données qui n'ont pas été envoyées, tu n'as pas besoin de te précipiter pour fermer le Socket, et tu peux continuer à envoyer des données. Donc tu envoies d'abord ACK, « dis au Client, j'ai reçu ta demande, mais je ne suis pas encore prêt, veuillez continuer à attendre mon message. » À ce moment, le Client entre dans l'état FIN_WAIT et continue à attendre le segment FIN du Serveur. Lorsque le Serveur détermine que les données ont été complètement envoyées, il envoie un segment FIN au Client, « disant au Client, OK, j'ai fini d'envoyer les données ici, et je suis prêt à fermer la connexion. » Après avoir reçu le segment FIN, le Client « sait qu'il peut fermer la connexion, mais il ne fait toujours pas confiance au réseau, craignant que le Serveur ne sache pas qu'il doit fermer, donc après avoir envoyé ACK, il entre dans l'état TIME_WAIT. Si le Serveur ne reçoit pas l'ACK, il peut le retransmettre. » Après que le Serveur reçoit l'ACK, il « sait qu'il peut se déconnecter. » Après que le Client a attendu 2MSL et ne reçoit toujours pas de réponse, cela prouve que le Serveur s'est fermé normalement. Bon, le Client peut aussi fermer la connexion. Ok, la connexion TCP est fermée de cette façon !
Pourquoi une poignée de main en trois étapes ?
Dans le cas de seulement deux « poignées de main », supposons que le Client veuille établir une connexion avec le Serveur, mais comme le datagramme de demande de connexion est perdu en route, le Client doit le renvoyer. À ce moment-là, le Serveur ne reçoit qu'une seule demande de connexion, il peut donc établir la connexion normalement. Cependant, parfois le Client renvoie la demande non pas parce que le datagramme est perdu, mais parce que les données peuvent être bloquées à un certain nœud lors de la transmission en raison d'une forte concurrence réseau. Dans ce cas, le Serveur recevra successivement 2 demandes et continuera d'attendre que les deux demandes du Client lui envoient des données... Le problème est là : le Client n'a en réalité fait qu'une seule demande, mais le Serveur a 2 réponses. Dans des cas extrêmes, le Client peut renvoyer plusieurs fois les données de demande, ce qui amène finalement le Serveur à établir N réponses multiples en attente, causant ainsi un énorme gaspillage de ressources ! Par conséquent, la « poignée de main en trois temps » est très nécessaire !
Pourquoi une fermeture en quatre temps ?
Imaginez, si vous êtes maintenant le client et que vous voulez déconnecter toutes les connexions avec le Serveur, que feriez-vous ? D'abord, vous arrêtez d'envoyer des données au Serveur et attendez la réponse du Serveur. Mais l'affaire n'est pas terminée. Bien que vous n'envoyiez plus de données au Serveur, parce que vous avez déjà établi auparavant une connexion d'égal à égal, il a maintenant aussi l'initiative de vous envoyer des données ; le Serveur doit donc aussi arrêter d'envoyer activement des données vers vous et attendre votre confirmation. En fait, pour le dire simplement, cela garantit l'exécution complète d'un contrat entre les deux parties !
Protocoles utilisant TCP : FTP (File Transfer Protocol), Telnet (protocole de connexion à distance), SMTP (Simple Mail Transfer Protocol), POP3 (contrairement à SMTP, utilisé pour recevoir le courrier), protocole HTTP, etc.
8. Protocole UDP
UDP (User Datagram Protocol) est un protocole de communication sans connexion. Les données UDP incluent les informations de numéro de port de destination et de numéro de port source. Comme la communication ne nécessite pas de connexion, une transmission en diffusion peut être réalisée.
La communication UDP ne nécessite pas de confirmation du récepteur. Il s'agit d'une transmission non fiable, et des pertes de paquets peuvent se produire. Dans les applications pratiques, les programmeurs doivent le vérifier par programmation.
UDP et TCP se trouvent à la même couche, mais UDP ne se soucie pas de l'ordre, des erreurs ou de la retransmission des paquets de données. Par conséquent, UDP n'est pas utilisé pour les services orientés connexion utilisant des circuits virtuels. UDP est principalement utilisé pour les services orientés requête-réponse, tels que NFS. Comparés à FTP ou Telnet, ces services doivent échanger une quantité d'informations plus petite.
Chaque message UDP est divisé en deux parties : l'en-tête UDP et la zone de données UDP. L'en-tête est constitué de quatre champs de 16 bits (2 octets), qui décrivent respectivement le port source, le port de destination, la longueur du message et la somme de contrôle du message. L'en-tête UDP est constitué de 4 domaines, occupant chacun 2 octets, comme suit :
- (1) Numéro de port source ;
- (2) Numéro de port de destination ;
- (3) Longueur du datagramme ;
- (4) Somme de contrôle.
Les protocoles utilisant UDP incluent : TFTP (Trivial File Transfer Protocol), SNMP (Simple Network Management Protocol), DNS (protocole de résolution de noms de domaine), NFS, BOOTP.
TCP et UDP La différence entre TCP et UDP :TCP est un service de flux d'octets fiable et orienté connexion ; UDP est un service de datagrammes non fiable et sans connexion.
9. Protocole DNS
DNS est l'abréviation de Domain Name System, qui est utilisé pour nommer les ordinateurs et les services réseau organisés en une hiérarchie de domaines.On peut simplement le comprendre comme la conversion d'une URL en adresse IP.Un nom de domaine est composé d'une chaîne de mots ou d'abréviations séparés par des points. Chaque nom de domaine correspond à une adresse IP unique. Sur Internet, il existe une correspondance un à un entre les noms de domaine et les adresses IP. DNS est le serveur qui effectue la résolution de noms de domaine. Le nommage DNS est utilisé dans les réseaux TCP/IP tels qu'Internet pour trouver des ordinateurs et des services par des noms conviviaux.
10. Protocole NAT
NAT (Network Address Translation) est une technologie d'accès aux WAN. C'est une technologie de conversion qui traduit des adresses privées (réservées) en adresses IP légales. Elle est largement utilisée dans divers types de méthodes d'accès à Internet et divers types de réseaux. La raison est simple : NAT résout non seulement parfaitement le problème de l'insuffisance des adresses IP, mais évite aussi efficacement les attaques provenant de l'extérieur du réseau, en cachant et en protégeant les ordinateurs à l'intérieur du réseau.
11. Protocole DHCP
DHCP (Dynamic Host Configuration Protocol) est un protocole réseau pour les réseaux locaux. Il fonctionne à l'aide du protocole UDP et a deux objectifs principaux : attribuer automatiquement des adresses IP aux réseaux internes ou aux fournisseurs de services réseau, et servir de moyen permettant aux utilisateurs ou aux administrateurs de réseau interne de gérer de manière centralisée tous les ordinateurs.
12. Protocole HTTP
HTTP (HyperText Transfer Protocol) est le protocole réseau le plus utilisé sur Internet. Tous les fichiers WWW doivent se conformer à cette norme. HTTP Quelles requêtes le protocole comprend-il ?
GET : requête de lecture des informations identifiées par l'URL.
POST : ajoute des informations au serveur (comme des commentaires).
PUT : stocke un document à l'URL donnée.
DELETE : supprime la ressource identifiée par l'URL donnée.
HTTP Parmi eux, POST et GET la différence
- 1) GET sert à récupérer des données depuis le serveur, tandis que POST sert à envoyer des données au serveur.
- 2) GET ajoute la file de données des paramètres à l'URL pointée par l'attribut Action du formulaire soumis, avec des valeurs correspondant une à une à chaque champ du formulaire, et celle-ci peut être vue dans l'URL.
- 3) GET transmet une petite quantité de données, pas plus de 2KB ; POST transmet une quantité de données plus importante, généralement considérée comme illimitée par défaut.
- 4) Selon la spécification HTTP, GET est utilisé pour la récupération d'informations et doit être sûr et idempotent.
- I. Ce que l'on appellesûrsignifie que l'opération est utilisée pour obtenir des informations plutôt que pour les modifier. En d'autres termes, les requêtes GET ne devraient généralement pas produire d'effets secondaires. C'est-à-dire qu'elles ne font que récupérer des informations sur une ressource, comme une requête de base de données, et ne modifient ni n'ajoutent de données, ni n'affectent l'état de la ressource.
- II. Idempotentsignifie que plusieurs requêtes vers la même URL doivent renvoyer le même résultat.
13. Un exemple
Saisissez dans le navigateurhttp://www.baidu.com/tout le processus exécuté ensuite.
Supposons maintenant que nous saisissions http://www.baidu.com dans le navigateur client, et que baidu.com soit le serveur à accéder. Voici une analyse détaillée de la série d'opérations de protocole effectuées par le client pour accéder au serveur :
- 1) Le navigateur client résout l'adresse IP de www.baidu.com en 220.181.27.48 via DNS, et utilise cette adresse IP pour trouver le chemin du client au serveur. Le navigateur client initie une session HTTP vers 220.161.27.48, puis encapsule le paquet de données via TCP et le transmet à la couche réseau.
- 2) À la couche transport du client, la requête de session HTTP est divisée en segments, et les ports source et de destination sont ajoutés. Par exemple, le serveur utilise le port 80 pour écouter les requêtes des clients, tandis que le client sélectionne aléatoirement un port tel que 5000 pour échanger avec le serveur, et le serveur renvoie la requête correspondante au port 5000 du client. Ensuite, l'adresse IP de la couche IP est utilisée pour trouver la destination.
- 3) La couche réseau du client n'a pas besoin de se soucier de la couche application ni de la couche transport. Sa tâche principale est de déterminer comment atteindre le serveur en consultant la table de routage. Elle peut traverser plusieurs routeurs pendant ce processus. Ce sont toutes des tâches effectuées par les routeurs et elles ne seront pas décrites en détail. Elle décide simplement quel chemin emprunter pour atteindre le serveur en consultant la table de routage.
- 4) Au niveau de la couche de liaison du client, le paquet est envoyé au routeur via la couche de liaison. L'adresse MAC correspondant à l'adresse IP donnée est trouvée via le protocole de voisinage, puis une requête ARP est envoyée pour trouver l'adresse de destination. Une fois une réponse reçue, le paquet de données IP échangé via la requête/réponse ARP peut maintenant être transmis, puis le paquet de données IP est envoyé à l'adresse du serveur.
Lien original : http://www.cnblogs.com/maybe2030/p/4781555.html