In regulären Ausdrücken ist eine Nullbreiten-Assertion ein spezielles Konstrukt, das beim Abgleich keine Zeichen verbraucht; sie führt nur bedingte Prüfungen an der Übereinstimmungsposition durch. Dies ist für einige komplexe Musterabgleiche sehr nützlich, da es ermöglicht, Bedingungen vor oder nach der Übereinstimmungsposition hinzuzufügen und dadurch den Abgleich präziser zu steuern.
Es gibt 4 Formen von Lookahead- und Lookbehind-Assertions in regulären Ausdrücken:
- (?=pattern)Positive Lookahead-Assertion mit Nullbreite
- (?!pattern)Negative Lookahead-Assertion mit Nullbreite
- (?<=pattern)Positive Lookbehind-Assertion mit Nullbreite
- (?<!pattern)Negative Lookbehind-Assertion mit Nullbreite
Hier,patternist ein regulärer Ausdruck.
So wie^den Anfang darstellt,$das Ende darstellt,\bund eine Wortgrenze darstellt, haben Lookahead- und Lookbehind-Assertions einen ähnlichen Effekt: Sie stimmen nur mit bestimmten Positionen überein und belegen während des Matching-Prozesses keine Zeichen, daher werden sie genannt„Nullbreite“. Die sogenannte Position bezieht sich auf die Stelle links vom ersten Zeichen, rechts vom letzten Zeichen und in der Mitte zwischen benachbarten Zeichen in einer Zeichenkette (pro Zeile), wobei die Textrichtung von links nach rechts verläuft.
Konzepterklärung:
- Nullbreite: Sie stimmt nur mit Positionen überein. Nullbreite bedeutet, dass die Assertion während des Matchings keine Zeichen „konsumiert“; sie führt lediglich bedingte Prüfungen an der Position durch und bezieht Zeichen vor oder nach der Matchposition nicht in das Match-Ergebnis ein.
- Lookahead: Gibt an, dass die Assertion vor der Matchposition auftritt.
- Lookbehind: Gibt an, dass die Assertion nach der Matchposition auftritt.
- Positiv: Entspricht dem Ausdruck in den Klammern, das heißt, die von der Assertion geprüfte Bedingung ist bejahend; der Match ist nur erfolgreich, wenn die Bedingung zutrifft.
- Negativ: Entspricht nicht dem Ausdruck in den Klammern, das heißt, die von der Assertion geprüfte Bedingung ist verneinend; der Match ist nur erfolgreich, wenn die Bedingung nicht zutrifft.
Im Folgenden werden Beispiele gegeben, um die Bedeutung dieser 4 Assertions zu veranschaulichen.
(?=pattern) Positive Lookahead-Assertion
Stellt eine Position in der Zeichenkette dar; die Zeichenfolge unmittelbar nach dieser Position kann mit pattern übereinstimmen.
Zum Beispiel für"a regular expression"diesen String, wenn du das re in regular, aber nicht das re in expression matchen möchtest, kannst dure(?=gular)verwenden; dieser Ausdruck beschränkt die Position rechts von re; nach dieser Position kommt gular, aber er verbraucht keine Zeichen wie gular.
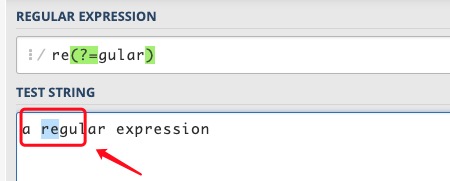
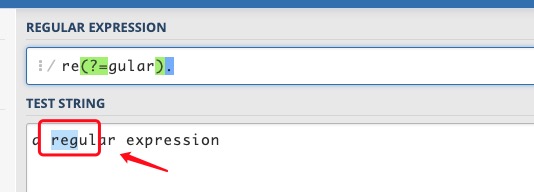
(?!pattern) Negative Lookahead-Assertion
Repräsentiert eine Position in der Zeichenkette; die Zeichenfolge unmittelbar nach dieser Position darf nicht mit pattern übereinstimmen.
Zum Beispiel für"regex represents regular expression"diesen String, wenn du das re matchen möchtest, das nicht in regex und regular vorkommt, kannst dure(?!g)verwenden; dieser Ausdruck beschränktredie Position nach rechts; nach dieser Position steht nicht das Zeicheng。
Der Unterschied zwischen negativ und positiv besteht darin, ob die Zeichen nach dieser Position mit dem Ausdruck in Klammern übereinstimmen können.
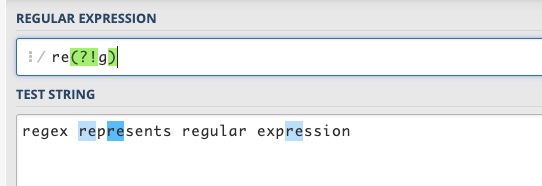
(?<=pattern) Positive Lookbehind-Assertion
Repräsentiert eine Position in der Zeichenkette; die Zeichenfolge unmittelbar vor dieser Position kann mit pattern übereinstimmen.
Zum Beispiel fürregex represents regular expressiondiesen String, es gibt 4 Wörter; wenn du das re im Inneren von Wörtern, aber nicht das re am Anfang von Wörtern matchen möchtest, kannst du(?<=\w)reverwenden; für das re im Inneren eines Wortes muss vor re ein Wortzeichen stehen.
Sie wird Lookbehind-Assertion genannt, weil die Regex-Engine, wenn sie einen String mit einem Ausdruck abgleicht, die Zeichen im String von vorne nach hinten einzeln durchläuft und prüft, ob sie mit dem Ausdruck übereinstimmen. Wenn sie diese Assertion im Ausdruck antrifft, muss die Engine bereits gescannte Zeichen in Richtung des Stringanfangs prüfen, was relativ zur Scanrichtung rückwärts ist.
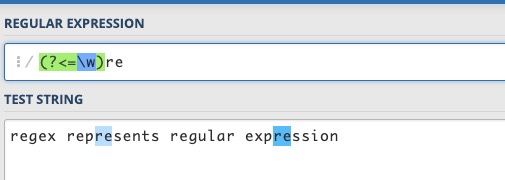
(?<!pattern) Negative Lookbehind-Assertion
Repräsentiert eine Position in der Zeichenkette; die Zeichenfolge unmittelbar vor dieser Position darf nicht mit pattern übereinstimmen.
Zum Beispiel für"regex represents regular expression"diese Zeichenkette, wenn du das re am Anfang von Wörtern abgleichen möchtest, kannst du(?<!\w)reverwenden. Das re am Anfang eines Wortes,re, in diesem Beispiel, bezieht sich auf das re, das nicht innerhalb eines Wortes steht,re, das heißt,redas Zeichen davor ist kein Wortzeichen. Natürlich kannst du auch\brezum Abgleichen.
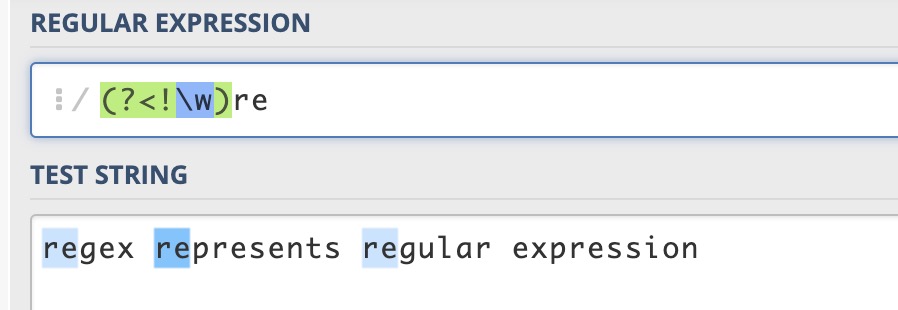
Um diese 4 Assertions zu verstehen, kannst du sie aus zwei Blickwinkeln betrachten:
-
1. Zu Lookahead und Lookbehind:Wenn die Regex-Engine einen Abgleich zwischen einer Zeichenkette und einem Ausdruck durchführt, durchsucht sie kontinuierlich die Zeichen in der Zeichenkette von Anfang bis Ende (von vorne nach hinten). Stell dir einen Scan-Zeiger vor, der auf eine Zeichengrenze zeigt und sich mit dem Abgleichprozess mitbewegt. Bei einer Lookahead-Assertion versucht die Engine, wenn sich der Scan-Zeiger an einer bestimmten Position befindet, Zeichen abzugleichen, die der Zeiger noch nicht gescannt hat, wobei sie diese Zeichen vor dem Zeiger erreicht; daher der Name Lookahead. Bei einer Lookbehind-Assertion versucht die Engine, Zeichen abzugleichen, die der Zeiger bereits gescannt hat, wobei sie diese Zeichen hinter dem Zeiger erreicht; daher der Name Lookbehind.
-
2. Zu positiv und negativ:Positiv bedeutet, dass der Ausdruck in Klammern übereinstimmen muss; negativ bedeutet, dass er nicht übereinstimmen darf.
Eselsbrücken für diese 4 Assertion-Formen:
-
1. Lookahead und Lookbehind:Die Lookbehind-Assertion(?<=pattern)、(?<!pattern)enthält ein Kleiner-als-Zeichen, das zugleich ein Pfeil ist. Für die Textrichtung von links nach rechts zeigt dieser Pfeil nach hinten, was ebenfalls unserer Konvention entspricht. Entfernt man das Kleiner-als-Zeichen, erhält man die Lookahead-Assertion.
-
2. Positiv und negativ:Ungleich(!=), logisches NICHT(!)werden beide durch!das !-Zeichen dargestellt, daher zeigt die Form mit!dem !-Zeichen keine Übereinstimmung an, negativ; ersetze!das !-Zeichen mit=dem =-Zeichen, das eine Übereinstimmung anzeigt, positiv.
Wir verwenden häufig reguläre Ausdrücke, um zu prüfen, ob eine Zeichenkette eine Teilzeichenkette enthält. Es ist auch einfach auszudrücken, dass eine Zeichenkette ein bestimmtes Zeichen oder bestimmte Zeichen nicht enthält; verwenden Sie einfach[^...]die Form. Aber wie drückt man aus, dass eine Zeichenkette eine bestimmte Teilzeichenkette (aus einer Zeichenfolge bestehend) nicht enthält?
verwenden[^...]Diese Form wird nicht funktionieren. In diesem Fall müssen Sie (negative) Lookahead- oder Lookbehind-Assertions verwenden oder beide gleichzeitig verwenden.
Zum Beispiel, um festzustellen, ob ein Satzthisenthält, aberthat nicht enthält。
enthältthis, ist einfach zu handhaben; bei einem Satz, derthatnicht enthält, kann man davon ausgehen, dass das Zeichen vor jedem Zeichen im Satz nichtthat istoder das Zeichen nach jedem Zeichen nichtthatist. Die regulären Ausdrücke lauten wie folgt:
^((?<!that).)*this((?<!that).)*$
或
^(.(?!that))*this(.(?!that))*$
Fürthis is example testdiesen Satz können beide Ausdrücke erfolgreich übereinstimmen, währendthis and that is example testalle nicht übereinstimmen.
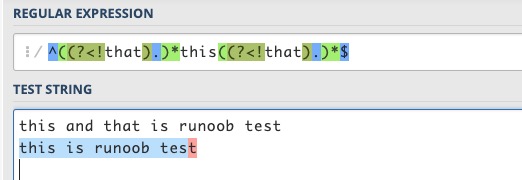
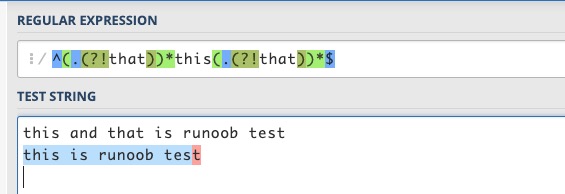
Im Allgemeinen können diese beiden Ausdrücke die Anforderungen im Wesentlichen erfüllen. Betrachten Sie Randfälle, wie wenn ein Satz mitthatbeginnt und mitthatendet, oder wennthatundthisverkettet sind, können die obigen Ausdrücke unzureichend sein.example thatthis is the caseoderthis is the case, not thatusw.
Solange Sie diese Assertions flexibel einsetzen, ist es einfach zu lösen:
^(.(?<!that))*this(.(?<!that))*$
^(.(?<!that))*this((?!that).)*$
^((?!that).)*this(.(?<!that))*$
^((?!that).)*this((?!that).)*$
Diese 4 regulären Ausdrücke wurden an den obigen Sätzen getestet, und die Ergebnisse erfüllen alle die Anforderungen.
Für die obigen 4 Assertions ist das Muster innerhalb der Klammern selbst ein regulärer Ausdruck. Es gibt jedoch Einschränkungen für die 2 Lookbehind-Assertions. In Perl und Python muss der Ausdruck eine feste Länge haben, das heißt, er darf nicht verwenden*、+、?Metazeichen wie(?<=abc)sind in Ordnung, aber(?<=a*bc)wird nicht unterstützt. Insbesondere wenn der Ausdruck durch | verbundene Zweige enthält, müssen alle Zweige dieselbe Länge haben. Der Grund, warum Ausdrücke variabler Länge nicht unterstützt werden, ist, dass die Engine nicht bestimmen kann, wie viele Schritte zurückverfolgt werden müssen, wenn eine Lookbehind-Assertion geprüft wird. Java unterstützt?、{m}、{n,m}Symbole wie, aber es unterstützt auch nicht*、+das Zeichen. JavaScript unterstützt Lookbehind-Assertions einfach nicht, aber allgemein gesprochen ist das kein großes Problem.
Lookahead- und Lookbehind-Assertions sind in gewissem Maße wie die Verwendung vonif-Anweisungen, um die Zeichen vor und nach der Übereinstimmung zu validieren.
Die folgende Liste zeigt die Verwendung von ?=, ?<=, ?!, ?<!=
exp1(?=exp2): Finde exp1 vor exp2.
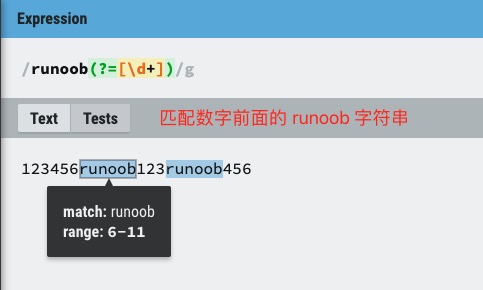
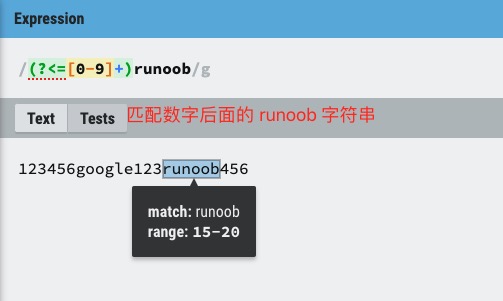
(?<=exp2)exp1: Finde exp1 nach exp2.
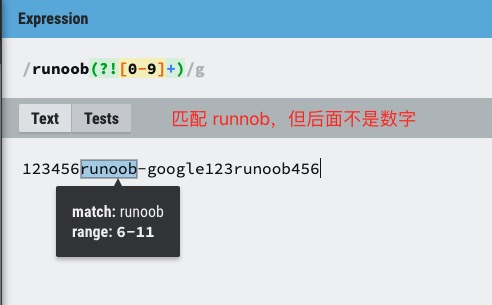
exp1(?!exp2): Finde exp1, auf das nicht exp2 folgt.
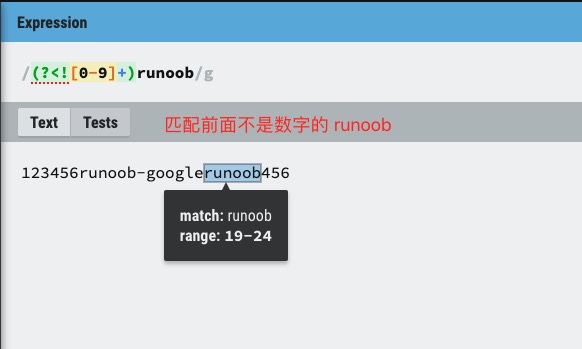
(?<!=exp2)exp1: Finde exp1, dem nicht exp2 vorausgeht.
Referenzlink: https://blog.51cto.com/cnn237111/749047