Примеры применения Sklearn
Набор данных Iris — один из самых классических вводных наборов данных в машинном обучении.
Набор данных Iris содержит три вида ириса (Setosa, Versicolor, Virginica) и 4 признака для каждого цветка: длина чашелистика, ширина чашелистика, длина лепестка и ширина лепестка.
Далее наша задача — предсказать вид ириса на основе этих признаков.
Пример в этой главе охватит такие этапы, как загрузка данных, визуализация, отбор признаков, предобработка данных, построение модели классификации, оценка модели и оптимизация.
1. Загрузка и визуализация данных
Загрузка данных
Сначала загрузим набор данных Iris. scikit-learn предоставляет интерфейс для прямой загрузки набора данных Iris.
Пример
import pandas as pd
# Загрузить набор данных Iris
data = load_iris()
# Преобразование в DataFrame для удобного просмотра
df = pd.DataFrame(data.data, columns=data.feature_names)
df['target'] = data.target
df['species'] = df['target'].apply(lambda x: data.target_names[x])
# Просмотреть первые несколько строк данных
print(df.head())
Вывод:
   sepal length (cm)  sepal width (cm)  petal length (cm)  petal width (cm)  target species
0                 5.1               3.5                1.4               0.2       0   setosa
1                 4.9               3.0                1.4               0.2       0   setosa
2                 4.7               3.2                1.3               0.2       0   setosa
3                 4.6               3.1                1.5               0.2       0   setosa
4                 5.0               3.6                1.4               0.2       0   setosa
На данный момент данные успешно загружены, и мы можем видеть признаки и соответствующие виды цветков для каждой записи.
Визуализация данных
Чтобы лучше понять данные, мы можем визуализировать связи между различными признаками. Для визуализации мы можем использовать библиотеки matplotlib и seaborn.
Пример
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt
# Загрузить набор данных Iris
data = load_iris()
# Преобразование в DataFrame для удобного просмотра
df = pd.DataFrame(data.data, columns=data.feature_names)
df['target'] = data.target
df['species'] = df['target'].apply(lambda x: data.target_names[x])
# Построить графики зависимостей между признаками
sns.pairplot(df, hue="species")
plt.show()
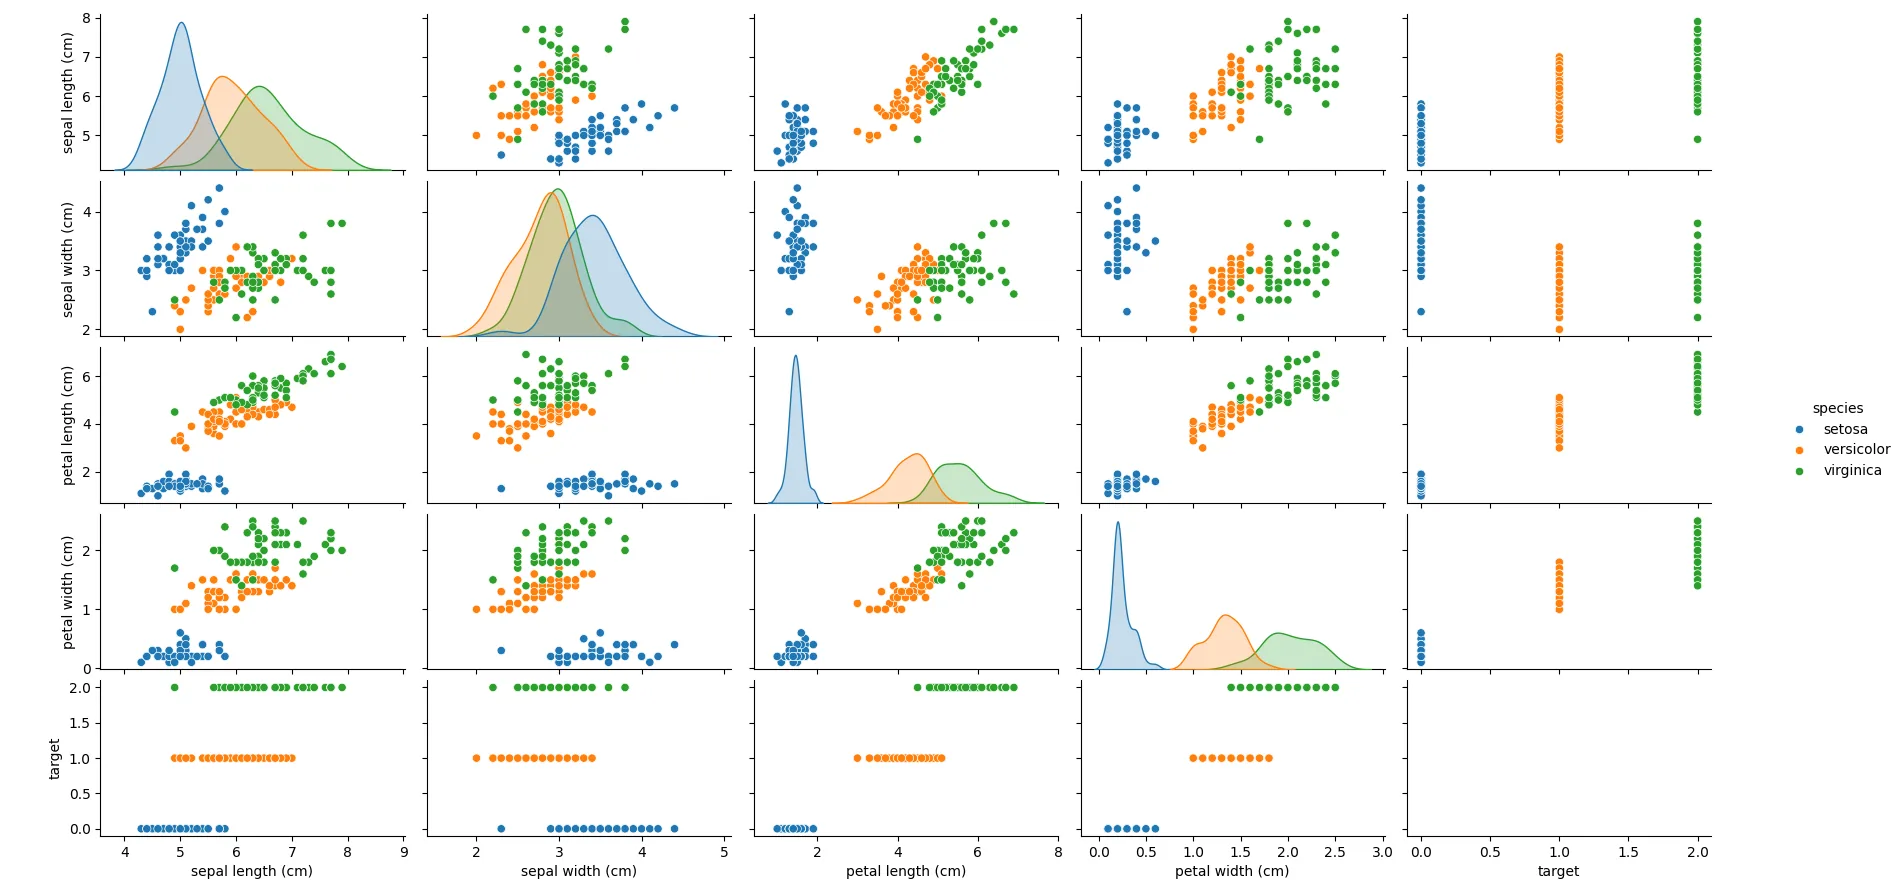
pairplot построит матрицу диаграмм рассеяния между признаками, используя разные цвета для идентификации разных видов ирисов. Это помогает нам понять распределение каждого признака и связи между ними.
Отображаемый график выглядит следующим образом:
Тепловая карта для визуализации корреляций между признаками
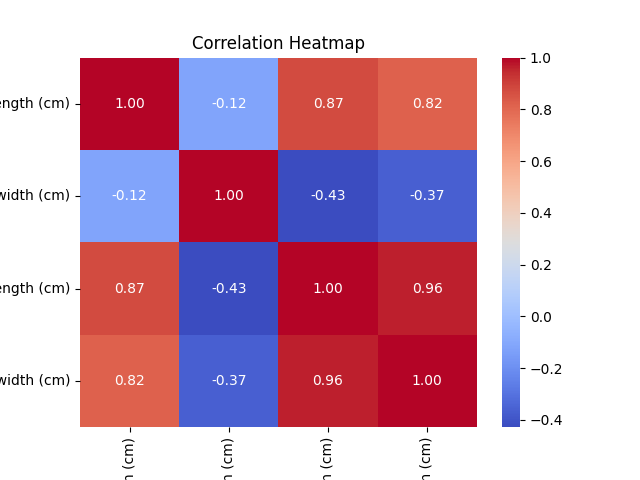
С помощью тепловой карты мы можем увидеть корреляции между признаками. Более сильные корреляции могут помочь нам сделать лучший выбор при моделировании.
Пример
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt
# Загрузить набор данных Iris
data = load_iris()
# Преобразование в DataFrame для удобного просмотра
df = pd.DataFrame(data.data, columns=data.feature_names)
df['target'] = data.target
df['species'] = df['target'].apply(lambda x: data.target_names[x])
# Построить графики зависимостей между признаками
correlation_matrix = df.drop(columns=['target', 'species']).corr()
sns.heatmap(correlation_matrix, annot=True, cmap="coolwarm", fmt=".2f")
plt.title("Correlation Heatmap")
plt.show()
Отображаемый график выглядит следующим образом:
2. Выбор признаков и предобработка данных
Предобработка данных
В машинном обучении предобработка данных — очень важный шаг.
Для набора данных Iris значения признаков уже числовые, поэтому большая предобработка не требуется. Однако мы можем стандартизировать данные, чтобы улучшить качество обучения модели.
Пример
# Извлечение признаков и меток
X = df.drop(columns=['target', 'species'])
y = df['target']
# Стандартизировать признаки
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)
Цель стандартизации — сделать так, чтобы каждый признак имел среднее 0 и дисперсию 1, что очень важно для некоторых моделей, основанных на расстоянии, таких как KNN и SVM.
Выбор признаков
Хотя признаки набора данных Iris относительно просты, в реальных задачах нам иногда нужно уменьшать размерность признаков с помощью отбора признаков, чтобы улучшить качество модели.
Мы можем использовать такие методы, как SelectKBest или рекурсивное исключение признаков (RFE).
Например, используйте SelectKBest, чтобы выбрать 2 признака, наиболее связанных с метками:
Пример
# Использовать критерий хи-квадрат для выбора 2 наиболее релевантных признаков
selector = SelectKBest(f_classif, k=2)
X_new = selector.fit_transform(X_scaled, y)
# Вывести выбранные признаки
selected_features = selector.get_support(indices=True)
print("Выбранные признаки:", X.columns[selected_features])
Это выберет 2 признака с наибольшей корреляцией с целевыми метками.
3. Построить модель классификации: используйте дерево решений или SVM для классификации
Использование классификатора дерева решений
Сначала мы попробуем использовать модель дерева решений для классификации.
Пример
from sklearn.tree import DecisionTreeClassifier
from sklearn.metrics import accuracy_score
# Разделить набор данных
X_train, X_test, y_train, y_test = train_test_split(X_scaled, y, test_size=0.2, random_state=42)
# Инициализировать классификатор дерева решений
model_dt = DecisionTreeClassifier(random_state=42)
# Обучаем модель
model_dt.fit(X_train, y_train)
# Прогнозирование
y_pred_dt = model_dt.predict(X_test)
# Оценка модели
accuracy_dt = accuracy_score(y_test, y_pred_dt)
print(f"Точность дерева решений: {accuracy_dt:.4f}")
Классификация с использованием метода опорных векторов (SVM)
Далее мы можем попробовать использовать метод опорных векторов (SVM) для классификации.
Пример
# Инициализировать классификатор SVM
model_svm = SVC(kernel='linear', random_state=42)
# Обучаем модель
model_svm.fit(X_train, y_train)
# Прогнозирование
y_pred_svm = model_svm.predict(X_test)
# Оценка модели
accuracy_svm = accuracy_score(y_test, y_pred_svm)
print(f"Точность SVM: {accuracy_svm:.4f}")
4. Оценка и оптимизация модели
Оценка модели
Помимо доли правильных ответов, можно также использовать другие метрики оценки, такие как матрица ошибок, точность, полнота и F1-мера.
Пример
# Матрица ошибок
cm = confusion_matrix(y_test, y_pred_dt)
print("Матрица ошибок (дерево решений):")
print(cm)
# Точность, полнота, F1-мера
report = classification_report(y_test, y_pred_dt)
print("Отчёт о классификации (дерево решений):")
print(report)
Настройка поиска по сетке
Чтобы оптимизировать модель, мы можем использовать поиск по сетке (GridSearchCV) для настройки гиперпараметров модели и поиска наилучшей комбинации параметров.
Пример
# Определяем сетку параметров для дерева решений
param_grid = {
'max_depth': [3, 5, 10, None],
'min_samples_split': [2, 5, 10],
'min_samples_leaf': [1, 2, 4]
}
# Инициализируем GridSearchCV
grid_search = GridSearchCV(estimator=DecisionTreeClassifier(random_state=42), param_grid=param_grid, cv=5)
# Обучаем поиск по сетке
grid_search.fit(X_train, y_train)
# Получаем лучшие параметры и лучшую модель
print("Лучшие параметры:", grid_search.best_params_)
best_model = grid_search.best_estimator_
# Прогнозирование и оценка
y_pred_optimized = best_model.predict(X_test)
accuracy_optimized = accuracy_score(y_test, y_pred_optimized)
print(f"Точность оптимизированного дерева решений: {accuracy_optimized:.4f}")
С помощью поиска по сетке мы можем найти параметры дерева решений, которые лучше всего соответствуют текущим данным и повышают точность предсказаний модели.
Кросс-валидация
Чтобы дополнительно оценить стабильность модели, мы можем использовать кросс-валидацию для оценки её производительности.
Пример
# Выполнить 5-кратную кросс-валидацию
cross_val_scores = cross_val_score(best_model, X_scaled, y, cv=5)
print(f"Оценки кросс-валидации: {cross_val_scores}")
print(f"Средняя точность кросс-валидации: {cross_val_scores.mean():.4f}")
Кросс-валидация помогает нам оценить производительность модели на разных подмножествах данных и избежать переобучения.
5. Полный код
Ниже приведён полный пример кода, охватывающий такие этапы, как загрузка набора данных Iris, предварительная обработка данных, отбор признаков, построение моделей классификации, оценка модели и оптимизация. Мы будем использовать классификаторы дерева решений и SVM, а также оптимизируем гиперпараметры модели с помощью поиска по сетке.Пример
import numpy as np
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split, GridSearchCV, cross_val_score
from sklearn.preprocessing import StandardScaler
from sklearn.tree import DecisionTreeClassifier
from sklearn.svm import SVC
from sklearn.metrics import accuracy_score, classification_report, confusion_matrix
# 1. Загрузка данных
# Загрузить набор данных Iris
data = load_iris()
# Преобразование в DataFrame для удобного просмотра
df = pd.DataFrame(data.data, columns=data.feature_names)
df['target'] = data.target
df['species'] = df['target'].apply(lambda x: data.target_names[x])
# Просмотреть первые несколько строк данных
print("Предварительный просмотр данных:")
print(df.head())
# 2. Визуализация данных
# Построить графики зависимостей между признаками
sns.pairplot(df, hue="species")
plt.show()
# Построить тепловую карту для просмотра корреляций между признаками
correlation_matrix = df.drop(columns=['target', 'species']).corr()
sns.heatmap(correlation_matrix, annot=True, cmap="coolwarm", fmt=".2f")
plt.title("Correlation Heatmap")
plt.show()
# 3. Отбор признаков и предварительная обработка данных
# Извлечение признаков и меток
X = df.drop(columns=['target', 'species'])
y = df['target']
# Стандартизация данных
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)
# 4. Построение моделей классификации
# Разделить набор данных
X_train, X_test, y_train, y_test = train_test_split(X_scaled, y, test_size=0.2, random_state=42)
# Использовать классификатор дерева решений
model_dt = DecisionTreeClassifier(random_state=42)
model_dt.fit(X_train, y_train)
# Прогнозирование
y_pred_dt = model_dt.predict(X_test)
# Вывести точность дерева решений
accuracy_dt = accuracy_score(y_test, y_pred_dt)
print(f"Точность дерева решений: {accuracy_dt:.4f}")
# Использовать классификатор опорных векторов (SVM)
model_svm = SVC(kernel='linear', random_state=42)
model_svm.fit(X_train, y_train)
# Прогнозирование
y_pred_svm = model_svm.predict(X_test)
# Вывести точность SVM
accuracy_svm = accuracy_score(y_test, y_pred_svm)
print(f"Точность SVM: {accuracy_svm:.4f}")
# 5. Оценка модели
# Оценка модели дерева решений
print("\nОтчёт о классификации дерева решений:")
print(classification_report(y_test, y_pred_dt))
print("\nМатрица ошибок дерева решений:")
print(confusion_matrix(y_test, y_pred_dt))
# Оценка модели SVM
print("\nОтчёт о классификации SVM:")
print(classification_report(y_test, y_pred_svm))
print("\nМатрица ошибок SVM:")
print(confusion_matrix(y_test, y_pred_svm))
# 6. Настройка поиска по сетке
# Определяем сетку параметров для дерева решений
param_grid = {
'max_depth': [3, 5, 10, None],
'min_samples_split': [2, 5, 10],
'min_samples_leaf': [1, 2, 4]
}
# Инициализируем GridSearchCV
grid_search = GridSearchCV(estimator=DecisionTreeClassifier(random_state=42), param_grid=param_grid, cv=5)
grid_search.fit(X_train, y_train)
# Получаем лучшие параметры и лучшую модель
print("\nЛучшие параметры из GridSearchCV (дерево решений):")
print(grid_search.best_params_)
# Использование лучшей модели для предсказания
best_model = grid_search.best_estimator_
y_pred_optimized = best_model.predict(X_test)
# Вывод точности оптимизированного дерева решений
accuracy_optimized = accuracy_score(y_test, y_pred_optimized)
print(f"Точность оптимизированного дерева решений: {accuracy_optimized:.4f}")
# 7. Кросс-валидация
# Выполнить 5-кратную кросс-валидацию
cross_val_scores = cross_val_score(best_model, X_scaled, y, cv=5)
print("\nОценки кросс-валидации (оптимизированное дерево решений):")
print(cross_val_scores)
print(f"Средняя точность кросс-валидации: {cross_val_scores.mean():.4f}")
Пояснение к коду:
Загрузка данных:
- Используйте
load_iris()загрузить набор данных Iris и преобразовать данные вDataFrameформат для просмотра и анализа.
- Используйте
Визуализация данных:
- Используйте
seabornизpairplotчтобы построить матрицу диаграмм рассеяния между признаками, и использоватьheatmapчтобы построить тепловую карту корреляций между признаками.
- Используйте
Отбор признаков и предобработка данных:
- Извлечь признаки (
X) и метки (y), и стандартизировать данные признаков так, чтобы каждый признак имел среднее 0 и дисперсию 1.
- Извлечь признаки (
Построение модели классификации:
- Используйте
DecisionTreeClassifierиSVCОбучите классификатор на основе дерева решений и классификатор на основе опорных векторов соответственно и оцените их точность на тестовом наборе.
- Используйте
Оценка модели:
- Используйте
classification_reportиconfusion_matrixВыведите подробные метрики оценки модели, включая точность, полноту, F1-меру и матрицу ошибок.
- Используйте
Настройка поиска по сетке:
- Используйте
GridSearchCVВыполните настройку гиперпараметров для модели дерева решений, найдите лучшую комбинацию гиперпараметров и выведите точность оптимизированной модели.
- Используйте
Кросс-валидация:
- Используйте
cross_val_scoreВыполните 5-кратную кросс-валидацию, чтобы оценить стабильность и производительность оптимизированной модели дерева решений.
- Используйте
Вывод следующий:
数据预览:
   sepal length (cm)  sepal width (cm)  petal length (cm)  petal width (cm)  target species
0                 5.1               3.5                1.4               0.2       0   setosa
1                 4.9               3.0                1.4               0.2       0   setosa
2                 4.7               3.2                1.3               0.2       0   setosa
3                 4.6               3.1                1.5               0.2       0   setosa
4                 5.0               3.6                1.4               0.2       0   setosa

Decision Tree Accuracy: 1.0000
SVM Accuracy: 1.0000

Decision Tree Classification Report:
              precision    recall  f1-score   support

           0       1.00      1.00      1.00         9
           1       1.00      1.00      1.00         8
           2       1.00      1.00      1.00         8

    accuracy                           1.00        25
   macro avg       1.00      1.00      1.00        25
weighted avg       1.00      1.00      1.00        25

Decision Tree Confusion Matrix:
[[9 0 0]
 [0 8 0]
 [0 0 8]]

SVM Classification Report:
              precision    recall  f1-score   support

           0       1.00      1.00      1.00         9
           1       1.00      1.00      1.00         8
           2       1.00      1.00      1.00         8

    accuracy                           1.00        25
   macro avg       1.00      1.00      1.00        25
weighted avg       1.00      1.00      1.00        25

SVM Confusion Matrix:
[[9 0 0]
 [0 8 0]
 [0 0 8]]

Best Parameters from GridSearchCV (Decision Tree):
{'max_depth': 5, 'min_samples_leaf': 1, 'min_samples_split': 2}

Optimized Decision Tree Accuracy: 1.0000

Cross-validation Scores (Optimized Decision Tree):
[1.         1.         1.         1.         1.        ]
Mean CV Accuracy: 1.0000
Другие расширения