Модели машинного обучения в Sklearn
Модели машинного обучения — это основные инструменты для автоматизированного анализа данных, распознавания образов и прогнозирования.
В зависимости от типа задачи модели машинного обучения обычно можно разделить на:
- Модели классификации:Предсказывают дискретные категории
- Модели регрессии:Предсказывают непрерывные значения
- Модели кластеризации:Автоматически группируют данные
В этой главе будут подробно представлены эти распространённые модели машинного обучения и объяснено, как их оценивать и оптимизировать.
1. Модели классификации
Классификация — одна из самых распространённых задач в машинном обучении, цель которой — отобразить входные данные в дискретные метки классов.
К распространённым моделям классификации относятся:
- Логистическая регрессия
- K-ближайших соседей (KNN)
- Машина опорных векторов (SVM)
- Дерево решений
- Случайный лес
Логистическая регрессия
Хотя в названии логистической регрессии есть "regression", по сути она являетсявероятностной моделью классификации, часто используемой для задач бинарной классификации.
Её основная идея такова:
- Сначала выполняется линейно взвешенная сумма
- Затем с помощью функции Sigmoid отобразить результат в диапазон от 0 до 1 как вероятность
Это можно выразить так:
Основная формула логистической регрессии:
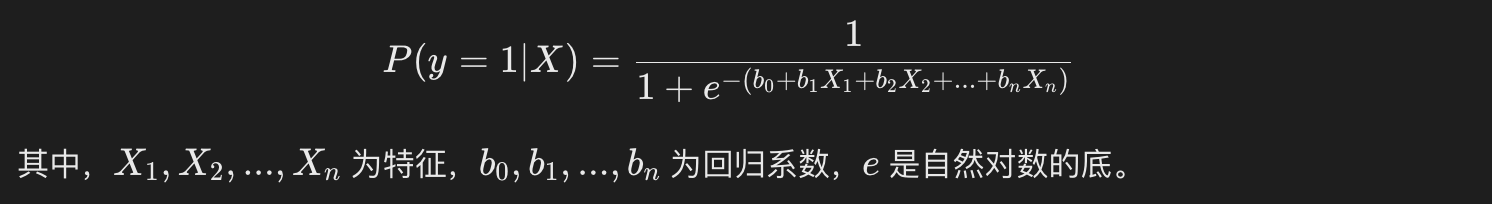
Реализация в scikit-learn:
Пример
from sklearn.model_selection import train_test_split
# Предположим, X — матрица признаков, y — метка
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
model = LogisticRegression()
model.fit(X_train, y_train)
# Прогнозирование
y_pred = model.predict(X_test)
K-ближайших соседей (KNN)
K-ближайших соседей (KNN) — это метод обучения на основе экземпляров. При прогнозировании он вычисляет расстояния между предсказываемым образцом и всеми образцами в обучающем наборе, выбирает K ближайших соседей и делает прогноз на основе меток этих соседей.
Основные параметры:
- K: Количество соседей для выбора.
- Метрика расстояния: Обычно используется евклидово расстояние; также можно использовать манхэттенское расстояние, расстояние Минковского и т. д.
Реализация в scikit-learn:
Пример
from sklearn.model_selection import train_test_split
# Предположим, X — матрица признаков, y — метка
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
model = KNeighborsClassifier(n_neighbors=3)
model.fit(X_train, y_train)
# Прогнозирование
y_pred = model.predict(X_test)
Машина опорных векторов (SVM)
Машина опорных векторов — это мощная модель классификации, особенно подходящая для многомерных данных.
Основная идея SVM — найти гиперплоскость, которая максимизирует зазор между точками выборки разных классов. Для нелинейно разделимых данных SVM использует ядерный трюк, чтобы отобразить данные в пространство более высокой размерности и найти разделяющую гиперплоскость.
Ядерные функции:
- Линейное ядро: Подходит для линейно разделимых данных.
- Гауссово ядро радиальной базисной функции (RBF): Подходит для нелинейных данных.
- Полиномиальное ядро: Подходит для данных с полиномиальными зависимостями.
Реализация в scikit-learn:
Пример
from sklearn.model_selection import train_test_split
# Предположим, X — матрица признаков, y — метка
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
model = SVC(kernel='linear') # Использовать линейное ядро
model.fit(X_train, y_train)
# Прогнозирование
y_pred = model.predict(X_test)
Дерево решений и случайный лес
Дерево решений — это древовидная модель классификации, которая разбивает данные и в конечном итоге разделяет их на разные классы. Случайный лес, с другой стороны, строит несколько деревьев решений и определяет итоговый прогноз путём голосования или усреднения.
Дерево решенийОно разбивает данные, выбирая оптимальные признаки. Критериями выбора обычно являютсяприрост информациииликоэффициент Джини。
Случайный лесОн уменьшает переобучение и повышает точность модели за счёт ансамбля нескольких деревьев решений. Он увеличивает разнообразие моделей, внося случайность (например, случайный выбор признаков, случайный выбор подмножеств данных).
Реализация в scikit-learn:
Пример
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split
# Предположим, X — матрица признаков, y — метка
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# Дерево решений
dt_model = DecisionTreeClassifier()
dt_model.fit(X_train, y_train)
# Случайный лес
rf_model = RandomForestClassifier(n_estimators=100)
rf_model.fit(X_train, y_train)
# Прогнозирование
dt_pred = dt_model.predict(X_test)
rf_pred = rf_model.predict(X_test)
2. Модели регрессии
Цель задач регрессии — предсказать непрерывную выходную переменную. К распространённым моделям регрессии относятся линейная регрессия, Ridge-регрессия и Lasso-регрессия.
Линейная регрессия
Линейная регрессия предсказывает целевую переменную, подгоняя прямую линию. Её основное предположение состоит в том, что между признаками и целевой переменной существует линейная зависимость.
Для задачи простой линейной регрессии модель можно выразить так:
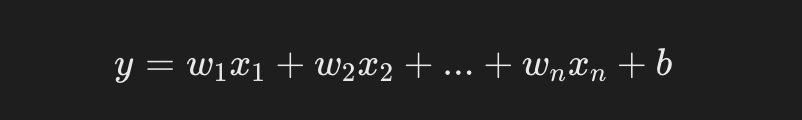
- y — предсказанное значение (целевое значение).
- x1,x2,xn— входной признак.
- w1,w2,wn— обучаемые веса (параметры модели).
- b — это член смещения.
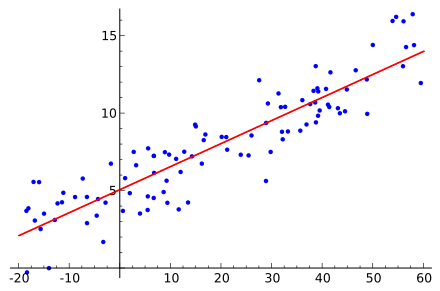
Реализация в scikit-learn:
Пример
from sklearn.model_selection import train_test_split
# Предположим, X — матрица признаков, y — целевая переменная
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
model = LinearRegression()
model.fit(X_train, y_train)
# Прогнозирование
y_pred = model.predict(X_test)
Ридж-регрессия
Ридж-регрессия — это вариант линейной регрессии, который используетL2-регуляризацию, чтобы ограничить сложность модели и избежать переобучения.
Штрафуя величину коэффициентов регрессии, ридж-регрессия может лучше справляться с проблемами мультиколлинеарности.
Пример
model = Ridge(alpha=1.0) Пример
model.fit(X_train, y_train)
# alpha — параметр регуляризации
y_pred = model.predict(X_test)
Лассо-регрессия
Лассо-регрессияЛассо-регрессия также является формой линейной регрессии; она используетL1-регуляризацию
чтобы штрафовать коэффициенты регрессии.
Пример
model = Lasso(alpha=0.1) реализация scikit-learn:
model.fit(X_train, y_train)
Пример
y_pred = model.predict(X_test)
3. Модели кластеризации
# Прогнозирование
K-Means
Кластеризация — это метод обучения без учителя, цель которого — разделить объекты в наборе данных на разные группы (или кластеры), делая объекты внутри одного кластера как можно более похожими, а объекты в разных кластерах — как можно более разными.
K-Means
Пример
Реализация в scikit-learn:
model = KMeans(n_clusters=3)
model.fit(X)
Пример
labels = model.predict(X)
DBSCAN (кластеризация на основе плотности)
# Получить метки кластеров
DBSCAN (кластеризация на основе плотности)
Пример
Реализация в scikit-learn:
model = DBSCAN(eps=0.5, min_samples=5)
model.fit(X)
# Получить метки кластеров
labels = model.labels_
Иерархическая кластеризация
Иерархическая кластеризация — это метод кластеризации, при котором кластеры рекурсивно объединяются или разделяются. К часто используемым методам иерархической кластеризации относятсяагломеративная кластеризация(Agglomerative) идивизивная кластеризация(Divisive)。
Реализация в scikit-learn:
Пример
# Предположим, X — матрица признаков
model = AgglomerativeClustering(n_clusters=3)
labels = model.fit_predict(X)
4. Оценка и выбор модели
В машинном обучении после завершения обучения модели необходимо оценить способность модели к обобщению с помощью разумных методов оценки и выбрать модель с наилучшими показателями.
К распространённым методам оценки относятся:
- Оценка метрик классификации
- Кросс-валидация
- Настройка гиперпараметров
Метрики оценки классификации
В задачах классификации обычно используются следующие метрики оценки:
- Точность
- Precision
- Полнота
- Оценка F1
Они отражают качество работы модели с разных сторон.
Пояснение значения каждой метрики:
Accuracy-- Доля правильно предсказанных примеров среди всех примеров: подходит для случаев с относительно сбалансированным распределением классов
-
Precision-- Среди примеров, предсказанных как положительные, доля действительно положительных: фокусируется на том, «надёжен ли положительный прогноз»
-
Recall-- Среди всех действительно положительных примеров доля, правильно идентифицированных моделью: фокусируется на том, «пропускаются ли положительные примеры»
F1-мера
Среднее гармоническое точности и полноты:
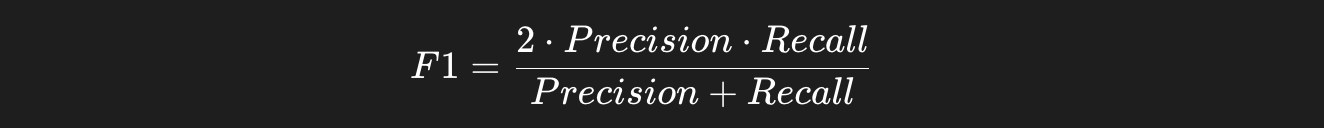
Используется для достижения баланса между точностью и полнотой.
Реализация в scikit-learn:
Пример
accuracy = accuracy_score(y_test, y_pred)
precision = precision_score(y_test, y_pred)
recall = recall_score(y_test, y_pred)
f1 = f1_score(y_test, y_pred)
print(f"Accuracy: {accuracy}")
print(f"Precision: {precision}")
print(f"Recall: {recall}")
print(f"F1 Score: {f1}")
Отложенная оценка (разделение на обучающую/тестовую выборки)
Наиболее распространённый и интуитивно понятный метод оценки — разделить набор данных на:
- Обучающий набор: используется для обучения модели
- Тестовый набор: используется для оценки эффективности
Этот метод прост и эффективен, подходит для понимания эффективности модели на начальном этапе.
Перекрёстная проверка
Перекрёстная проверка многократно разделяет набор данных для обучения и тестирования, что позволяет получить более стабильные и надёжные результаты оценки эффективности модели.
Обычная практика —K-кратная перекрёстная проверка:
- Набор данных разделяется на K блоков
- Каждый раз один блок используется в качестве валидационного набора
- Остальные — в качестве обучающего набора
- Повторите K раз и возьмите средний результат
Пример
from sklearn.linear_model import LogisticRegression
model = LogisticRegression()
scores = cross_val_score(model, X, y, cv=5)
print("Оценки кросс-валидации:", scores)
print("Средняя оценка:", scores.mean())
В реальных проектах обычно используется либо метод отложенной выборки, либо кросс-валидация; нет необходимости смешивать оба одновременно.
Настройка поиска по сетке (GridSearchCV)
На производительность модели часто существенно влияют настройки гиперпараметров.
Поиск по сетке автоматически находит оптимальную конфигурацию, перебирая комбинации параметров.
В сочетании с кросс-валидацией результаты настройки гиперпараметров становятся более устойчивыми.
Пример
from sklearn.svm import SVC
parameters = {
'kernel': ['linear', 'rbf'],
'C': [1, 10, 100]
}
model = SVC()
grid_search = GridSearchCV(
model,
parameters,
cv=5
)
grid_search.fit(X, y)
print("Лучшие параметры:", grid_search.best_params_)
print("Лучшая оценка:", grid_search.best_score_)