Как представляются символы -- ASCII и Unicode
В этой лекции вы поймёте: как текст представляется в компьютере, который может хранить только числа, и почему при открытии файла иногда появляется искажённый текст.
Бытовая аналогия: нумерация комнат
Представьте здание со 128 комнатами.
Стойка регистрации не управляет комнатами по названиям вроде "Президентский люкс" или "Садовая комната".
Они присваивают каждой комнате номер: 101, 102, 103...
Посмотрите номер 101 и понимаете: о, это стандартный номер с кроватью king-size.
Компьютеры обрабатывают текст точно так же:
Назначьте числовой код каждому символу, затем храните и обрабатывайте это число.
Эта «схема нумерации» — это кодировка символов.
ASCII: начало всех кодировок
ASCII (American Standard Code for Information Interchange, United States Information Exchange Standard Code) появился в 1963 году.
Он использует 7 бит для представления одного символа, всего 2^7 = 128 символов.
Содержит:
- Управляющие символы (0~31): невидимые символы, такие как возврат каретки, перевод строки и возврат на одну позицию
- Печатаемые символы (32~126): пробел, знаки препинания, цифры 0-9, заглавные буквы A-Z, строчные буквы a-z
- DEL, символ удаления (127)
Полная таблица ASCII (0~127)
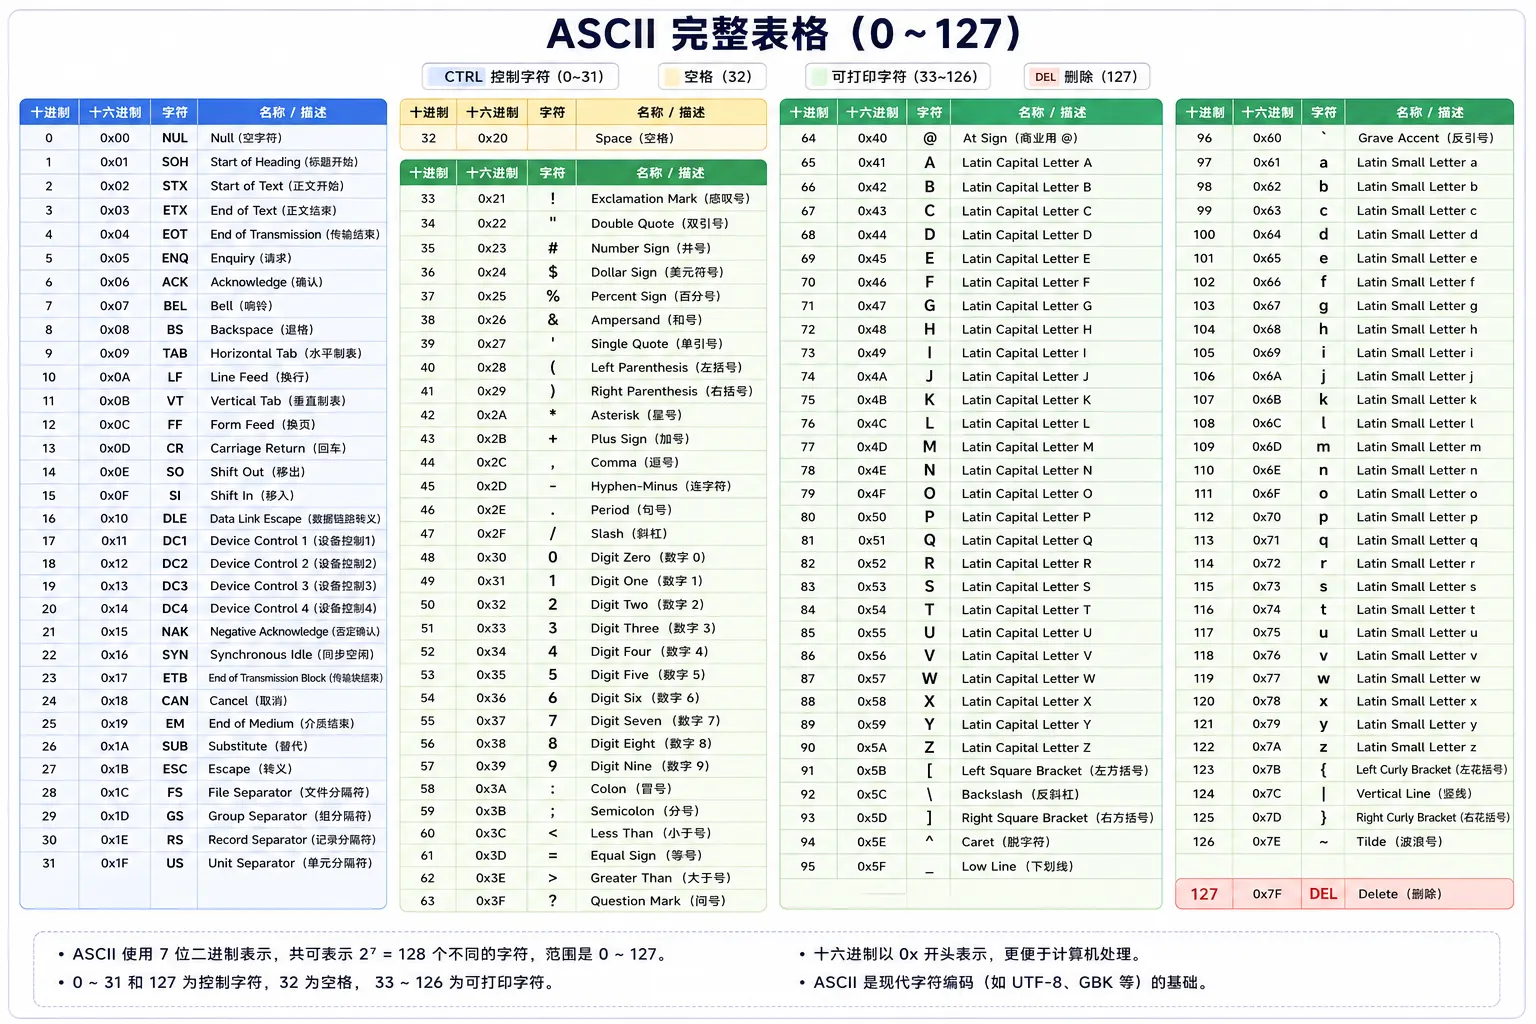
Ключевые опорные точки в ASCII
| Категория символов | Диапазон ASCII | особенность |
|---|---|---|
| '0' ~ '9' | 48 ~ 57 (0x30 ~ 0x39) | Код цифры 0 — 48, а не 0. |
| 'A' ~ 'Z' | 65 ~ 90 (0x41 ~ 0x5A) | Прописные буквы расположены последовательно |
| 'a' ~ 'z' | 97 ~ 122 (0x61 ~ 0x7A) | Строчные буквы расположены последовательно |
| Новая строка '\n' | 10 (0x0A) | LF, перенос строки в Unix/Mac |
| Возврат каретки '\r' | 13 (0x0D) | CR, перенос строки, использовавшийся в старых Mac |
Остроумная связь между прописными и строчными буквами
Обратите внимание на двоичное представление заглавной 'A' (65) и строчной 'a' (97):
'a' = 01100001
Отличается только бит 5 (значение = 32, нумерация битов справа налево, начиная с 0)
Это не совпадение.
На двоичном уровне изменение бита 5 с 0 на 1 напрямую выполняет преобразование из верхнего регистра в нижний.
Это остроумное решение позволяло ранним телетайпам переключаться между режимами верхнего и нижнего регистра с помощью всего одной простой схемы.
Бит 5 отсчитывается по соглашению о нумерации битов справа налево, начиная с 0 (то есть младший значащий бит — это бит 0), что является наиболее распространённым соглашением о нумерации битов в компьютерах:
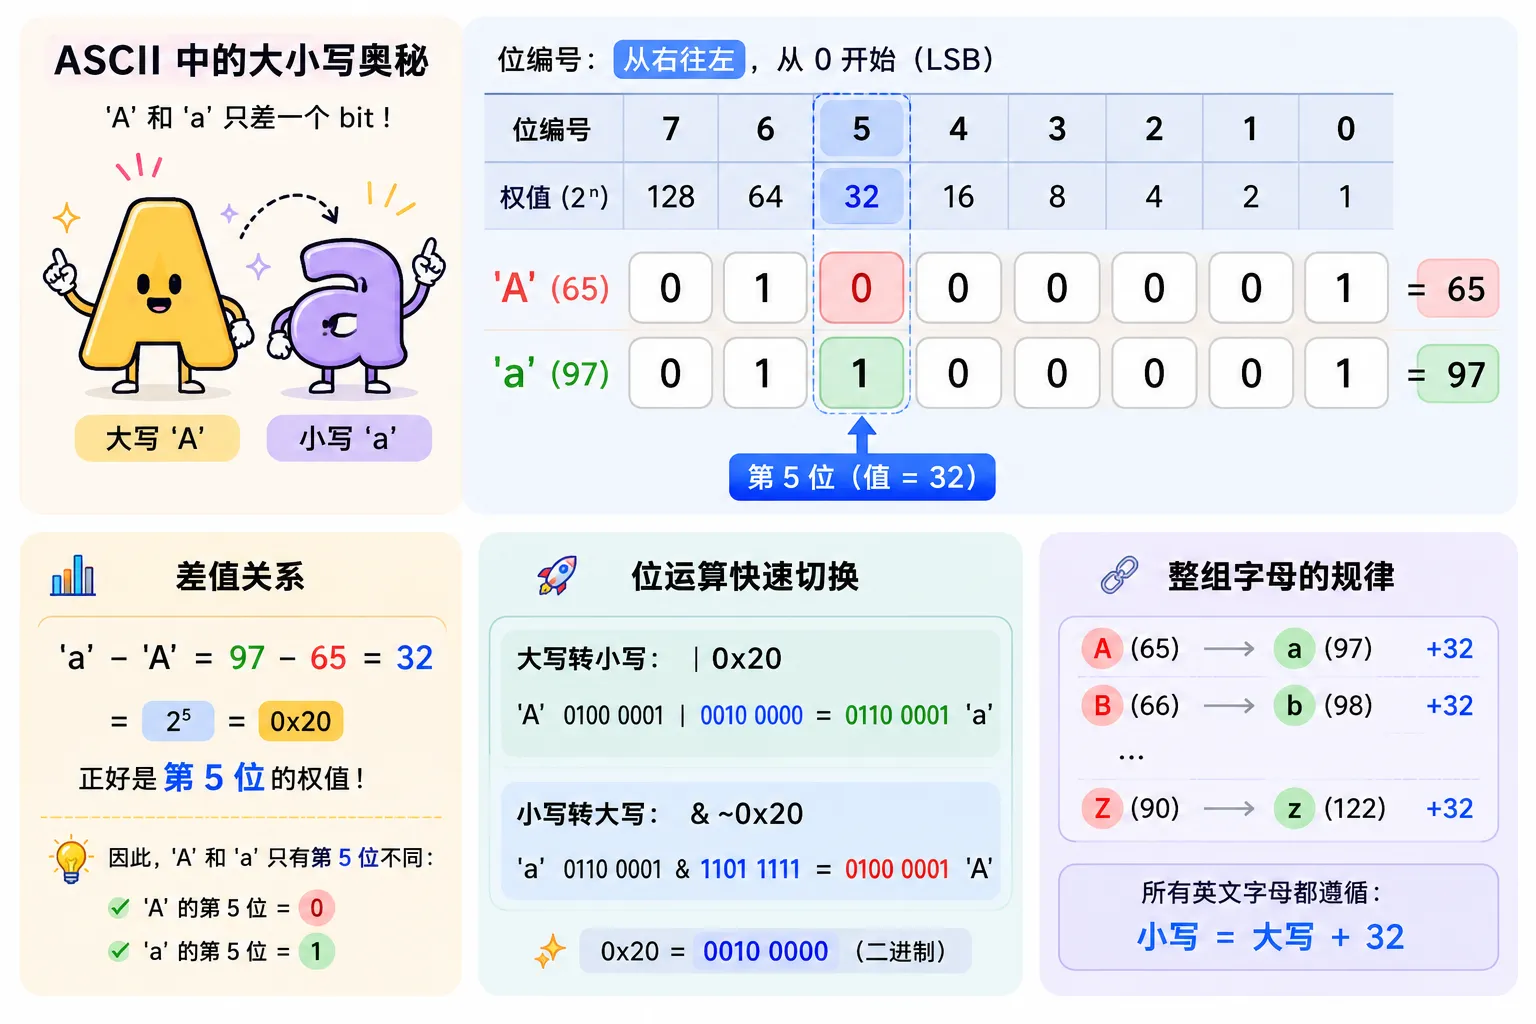
Заглавные и строчные буквы различаются на 32, поэтому на уровне ASCII,
'a' - 'A' = 32,'A' | 0x20 = 'a'(Побитовая операция для переключения регистра). Всё это вытекает из остроумной структуры таблицы кодировки ASCII.
Ограничение ASCII: одного байта недостаточно
В ASCII всего 128 символов, чего достаточно для английского.
Но когда компьютеры начали распространяться в Европе, возникли проблемы:
Во французском есть é, в немецком есть ü, в испанском есть ñ — этих букв с диакритикой просто нет в ASCII.
Так каждая страна начала «латать» — используя диапазон 128~255, который ASCII не использовал (с установленным 8-м битом в 1):
- Западная Европа: ISO-8859-1 (Latin-1), которая добавила западноевропейские символы, такие как e и u
- Восточная Европа: ISO-8859-2, добавлены славянские буквы
- Греция: ISO-8859-7, добавлены греческие буквы
- Китай: GB2312/GBK, использует два байта для представления одного китайского иероглифа
- Япония: Shift-JIS
- Корея: EUC-KR
Это обернулось катастрофой —Одни и те же двоичные данные при интерпретации в разных кодировках дают совершенно разный текст。
Открываете японский документ и видите абракадабру? Это классический симптом несоответствия кодировок.
Unicode: присвоение каждому символу в мире уникального номера
Цель Unicode проста, но амбициозна:
Присвоить каждому символу в мире уникальный числовой код (Code Point).。
Unicode — не 16-битная система: диапазон его кодовых точек — от U+0000 до U+10FFFF, что позволяет вместить более 1 миллиона символов.
На данный момент назначено около 150,000 символов, охватывающих почти все системы письменности человечества, а также эмодзи.
Примеры кодовых точек Unicode
| Символ | Кодовая точка Unicode | Значение | Назначенный блок |
|---|---|---|---|
| A | U+0041 | Заглавная латинская буква A | Основной латинский алфавит (совместим с ASCII) |
| ты | U+4F60 | Китайский иероглиф CJK「你」 | CJK Unified Ideographs |
| ОК | U+597D | Китайский иероглиф CJK「好」 | CJK Unified Ideographs |
| привет | U+68D2 | Арабский «Привет» | Арабский |
| пример | U+E0001 | Языковой тег | Блок тегов |
Примечание: Unicode — это всего лишь «схема нумерации» — она сообщает, что «символ X имеет номер U+XXXX».
Она не указывает, «как номер U+XXXX хранится в файле».
Сохранение — это задача «схем кодирования», таких как UTF-8 и UTF-16.
Многие люди путают Unicode с UTF-8. Запомните это различие: Unicode — это словарь (определяющий, какой символ соответствует какому номеру), а UTF-8 — это правило записи (определяющее, как номер записывается в виде последовательности байтов).
UTF-8: самая популярная схема кодирования Unicode
Дизайн UTF-8 чрезвычайно умён. Этокодировка переменной длины:
- Символы ASCII (U+0000 ~ U+007F): хранятся в 1 байте
- Большинство европейских и арабских символов: используют 2 байта
- Китайские, японские и корейские: используют 3 байта
- Дополнительные символы (включая большинство эмодзи): используют 4 байта
Правила кодирования UTF-8
Первого байташаблон ведущих битовОн сообщает декодеру: сколько байтов занимает этот символ.
- Начинается с 0: однобайтовый символ
- Начинается с 110: двухбайтовый символ
- Начинается с 1110: трёхбайтовый символ
- Начинается с 11110: четырёхбайтовый символ
- Все последующие байты начинаются с 10
Главное преимущество UTF-8:Полная совместимость с ASCII。
Любой корректный текст ASCII также является корректным текстом UTF-8.
Это свойство позволяет UTF-8 плавно заменить старую систему ASCII, не нарушая никаких существующих данных.
Интерактивная демонстрация: просмотр кодировки в реальном времени
Введите любой текст ниже, чтобы увидеть кодовую точку Unicode каждого символа, байты в кодировке UTF-8 и занимаемое место.
Рекомендации по работе:
- Введите текст только на английском и обратите внимание, что каждый символ занимает всего 1 байт.
- Введите текст на китайском и обратите внимание, что каждый китайский символ занимает 3 байта.
- Ввод
Hello EXAMPLEОбратите внимание, идут ли ASCII-коды букв последовательно. - Сравните двоичные представления прописных и строчных букв и найдите соответствующие пары букв, которые различаются только на 1 бит (например, A и a).
Проблема искажения кодировки: принципы и предотвращение
Суть кракозябр можно выразить одной фразой:использование неправильного словаря для интерпретации данных。
Предположим, файл содержит три байта, сохранённых в кодировке UTF-8:E4 BD A0
- Декодирование с помощью UTF-8: эти 3 байта образуют один символ → "ты"
- Декодирование с помощью GBK: E4 BD рассматривается как двухбайтовый символ GBK → возможно, это какой-то не связанный китайский иероглиф
- Декодирование с помощью Latin-1: E4, BD, A0 рассматриваются как три независимых западноевропейских символа → кракозябры вроде "a + 1/2 + nbsp"
Одни и те же двоичные данные, декодированные с помощью трёх разных словарей, дают три разных текста.
Как избежать кракозябр?
- Используйте UTF-8 повсеместноСовременные веб-технологии, API и базы данных почти все по умолчанию используют UTF-8
- Явно указывайте кодировку: записывайте в HTML
<meta charset="UTF-8">, укажите в заголовке HTTP-ответаContent-Type: text/html; charset=utf-8 - настройки редактораТакие редакторы, как VS Code и Sublime, поддерживают установку кодировки файла в UTF-8
Проблема с BOM (Byte Order Mark)
Хотя в UTF-8 не нужно беспокоиться о порядке байтов (поскольку он основан на байтах), некоторые программы Windows добавляют BOM в начало файлов UTF-8:EF BB BF。
Эти три байта используются, чтобы обозначить, что "этот файл закодирован в UTF-8".
Но в системах Unix/Linux BOM может вызывать различные проблемы:
- Первая строка Shell-скрипта
#!/bin/bashЛишние три невидимых байта в начале приводят к тому, что скрипт не может выполниться - Если в файле PHP есть BOM, это может вызвать ошибку "headers already sent"
- Парсеры JSON могут отклонять данные JSON, начинающиеся с BOM
Рекомендация: используйте формат "без BOM" для файлов UTF-8 (UTF-8 без BOM), что также является настройкой по умолчанию в большинстве современных редакторов.
Демонстрация кода: кодирование и декодирование
Пример
import sys
# =============================================
# Демо 1: Базовое использование ord() и chr()
# =============================================
print("=" * 60)
print("Демо 1: Преобразование между символами и кодовыми точками")
print("=" * 60)
# ord() получает кодовую точку Unicode символа
text = "Hello EXAMPLE"
for ch in text:
cp = ord(ch)
print(f'{ch}' → кодовая точка U+{cp:04X} (десятичное значение {cp}))
print()
# chr() получает символ по кодовой точке
for cp in [65, 97, 48, 0x4F60, 0x597D]:
ch = chr(cp)
print(f" Кодовая точка U+{cp:04X} → символ '{ch}'")
# =============================================
# Демо 2: кодирование в виде последовательности байтов (encode)
# =============================================
print("\n" + "=" * 60)
print(Демонстрация 2: строка → последовательность байтов UTF-8)
print("=" * 60)
texts = ["A", "Hello", Hello, "EXAMPLE Tutorial"]
for text in texts:
utf8_bytes = text.encode('utf-8')
hex_str = utf8_bytes.hex(' ').upper()
print(f"\nТекст: '{text}'")
print(f" Количество символов: {len(text)}")
print(fКоличество байтов UTF-8: {len(utf8_bytes)})
print(f" UTF-8 в шестнадцатеричном виде: {hex_str}")
# Побайтовый анализ
print(f" Разложение по байтам:")
for i, b in enumerate(utf8_bytes):
bin_str = format(b, '08b')
# Определить тип байта
if b < 0x80:
typ = "Одиночный байт ASCII"
elif b >= 0xC0 and b < 0xE0:
typ = "Ведущий байт двухбайтового символа"
elif b >= 0xE0 and b < 0xF0:
typ = "Ведущий байт трёхбайтового символа"
elif b >= 0x80 and b < 0xC0:
typ = "Байты продолжения"
else:
typ = "Другое"
print(fБайт {i}: 0x{b:02X} = {bin_str} ({typ}))
# =============================================
# Демо 3: кодировка GBK (не-Unicode-кодировка, широко используемая в Китае)
# =============================================
print("\n" + "=" * 60)
print(Демо 3: кодировка GBK (по сравнению с UTF-8))
print("=" * 60)
text = "Hello EXAMPLE"
utf8_bytes = text.encode('utf-8')
gbk_bytes = text.encode('gbk')
print(fТекст: '{text}')
print(f" UTF-8 ({len(utf8_bytes)} байт): {utf8_bytes.hex(' ').upper()}")
print(f" GBK ({len(gbk_bytes)} байт): {gbk_bytes.hex(' ').upper()}")
# В GBK каждый китайский иероглиф занимает 2 байта
print(f"\nПримечание: в GBK китайские иероглифы занимают 2 байта; в UTF-8 китайские иероглифы занимают 3 байта.")
print(f" Для китайского текста GBK компактнее, чем UTF-8")
print(fНо GBK не поддерживает все символы Unicode (например, эмодзи).)
# =============================================
# Демо 4: сценарий ошибки декодирования
# =============================================
print("\n" + "=" * 60)
print("Демо 4: сценарий ошибки декодирования (причина искажённого текста)")
print("=" * 60)
# Кодировать китайский текст в UTF-8
original = Hello
utf8_data = original.encode('utf-8')
print(f"Исходный текст: '{original}'")
print(fКодировка UTF-8: {utf8_data.hex(' ').upper()})
# Ошибка 1: декодирование данных UTF-8 с помощью GBK
try:
decoded_wrong = utf8_data.decode('gbk')
print(fДекодировано с помощью GBK: '{decoded_wrong}' (искажено!))
except Exception as e:
print(fНе удалось декодировать с помощью GBK: {e})
# Ошибка 2: декодирование с Latin-1
decoded_latin = utf8_data.decode('latin-1')
print(fДекодировано с Latin-1: '{decoded_latin}' (похоже на искажённые западноевропейские символы))
# =============================================
# Демо 5: Создайте разумный декодер
# =============================================
print("\n" + "=" * 60)
print(Демо 5: Определение кодировки и безопасное декодирование)
print("=" * 60)
def safe_decode(data, encodings=['utf-8', 'gbk', 'latin-1']):
"""Попробовать декодировать с несколькими кодировками, вернуть первый успешный результат"""
for enc in encodings:
try:
return data.decode(enc), enc
except (UnicodeDecodeError, LookupError):
continue
return data.decode('latin-1', errors='replace'), 'latin-1 (резервный вариант)'
#
test_cases = [
"Привет EXAMPLE".encode('utf-8'),
"Привет, мир".encode('utf-8'),
"Computer".encode('gbk'),
]
for data in test_cases:
data, encoding = safe_decode(data)
print(fДанные ({len(data)} bytes) декодированы с помощью {encoding}: '{result}')
print("\n" + "=" * 60)
print(Итог: строки — это внутреннее представление Python; кодировка — это формат для хранения/передачи.)
print(Всегда выполняйте преобразование кодировки на границе ввода-вывода и всегда используйте тип str внутри.)
print("=" * 60)
Настоящее и будущее кодировки символов
На сегодняшний день,UTF-8 стал фактическим стандартом в Интернете.。
Более 98% веб-страниц используют UTF-8.
Спецификация JSON требует UTF-8.
Почти все современные языки программирования по умолчанию используют UTF-8 для обработки текста.
Unicode всё ещё расширяется.
Новые версии Unicode добавляют новые символы каждый год, включая: редкие письменности, исторические письменности и новые эмодзи.
Кодирование сместилось с вопроса «можно ли это представить» к вопросу «как эффективно хранить и передавать».
Другие расширенияЕсли вы начинаете новый проект сегодня, выбор UTF-8 не будет ошибкой. Это схема кодирования, обратно совместимая с ASCII, кроссплатформенная и поддерживает все языки. Единственное, на что стоит обратить внимание, — убедитесь, что весь ваш стек (фронтенд, бэкенд, база данных) использует UTF-8, и не смешивайте.