Comment les caractères sont-ils représentés -- ASCII et Unicode
Dans ce cours, vous comprendrez : comment le texte est représenté dans un ordinateur qui ne peut stocker que des nombres, et pourquoi l'ouverture d'un fichier produit parfois du texte brouillé.
Analogie du quotidien : numérotation des chambres
Imaginez un bâtiment avec 128 chambres.
La réception ne gère pas les chambres par des noms comme « Suite présidentielle » ou « Chambre du jardin ».
Ils attribuent à chaque chambre un numéro : 101, 102, 103...
Cherchez le numéro 101 et vous savez : ah, c'est une chambre king standard.
Les ordinateurs traitent le texte exactement de la même manière :
Attribuez un code numérique à chaque caractère, puis stockez et traitez ce nombre.
Ce « système de numérotation » est l'encodage des caractères.
ASCII : l'origine de tous les encodages
ASCII (American Standard Code for Information Interchange, United States Information Interchange Standard Code) a vu le jour en 1963.
Il utilise 7 bits pour représenter un caractère, soit un total de 2^7 = 128 caractères.
Contient :
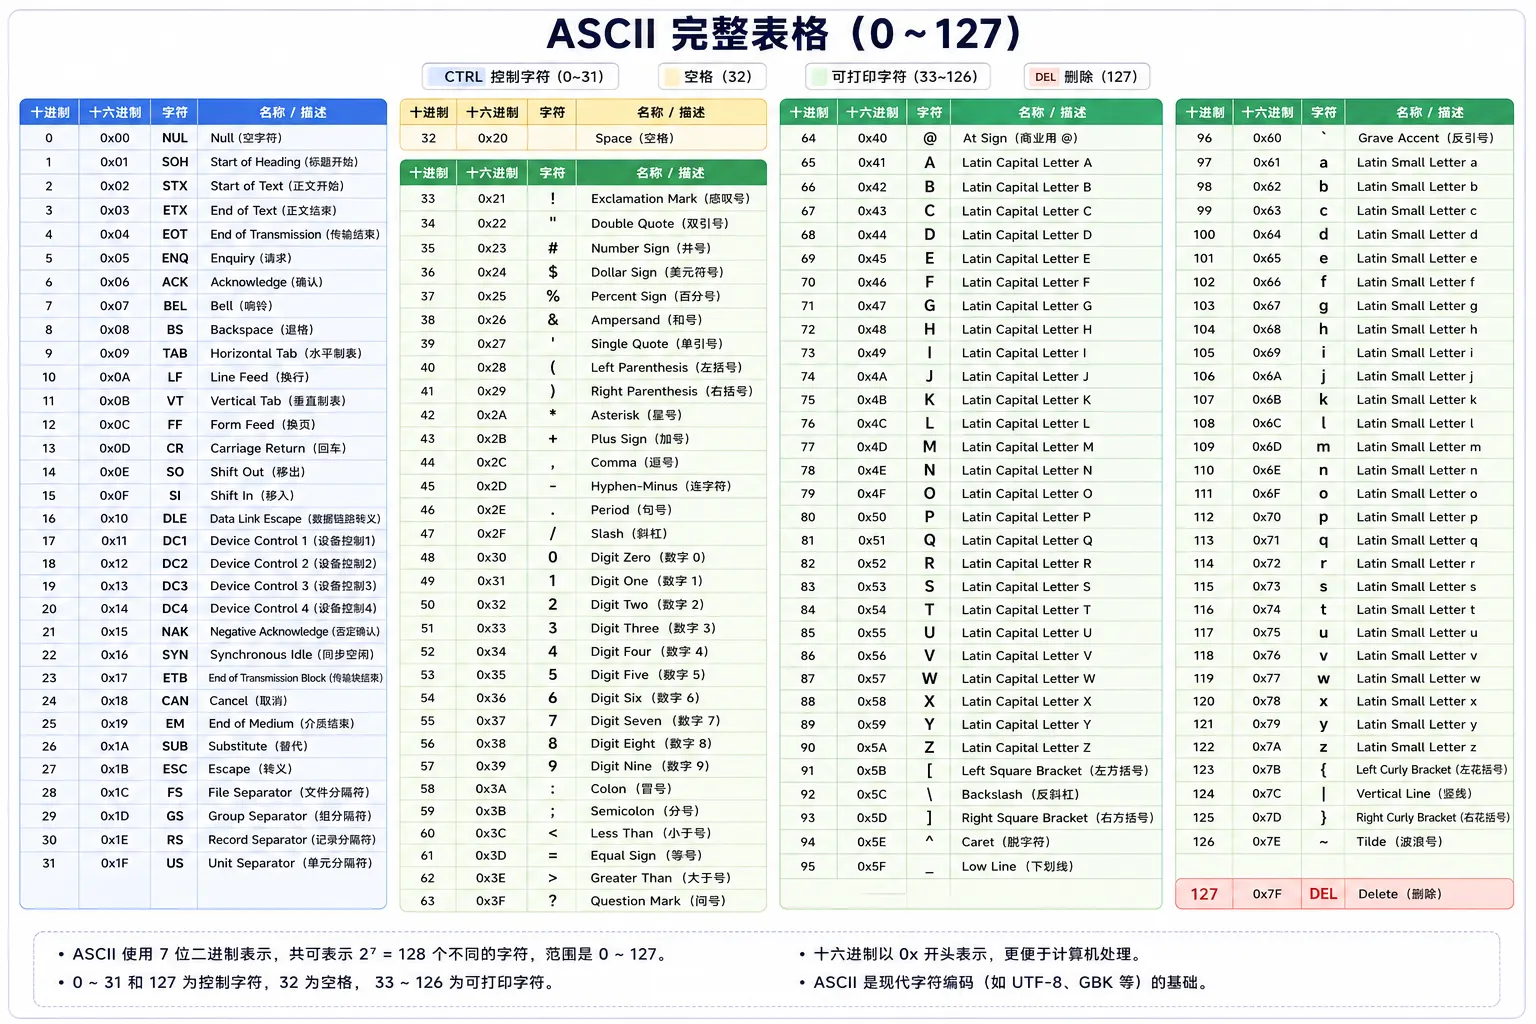
- Caractères de contrôle (0~31) : caractères invisibles tels que le retour chariot, le saut de ligne et le retour arrière
- Caractères imprimables (32~126) : espace, ponctuation, chiffres 0-9, lettres majuscules A-Z, lettres minuscules a-z
- DEL caractère de suppression (127)
Table ASCII complète (0~127)
Points d'ancrage clés en ASCII
| Catégorie de caractère | Plage ASCII | Fonctionnalité |
|---|---|---|
| '0' ~ '9' | 48 ~ 57 (0x30 ~ 0x39) | Le code du chiffre 0 est 48, pas 0. |
| 'A' ~ 'Z' | 65 ~ 90 (0x41 ~ 0x5A) | Les lettres majuscules sont disposées consécutivement |
| 'a' ~ 'z' | 97 ~ 122 (0x61 ~ 0x7A) | Les lettres minuscules sont disposées consécutivement |
| Nouvelle ligne '\n' | 10 (0x0A) | LF, saut de ligne Unix/Mac |
| Retour chariot '\r' | 13 (0x0D) | CR, le saut de ligne utilisé par les anciens Mac |
La relation ingénieuse entre majuscules et minuscules
Notez la représentation binaire de la lettre majuscule 'A' (65) et de la lettre minuscule 'a' (97) :
'a' = 01100001
Seul le bit 5 diffère (valeur = 32, numérotation des bits de droite à gauche, en partant de 0)
Ce n'est pas une coïncidence.
Au niveau binaire, faire passer le bit 5 de 0 à 1 effectue directement la conversion de majuscule en minuscule.
Cette conception astucieuse a permis aux premiers téléscripteurs de passer entre les modes majuscules et minuscules avec un simple circuit.
Le bit 5 est compté selon la convention de numérotation des bits de droite à gauche en partant de 0 (c'est-à-dire que le LSB est le bit 0), qui est la convention de numérotation des bits la plus courante en informatique :
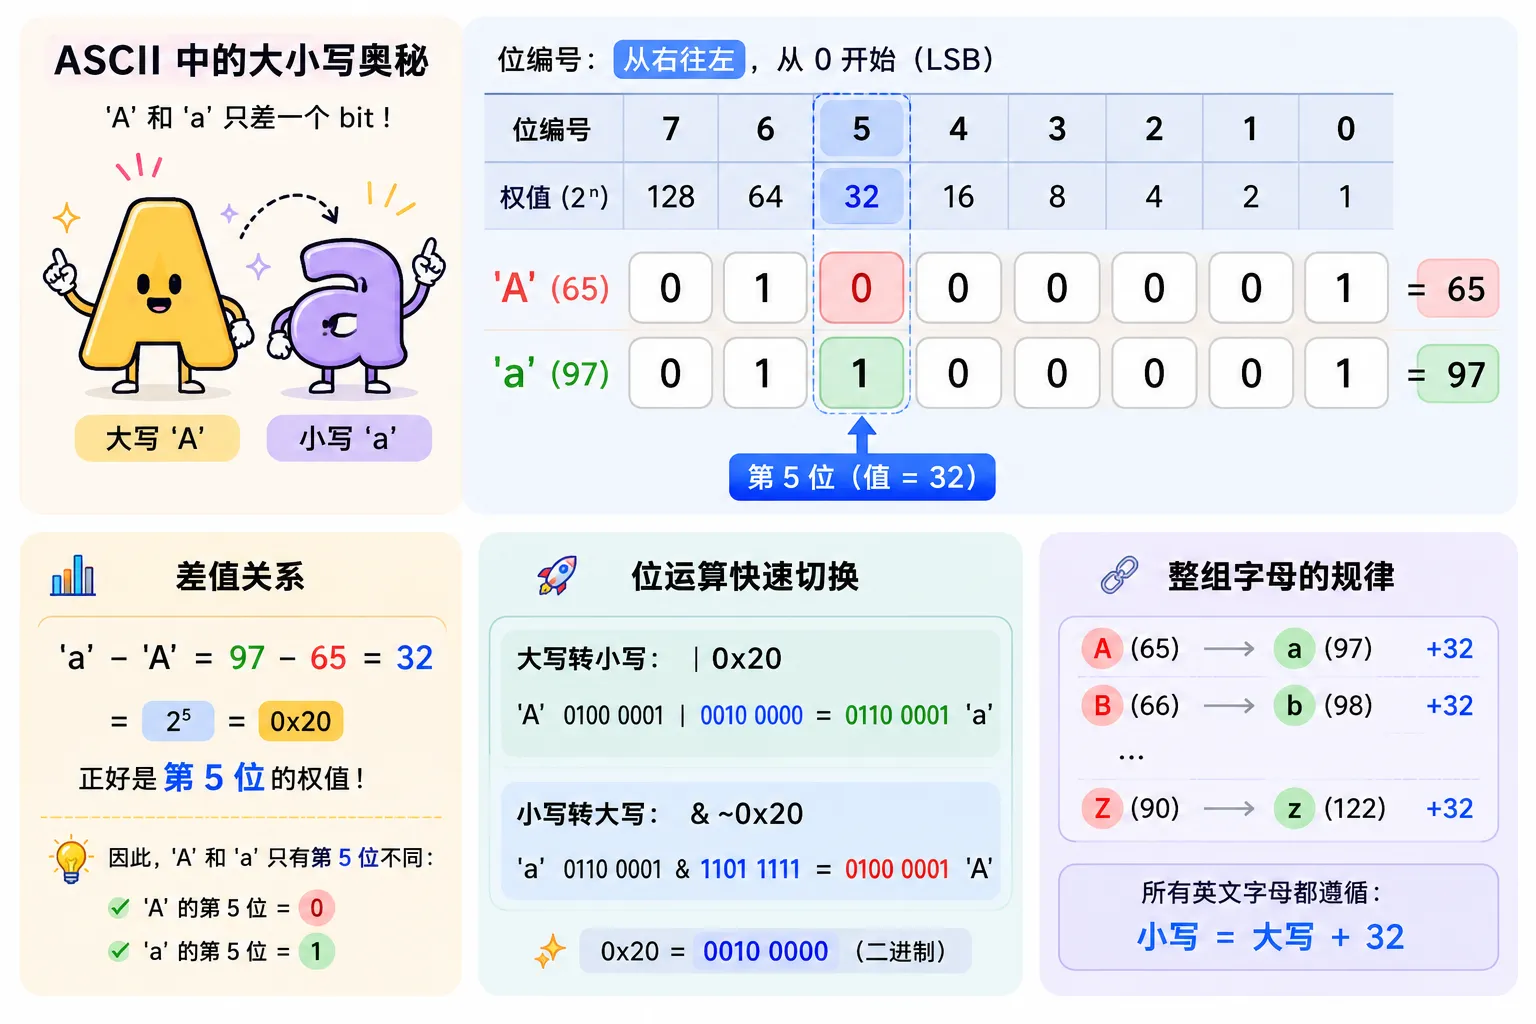
Les lettres majuscules et minuscules diffèrent de 32, donc au niveau ASCII,
'a' - 'A' = 32,'A' | 0x20 = 'a'(Opération bit à bit pour changer la casse). Tout cela découle de l'agencement astucieux de la table d'encodage ASCII.
La limitation de l'ASCII : un octet ne suffit pas
L'ASCII ne compte que 128 caractères, ce qui suffit pour l'anglais.
Mais lorsque les ordinateurs se sont répandus en Europe, des problèmes sont apparus :
Le français a é, l'allemand a ü, l'espagnol a ñ — ces lettres accentuées n'existent tout simplement pas dans l'ASCII.
Ainsi, chaque pays a commencé à « patcher »—en utilisant la plage 128~255 que l’ASCII n’utilisait pas (avec le 8e bit à 1) :
- Europe de l’Ouest : ISO-8859-1 (Latin-1), qui a ajouté des caractères d’Europe de l’Ouest tels que e et u
- Europe de l’Est : ISO-8859-2, a ajouté des lettres slaves
- Grèce : ISO-8859-7, a ajouté des lettres grecques
- Chine : GB2312/GBK, utilise deux octets pour représenter un caractère chinois
- Japon : Shift-JIS
- Corée : EUC-KR
C’est devenu un désastre—Les mêmes données binaires, lorsqu’elles sont interprétées selon différents encodages, produisent un texte complètement différent。
Vous ouvrez un document japonais et voyez du texte brouillé ? C’est le symptôme classique d’une incompatibilité d’encodage.
Unicode : donner un numéro unique à chaque caractère du monde
L’objectif d’Unicode est simple mais ambitieux :
Attribuer un code numérique unique (point de code) à chaque caractère du monde.。
Unicode n'est pas sur 16 bits — sa plage de points de code va de U+0000 à U+10FFFF, ce qui permet de contenir plus de 1 million de caractères.
Environ 150,000 caractères ont été attribués jusqu'à présent, couvrant presque tous les systèmes d'écriture humains, ainsi que les emoji.
Exemples de points de code Unicode
| Caractère | Point de code Unicode | Signification | Bloc attribué |
|---|---|---|---|
| A | U+0041 | Lettre majuscule latine A | Alphabet latin de base (compatible ASCII) |
| vous | U+4F60 | Caractère chinois CJK「你」 | Idéogrammes unifiés CJK |
| OK | U+597D | Caractère chinois CJK「好」 | Idéogrammes unifiés CJK |
| bonjour | U+68D2 | « Bonjour » en arabe | Arabe |
| exemple | U+E0001 | Étiquette de langue | Bloc de balises |
Remarque : Unicode n’est qu’un « système de numérotation » — il vous indique que « le caractère X a le numéro U+XXXX ».
Il ne précise pas « comment le numéro U+XXXX est stocké dans un fichier ».
Le stockage dans des fichiers est le rôle des « schémas d’encodage » tels que UTF-8 et UTF-16.
Beaucoup de gens confondent Unicode et UTF-8. Retenez cette distinction : Unicode est un dictionnaire (qui définit quel caractère correspond à quel numéro), tandis que UTF-8 est une règle d’écriture (qui spécifie comment un numéro s’écrit sous forme de séquence d’octets).
UTF-8 : le schéma d’encodage Unicode le plus populaire
La conception d’UTF-8 est extrêmement astucieuse. C’est unencodage à longueur variable:
- Caractères ASCII (U+0000 ~ U+007F) : stockés sur 1 octet
- La plupart des caractères européens et arabes : utilisent 2 octets
- Chinois, japonais et coréen : utilisent 3 octets
- Caractères supplémentaires (y compris la plupart des emoji) : utilisent 4 octets
Règles d'encodage UTF-8
Du premier octetmotif des bits de têteIl indique au décodeur : combien d'octets ce caractère occupe.
- Commençant par 0 : caractère sur un octet
- Commençant par 110 : caractère sur deux octets
- Commence par 1110 : caractère sur trois octets
- Commence par 11110 : caractère sur quatre octets
- Les octets suivants commencent tous par 10
Le plus grand avantage d’UTF-8 :Entièrement compatible avec l’ASCII。
Tout texte ASCII valide est également un texte UTF-8 valide.
Cette propriété permet à UTF-8 de remplacer en douceur l’ancien système ASCII sans altérer aucune donnée existante.
Démo interactive : consultation d’encodage en temps réel
Saisissez n’importe quel texte ci-dessous pour voir le point de code Unicode de chaque caractère, les octets encodés en UTF-8 et l’espace occupé.
Suggestions d'opérations :
- Saisissez un texte en anglais uniquement et observez que chaque caractère n’occupe qu’un seul octet.
- Saisissez un texte en chinois et observez que chaque caractère chinois occupe 3 octets.
- Entrée
Hello EXAMPLENotez si les codes ASCII des lettres sont disposés consécutivement. - Comparez les représentations binaires des lettres majuscules et minuscules, et trouvez les paires de lettres correspondantes qui ne diffèrent que d'un seul bit (comme A et a).
Problème de brouillage d'encodage : principes et prévention
L'essence du texte illisible peut se résumer en une phrase :Utiliser le mauvais dictionnaire pour interpréter les données。
Supposons qu'un fichier contienne trois octets stockés en encodage UTF-8 :E4 BD A0
- Décoder avec UTF-8 : ces 3 octets forment un seul caractère → "vous"
- Décoder avec GBK : E4 BD est traité comme un caractère GBK de deux octets → pourrait être un caractère chinois sans rapport
- Décoder avec Latin-1 : E4, BD, A0 sont traités comme trois caractères indépendants d'Europe occidentale → texte illisible comme "a + 1/2 + nbsp"
Les mêmes données binaires, décodées avec trois dictionnaires différents, donnent trois textes différents.
Comment éviter le texte illisible ?
- Utiliser UTF-8 uniformémentLe Web moderne, les API et les bases de données utilisent presque tous UTF-8 par défaut
- Déclarer explicitement l'encodage: Écrire en HTML
<meta charset="UTF-8">, écrire dans l'en-tête de réponse HTTPContent-Type: text/html; charset=utf-8 - paramètres de l'éditeurLes éditeurs comme VS Code et Sublime permettent tous de définir l'encodage de fichier en UTF-8
Problème de BOM (Byte Order Mark)
Bien que UTF-8 n'ait pas à se soucier de l'ordre des octets (car il est basé sur les octets), certains programmes Windows ajoutent un BOM au début des fichiers UTF-8 :EF BB BF。
Ces trois octets servent à indiquer que « ce fichier est encodé en UTF-8 ».
Mais sur les systèmes Unix/Linux, le BOM peut causer divers problèmes :
- La première ligne d'un script Shell
#!/bin/bashLes trois octets invisibles supplémentaires au début empêchent le script de s'exécuter - Si un fichier PHP contient un BOM, cela peut déclencher une erreur « headers already sent »
- Les analyseurs JSON peuvent rejeter les données JSON qui commencent par un BOM
Recommandation : utilisez le format « sans BOM » pour les fichiers UTF-8 (UTF-8 sans BOM), qui est également le paramètre par défaut de la plupart des éditeurs modernes.
Démonstration de code : encodage et décodage
Exemple
import sys
# =============================================
# Démo 1 : Utilisation de base de ord() et chr()
# =============================================
print("=" * 60)
print("Démo 1 : Conversion entre caractères et points de code")
print("=" * 60)
# ord() renvoie le point de code Unicode d'un caractère
text = "Hello EXAMPLE"
for ch in text:
cp = ord(ch)
print(f'{ch}' → point de code U+{cp:04X} (décimal {cp}))
print()
# chr() renvoie le caractère correspondant au point de code
for cp in [65, 97, 48, 0x4F60, 0x597D]:
ch = chr(cp)
print(f" Point de code U+{cp:04X} → caractère '{ch}'")
# =============================================
# Démo 2 : encoder en séquence d'octets (encode)
# =============================================
print("\n" + "=" * 60)
print(Démo 2 : Chaîne → Séquence d'octets UTF-8)
print("=" * 60)
texts = ["A", "Hello", Hello, "EXAMPLE Tutorial"]
for text in texts:
utf8_bytes = text.encode('utf-8')
hex_str = utf8_bytes.hex(' ').upper()
print(f"\nTexte : '{text}'")
print(f" Nombre de caractères : {len(text)}")
print(fNombre d'octets UTF-8 : {len(utf8_bytes)})
print(f" Hexadécimal UTF-8 : {hex_str}")
# Analyse octet par octet
print(f" Décomposition en octets :")
for i, b in enumerate(utf8_bytes):
bin_str = format(b, '08b')
# Déterminer le type d'octet
if b < 0x80:
typ = "octet unique ASCII"
elif b >= 0xC0 and b < 0xE0:
typ = "Octet de tête pour deux octets"
elif b >= 0xE0 and b < 0xF0:
typ = "Octet de tête pour trois octets"
elif b >= 0x80 and b < 0xC0:
typ = "Octets de continuation"
else:
typ = "Autre"
print(fOctet {i}: 0x{b:02X} = {bin_str} ({typ}))
# =============================================
# Démo 3 : encodage GBK (un encodage non-Unicode couramment utilisé en Chine)
# =============================================
print("\n" + "=" * 60)
print(Démo 3 : encodage GBK (comparé à UTF-8))
print("=" * 60)
text = "Hello EXAMPLE"
utf8_bytes = text.encode('utf-8')
gbk_bytes = text.encode('gbk')
print(fTexte : '{text}')
print(f" UTF-8 ({len(utf8_bytes)} byte) : {utf8_bytes.hex(' ').upper()}")
print(f" GBK ({len(gbk_bytes)} byte) : {gbk_bytes.hex(' ').upper()}")
# En GBK, chaque caractère chinois occupe 2 bytes
print(f"\nRemarque : En GBK, les caractères chinois occupent 2 bytes ; en UTF-8, les caractères chinois occupent 3 bytes.")
print(f" Pour le texte chinois, GBK est plus compact que UTF-8")
print(fMais GBK ne prend pas en charge tous les caractères Unicode (comme les emoji).)
# =============================================
# Démo 4 : scénario d'erreur de décodage
# =============================================
print("\n" + "=" * 60)
print("Démo 4 : scénario d'erreur de décodage (cause du texte illisible)")
print("=" * 60)
# Encoder du chinois en UTF-8
original = Hello
utf8_data = original.encode('utf-8')
print(f"Texte original : '{original}'")
print(fEncodage UTF-8 : {utf8_data.hex(' ').upper()})
# Erreur 1 : décodage de données UTF-8 avec GBK
try:
decoded_wrong = utf8_data.decode('gbk')
print(fDécodé avec GBK : '{decoded_wrong}' (illisible !))
except Exception as e:
print(fÉchec du décodage avec GBK : {e})
# Erreur 2 : décodage avec Latin-1
decoded_latin = utf8_data.decode('latin-1')
print(fDécodé avec Latin-1 : '{decoded_latin}' (semble être des caractères européens occidentaux illisibles))
# =============================================
# Demo 5: Créer un décodeur raisonnable
# =============================================
print("\n" + "=" * 60)
print(Démo 5 : Détection d'encodage et décodage sûr)
print("=" * 60)
def safe_decode(data, encodings=['utf-8', 'gbk', 'latin-1']):
"""Essayer de décoder avec plusieurs encodages, retourner le premier résultat réussi"""
for enc in encodings:
try:
return data.decode(enc), enc
except (UnicodeDecodeError, LookupError):
continue
return data.decode('latin-1', errors='replace'), 'latin-1 (repli)'
# Test
test_cases = [
"Bonjour EXAMPLE".encode('utf-8'),
"Bonjour le monde".encode('utf-8'),
"Computer".encode('gbk'),
]
for data in test_cases:
result, encoding = safe_decode(data)
print(fDonnées ({len(data)} bytes) décodées avec {encoding} : '{result}')
print("\n" + "=" * 60)
print(Résumé : Les chaînes sont la représentation interne de Python ; l'encodage est le format pour le stockage/transmission.)
print(Toujours effectuer la conversion d'encodage à la frontière d'E/S, et toujours utiliser le type str en interne.)
print("=" * 60)
État actuel et avenir de l'encodage des caractères
À ce jour,UTF-8 est devenu le standard de facto sur Internet.。
Plus de 98% des pages web utilisent l'encodage UTF-8.
La spécification JSON exige UTF-8.
Presque tous les langages de programmation modernes utilisent UTF-8 par défaut pour traiter le texte.
Unicode est encore en expansion.
Les nouvelles versions d'Unicode ajoutent de nouveaux caractères chaque année, notamment : des écritures rares, des écritures historiques et de nouveaux emoji.
Le codage est passé de la question de « peut-il être représenté » à « comment le stocker et le transmettre efficacement ».
autres extensionsSi vous démarrez un nouveau projet aujourd'hui, choisir UTF-8 ne posera pas de problème. C'est un schéma d'encodage rétrocompatible avec ASCII, multiplateforme et prenant en charge toutes les langues. La seule chose à noter est—assurez-vous que toute votre pile (frontend, backend, base de données) utilise UTF-8, et ne mélangez pas.