文字の表現方法 -- ASCII と Unicode
この講義で理解できること:文字が数値しか保存できないコンピュータでどのように表現されるか、そして時々ファイルを開くと文字化けが発生する理由。
生活に馴染みのある例え:部屋番号
128の部屋がある建物を想像してみてください。
フロントは「プレジデントスイート」「ガーデンルーム」のような名前で部屋を管理しません。
各部屋に番号を割り当てます:101, 102, 103...
番号101を調べるとわかります:ああ、それはスタンダードダブルルームだと。
コンピュータが文字を処理するときもまったく同じ考え方を使います:
各文字に数字の番号を割り当てる、そしてその数字を保存・処理します。
この「番号割り当て方式」が文字エンコーディングです。
ASCII:すべてのエンコーディングの出発点
ASCII(American Standard Code for Information Interchange、アメリカ情報交換標準コード)は1963年に誕生しました。
7ビットで1文字を表し、合計 2^7 = 128 文字を表現できます。
内容:
- 制御文字(0〜31):復帰、改行、バックスペースなどの不可視文字
- 表示可能文字(32〜126):スペース、句読点、数字 0-9、大文字 A-Z、小文字 a-z
- DEL 削除文字(127)
ASCII 完全テーブル(0〜127)
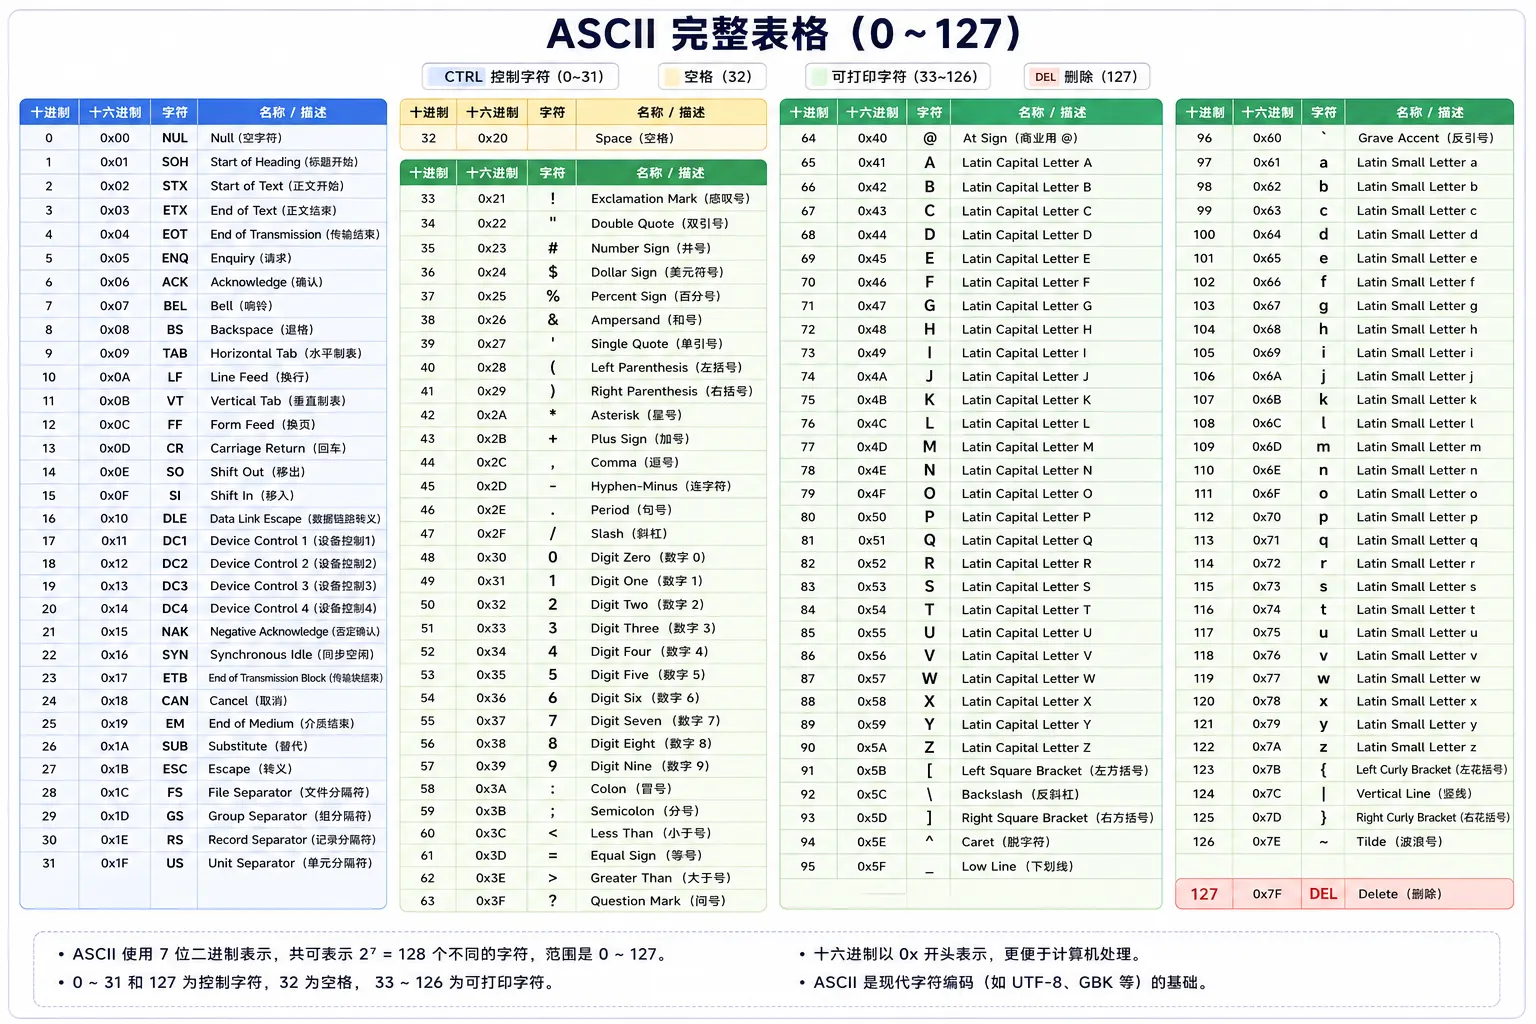
ASCII のいくつかの重要な位置づけ
| 文字の種類 | ASCII 範囲 | 特徴 |
|---|---|---|
| '0' ~ '9' | 48 ~ 57 (0x30 ~ 0x39) | 数字の 0 のエンコーディングは 48 であり、0 ではありません |
| 'A' ~ 'Z' | 65 ~ 90 (0x41 ~ 0x5A) | 大文字は連続して並んでいる |
| 'a' ~ 'z' | 97 ~ 122 (0x61 ~ 0x7A) | 小文字は連続して並んでいる |
| 改行 '\n' | 10 (0x0A) | LF、Unix/Mac の改行 |
| 復帰 '\r' | 13 (0x0D) | CR、旧型 Mac の改行 |
大文字と小文字の巧妙な関係
大文字 'A' (65) と小文字 'a' (97) の2進数表現に注目してください:
'a' = 01100001
第5ビットだけが異なります(値 = 32、ビット番号は右から左へ、0から数えます)
これは偶然ではありません。
2進数のレベルで第5ビットを0から1に変えると、そのまま大文字から小文字への変換が完了します。
この巧妙な設計により、初期のテレタイプライターは簡単な回路だけで大文字と小文字のモードを切り替えられました。
第5ビットは、右から左へ0から番号を付けるビット位置で計算されます(つまりLSBが第0位)、これはコンピュータで最も一般的なビット番号方式です:
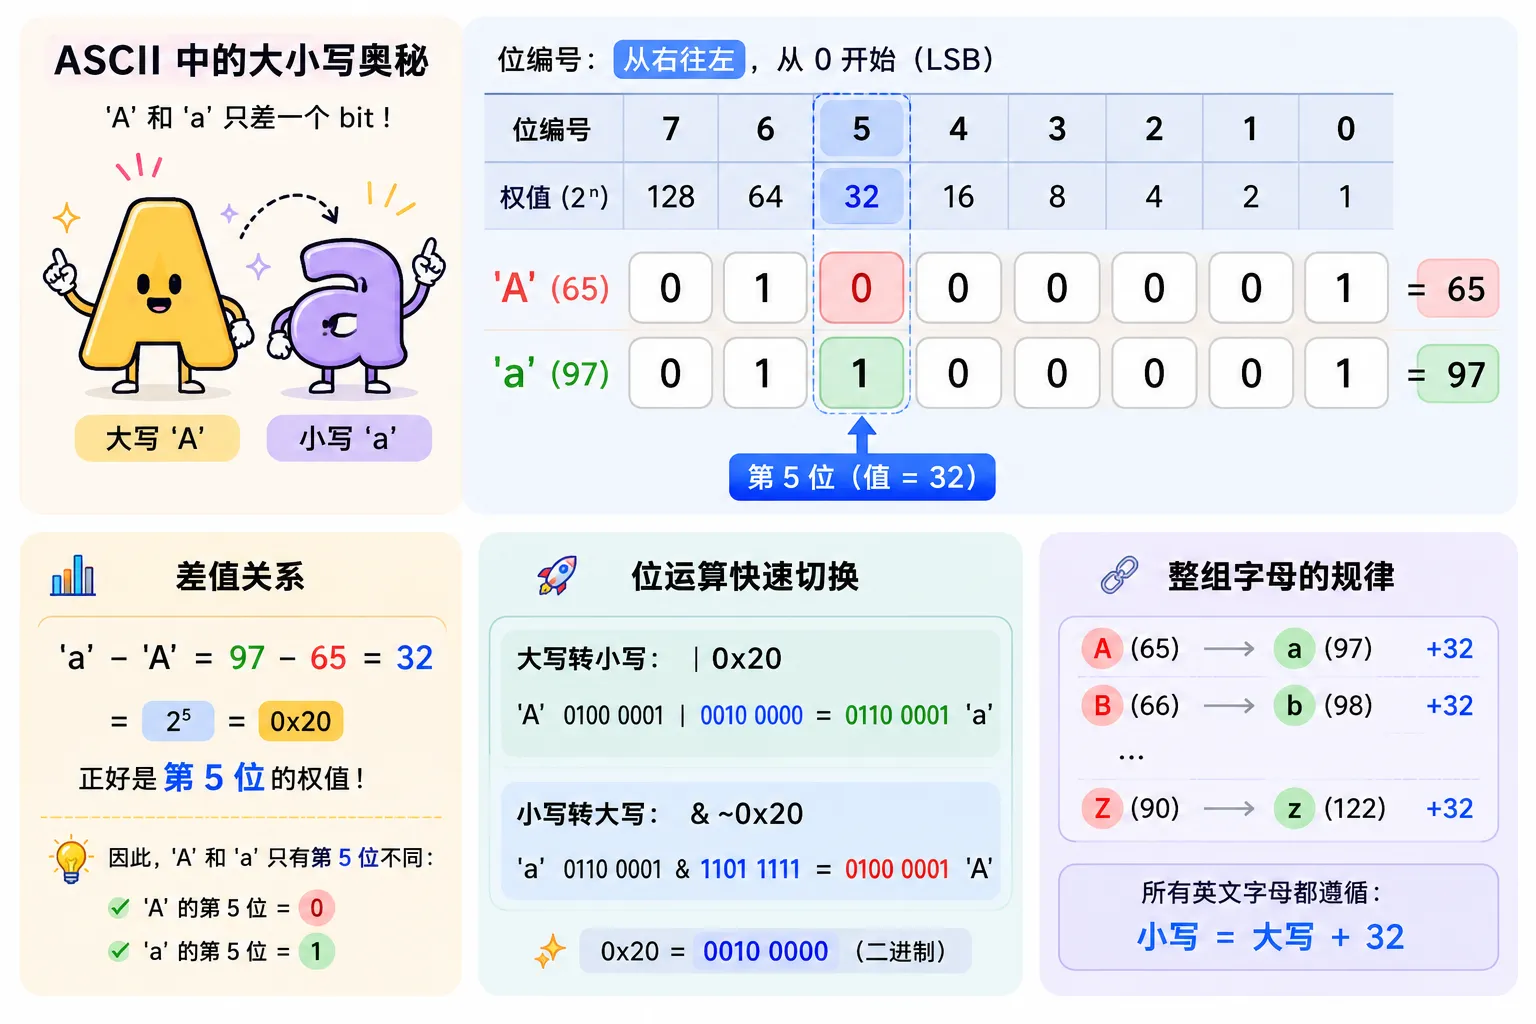
大文字と小文字は32差なので、ASCIIレベルでは、
'a' - 'A' = 32,'A' | 0x20 = 'a'(ビット演算で大文字小文字を切り替える)。これはすべてASCIIエンコーディング表の巧妙な配置に由来します。
ASCII の限界:1バイトでは足りない
ASCIIは128文字しかなく、英語には十分です。
しかしコンピュータがヨーロッパに広がると、問題が発生しました:
フランス語には é、ドイツ語には ü、スペイン語には ñ があります——これらのアクセント記号付きの文字は、ASCIIにはまったくありません。
そこで各国は「パッチを当てる」ように——ASCIIで使われていない128〜255の領域(第8ビットを1にする)を使いました:
- 西ヨーロッパ:ISO-8859-1(Latin-1)、é、üなどの西ヨーロッパ文字を追加
- 東ヨーロッパ:ISO-8859-2、スラブ文字を追加
- ギリシャ:ISO-8859-7、ギリシャ文字を追加
- 中国:GB2312/GBK、2バイトで1つの漢字を表す
- 日本:Shift-JIS
- 韓国:EUC-KR
これは災難になりました——同じバイナリデータでも、異なるエンコーディングで解釈するとまったく異なる文字になります。
日本語の文書を開いたら文字化けした?それはエンコーディング不一致の典型的な症状です。
Unicode:世界中のすべての文字に一意の番号を割り当てる
Unicode の目標は単純でありながら壮大です:
世界のあらゆる文字に一意の数字番号(コードポイント)を割り当てる。
Unicode は16ビットではありません——そのコードポイント範囲は U+0000 から U+10FFFF で、100万以上の文字を収容できます。
現在、約15万文字が割り当てられており、ほとんどすべての人類の書記体系と絵文字をカバーしています。
Unicode コードポイントの例
| 文字 | Unicode コードポイント | 意味 | 所属ブロック |
|---|---|---|---|
| A | U+0041 | ラテン大文字 A | 基本ラテン文字(ASCIIと互換) |
| 你 | U+4F60 | CJK 漢字「你」 | CJK統合漢字 |
| 好 | U+597D | CJK 漢字「好」 | CJK統合漢字 |
| hello | U+68D2 | アラビア語の「こんにちは」 | アラビア文字 |
| サンプル | U+E0001 | 言語タグ | Tags ブロック |
注意:Unicode はあくまで「番号割り当て方式」です——「文字 X の番号は U+XXXX」と教えてくれます。
それは「番号 U+XXXX をファイルにどう保存するか」を規定しません。
ファイルへの保存は UTF-8、UTF-16 といった「エンコーディング方式」の役割です。
多くの人が Unicode と UTF-8 を混同しています。この区別を覚えておきましょう:Unicode は辞書(どの文字がどの番号に対応するかを定義)、UTF-8 は書き方の規則(番号をどうバイト列に書き表すかを規定)です。
UTF-8:最も普及しているUnicodeエンコーディング方式
UTF-8 の設計は非常に巧妙です。それは一種の可変長エンコーディング:
- ASCII 文字(U+0000 ~ U+007F):1バイトで保存
- ほとんどのヨーロッパ・アラビア文字:2バイト
- 中国語、日本語、韓国語:3バイト
- 補助文字(ほとんどの絵文字を含む):4バイト
UTF-8 エンコーディング規則
最初のバイトの先頭ビットパターンデコーダにこの文字が何バイトで保存されているかを伝えます。
- 0 で始まる:1バイト文字
- 110 で始まる:2バイト文字
- 1110 で始まる:3バイト文字
- 11110 で始まる:4バイト文字
- 後続のバイトはすべて 10 で始まる
UTF-8 の最大の利点:ASCII と完全互換。
正規のASCIIテキストは、同時に正規のUTF-8テキストでもあります。
この特性により、UTF-8 は既存のデータを壊すことなく、古いASCIIシステムをスムーズに置き換えることができます。
インタラクティブデモ:エンコーディングリアルタイム検索
下の欄に任意の文字を入力して、各文字のUnicodeコードポイント、UTF-8エンコードバイト、および占有容量を確認できます。
操作のヒント:
- 純粋な英語を入力して、各文字が1バイトしか占めないことを観察してください。
- 中国語を入力して、各漢字が3バイト占めることを観察してください。
- 入力
Hello サンプル、各字母のASCIIコードが連続して並んでいるかに注意してください。 - 大文字と小文字のアルファベットの2進数を比較し、1ビットだけ異なる対応する文字ペア(A と a など)を見つけます。
文字化け問題:原理と予防
文字化けの本質はただ一言:間違った辞書でデータを解釈したこと。
あるファイルにUTF-8でエンコードされた3バイトが保存されていると仮定します:E4 BD A0
- UTF-8でデコード:この3バイトが1文字を構成する → 「你」
- GBKでデコード:E4 BDがGBKの2バイト文字として扱われる → 無関係の漢字の可能性がある
- Latin-1でデコード:E4、BD、A0が3つの独立した西欧文字として扱われる → 「a + 1/2 + nbsp」のような文字化け
同じバイナリでも、3つの辞書で3つの異なる文字が読み出される。
文字化けを防ぐには?
- UTF-8に統一する:現代のWeb、API、データベースはほぼすべてデフォルトでUTF-8です
- エンコーディングを明示的に宣言する:HTMLには次のように書きます
<meta charset="UTF-8">、HTTPレスポンスヘッダーには次のように書きますContent-Type: text/html; charset=utf-8 - エディタの設定:VS Code、Sublimeなどのエディタは、ファイルエンコーディングをUTF-8に設定することをサポートしています
BOM(バイトオーダーマーク)の問題
UTF-8はバイト単位であるためバイトオーダーを考慮する必要はありませんが、一部のWindowsプログラムはUTF-8ファイルの先頭にBOMを追加します:EF BB BF。
この3バイトは「このファイルはUTF-8エンコーディングである」ことを示すためのものです。
しかしUnix/Linuxシステムでは、BOMがさまざまな問題を引き起こす可能性があります:
- シェルスクリプトの先頭行の
#!/bin/bash先頭に3バイトの不可視文字が付加されるため、スクリプトが実行できなくなります - PHPファイルにBOMがあると、「headers already sent」エラーが発生する可能性があります
- JSONパーサーがBOMで始まるJSONデータを拒否する可能性があります
推奨:UTF-8ファイルは「BOMなし」形式(UTF-8 without BOM)を使用します。これもほとんどの最新エディタのデフォルト設定です。
コードデモ:エンコードとデコード
実例
import sys
# =============================================
# デモ 1: ord() と chr() の基本的な使い方
# =============================================
print("=" * 60)
print("デモ 1: 文字とコードポイントの相互変換")
print("=" * 60)
# ord() は文字のUnicodeコードポイントを取得する
text = "Hello サンプル"
for ch in text:
cp = ord(ch)
print(f" '{ch}' → コードポイント U+{cp:04X} (10進数 {cp})")
print()
# chr() はコードポイントから文字を取得する
for cp in [65, 97, 48, 0x4F60, 0x597D]:
ch = chr(cp)
print(f" コードポイント U+{cp:04X} → 文字 '{ch}'")
# =============================================
# デモ 2: バイトシーケンスへのエンコード (encode)
# =============================================
print("\n" + "=" * 60)
print("デモ 2: 文字列 → UTF-8バイトシーケンス")
print("=" * 60)
texts = ["A", "Hello", "你好", "サンプル チュートリアル"]
for text in texts:
utf8_bytes = text.encode('utf-8')
hex_str = utf8_bytes.hex(' ').upper()
print(f"\n"テキスト: '{text}'")
print(f" 文字数: {len(text)}")
print(f" UTF-8バイト数: {len(utf8_bytes)}")
print(f" UTF-8 16進数: {hex_str}")
# バイトごとの分析
print(f" バイト分解:")
for i, b in enumerate(utf8_bytes):
bin_str = format(b, '08b')
# バイトタイプを判定する
if b < 0x80:
typ = "ASCII 1バイト"
elif b >= 0xC0 and b < 0xE0:
typ = "2バイト文字の先頭バイト"
elif b >= 0xE0 and b < 0xF0:
typ = "3バイト文字の先頭バイト"
elif b >= 0x80 and b < 0xC0:
typ = "後続バイト"
else:
typ = "その他"
print(f" バイト {i}: 0x{b:02X} = {bin_str} ({typ})")
# =============================================
# デモ 3: GBKエンコーディング(中国で一般的な非Unicodeエンコーディング)
# =============================================
print("\n" + "=" * 60)
print("デモ 3: GBKエンコーディング(UTF-8との比較)")
print("=" * 60)
text = "你好 サンプル"
utf8_bytes = text.encode('utf-8')
gbk_bytes = text.encode('gbk')
print(f"テキスト: '{text}'")
print(f" UTF-8 ({len(utf8_bytes)} バイト): {utf8_bytes.hex(' ').upper()}")
print(f" GBK ({len(gbk_bytes)} バイト): {gbk_bytes.hex(' ').upper()}")
# GBKでは各漢字は2バイトを占める
print(f"\n"注意:GBKでは漢字は2バイト、UTF-8では漢字は3バイト")
print(f" 中国語テキストの場合、GBKはUTF-8よりコンパクトです")
print(f" ただしGBKはすべてのUnicode文字(emojiなど)をサポートしていません")
# =============================================
# デモ 4: デコードエラーのシナリオ
# =============================================
print("\n" + "=" * 60)
print("デモ 4: デコードエラーのシナリオ(文字化けの原因)")
print("=" * 60)
# 中国語をUTF-8でエンコードする
original = "你好"
utf8_data = original.encode('utf-8')
print(f"元のテキスト: '{original}'")
print(f"UTF-8エンコード: {utf8_data.hex(' ').upper()}")
# エラー 1: UTF-8データをGBKでデコードする
try:
decoded_wrong = utf8_data.decode('gbk')
print(f"GBKでデコード: '{decoded_wrong}' (文字化け!)")
except Exception as e:
print(f"GBKでのデコード失敗: {e}")
# エラー 2: Latin-1でデコードする
decoded_latin = utf8_data.decode('latin-1')
print(f"Latin-1でデコード: '{decoded_latin}' (西欧文字のように見える文字化け)")
# =============================================
# デモ 5: 適切なデコーダーを作成する
# =============================================
print("\n" + "=" * 60)
print("デモ 5: エンコーディングの検出と安全なデコード")
print("=" * 60)
def safe_decode(data, encodings=['utf-8', 'gbk', 'latin-1']):
"""複数のエンコーディングでデコードを試み、最初に成功した結果を返す"""
for enc in encodings:
try:
return data.decode(enc), enc
except (UnicodeDecodeError, LookupError):
continue
return data.decode('latin-1', errors='replace'), 'latin-1 (fallback)'
# テスト
test_cases = [
"Hello サンプル".encode('utf-8'),
"你好世界".encode('utf-8'),
"计算机".encode('gbk'),
]
for data in test_cases:
result, encoding = safe_decode(data)
print(f" データ ({len(data)} バイト) を {encoding} でデコード: '{result}'")
print("\n" + "=" * 60)
print("まとめ:文字列はPythonの内部表現であり、エンコーディングは保存・転送時の形式です。")
print("常にI/O境界でエンコーディング変換を行い、内部では常にstr型を使用します。")
print("=" * 60)
文字エンコーディングの現状と未来
今日現在、UTF-8はインターネットの事実上の標準になっています。
98%以上のWebページがUTF-8エンコーディングを使用しています。
JSON仕様はUTF-8を要求しています。
ほとんどすべての現代的なプログラミング言語はデフォルトでUTF-8を使用してテキストを処理します。
Unicodeは今も拡張を続けています。
新しいバージョンのUnicodeは毎年新しい文字を追加しています。例:珍しい文字、歴史的文字、新しいemoji。
エンコーディングは「表現できるかどうか」という問題から、「効率的に保存・転送する方法」という問題に変わりました。
その他の拡張今日新しいプロジェクトを始めるなら、UTF-8を選べば間違いありません。UTF-8はASCIIと後方互換性があり、クロスプラットフォームで、全言語をサポートするエンコーディング方式です。唯一注意すべき点は——フルスタック(フロントエンド、バックエンド、データベース)でUTF-8を使用し、混在させないことです。