Общие математические символы
Первое препятствие к пониманию статей и руководств по ИИ — часто не сама математика, а страницы, заполненные математическими символами.
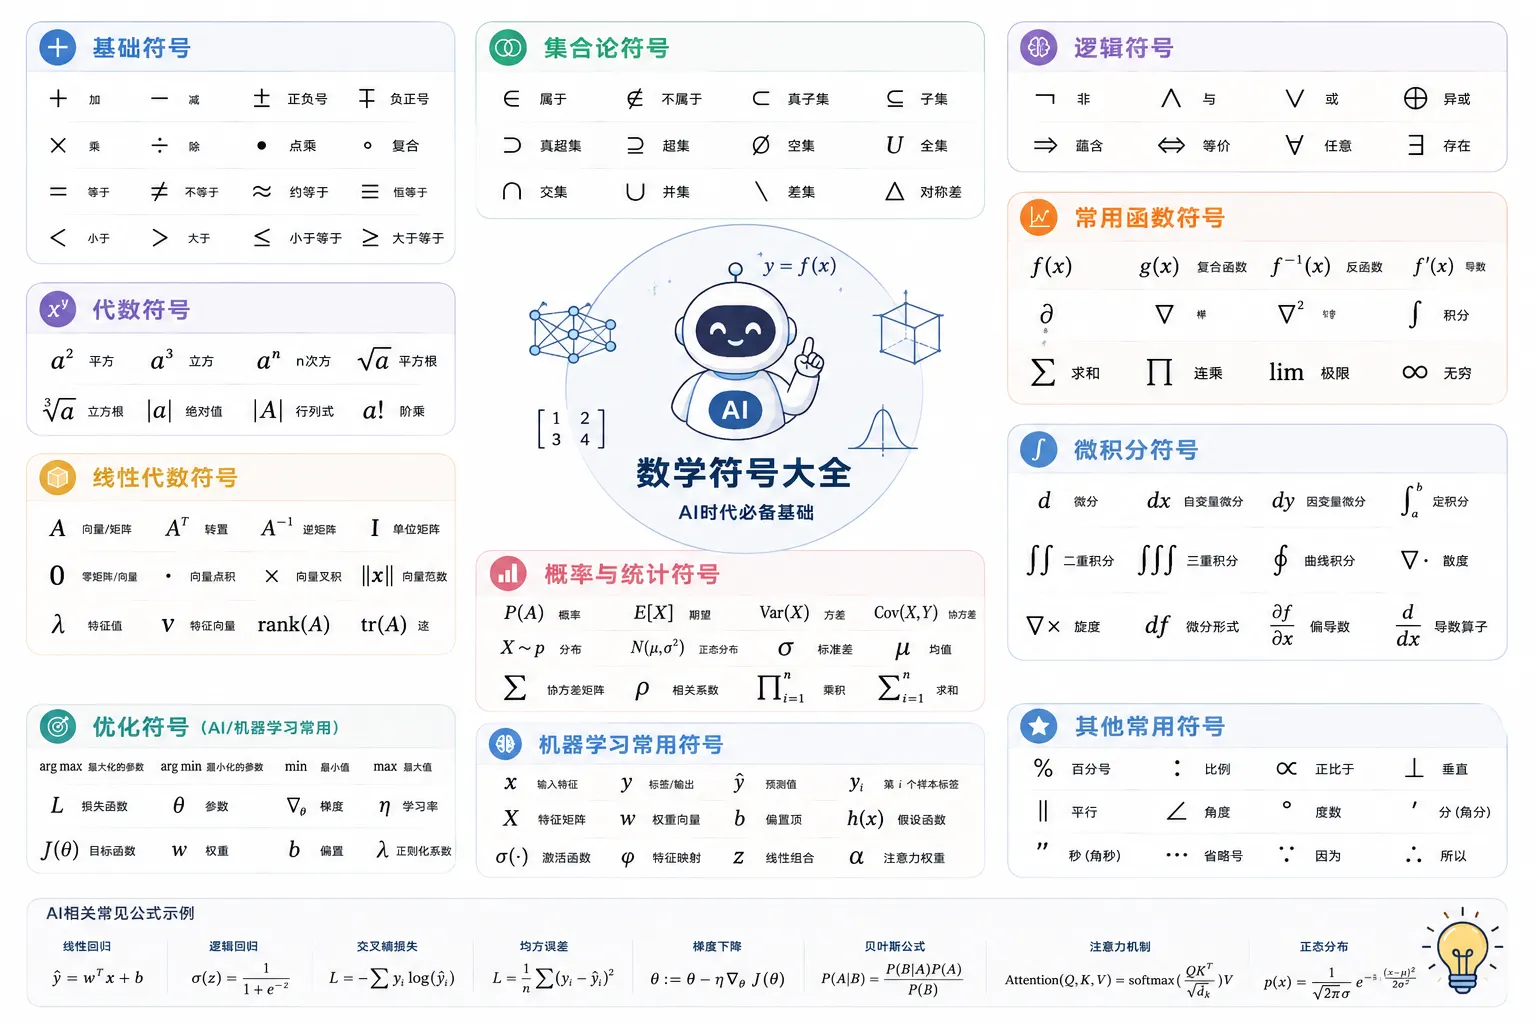
В этой главе наиболее часто используемые в изучении ИИ символы собраны в таблицы. Можно сначала бегло их просмотреть, а позже вернуться, когда понадобится что-то уточнить:
-
Читайте по порядкуК каждому символу прилагается пояснение, когда он используется; пройдитесь по ним в общих чертах, чтобы создать общее представление.
-
Справляйтесь по мере необходимостиЕсли при чтении статей или руководств вы застряли на каком-то символе, вернитесь к таблице.
К большинству символов прилагаются исполняемые примеры на Python. Один раз попробовать самому эффективнее, чем десять раз прочитать.
Числа и основные операции
Эти символы используются ещё с математики начальной школы и являются основой всех формул.
| Символ | Значение | Пример |
|---|---|---|
| Сложение, вычитание, умножение и деление | ||
| Знак плюс-минус, указывающий на два возможных значения | ||
| Не равно | ||
| Меньше, больше, меньше или равно, больше или равно | ||
| Приблизительно равно | ||
| Модуль, убирает знак минус | ||
| Квадратный корень | ||
| Корень n-й степени | ||
| Квадрат, n-я степень | ||
| Обратная величина (отрицательная степень) | ||
| Факториал, умножение от 1 до n | ||
| Бесконечность |
В научных статьях знак умножения обычно опускают или записывают в виде маленькой точки:Означает w, умноженное на x; обе записи имеют абсолютно одинаковое значение.
Переменные и соглашения о буквенных обозначениях
В математике буквы выбираются не произвольно; разные буквы имеют роли по умолчанию.
| Буква | Роль по умолчанию | Типичное значение в контексте ИИ |
|---|---|---|
| Константа | Фиксированный, неизменный коэффициент | |
| Переменная | x — входной признак, y — выходная метка | |
| Веса и смещения | Параметры, которые должна изучить нейронная сеть | |
| Набор параметров | Собирательное название для всех параметров модели, произносится как тета | |
| Величина | Количество выборок, размерность признаков | |
| Пи | ||
| Число Эйлера |
Когда используются и x, и X, будьте внимательны, чтобы различать:Строчная буква обычно обозначает одно число (скаляр), прописная обычно обозначает матрицуЭто будет подробно объяснено в разделе о строчных буквах.
Когда вы видитеНе паникуйте, это просто традиционное обозначение «параметра», иПринципиальной разницы нет; то, какой из них выберет автор статьи, — исключительно вопрос предпочтения.
Экспоненты и логарифмы
Самая распространённая пара функций в ИИ.
Встречается в sigmoid и softmax, отвечает за «усиление или сжатие» значений;Встречается в кросс-энтропийной потере, отвечает за «превращение умножения в сложение».
| Символ | Значение | Пример |
|---|---|---|
| a в n-й степени | ||
| Любое ненулевое число в степени 0 | ||
| Экспоненциальная функция с основанием e | ||
| Логарифм x по основанию a | ||
| Натуральный логарифм (по основанию e) | ||
| В статьях обычно по умолчанию используется |
Четыре арифметических правила необходимо освоить; они многократно используются при выводе функций потерь:
Формула перехода к новому основанию позволяет преобразовать логарифм по любому основанию в натуральный логарифм; она часто используется в программировании:
Примеры
# Python-функция math.log(x, base) делает это внутри
import math
x = 100
base = 2
# Прямой вызов
print(math.log(x, base))
# Формула перехода к новому основанию, написанная от руки: log_2(100) = ln(100) / ln(2)
print(math.log(x) / math.log(base))
Вывод вышеприведённого кода:
6.643856189774725
6.643856189774725
Почему добавляют небольшую константу ε: Аргумент логарифма должен быть больше 0, но на ранней стадии обучения модель может выдавать вероятность 0; в этот моментвы получаете отрицательную бесконечность, что приводит к краху обучения.
Поэтому в реализациях это обычно записывают как, где— очень маленькое положительное число, например 0.0000001.
Символы, связанные с функциями
Функция — это «правило соответствия от входа к выходу»; нейронная сеть по сути представляет собой композицию многих слоёв функций.
| Символ | Значение | Пример / Пояснение |
|---|---|---|
| Функция; результат, полученный после отображения x функцией f | ||
| f отображает элементы множества A во множество B | Опишите «сигнатуру типа» функции. | |
| Обратная функция, отменяет действие f. | ||
| Композиция функций: сначала вычислите g(x), затем подставьте в f. | ||
| Изменение x. | ||
| Предсказанное значение y (читается как y-hat). | Чтобы отличать от истинной метки y. | |
| сигмоидная функция активации. |
В машинном обучении,(читается как y-hat) конкретно обозначает предсказанное значение модели,обозначает истинную метку; разница между ними — это ошибка предсказания.
Композиции функций — ключ к пониманию нейронных сетей: двухслойная сеть по сути представляет собой, обратное распространение вычисляет градиенты слой за слоем, опираясь именно на правило цепочки для дифференцирования композиций функций.
Примеры
# Пусть g(x) = x + 1, f(x) = x^2
def g(x):
return x + 1 # Внутренняя функция
def f(x):
return x ** 2 # Внешняя функция
# Композиция: сначала вычислить g(x), затем подставить результат в f
print(f(g(3))) # g(3)=4, f(4)=16
print(f(g(3)) == (3 + 1) ** 2)
При выполнении приведённого выше кода выводится:
16
True
Суммирование и произведение
являются самыми часто встречающимися символами в формулах ИИ, вне конкуренции.
Это означает: пусть нижний индекс i изменяется от нижней границы до верхней, а затем просуммировать каждое слагаемое.
Читается как «i от 1 до n, сумма по x с нижним индексом i». Читайте выражение суммирования в три шага:
| Шаги | На что смотреть | В этом примере |
|---|---|---|
| 1 | По какой переменной выполняется суммирование (нижний индекс) | i |
| 2 | Диапазон суммирования (от нижней границы до верхней) | от 1 до n |
| 3 | Как выглядит каждый член |
Символ произведенияСтруктура та же, только замените "сложение" на "умножение":
Две самые распространённые формулы в ИИ строятся на суммировании:
Потеря среднеквадратичной ошибки:
Взвешенная сумма нейрона:
Примеры
w = [0.5, -1.0, 2.0] # Веса, соответствующие w_i в формуле
x = [2.0, 3.0, 1.0] # Входы, соответствующие x_i в формуле
b = 0.1 # Смещение
# sum_{i=1}^{3} w_i * x_i — это ровно следующая строка
z = sum(wi * xi for wi, xi in zip(w, x)) + b
print(z)
# Развёрнутая проверка: 0.5*2 + (-1.0)*3 + 2.0*1 + 0.1
print(0.5*2 + (-1.0)*3 + 2.0*1 + 0.1)
При выполнении приведённого выше кода выводится:
0.1
0.1
Множества и логика
Символы множеств описывают, «к какой категории относятся данные», символы логики описывают, «как комбинируются условия», а теория вероятностей и машинного обучения широко их используют.
| Символ | Значение | Пример |
|---|---|---|
| принадлежит | ||
| не принадлежит | ||
| подмножество | ||
| объединение | ||
| пересечение | ||
| пустое множество (не содержит элементов) | ||
| множество вещественных чисел | ||
| произвольный, все (квантор всеобщности) | ||
| существует (квантор существования) | ||
| логическое НЕ | ||
| логическое И, логическое ИЛИ | ||
| влечёт, импликация | ||
| эквивалентно (если и только если) |
Эти символы чаще всего встречаются в разделах теорем и предположений статей, например,читается как "для любого эпсилона, большего 0, существует N".
Верхние индексы, нижние индексы и диапазоны значений
В этом разделе разъясняются две распространённые путаницы: что на самом деле означают нижние индексы и как читать запись интервалов.
Нижний индекс: нумерация переменных одного типа
В обучающих данных много примеров; использовать x для всех сбивало бы с толку, поэтому для их различения используются нижние индексы:。
Когда есть два нижних индекса, например, это обычно означает "i-я строка и j-й столбец", что как раз и является элементом матрицы.
Вектор записывается как(жирным), его компоненты равны; матрицаЕё форма описывается как "строки × столбцы", обозначается как。
Интервалы и диапазоны значений
Круглые скобки означают "концы не включены", а квадратные скобки означают "концы включены".
| Символ | Чтение | Значение |
|---|---|---|
| Открытый интервал | Все числа между a и b, исключая оба конца | |
| Замкнутый интервал | Все числа между a и b, включая оба конца | |
| Полуоткрытый интервал | Включает b, исключает a | |
| x принадлежит замкнутому интервалу | x принимает значения между 0 и 1, концы допускаются |
Область значений сигмоидной функции равна, этот открытый интервал означает, что выход всегда строго больше 0 и меньше 1, и именно это является математической причиной, по которой её можно использовать как "вероятность".
Таблица греческого алфавита
Многочисленные греческие буквы в статьях — не украшение; каждая имеет значение по умолчанию. Знание их всех сделает чтение статей намного проще.
| Верхний регистр | Нижний регистр | Name | Распространённые значения в ИИ |
|---|---|---|---|
| альфа | Скорость обучения | ||
| бета | Коэффициент импульса, скорость затухания второго момента в Adam | ||
| гамма | Коэффициент дисконтирования (обучение с подкреплением) | ||
| дельта | Изменение, приращение | ||
| эпсилон | Крошечное положительное число, вероятность исследования | ||
| тета | Параметры модели | ||
| lambda | Коэффициент регуляризации | ||
| пи | Политика (обучение с подкреплением), пи | ||
| сигма | Суммирование / сигмоидная функция, стандартное отклонение | ||
| фи | Функция отображения признаков | ||
| омега | Веса модели (в некоторых работах) |
Один и тот же символ имеет разные значения в разных областях:В контексте функции активации это сигмоида, в статистическом контексте это стандартное отклонение, а в формулах суммирования прописная— это оператор суммирования. Чтобы понять значение, сначала посмотрите на контекст — это самая важная привычка при чтении статей.
Вероятность и статистика
Основной язык машинного обучения. «Уверенность», выдаваемая моделями классификации, вывод функций потерь и байесовские методы — всё это построено на этих символах.
| Символ | Значение | Пример / Пояснение |
|---|---|---|
| Вероятность наступления события A | ||
| Условная вероятность: вероятность A при условии B | Вертикальная черта читается как «при условии» | |
| Совместная вероятность: A и B происходят одновременно | ||
| Теорема Байеса | Основа всех байесовских методов | |
| Ожидание (среднее) | ||
| Дисперсия (степень разброса) | ||
| Среднее | Центр распределения данных | |
| Дисперсия (сигма в квадрате) | ||
| Подчиняется ... распределению | ||
| Нормальное распределение (распределение Гаусса) | В скобках указаны среднее значение и дисперсия | |
| Информационная энтропия |
Потери кросс-энтропии — это кульминация этих символов, объединяющая суммирование, условную вероятность и логарифм:
Разбираем символ за символом:— истинная метка i-го образца,— предсказанная моделью вероятность,превращает умножение вероятностей в сложение, а знак минус делает так, что «чем меньше потери, тем лучше».
— это рукописная форма «Normal», обозначающая нормальное распределение, а не букву N. Рукописные символы、часто используются для обозначения «множествоподобных» объектов, таких как распределения, функции потерь и наборы данных.
Линейная алгебра
Базовая структура нейронных сетей. Каждая матричная операция в фреймворках глубокого обучения использует эти символы.
| Символ | Значение | Пример / Пояснение |
|---|---|---|
| Вектор (полужирная строчная буква) | ||
| Матрица (полужирные заглавные буквы) | Таблица чисел с m строками и n столбцами | |
| Транспонирование: поменять местами строки и столбцы | Вектор-строка становится вектором-столбцом | |
| Умножение матриц | Не поэлементное умножение | |
| Поэлементное умножение (произведение Адамара) | Умножение соответствующих позиций матриц одинаковой формы | |
| Норма ("длина" вектора) | ||
| Норма L1: сумма абсолютных значений | Основа L1-регуляризации | |
| Обратная матрица | ||
| Единичная матрица | Диагональные элементы равны 1, все остальные — 0 | |
| Скалярное произведение (внутреннее произведение) |
Скалярное произведение — основа механизма внимания: каждый слой трансформера вычисляет скалярное произведение между векторами запросов и векторами ключей, измеряя их «сходство».
Примеры
# x · y = sum(x_i * y_i),||x||_2 = sqrt(sum(x_i^2))
import math
x = [1.0, 2.0, 3.0]
y = [4.0, 0.0, -1.0]
# Скалярное произведение x · y
dot = sum(xi * yi for xi, yi in zip(x, y))
print(dot)
# Норма L2 ||x||_2
norm2 = math.sqrt(sum(xi ** 2 for xi in x))
print(norm2)
# Раскрыть и проверить
print(1.0*4.0 + 2.0*0.0 + 3.0*(-1.0))
print(math.sqrt(1 + 4 + 9))
Выполнение приведённого выше кода даёт следующий вывод:
1.0
3.7416573867739413
1.0
3.7416573867739413
Математический анализ
Суть обучения — «корректировка параметров в направлении, противоположном градиенту», поэтому разделы оптимизации в статьях не могут обойтись без этих символов.
Вам пока не нужно уметь их вычислять; достаточно уметь распознавать каждый из них.
| Символ | Значение | Пример / Описание |
|---|---|---|
| Производная: скорость изменения y относительно x | ||
| Альтернативное обозначение производной | ||
| Частная производная: скорость изменения f, когда изменяется только x | Используется для функций нескольких переменных | |
| Градиент: вектор всех частных производных | ||
| Интеграл — операция, обратная дифференцированию | ||
| Предел: значение, когда x стремится к a |
Самая важная формула в глубоком обучении использует только две строки из приведённой выше таблицы: правило обновления параметров для градиентного спуска.
Разбор каждого символа:— это параметр,означает «обновить левую часть значением справа»,— это скорость обучения,— это градиент функции потерь J по параметру θ.
В одном предложении:новый параметр = старый параметр − скорость обучения × градиент, то есть сделать небольшой шаг в направлении, в котором потери убывают быстрее всего.
Читается как набла или «оператор градиента»: это не число, а указание взять частные производные по всем следующим за ним переменным, во многом подобно функции высшего порядка в программировании.
Оптимизация и другие часто встречающиеся символы
В этом последнем разделе рассматриваются символы, которые встречаются в статьях лишь изредка, но тем не менее критически важны.
| Символ | Значение | Пример / Описание |
|---|---|---|
| x, максимизирующий f | возвращает x, а не само максимальное значение | |
| x, минимизирующий f | Обучение — это нахождение | |
| минимума f | возвращает само значение | |
| функция softmax | ||
| композиция функций | ||
| определяется как | левая часть определяется как значение справа | |
| пропорционально | ||
| функция активации ReLU | ||
| Нотация Big O: порядок роста | Игнорируйте константы, смотрите только на масштаб. |
То, что модель классификации делает во время прогнозирования, — это ровно: взять класс с наибольшей вероятностью; argmax возвращает индекс класса, а не значение вероятности.
иЛегко перепутать:Ответ «чему равно максимальное значение»,Ответ «при каком x достигается максимум». В задачах классификации важен последний вариант.
Советы по изучению
Не нужно заучивать таблицы символов наизусть; методы эффективнее зубрёжки.
Во-первых, выработайте привычку разбирать символы по одному: получив формулу, сначала спросите, является ли каждый символ оператором, переменной или функцией, а затем — что он означает в текущем контексте. После такого разбора она часто перестаёт быть загадочной.
Во-вторых, в первую очередь досконально освойте три вещи:суммирование, степени и логарифмы, запись с нижними индексами. Они необходимы для чтения формул линейной алгебры и математического анализа. Для каждой из них в этой статье есть отдельный раздел.
В-третьих, столкнувшись с незнакомым символом, сразу ищите "название символа + математическое значение" — это быстрее, чем продираться через учебники.
Другие расширенияСимволы — это карта, а не местность. Истинное понимание приходит через вычисление конкретных примеров с ними; каждый пример на Python в тексте стоит запустить вручную.