Häufige mathematische Symbole
Die erste Hürde beim Verstehen von KI-Papers und Tutorials ist oft nicht die Mathematik selbst, sondern die Seiten voller mathematischer Symbole.
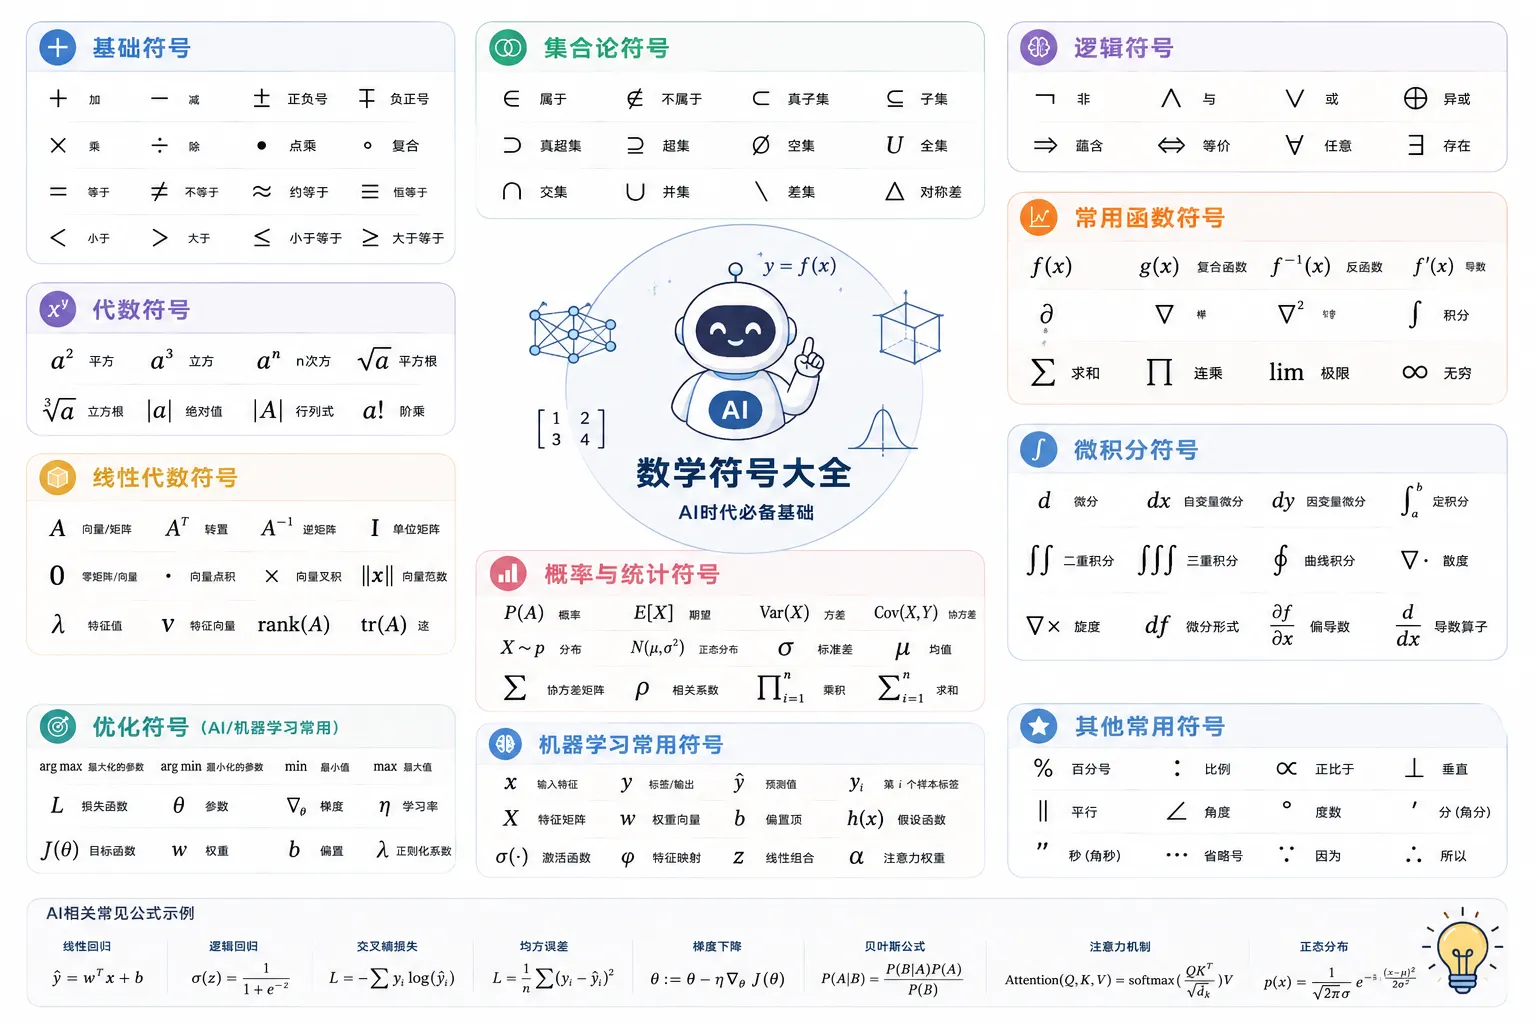
Dieses Kapitel ordnet die am häufigsten verwendeten Symbole beim KI-Lernen in Tabellen. Du kannst sie zuerst überfliegen oder später zurückkommen, wenn du etwas nachschlagen musst:
-
In der Reihenfolge lesenZu jedem Symbol gibt es eine Erklärung, wann es verwendet wird; gehe sie grob durch, um einen Gesamteindruck zu gewinnen.
-
Bei Bedarf nachschlagenWenn du beim Lesen von Papers oder Tutorials an einem Symbol hängen bleibst, komm zur Tabelle zurück.
Zu den meisten Symbolen gibt es ausführbare Python-Beispiele. Sie einmal selbst auszuprobieren ist effektiver, als sie zehnmal zu lesen.
Zahlen und grundlegende Operationen
Diese Symbole werden seit der Grundschulmathematik verwendet und sind die Grundlage aller Formeln.
| Symbol | Bedeutung | Beispiel |
|---|---|---|
| Addition, Subtraktion, Multiplikation und Division | ||
| Plus-Minus-Zeichen, das zwei mögliche Werte anzeigt | ||
| Ungleich | ||
| Kleiner als, größer als, kleiner oder gleich, größer oder gleich | ||
| Ungefähr gleich | ||
| Absolutwert, entfernt das negative Vorzeichen | ||
| Quadratwurzel | ||
| n-te Wurzel | ||
| Quadrat, n-te Potenz | ||
| Kehrwert (negativer Exponent) | ||
| Fakultät, multipliziert von 1 bis n | ||
| Unendlich |
In Fachartikeln wird das Multiplikationszeichen meist weggelassen oder als kleiner Punkt geschrieben:Steht für w multipliziert mit x; die beiden Schreibweisen haben genau dieselbe Bedeutung.
Variablen und Buchstabenkonventionen
In der Mathematik werden Buchstaben nicht willkürlich gewählt; verschiedene Buchstaben haben feste Standardrollen.
| Buchstabe | Standardrolle | Typische Bedeutung im KI-Kontext |
|---|---|---|
| Konstante | Ein fester, unveränderlicher Koeffizient | |
| Variable | x ist das Eingabe-Feature, y ist das Ausgabe-Label | |
| Gewichte und Bias-Werte | Parameter, die das neuronale Netz lernen muss | |
| Parametersatz | Sammelbegriff für alle Parameter des Modells, ausgesprochen Theta | |
| Anzahl | Anzahl der Stichproben, Merkmalsdimension | |
| Pi | ||
| Eulersche Zahl |
Wenn sowohl x als auch X verwendet werden, genau unterscheiden:Kleinschreibung bezeichnet normalerweise eine einzelne Zahl (Skalar), Großschreibung normalerweise eine MatrixDies wird im Abschnitt zur Kleinschreibung näher erläutert.
Wenn Siesehen, geraten Sie nicht in Panik, es ist nur das übliche Symbol für „Parameter“, undEs gibt keinen wesentlichen Unterschied; welches der Autor des Fachartikels wählt, ist reine Geschmackssache.
Exponenten und Logarithmen
Das häufigste Funktionspaar in der KI.
Erscheint in Sigmoid und Softmax und ist für das „Verstärken oder Komprimieren“ von Werten verantwortlich;Erscheint in der Cross-Entropy-Verlustfunktion und ist dafür verantwortlich, „Multiplikation in Addition umzuwandeln“.
| Symbol | Bedeutung | Beispiel |
|---|---|---|
| a hoch n | ||
| Jede von null verschiedene Zahl hoch 0 | ||
| Exponentialfunktion zur Basis e | ||
| Logarithmus von x zur Basis a | ||
| Natürlicher Logarithmus (Basis e) | ||
| In Fachartikeln ist damit normalerweise gemeint |
Die vier Grundrechenarten müssen beherrscht werden; sie werden beim Ableiten von Verlustfunktionen immer wieder verwendet:
Die Basiswechselformel kann einen Logarithmus beliebiger Basis in einen natürlichen Logarithmus umwandeln; sie wird in der Programmierung häufig verwendet:
Beispiele
# Pythons math.log(x, base) macht das intern
import math
x = 100
Basis = 2
# Direkter Aufruf
print(math.log(x, base))
# Handgeschriebene Basiswechselformel: log_2(100) = ln(100) / ln(2)
print(math.log(x) / math.log(Basis))
Die Ausgabe des obigen Codes ist:
6.643856189774725
6.643856189774725
Warum eine kleine Konstante εhinzufügen: Das Argument eines Logarithmus muss größer als 0 sein, aber früh im Training kann das Modell eine Wahrscheinlichkeit von 0 ausgeben; dannerhält man negativ unendlich, was zum Trainingskollaps führt.
Deshalb schreibt man es in Implementierungen üblicherweise als, wobeieine sehr kleine positive Zahl ist, wie 0.0000001.
Funktionsbezogene Symbole
Eine Funktion ist die „Zuordnungsregel von Eingabe zu Ausgabe“; ein neuronales Netz ist im Wesentlichen eine Komposition vieler Funktionsschichten.
| Symbol | Bedeutung | Beispiel / Erklärung |
|---|---|---|
| Funktion; das Ergebnis, nachdem x durch f abgebildet wurde | ||
| f bildet Elemente der Menge A auf die Menge B ab | Beschreibt die „Typsignatur“ einer Funktion. | |
| Umkehrfunktion, hebt die Operation von f auf. | ||
| Zusammengesetzte Funktion: zuerst g(x) berechnen, dann in f einsetzen. | ||
| Die Änderung von x. | ||
| Der vorhergesagte Wert von y (ausgesprochen y-hat). | Zur Unterscheidung vom wahren Label y. | |
| Sigmoid-Aktivierungsfunktion. |
Im maschinellen Lernen bezeichnet(gelesen als y-hat) speziell den vom Modell vorhergesagten Wert,bezeichnet das wahre Label; die Differenz zwischen beiden ist der Vorhersagefehler.
Verkettete Funktionen sind entscheidend für das Verständnis neuronaler Netze: Ein zweischichtiges Netz ist im Wesentlichen, Backpropagation berechnet Gradienten Schicht für Schicht und stützt sich dabei genau auf die Kettenregel zur Differentiation verketteter Funktionen.
Beispiele
# Sei g(x) = x + 1, f(x) = x^2
def g(x):
return x + 1 # Innere Funktion
def f(x):
return x ** 2 # Äußere Funktion
# Komposition: zuerst g(x) berechnen, dann das Ergebnis in f einsetzen
print(f(g(3))) # g(3)=4, f(4)=16
print(f(g(3)) == (3 + 1) ** 2)
Die Ausführung des obigen Codes gibt aus:
16
True
Summation und Produkt
sind die am häufigsten vorkommenden Symbole in KI-Formeln, ohne Ausnahme.
Es bedeutet: Der Index i läuft von der unteren Grenze zur oberen Grenze, und jeder Term wird aufsummiert.
Lies als „i von 1 bis n, Summe über x mit Index i“. Einen Summenausdruck liest man in drei Schritten:
| Schritte | Worauf man achten muss | In diesem Beispiel |
|---|---|---|
| 1 | Welche Variable summiert wird (Index) | i |
| 2 | Summationsbereich (untere Grenze bis obere Grenze) | 1 bis n |
| 3 | Wie die einzelnen Terme aussehen |
ProduktzeichenDie Struktur ist dieselbe, man ersetzt nur „Addition“ durch „Multiplikation“:
Die zwei häufigsten KI-Formeln basieren auf der Summation:
Verlust des mittleren quadratischen Fehlers:
Gewichtete Summe eines Neurons:
Beispiele
w = [0.5, -1.0, 2.0] # Gewichte, entsprechend w_i in der Formel
x = [2.0, 3.0, 1.0] # Eingaben, entsprechend x_i in der Formel
b = 0.1 # Bias
# sum_{i=1}^{3} w_i * x_i ist genau die folgende Zeile
z = sum(wi * xi for wi, xi in zip(w, x)) + b
print(z)
# Ausführliche Überprüfung: 0.5*2 + (-1.0)*3 + 2.0*1 + 0.1
print(0.5*2 + (-1.0)*3 + 2.0*1 + 0.1)
Die Ausführung des obigen Codes gibt aus:
0.1
0.1
Mengen und Logik
Mengensymbole beschreiben, „zu welcher Kategorie Daten gehören“, Logiksymbole beschreiben, „wie Bedingungen kombiniert werden“, und Wahrscheinlichkeitstheorie und maschinelles Lernen nutzen sie ausgiebig.
| Symbol | Bedeutung | Beispiel |
|---|---|---|
| gehört zu | ||
| gehört nicht zu | ||
| Teilmenge | ||
| Vereinigung | ||
| Schnittmenge | ||
| leere Menge (enthält keine Elemente) | ||
| Menge der reellen Zahlen | ||
| beliebig, alle (Allquantor) | ||
| existiert (Existenzquantor) | ||
| logisches NICHT | ||
| logisches UND, logisches ODER | ||
| impliziert, Implikation | ||
| äquivalent (genau dann, wenn) |
Diese Symbole kommen am häufigsten in den Theorem- und Annahmenabschnitten von Arbeiten vor, zum Beispielgelesen als „für jedes Epsilon größer als 0 existiert ein N“.
Hochstellungen, Tiefstellungen und Wertebereiche
Dieser Abschnitt klärt zwei häufige Verwechslungen: was tiefgestellte Indizes tatsächlich bedeuten und wie man Intervallschreibweise liest.
Tiefstellung: Nummerierung von Variablen desselben Typs
Trainingsdaten enthalten viele Beispiele; alle mit x zu bezeichnen wäre verwirrend, daher verwendet man Indizes, um sie zu unterscheiden:。
Wenn es zwei Indizes gibt, wie z. B., bedeutet das normalerweise „die i-te Zeile und j-te Spalte“, was genau ein Element einer Matrix ist.
Ein Vektor wird als(fett) geschrieben, seine Komponenten sind; MatrixIhre Form wird durch „Zeilen × Spalten“ beschrieben, bezeichnet als。
Intervalle und Wertebereiche
Runde Klammern bedeuten „Endpunkte ausgeschlossen“, und eckige Klammern bedeuten „Endpunkte eingeschlossen“.
| Symbol | Lesart | Bedeutung |
|---|---|---|
| Offenes Intervall | Alle Zahlen zwischen a und b, wobei beide Endpunkte ausgeschlossen sind | |
| Abgeschlossenes Intervall | Alle Zahlen zwischen a und b, wobei beide Endpunkte eingeschlossen sind | |
| Halboffenes Intervall | b eingeschlossen, a ausgeschlossen | |
| x gehört zum abgeschlossenen Intervall | x nimmt Werte zwischen 0 und 1 an, Endpunkte erlaubt |
Der Wertebereich der Sigmoid-Funktion ist, dieses offene Intervall bedeutet, dass die Ausgabe immer echt größer als 0 und kleiner als 1 ist, was genau der mathematische Grund dafür ist, dass sie als "Wahrscheinlichkeit" verwendet werden kann.
Tabelle des griechischen Alphabets
Die zahlreichen griechischen Buchstaben in Papers sind keine Dekoration; jeder hat eine Standardbedeutung. Wenn man sie alle kennt, wird das Lesen von Papers viel flüssiger.
| Großbuchstabe | Kleinbuchstabe | Name | Häufige Bedeutungen in der KI |
|---|---|---|---|
| Alpha | Lernrate | ||
| Beta | Momentum-Koeffizient, Abklingrate des zweiten Moments in Adam | ||
| Gamma | Diskontfaktor (Reinforcement Learning) | ||
| Delta | Änderung, Inkrement | ||
| Epsilon | Kleine positive Zahl, Explorationswahrscheinlichkeit | ||
| Theta | Modellparameter | ||
| lambda | Regularisierungskoeffizient | ||
| Pi | Policy (Reinforcement Learning), pi | ||
| Sigma | Summation / Sigmoid-Funktion, Standardabweichung | ||
| Phi | Feature-Mapping-Funktion | ||
| Omega | Modellgewichte (in einigen Papers) |
Dasselbe Symbol hat in verschiedenen Bereichen unterschiedliche Bedeutungen:Im Kontext von Aktivierungsfunktionen ist es Sigmoid, im statistischen Kontext ist es die Standardabweichung, und in Summenformeln ist das großeder Summationsoperator. Um die Bedeutung zu verstehen, schaue zuerst auf den Kontext – das ist die wichtigste Gewohnheit beim Lesen von Papers.
Wahrscheinlichkeitsrechnung und Statistik
Die Kernsprache des maschinellen Lernens. Die von Klassifikationsmodellen ausgegebene "Konfidenz", die Herleitung von Verlustfunktionen und Bayes-Methoden bauen alle auf diesen Symbolen auf.
| Symbol | Bedeutung | Beispiel / Erklärung |
|---|---|---|
| Wahrscheinlichkeit, dass Ereignis A eintritt | ||
| Bedingte Wahrscheinlichkeit: Wahrscheinlichkeit von A gegeben B | Der senkrechte Strich wird als "gegeben" gelesen | |
| Gemeinsame Wahrscheinlichkeit: A und B treten gleichzeitig ein | ||
| Satz von Bayes | Grundlage aller Bayes-Methoden | |
| Erwartungswert (Mittelwert) | ||
| Varianz (Ausmaß der Streuung) | ||
| Mittelwert | Zentrum der Datenverteilung | |
| Varianz (Sigma zum Quadrat) | ||
| Folgt einer ... Verteilung | ||
| Normalverteilung (Gauß-Verteilung) | In den Klammern stehen Mittelwert und Varianz | |
| Informationsentropie |
Der Kreuzentropie-Verlust ist die Krönung dieser Symbole und kombiniert Summation, bedingte Wahrscheinlichkeit und Logarithmus:
Zerlegt man es Symbol für Symbol:ist das wahre Label der i-ten Stichprobe,ist die vom Modell vorhergesagte Wahrscheinlichkeit,verwandelt die Multiplikation von Wahrscheinlichkeiten in eine Addition, und das negative Vorzeichen sorgt dafür, dass "je kleiner der Verlust, desto besser" gilt.
ist die kalligrafische Form von "Normal", die sich auf die Normalverteilung bezieht, nicht auf den Buchstaben N. Kalligrafische Symbole、werden oft verwendet, um "mengenartige" Objekte wie Verteilungen, Verlustfunktionen und Datensätze darzustellen.
Lineare Algebra
Die zugrunde liegende Struktur neuronaler Netze. Jede Matrixoperation in Deep-Learning-Frameworks verwendet diese Symbole.
| Symbol | Bedeutung | Beispiel / Erklärung |
|---|---|---|
| Vektor (fett, kleingeschrieben) | ||
| Matrix (fett, großgeschrieben) | Eine Tabelle aus Zahlen mit m Zeilen und n Spalten | |
| Transponieren: Zeilen und Spalten vertauschen | Zeilenvektor wird zum Spaltenvektor | |
| Matrixmultiplikation | Keine elementweise Multiplikation | |
| Elementweise Multiplikation (Hadamard-Produkt) | Multiplikation entsprechender Positionen von Matrizen gleicher Form | |
| Norm (die "Länge" eines Vektors) | ||
| L1-Norm: Summe der Absolutwerte | Grundlage der L1-Regularisierung | |
| Inverse einer Matrix | ||
| Einheitsmatrix | Diagonaleinträge sind 1, alle anderen sind 0 | |
| Skalarprodukt (inneres Produkt) |
Das Skalarprodukt ist das Rückgrat des Attention-Mechanismus: Jede Schicht des Transformers berechnet das Skalarprodukt zwischen Query-Vektoren und Key-Vektoren und misst damit ihre "Ähnlichkeit".
Beispiele
# x · y = sum(x_i * y_i),||x||_2 = sqrt(sum(x_i^2))
import math
x = [1.0, 2.0, 3.0]
y = [4.0, 0.0, -1.0]
# Skalarprodukt x · y
dot = sum(xi * yi for xi, yi in zip(x, y))
print(dot)
# L2-Norm ||x||_2
norm2 = math.sqrt(sum(xi ** 2 for xi in x))
print(norm2)
# Ausmultiplizieren und überprüfen
print(1.0*4.0 + 2.0*0.0 + 3.0*(-1.0))
print(math.sqrt(1 + 4 + 9))
Das Ausführen des obigen Codes erzeugt die folgende Ausgabe:
1.0
3.7416573867739413
1.0
3.7416573867739413
Analysis
Das Wesen des Trainings besteht darin, "Parameter entgegen der Gradientenrichtung anzupassen", daher kommen die Optimierungsabschnitte in Fachartikeln nicht ohne diese Symbole aus.
Du musst sie noch nicht berechnen können; du musst sie nur erkennen können.
| Symbol | Bedeutung | Beispiel / Beschreibung |
|---|---|---|
| Ableitung: die Änderungsrate von y bezüglich x | ||
| Alternative Schreibweise für die Ableitung | ||
| Partielle Ableitung: die Änderungsrate von f, wenn sich nur x ändert | Wird für Funktionen mit mehreren Variablen verwendet | |
| Gradient: ein Vektor aller partiellen Ableitungen | ||
| Integral, die Umkehroperation der Differentiation | ||
| Grenzwert: der Wert, wenn x gegen a strebt |
Die wichtigste Formel im Deep Learning verwendet nur zwei Zeilen aus der obigen Tabelle: die Parameteraktualisierungsregel für den Gradientenabstieg.
Zerlegung jedes Symbols:ist der Parameter,bedeutet "aktualisiere die linke Seite mit dem Wert auf der rechten Seite",ist die Lernrate,ist der Gradient der Verlustfunktion J bezüglich des Parameters θ.
In einem Satz:neuer Parameter = alter Parameter − Lernrate × Gradient, das heißt, mache einen kleinen Schritt in die Richtung, in der der Verlust am schnellsten abnimmt.
Gelesen als Nabla oder der "Gradientenoperator", ist es keine Zahl, sondern eine Anweisung, partielle Ableitungen bezüglich aller folgenden Variablen zu bilden, ganz ähnlich einer Funktion höherer Ordnung in der Programmierung.
Optimierung und andere häufig vorkommende Symbole
Dieser letzte Abschnitt behandelt Symbole, die sporadisch in Fachartikeln auftauchen, aber dennoch entscheidend sind.
| Symbol | Bedeutung | Beispiel / Beschreibung |
|---|---|---|
| das x, das f maximiert | liefert x zurück, nicht den Maximalwert selbst | |
| das x, das f minimiert | Training ist das Finden | |
| des Minimums von f | liefert den Wert selbst zurück | |
| Softmax-Funktion | ||
| Funktionskomposition | ||
| definiert als | die linke Seite wird als der Wert auf der rechten Seite definiert | |
| proportional zu | ||
| ReLU-Aktivierungsfunktion | ||
| Big-O-Notation: Wachstumsordnung | Konstanten ignorieren, nur die Größenordnung betrachten. |
Was ein Klassifikationsmodell während der Vorhersage tut, ist genau: die Klasse mit der höchsten Wahrscheinlichkeit nehmen; argmax gibt den Klassenindex zurück, nicht den Wahrscheinlichkeitswert.
undLeicht zu verwechseln:Antwort "Was ist der Maximalwert",Antwort "an welchem x das Maximum erreicht wird." Bei Klassifikationsaufgaben geht es um Letzteres.
Lernempfehlungen
Es ist nicht nötig, Symboltabellen auswendig zu lernen; Methoden sind effektiver als Auswendiglernen.
Entwickle zuerst die Gewohnheit, Symbole einzeln zu zerlegen: Wenn du eine Formel bekommst, frage zuerst, ob jedes Symbol ein Operator, eine Variable oder eine Funktion ist, und dann, was es im aktuellen Kontext repräsentiert. Nach dem Zerlegen ist es oft nicht mehr mysteriös.
Zweitens: Priorisiere, drei Dinge gründlich zu beherrschen:Summenbildung, Exponenten und Logarithmen, Indexnotation. Sie sind die Voraussetzungen, um Formeln der linearen Algebra und der Analysis zu lesen. Dieser Artikel hat für jedes einen eigenen Abschnitt.
Drittens: Wenn du auf ein unbekanntes Symbol stößt, suche direkt nach "Symbolname + mathematische Bedeutung". Das ist schneller, als sich mühsam durch Lehrbücher zu quälen.
Weitere ErweiterungenSymbole sind die Karte, nicht das Gelände. Wahres Verständnis entsteht, wenn man mit ihnen konkrete Beispiele berechnet; jedes Python-Beispiel im Text ist es wert, von Hand ausgeführt zu werden.